


Kortversionen
- AI-kodagenter är bra på att lägga till kod och dåliga på att upptäcka att koden redan finns. Lämnade åt sig själva ger de ett repo en andra hjälpfunktion för varje första, och varje läsare måste kontrollera båda för att lita på någon av dem.
- Lösningen är två vanor som skrivits ned så att en agent följer dem. Grain: hitta det närmaste befintliga exemplet på samma sorts sak och spegla dess form, placering och namn. Ponytail: klättra på en stege från “behöver detta ens finnas” till “det minimala som fungerar” och stanna vid första stegpinne som håller.
- Båda är nu en offentlig skill, licensierad under MIT: grain-skill på GitHub . Den innehåller reglerna för hur man skriver dem, en granskningsomgång med fasta taggar och formen på den avslutande raden som får agenten att namnge vad den speglade.
- I vårt huvudrepo sedan augusti: 386 issues och pull requests bär en plankommentar som namnger exemplaret att spegla, över 1 333 commits in i ett träd på ungefär 18 000 filer. 35 ställen i koden bär en
ponytail:-kommentar som namnger en medveten förenkling och dess uppgraderingsväg. - Det obekväma fyndet: agenten anropade skillen som en skill noll gånger. Reglerna fungerade eftersom jag också lade dem i projektets CLAUDE.md, i definitionerna för arbetsagenterna och i granskningschecklistan. Lägg regeln där agenten redan läser.
Jag skrev om detta en gång tidigare och jag gillade inte resultatet, eftersom det beskrev principen och inte mekanismen. Det här är versionen med mekanismen.
Felet detta är till för
Tre exempel från vår backend, alla verkliga, alla från agent-skrivna pull requests som passerade sina tester.
En ny REST-rutt som hämtade applikationstjänsten direkt från en fabrik. Varje systerrutt i repot går rutt till controller till tjänst till repository, varje steg injicerat. Den här kollapsade kedjan till rutt till tjänst. Den fungerade. Det innebar också att den enda plats där validering av förfrågan och formning av svar lever för den funktionen inte fanns, och nästa agent som rörde funktionen hade två former att välja mellan.
En överdimensionerad tjänst delades upp i _payloads.py, _protocol.py och _tokens.py, var och en en modul med nakna async def:er, där tjänsten anropar protocol.discover(...) via import. Kontrollen av fillängd blev grön. Det som beroendeinjektion finns för att förhindra kom rakt tillbaka: en samarbetspartner vald vid importtillfället, omöjlig att ersätta utan att patcha modulen, frånvarande i konstruktorn som dokumenterar vad tjänsten är beroende av.
En andra normaliserare. Det fanns redan en. Agenten hittade den inte, skrev åtta rader till som gjorde nästan samma sak, och nu gör två funktioner med olika beteende i gränsfall anspråk på att kanonisera samma fält.
Inget av dessa är en bugg i den mening ett test fångar. Vart och ett är en agent som väljer koden den kunde generera framför koden som fanns. Gör det över några hundra pull requests och repot slutar ha en form.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Grain
Ny kod ska vara omöjlig att skilja från koden runt omkring. Skillen förvandlar den meningen till fem steg som en agent tar innan den skriver.
Hitta exemplaret först. För en endpoint, tjänst, repository, query hook, store-slice eller komponent: lokalisera den närmaste befintliga och kopiera dess form, filplacering och namngivning. Hitta inte på en struktur när ett mönster finns. I vårt repo är branding-slicen det namngivna exemplaret för backend eftersom den är liten, ren och spänner över varje lager, och skillens tabell säger, för varje slags artefakt, vilken fil som ska öppnas och vad som ska speglas.
Respektera lagren. Presentation anropar applikation anropar domän, och infrastruktur implementerar domän. En ny import över de gränserna misslyckas i arkitekturkontrollen. Läs lagerdokumentet, härled det inte på nytt.
Lokalt grain mot repots grain. Matcha dina syskon. Men om syskonen själva avviker från den kanoniska kedjan, följ den kanoniska kedjan och notera avvikelsen i stället för att kopiera driften. “Den matchar de andra fem rutterna i den här filen” räcker inte om alla sex hoppar över ett lager som den kanoniska slicen använder. Du jämförde för lokalt.
Återanvänd den kanoniska hjälpfunktionen. Om en hjälpfunktion, typ eller mönster redan finns i repot, använd den. Två normaliserare tvingar varje läsare att diffa båda.
Namn bär betydelse. Återanvänd ordförrådet som redan finns i koden. Ett nytt namn för ett befintligt begrepp är en bugg som väntar på en läsare.
Testet i slutet är det jag ger granskare: om du enbart utifrån formen kan se vilka rader agenten skrev, gick den mothårs.
Ponytail
Lat betyder effektiv, inte slarvig. Den bästa koden är koden som aldrig skrivs. Förstå problemet fullt ut först, varje fil ändringen rör, det verkliga flödet från början till slut, och klättra sedan på den här stegen och stanna vid första stegpinne som håller.
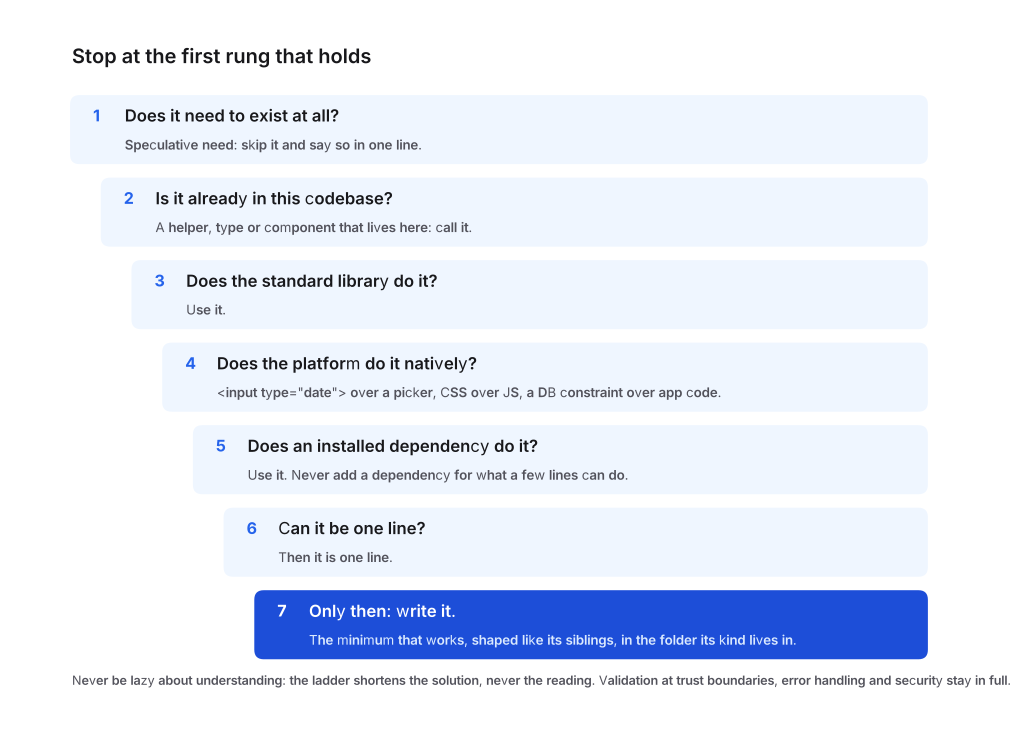
Två regler följer med stegen.
En buggfix är en grundorsak, inte ett symptom. En ticket namnger ett symptom. Greppa varje anropare av funktionen du är på väg att röra. En skyddskontroll i den delade funktionen är en mindre diff än en skyddskontroll i varje anropare, och att bara laga vägen som ticketen namnger lämnar syskonanroparna trasiga.
Håll diffen minimal. Diffen är det granskningen läser. Inga refaktoreringar på köpet, inga namnbyten, ingen omformatering, inga “medan jag ändå är här”-förbättringar, inga filer rörda som uppgiften inte krävde. Var och en begraver den verkliga ändringen. Om diffen är större än problemet, skär ner den. Förbättringar du upptäckte är ett uppföljningsärende, inte extra commits på den här grenen.
Och gränserna, eftersom “lat” är ordet som mest sannolikt missförstås. Förenkla aldrig bort validering av indata vid en förtroendegräns, felhantering som förhindrar dataförlust, säkerhet, grundläggande tillgänglighet eller något användaren bett om. Var aldrig lat när det gäller att förstå: stegen kortar lösningen, aldrig läsningen. En liten diff på fel plats är en andra bugg. Icke-trivial logik lämnar ett körbart test efter sig, den minsta sak som fallerar om logiken går sönder.
När agenten medvetet tar en stegpinne och känner till taket, säger den det i koden:
# ponytail: global lock, per-account locks if throughput matters
Det finns 35 sådana i vårt repo nu. Var och en är ett beslut som en framtida läsare annars skulle behöva rekonstruera, och en markering för var man ska titta när taket nås.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Att få en agent att faktiskt göra det
En princip i ett dokument är inte ett beteende. Tre mekanismer gjorde dessa två till beteenden, och jag skulle rangordna dem i den här ordningen.
Briefen bär exemplaret. I arkitektmönstret skriver huvudmodellen en brief till en arbetare, och briefens Design-fält namnger det närmaste befintliga mönstret att spegla och den minimala grundorsaksändringen. Arbetaren behöver inte hitta grain. Den får det tilldelat. I vårt repo är det vad de 491 plankommentarerna på 386 issues och pull requests är: ett planeringssteg som namnger vad som ska speglas innan någon skriver.
Agenten avslutar med vad den speglade. Varje implementerares rapport slutar med en rad, mirrored: <path>, eller namnger det nya mönstret och varför inget syskon passade. Det är billigt och det är den enskilt bästa granskningshjälpen jag har lagt till. En mirrored:-rad som pekar på fel sorts fil säger att diffen är fel innan du ens öppnar den. En saknad sådan säger att agenten inte tittade.
Granskningen upprätthåller samma ribba, i en fast ordning. Vår gransknings-skill har två omgångar med fasta taggar, och det är taggarna som gör fynd jämförbara mellan granskare och mellan agenter.
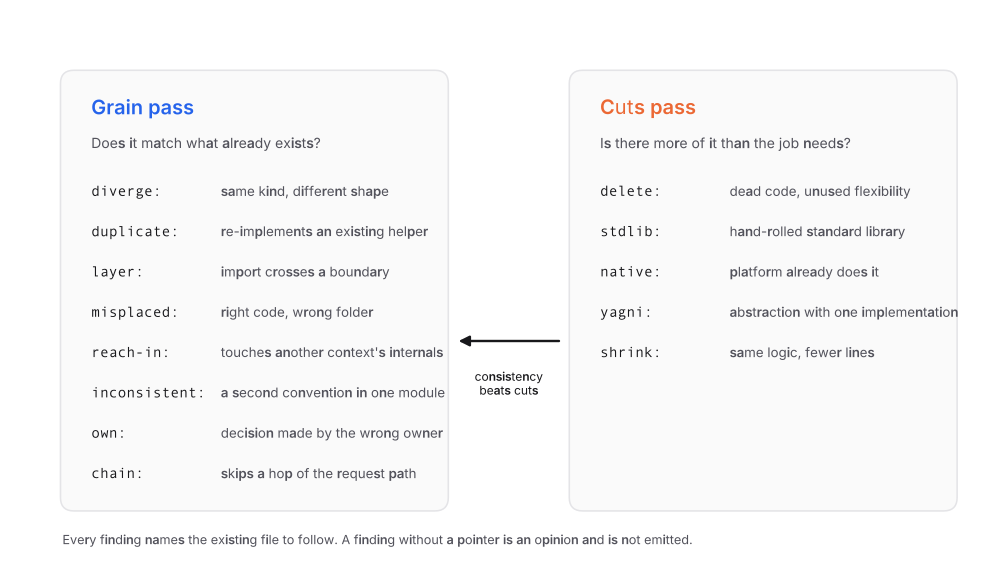
Struktur först. Avviker detta från närmaste exemplar, duplicerar det en befintlig hjälpfunktion, korsar det ett lager, sitter det på fel plats, sträcker det sig in i en annan moduls interna delar, använder det inkonsekventa namn, tar det ägandeskap över något det borde injicera, eller bryter det den kanoniska anropskedjan? Sedan nedskärningar. Vad skulle kunna tas bort, ersättas av standardbiblioteket, ersättas av en inbyggd plattformsfunktion, strykas som spekulativt eller krympas?
Ordningen är en regel, inte en preferens. Konsekvens slår nedskärningar. En nedskärning som lämnar koden avvikande från sina syskon är ingen vinst, eftersom läsaren nu måste lära sig två former för att spara åtta rader. Kör strukturen först och nedskärningsomgången rör bara kod som redan matchar.
Vad som hände i repot, inklusive delen som inte fungerade
Sedan 1 augusti har vårt huvudrepo tagit emot 1 333 commits, de flesta agent-skrivna under granskning. 386 av issues och pull requests under den perioden bär en plankommentar som namnger exemplaret att spegla, 491 sådana kommentarer totalt. Den kanoniska kedjan är standardformen för en ny endpoint, och de två äldre rutterna som hoppar över controllern listas i dokumentet som en avvikelse under avveckling, inte som en andra stil.
De 35 ponytail:-kommentarerna är ett mindre antal än jag förväntade mig och jag tror att det är rätt. De flesta förenklingar är inte värda en kommentar. De som är det, är de med ett tak.
Nu delen jag helst inte vill rapportera. Jag släppte grain och ponytail som en Claude Code-skill: en beskrivning i skill-indexet, en kropp som laddas på begäran och en rad i CLAUDE.md som säger att den ska anropas innan kod skrivs. Under fem veckors transkript anropade agenten den vid namn noll gånger. Den avslutande mirrored:-raden dök upp i sju svar.
Reglerna landade ändå. De landade eftersom samma text också fanns på tre ställen som agenten läser utan att välja det: projektets CLAUDE.md, som finns i kontexten från första turen; definitionerna för arbetsagenterna, som säger “spegla det närmaste befintliga exemplets form, placering och namngivning” och “sträck dig efter den lataste lösning som faktiskt fungerar” som regler, inte som en skill att överväga; och granskningschecklistan, vars taggar fäller en pull request som ignorerar dem. Skillens kropp blev den kanoniska referens som dessa tre pekar på. Som utlösare gjorde den ingenting.
Så lärdomen jag skulle föra vidare till alla som paketerar konventioner för en agent är denna. En skill är en bra plats för den långa versionen av en regel. Den är en dålig plats för själva regeln, eftersom agenten måste besluta sig för att ladda den och oftast inte gör det. Lägg enparagrafsversionen i filen som alltid finns i kontexten, lägg imperativversionen i definitionen av agenten som skriver koden, och lägg kontrollen i granskningen som grindar mergen. Peka sedan alla tre på skillen för detaljerna.
Den offentliga versionen på github.com/LivinTribunal/grain-skill är upplagd på det sättet: en kort SKILL.md med reglerna en agent kan hålla i huvudet, hela dokumentet med stegen och antimönstren, granskningstaggarna och en README som säger vilket stycke som hör hemma i din CLAUDE.md och vilket som hör hemma i din implementerares definition. Byt ut det genomarbetade exemplet mot ditt eget kanoniska exemplar och det är klart.
