


Bản tóm tắt ngắn
- Tôi lấy một issue thật từ backlog của FlowHunt và để Claude Code triển khai nó 13 lần trên Opus 5.5, với bảy cách thiết lập hướng dẫn khác nhau. Mọi lần chạy đều bắt đầu từ cùng một commit, trong bản clone riêng với database riêng, và đi qua GitHub CI thật của chúng tôi. Hai đánh giá mù của Opus chấm điểm từng kết quả.
- File CLAUDE.md 33 KB của repository không mua được chất lượng đo lường được. Các lần chạy có nó nhận 2.0 phát hiện mức blocker và major mỗi lần đánh giá. Một lần chạy không có file hướng dẫn nào cũng nhận đúng như vậy. Một file 5.5 KB nhận 1.0.
- Một giai đoạn lập kế hoạch riêng khiến mọi thứ tệ hơn. Cả hai thiết lập chạy prompt lập kế hoạch rồi đến prompt triển khai đều tốn hơn so với bản song sinh chỉ dùng prompt thường, và chúng tạo ra bốn trong năm blocker của toàn bộ 26 lượt đánh giá.
- Người thắng là một CLAUDE.md 8 KB, ba skill, worker Sonnet, và một prompt thường. Hai lần chạy của nó tốn trung bình 6,68 đô theo giá niêm yết API. Thiết lập đầy đủ với các prompt pipeline tốn trung bình 11,49 đô, khoảng gấp 1,7 lần, và có nhiều phát hiện hơn.
- Thứ còn trụ lại từ tất cả cấu trúc tôi đã dựng nên là bản brief: một mô tả ngắn gọn, đã chốt về một lát cắt công việc mà model chính viết cho một worker rẻ hơn. Các bản kế hoạch dành cho chính model chính thì không mang lại lợi ích. Model tự lập kế hoạch tốt.
Bài này nối tiếp bài pattern architect , nơi đo xem ai nên gõ code. Bài này hỏi model chính cần được cho biết bao nhiêu trước khi bắt đầu.
Vì sao tôi chạy thử nghiệm này
Monorepo của chúng tôi đã tích lũy rất nhiều hướng dẫn cho agent. File CLAUDE.md ở gốc nặng 33 KB: lệnh build, nhịp độ test, phong cách code, kiến trúc, các đường dẫn quan trọng, quy tắc bảo mật, quy tắc về quyền và credit, hai bề mặt agent, cách mở issue, quy ước PR. Mười skill nằm dưới .claude/skills/. Trên hết, pipeline CI của chúng tôi (chúng tôi gọi nó là harnext) đưa một issue qua một bước gắn nhãn, một bước phân loại, một bước lập kế hoạch viết bản kế hoạch thành bình luận trong issue, và một bước triển khai đọc lại bản kế hoạch rồi viết code, mỗi bước có system prompt dài riêng.
Từng dòng trong đó đều được thêm vào vì một lý do, thường là sau khi agent làm sai điều gì đó. Câu hỏi mà chưa ai đặt ra là liệu nó có còn hữu ích không. Một CLAUDE.md được nạp vào mọi phiên và được gửi lại ở mọi lượt. Nếu model vốn dĩ đã làm đúng, thì những token đó là một khoản thuế, và như bài cửa sổ ngữ cảnh tốn bao nhiêu giải thích, một khoản thuế trên mọi lượt sẽ cộng dồn nhanh hơn vẻ ngoài của nó.

Sẵn sàng phát triển doanh nghiệp của bạn?
Bắt đầu dùng thử miễn phí ngay hôm nay và xem kết quả trong vài ngày.
Thử nghiệm
Issue là một chuỗi email theo thời gian cho người đăng ký mới: admin định nghĩa các bước như “ngày 0: chào mừng” và “ngày 5: bản dùng thử của bạn sắp hết”, và một tác vụ nền sẽ gửi mail cho từng tài khoản vào đúng ngày, dừng lại khi người đó mua gói trả phí, và bỏ qua những tài khoản được tạo trước ngày ra mắt. Nó cần một migration, một repository, một service, một tác vụ Celery beat, các endpoint REST, công cụ MCP cho agent, và một giao diện console bằng 11 ngôn ngữ. Đó là một tính năng thực tế của tuần đầu, và nó có vài edge case rất dễ bị bỏ sót.
Mỗi lần chạy là một phiên Claude Code không giao diện trên Opus 5.5, được cô lập trong bản clone và database riêng, với một script đẩy commit của nó lên draft PR và đưa kết quả CI trở lại phiên, tối đa ba vòng. Chi phí là total_cost_usd của chính Claude Code cho phiên chính cộng mọi subagent, tính theo giá niêm yết API. Tôi trả tiền theo gói thuê bao, nên đây là phép đo khối lượng công việc, không phải hóa đơn của tôi.
Bảy thiết lập:
| Thiết lập | Số lần chạy | |
|---|---|---|
| A | CLAUDE.md đầy đủ 33 KB và mười skill, prompt pipeline (lập kế hoạch, rồi triển khai) | 2 |
| B | CLAUDE.md và skill đầy đủ, prompt thường | 3 |
| C | Không CLAUDE.md, không skill, prompt thường | 2 |
| D | CLAUDE.md đầy đủ cộng skill architect, prompt thường | 2 |
| E | CLAUDE.md 8 KB, architect, grain-ponytail và unslop, prompt pipeline | 1 |
| F | CLAUDE.md 5.5 KB, không skill, prompt thường | 1 |
| G | CLAUDE.md 8 KB, architect, grain-ponytail và unslop, prompt thường | 2 |
A đến D chạy trước. E đến G được dựng từ những gì chúng cho thấy, và lần chạy B thứ ba đi kèm chúng như một đối chứng. File 8 KB là file 5.5 KB cộng thêm một danh sách ngắn các skill và thời điểm nạp chúng, cùng các quy tắc định tuyến model giúp skill architect giao việc cho Sonnet.
Sau đó mọi kết quả được gửi cho hai người đánh giá Opus, những người chỉ nhìn thấy một chữ cái, diff, repository và issue. Họ liệt kê mọi thay đổi họ sẽ yêu cầu trước khi phê duyệt, xếp loại blocker, major, minor hoặc nit, và kiểm tra từng tiêu chí nghiệm thu dựa trên một file và số dòng cụ thể.
Chi phí
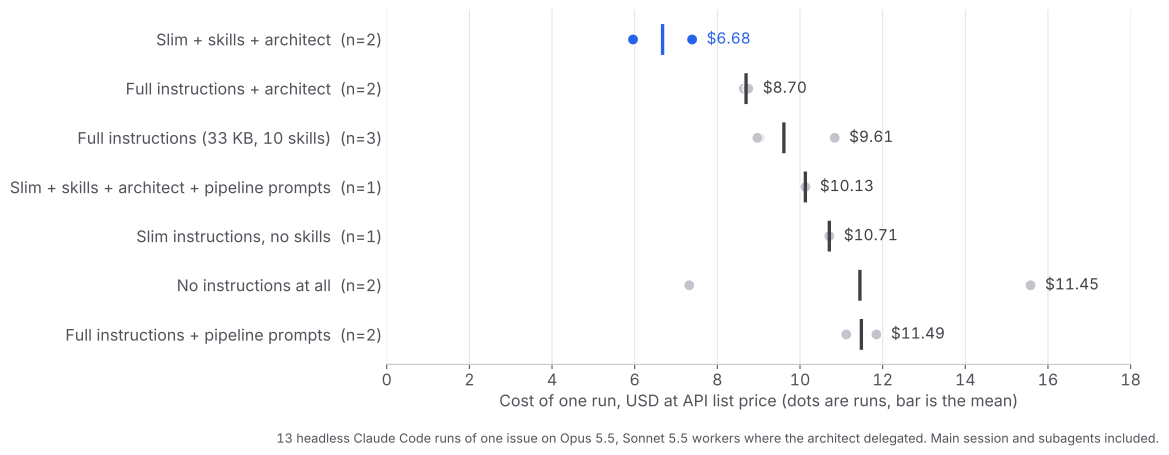
Thiết lập thắng cuộc, G, tốn 5,96 đô và 7,39 đô. Thiết lập đầy đủ với prompt pipeline, A, tốn 11,12 đô và 11,85 đô. Khoảng cách chủ yếu nằm ở số lượt và lượng mà mỗi lượt mang theo. Các phiên chính của A chạy 172 và 144 lượt trên Opus với 24 đến 28 triệu input token. Các phiên của G chạy 79 và 95 lượt với 13 đến 16 triệu, và giao thêm khoảng 60 lượt cho các worker Sonnet, vốn được tính giá chỉ bằng một phần nhỏ. G còn hoàn thành công việc trong khoảng 21 phút so với 45 phút của A.
Hai điều trên biểu đồ này khiến tôi bất ngờ. Không có hướng dẫn nào không phải là phương án rẻ: hai lần chạy của nó tốn 7,32 đô và 15,58 đô, và lần đắt còn làm fail CI và viết diff lớn nhất trong thử nghiệm. Còn file 5.5 KB không có skill, F, không hề rẻ hơn thiết lập đầy đủ. Nó viết nhiều code hơn, 1.601 dòng sản phẩm, và phải trả giá cho điều đó. Khoản tiết kiệm ở G không chỉ đến từ file ngắn. Nó đến từ file ngắn cộng với hai skill thay đổi cách công việc được thực hiện.
Tham gia bản tin của chúng tôi
Nhận các mẹo, xu hướng và ưu đãi mới nhất miễn phí.
Chất lượng
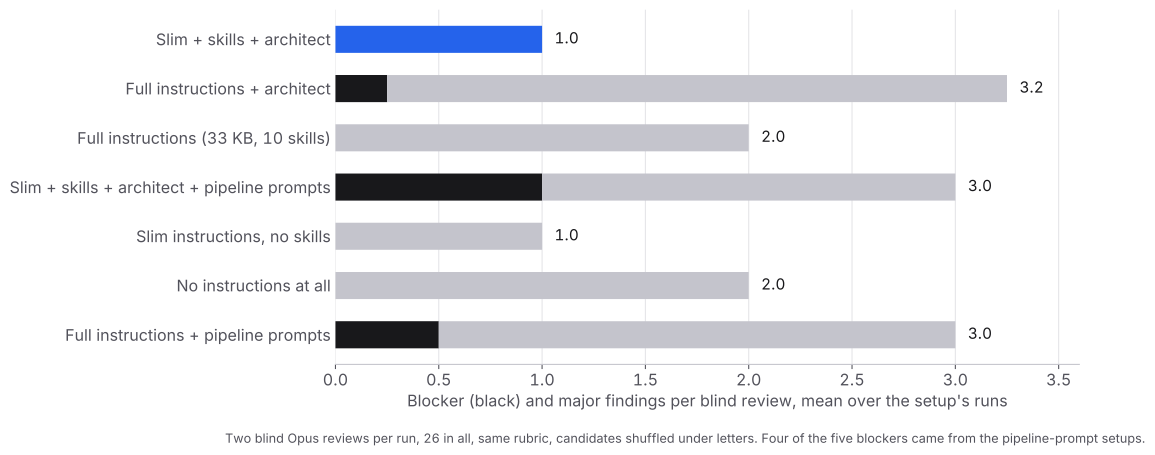
Thiết lập rẻ nhất cũng có ít phát hiện nghiêm trọng nhất: không blocker nào, và 1.5 cùng 0.5 phát hiện major mỗi lần đánh giá ở hai lần chạy của nó. CLAUDE.md đầy đủ, B, đứng ở 2.0 major trong cả ba lần chạy, ngang bằng với việc không có CLAUDE.md nào cả.
Đây là kết quả tôi quan tâm nhất. File có những phần dài về bảo mật, quyền và credit, được viết ra vì có lần một agent đã bỏ qua chúng. Dù có hay không có file, những người đánh giá vẫn tìm thấy cùng số lượng vấn đề nghiêm trọng, và cùng những loại vấn đề quay lại qua các thiết lập: một người đăng ký trả tiền rồi hủy, một email bị mất hoặc gửi hai lần khi một worker thất bại giữa chừng, một trình soạn thảo ghi đè nội dung mà nó không hiển thị được. Đó là những lỗ hổng trong suy luận về trạng thái theo thời gian. Không danh sách quy tắc nào trong CLAUDE.md bao quát được chúng, vì bạn không thể viết một quy tắc cho edge case mà bạn chưa từng nghĩ tới.
Thứ bao quát được chúng là một thay đổi ở skill architect giữa các vòng. Trước khi model chính viết bất kỳ bản brief nào, giờ nó viết một bảng: từng tiêu chí nghiệm thu, điều gì xảy ra khi trạng thái mà tiêu chí đó phụ thuộc thay đổi theo thời gian, và hành vi đã được chốt. Mỗi dòng sau đó đi vào bản brief kèm một test được đặt tên. Các lần chạy của G viết 774 và 818 dòng test, so với 510 đến 670 ở B.
Giai đoạn lập kế hoạch
A và E là hai thiết lập chạy các prompt của pipeline CI của chúng tôi: một prompt lập kế hoạch viết ra bản kế hoạch, rồi một prompt triển khai đọc bản kế hoạch và thực thi nó. Hãy so mỗi thiết lập với bản song sinh của nó chỉ nhận một prompt thường. A tốn 11,49 đô mỗi lần chạy so với 9,61 đô của B và có blocker trong khi B không có. E tốn 10,13 đô so với 6,68 đô của G và có một blocker trong mỗi lần đánh giá, trong khi G không có.
Tôi nghĩ lý do là bản kế hoạch là một tài liệu mà model viết cho chính nó rồi sau đó phải đọc lại như một chỉ dẫn từ bên ngoài. Phiên thứ hai coi bản kế hoạch như một đặc tả, tuân theo nó ở cả những chỗ nó sai, và tiêu tốn lượt để dung hòa nó với những gì tìm thấy trong code. Một model mạnh đến mức này sẽ lập kế hoạch tốt hơn ngay bên trong phiên sắp sửa làm việc, nơi bản kế hoạch và code nằm trong cùng một ngữ cảnh.
Phần còn trụ lại của việc lập kế hoạch là bản brief. Khi model chính giao một lát cắt cho một worker Sonnet, worker bắt đầu với ngữ cảnh trống và dựng đúng những gì được nói. Sự bàn giao đó cần một mô tả đã viết ra và đã chốt: mục tiêu, các file, pattern cần bắt chước, các edge case, test cần viết. Một bản kế hoạch cho chính mình là chi phí thừa. Một bản brief cho người khác là cách duy nhất để công việc được chuyển tải.
Skill grain-ponytail đã làm gì
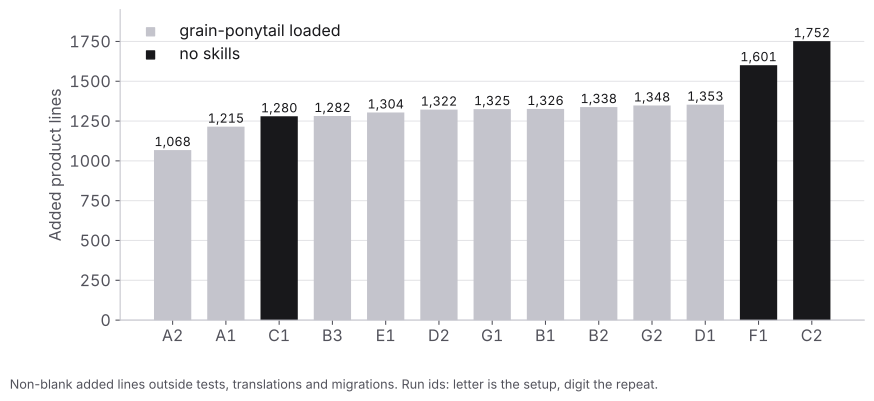
Skill từ bài code with the grain bảo model bắt chước ví dụ sẵn có gần nhất và chỉ ship lượng code ít nhất có thể chạy được. Mọi lần chạy có nạp skill này đều viết từ 1.068 đến 1.353 dòng sản phẩm. Hai diff lớn nhất, 1.601 và 1.752, đến từ các lần chạy không có skill. Một lần chạy không skill vẫn ở mức 1.280, nên skill không tự nó quyết định kích thước, nhưng nó đã cắt bỏ phần đuôi.
Đây cũng là ví dụ rõ nhất về loại hướng dẫn nào vẫn đáng giá. “Bắt chước ví dụ gần nhất” thay đổi điều model làm ở mọi file nó viết. “Dùng snake_case cho tên hàm” chỉ nhắc lại điều nó vốn đã làm.
Những gì các đánh giá vẫn bắt được
Lần chạy thắng cuộc không hề sạch. Sau thử nghiệm, tôi rebase công việc của G2 lên main và đưa nó qua toàn bộ bước kiểm tra PR của chúng tôi, vốn đánh giá diff, chứng minh từng phát hiện bằng một test thất bại, và chạy thay đổi trong trình duyệt thật. Nó phát hiện rằng trình soạn thảo bước đã bỏ mọi block ngoại trừ block HTML đầu tiên khi admin chỉnh sửa một bước được tạo qua MCP, và rằng một lần giải phóng claim thất bại có thể gửi mail cho một số người dùng hai lần. Cả hai đều đã được sửa, kèm test, trước khi PR được đưa lên cho người đánh giá.
Những người đánh giá mù cũng gắn cờ nhiều vấn đề thiết kế thừa (over-engineering) hơn ở các lần chạy architect so với các lần chạy có hướng dẫn đầy đủ: 2.5 mục mỗi lần đánh giá ở G so với 0 đến 1.0 ở các lần chạy A và B. Ít phát hiện nghiêm trọng hơn, nhiều nit hơn. Tôi sẽ chấp nhận đánh đổi đó, nhưng nó vẫn là một đánh đổi.
Những gì tôi đã thay đổi
- File CLAUDE.md 33 KB trở thành một AGENTS.md 12 KB mà Codex cũng đọc, và CLAUDE.md giờ chỉ import nó. Nó giữ lại các lệnh, nhịp độ test, kiến trúc và những quy tắc mà model không thể suy ra từ code, như đường dẫn nào là quan trọng và hai bề mặt agent phải luôn đồng bộ.
- Giai đoạn lập kế hoạch đã bị loại khỏi pipeline. Bước phân loại chuyển issue thẳng cho một bước triển khai có prompt rút gọn còn sáu bước: đọc issue, tạo branch, nạp các skill architect và grain-ponytail, test, commit, mở draft PR.
- Skill architect có thêm bảng edge case, một trường Tests trong bản brief, và một lượt cuối kiểm tra toàn bộ diff dựa trên issue thay vì dựa trên các bản brief. Phiên bản đó được công khai tại github.com/LivinTribunal/architect-skill .
Thay đổi trong repository đang được xem xét ở thời điểm viết bài.
Cần rút ra điều gì
Nếu CLAUDE.md của bạn lớn lên theo từng sự cố một, nó có thể đang phải trả giá cho những quy tắc mà model vốn đã tuân theo. Hãy cắt nó về những gì model không thể tự tìm ra bằng cách đọc code, và đo trước và sau trên một tác vụ thật thay vì tin rằng càng nhiều hướng dẫn thì càng an toàn.
Hãy giữ những hướng dẫn thay đổi cách công việc được thực hiện: ai gõ code, một lát cắt được brief như thế nào, cần sao chép pattern sẵn có nào. Hãy bỏ pipeline lập kế hoạch-rồi-thực thi nếu model chính của bạn là một model tiên tiến hiện hành. Viết brief cho worker, chứ không phải kế hoạch cho chính mình.
Phương pháp
13 lần chạy Claude Code 2.1.289 không giao diện vào ngày 5 tháng 10 năm 2026, model chính là Opus 5.5, worker là Sonnet 5.5 ở những chỗ skill architect giao việc. Mọi lần chạy đều bắt đầu từ một commit của monorepo FlowHunt, mỗi lần trong một bản clone APFS với database Postgres riêng, được cô lập khỏi các lần chạy khác và khỏi chính các file của thử nghiệm. Một broker đẩy commit của mỗi lần chạy lên một draft PR dựa trên một base branch đã đóng băng và tiếp tục phiên với kết quả CI, tối đa ba vòng. Chi phí là total_cost_usd tối đa mỗi phiên, cộng dồn trên phiên chính và các subagent của nó. Dòng sản phẩm là các dòng được thêm không trống, nằm ngoài test, bản dịch và migration.
Mỗi kết quả nhận hai đánh giá mù bởi Opus với một rubric duy nhất: tính đúng đắn, tiêu chí nghiệm thu, độ bám sát (grain), các trường riêng tư và trạng thái ẩn, thiết kế thừa, bảo mật và quyền, test, migration. Các ứng viên được xáo trộn dưới các chữ cái, và những người đánh giá có thể đọc repository nhưng không chạy được gì. Số phát hiện mỗi lần đánh giá được lấy trung bình trên các lần chạy của một thiết lập. Với một đến ba lần chạy cho mỗi thiết lập, hãy coi giá trị trung bình của một thiết lập là nhiễu. Những kết luận ở trên là những kết luận giữ nguyên qua cả hai vòng.
