


Vài ngày trước, Anthropic đã đưa Fable trở thành một phần thường trực của các gói Max. Thời điểm này kể lên câu chuyện: nó ra đời ngay sau khi OpenAI phát hành GPT-5.6 Sol, và — quan trọng hơn — ngay sau khi Kimi K3 tung ra trọng số của mình. Phải cần đến một model mã nguồn mở mới buộc được phòng thí nghiệm AI lớn nhất phải nhìn lại thực tế và chấm dứt màn ồn ào tiếp thị quanh model chủ lực của mình. Chỉ riêng điều đó cũng đáng để bất kỳ ai phải trả những hoá đơn này nâng ly.
Nhưng “đã bao gồm trong gói đăng ký của bạn” không giống với “rẻ”, và chắc chắn cũng không giống với “rẻ mãi mãi”. Đó là lý do, trong khi Fable vẫn còn bị tính phí theo mức dùng, chúng tôi đã xây dựng lại quy trình của mình để model đắt tiền bị chặn một cách máy móc khỏi việc viết code. Nó suy nghĩ, lập kế hoạch và đánh giá. Các model rẻ hơn gõ phím. Bài viết này cho thấy điều đó vận hành ra sao, và nó thực sự đo ra được gì trên mọi bản ghi phiên mà chúng tôi có — 606 phiên thực tế trải khắp một monorepo SaaS đang chạy production, một ứng dụng điều hành drone, một website marketing, và các agent CI phục vụ chúng.
Phần 1 — Cái bẫy và nguyên lý
Đây là xuất phát điểm trung thực của chúng tôi: chúng tôi không còn có thể vận hành mà không có các model tiên tiến. Không ai trong đội có thể duy trì sản lượng hiện tại nếu thiếu chúng — và chính sự phụ thuộc đó là đòn bẩy mà các phòng thí nghiệm lớn nắm giữ. Theo cách chúng tôi nhìn nhận, các gói đăng ký AI hiện nay cung cấp lượng tính toán nhiều hơn hẳn so với giá phải trả; đây là mức giá giành thị phần, và mức giá giành thị phần thì sẽ kết thúc. Khi điều đó xảy ra, ai đã xây dựng văn hoá kỹ thuật của mình quanh “token tiên tiến không giới hạn” sẽ phải trả bất cứ giá nào bị đòi.
Có hai cách phòng thủ. Thứ nhất là duy trì một lối thoát đáng tin: các model mở như DeepSeek và Kimi chính là thứ đã tạo ra đợt điều chỉnh giá trong tuần này, và chúng chỉ còn là đòn bẩy nếu chúng ta thực sự giữ cho quy trình của mình có thể chuyển sang chúng. Thứ hai là kỷ luật quy trình: chỉ tiêu token tiên tiến ở những nơi không có gì rẻ hơn làm được. Bài viết này nói về điều thứ hai — vì đó là thứ bạn có thể bắt đầu ngay thứ Hai.
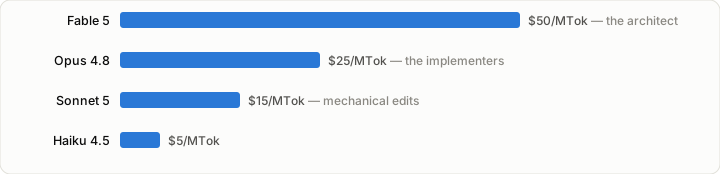
Nguyên lý này đã cũ đến mức có cả một toà nhà được đặt tên theo nó: kiến trúc sư không xây gạch. Lợi thế của một model tiên tiến so với một model hạng trung là rất lớn trong thiết kế, phân rã công việc và đánh giá — và gần như bằng không khi gõ một thao tác đổi tên trên bốn mươi tệp. Vậy nên hãy tách vai trò. Thang giá cũng nói điều tương tự bằng đô-la:
Mẫu fable-architect vận hành như thế nào
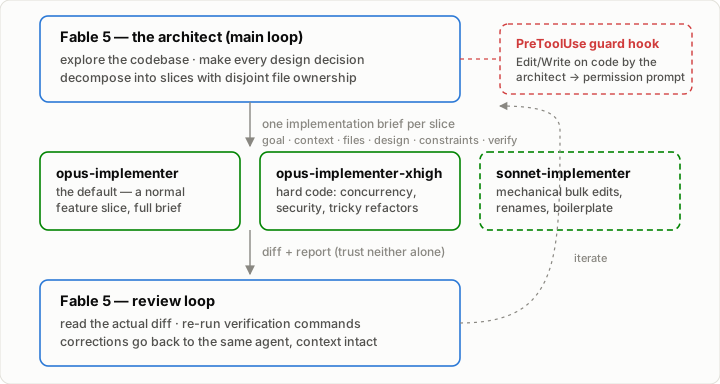
Skill fable-architect là một tệp markdown khoảng 100 dòng cộng thêm một shell hook, được nạp mỗi khi một phiên Claude Code chạy trên model tiên tiến. Nó thực thi một sự phân công lao động:
- Kiến trúc sư làm: chất vấn yêu cầu, khảo sát codebase, đưa ra mọi quyết định thiết kế — hướng tiếp cận, luồng dữ liệu, tên gọi, chữ ký hàm, các trường hợp biên — phân rã công việc thành những lát cắt độc lập, đánh giá các diff trả về, chạy kiểm tra, và viết toàn bộ phần văn bản (kế hoạch, bản tóm tắt, nội dung PR, thông điệp commit).
- Kiến trúc sư không bao giờ làm: viết hoặc sửa một tệp nguồn. Không có code trong chat ngoài những chữ ký hàm ngắn nằm trong một bản tóm tắt.
Ba điều khiến việc này vận hành được trong thực tế chứ không chỉ trên slide.
1. Bản tóm tắt chính là giao diện
Mỗi lát cắt nhận một bản tóm tắt triển khai. Người triển khai bắt đầu với một cửa sổ ngữ cảnh mới tinh — bất cứ điều gì không có trong bản tóm tắt, nó đều phải khám phá lại hoặc đoán. Ràng buộc đó là một đặc điểm hữu ích: nó buộc kiến trúc sư phải quyết định xong trước khi uỷ quyền. Một bản tóm tắt chứa các quyết định, không phải các lựa chọn.
## Bản tóm tắt triển khai: <slice>
Mục tiêu:     một câu, kết quả quan sát được
Ngữ cảnh:     những gì quá trình khảo sát đã tìm ra — trích đoạn, mẫu gần nhất
              để noi theo, mốc dòng, những cạm bẫy
Tệp:          đường dẫn cần tạo/sửa — quyền sở hữu độc quyền của lát cắt này
Thiết kế:     phương án đã chốt — luồng dữ liệu, tên gọi, chữ ký hàm, biên
Ràng buộc:    các quy tắc dự án được áp dụng: phong cách, tầng, bảo mật
Ngoài phạm vi: những gì không được chạm vào, kể cả tệp thuộc lát cắt khác
Uỷ quyền:     lát cắt này có được phép tạo sub-implementer không, và bao nhiêu
Kiểm tra:     các lệnh chính xác và kết quả mong đợi
Hai trong số những dòng đó mới hơn phần còn lại, và chúng tồn tại vì tầng người triển khai đã thay đổi ngay dưới chân chúng tôi — xem phần cập nhật bên dưới.
2. Cưỡng chế, không phải cảm tính
Một hook bảo vệ PreToolUse giám sát phiên: nếu kiến trúc sư cố sửa một tệp không phải văn bản, một lời nhắc cấp quyền sẽ được kích hoạt. Phê duyệt lời nhắc đó chính là ngoại lệ được ghi nhận cho các chỉnh sửa vặt vãnh (một lỗi chính tả, một lần tăng phiên bản — những trường hợp mà chi phí uỷ quyền còn cao hơn việc gõ phím). Ma sát chính là chính sách. Không có hook này, “model đắt tiền không nên viết code” chỉ tồn tại đúng cho đến thời hạn đầu tiên.
3. Vòng đánh giá khép lại khoảng cách chất lượng
Kiến trúc sư đọc báo cáo của agent và diff thực tế — không tin riêng cái nào — và chạy lại các lệnh kiểm tra then chốt khi lời khẳng định đó thực sự quan trọng. Phát hiện vấn đề? Bản chỉnh sửa được gửi trả lại chính agent đó, vốn vẫn giữ trọn ngữ cảnh làm việc. Không sửa tay, không khởi tạo lại từ đầu.
Lưu ý rằng đây là phần kiểm tra của kiến trúc sư, và nó vẫn giữ nguyên. Điều chúng tôi bắt đầu loại bỏ là phần kiểm tra mà trước đây chúng tôi viết vào các bản tóm tắt — những chỉ dẫn yêu cầu người triển khai tự kiểm tra lại. Các model triển khai mới hơn tự làm điều đó mà không cần nhắc, và việc bảo chúng làm lại chỉ mua thêm một lượt chạy thứ hai mà bạn đã trả tiền rồi.

Sẵn sàng phát triển doanh nghiệp của bạn?
Bắt đầu dùng thử miễn phí ngay hôm nay và xem kết quả trong vài ngày.
Những gì chúng tôi đo được
Để kiểm tra xem đây là một cơ chế kinh tế thực sự hay chỉ là một nghi thức dễ chịu, chúng tôi khai thác mọi bản ghi phiên Claude Code trong các dự án của mình, loại trùng các yêu cầu API và tính giá từng token theo mức giá niêm yết hiện hành. Ba giả thuyết, được đăng ký trước khi nhìn vào các con số theo từng phiên:
- H1 — Người triển khai là bên gõ phím. Nếu đúng, các subagent triển khai phải tạo ra nhiều token đầu ra hơn vòng lặp chính của kiến trúc sư trong những phiên có uỷ quyền.
- H2 — Uỷ quyền rẻ hơn. Nếu đúng, việc tính lại giá công việc của người triển khai theo mức giá của model kiến trúc sư phải cho ra kết quả đắt hơn đáng kể so với số tiền chúng tôi thực trả.
- H3 — Chất lượng được giữ vững. Đây là giả thuyết khó: code được uỷ quyền không nên cần phải làm lại nhiều hơn code do kiến trúc sư gõ.
Quy tắc cơ bản. Một yêu cầu API trải dài qua nhiều dòng bản ghi lặp lại cùng một đối tượng usage — chúng tôi nhóm theo ID yêu cầu, đếm token đầu vào và token cache một lần cho mỗi yêu cầu, và lấy ảnh chụp token đầu ra lớn nhất (cộng thô theo từng dòng sẽ đếm thừa 2–3 lần). Chi phí dùng mức giá niêm yết hiện hành của Anthropic — Fable $10/$50, Opus $5/$25, Sonnet $3/$15 trên mỗi triệu token đầu vào/đầu ra — với đọc cache tính 10% giá đầu vào và ghi cache tính theo mức giá của từng TTL. 31 trong số 354 phiên của kho tương tác đủ điều kiện là phiên fable-architect theo một bộ phân loại thận trọng; các con số thể hiện tám phiên đắt nhất. Chúng tôi báo cáo các tỷ lệ và phần trăm thay vì chi tiêu tuyệt đối của mình.
Phần 2 — Hoá đơn
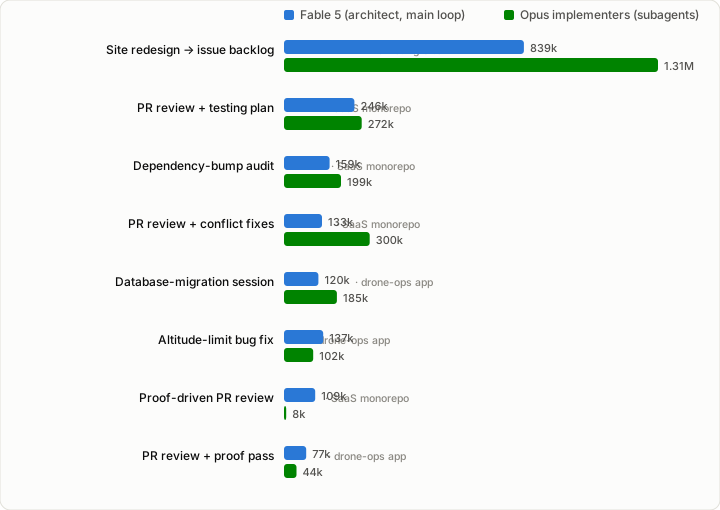
H1 — Kết quả hỗn hợp… theo cách tính đầu tiên. Trong những phiên uỷ quyền lớn nhất, giả thuyết này đúng một cách dứt khoát — đầu ra của người triển khai nhiều hơn tới 2.3× so với đầu ra của kiến trúc sư. Nhưng tính trên cả 31 phiên fable-architect, kiến trúc sư vẫn tạo ra nhiều đầu ra hơn người triển khai, 3.59M so với 3.15M token. Một phần điều đó là hợp lý — đầu ra của kiến trúc sư bao gồm toàn bộ kế hoạch, bản tóm tắt và văn bản đánh giá, đúng như công việc của nó — và một phần trông như những phiên chỉ uỷ quyền một lát cắt rồi giữ phần còn lại. Rồi chúng tôi nhớ ra rằng đợt thiết kế lại website của mình hoàn toàn không có cảm giác nặng về kiến trúc sư, và bắt đầu đi tìm những token mà cách hạch toán theo subagent không nhìn thấy.
Tham gia bản tin của chúng tôi
Nhận các mẹo, xu hướng và ưu đãi mới nhất miễn phí.
Kênh thứ hai: trình theo dõi issue như một tuyến uỷ quyền
Cách hạch toán theo subagent có một điểm mù: nó chỉ nhìn thấy những uỷ quyền diễn ra bên trong một phiên. Phiên thiết kế lại website — cột lớn nhất trong biểu đồ trên — hoá ra lại là một thứ hoàn toàn khác: một phiên vòng lặp kiến trúc sư duy nhất chạy liên tục 107 giờ (292 lần đánh thức theo lịch), chia đợt thiết kế lại thành các issue GitHub, gắn thẻ chúng cho pipeline CI của chúng tôi, rồi giám sát: thăm dò các lượt chạy, đánh giá các pull request của pipeline, mở các issue tiếp nối khi QA phát hiện lỗi.
Việc gõ phím diễn ra ở một nơi mà quá trình khai thác theo từng phiên của chúng tôi còn chưa từng nhìn tới: một đội runner tự vận hành riêng, nơi các giai đoạn plan → implement → gap-evaluation → review của pipeline chạy thành 252 phiên Opus độc lập trong 4.5 ngày, chạm tới 48 issue và PR khác nhau.
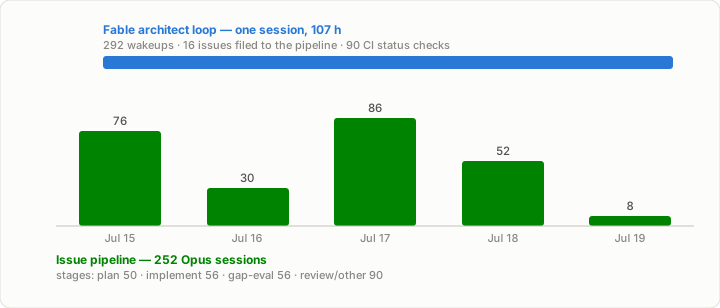
H1, xem lại — Được xác nhận ở quy mô dự án. Đếm cả hai kênh thì bức tranh đảo ngược: pipeline gõ nhiều hơn 10 lần số token đầu ra so với vòng lặp kiến trúc sư đã điều phối nó (9.07M so với 877k), tất cả đều ở mức giá Opus. Chạy đợt triển khai đó trên model của kiến trúc sư sẽ tốn gấp 2.1 lần — chỉ cho một đợt thiết kế lại, trong một tuần, chưa tính các subagent trong phiên. Một issue chỉ là một bản tóm tắt thô hơn: cùng giao diện, cùng kinh tế học, chỉ lên một cấp.
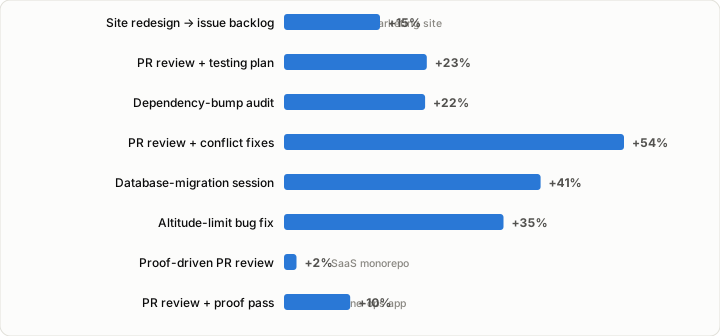
H2 — Được xác nhận, nhưng có một nút thắt. Tính lại giá đúng khối lượng token của người triển khai theo mức giá của model kiến trúc sư khiến mọi phiên đều đắt hơn — từ +2% đến +54%, và 17% tính trên tám phiên đắt nhất. Là tiền thật, nhưng nhỏ hơn mức mà khoảng cách giá đầu ra gấp 2 lần gợi ý. Nút thắt nằm ở đây: tiền không chảy vào phần đầu ra. Trong phiên lớn nhất, chi phí đọc cache của kiến trúc sư cao gấp khoảng 13 lần mọi thứ nó gõ ra — khoản chi chủ đạo là việc model đắt tiền giữ và đọc lại một ngữ cảnh điều phối lớn, chứ không phải việc gõ phím. Uỷ quyền giới hạn hoá đơn đầu ra; đòn bẩy tiếp theo là giữ ngữ cảnh của kiến trúc sư gọn gàng.
H3 — Không được đo ở đây. Kế toán token không nhìn thấy chất lượng code. Điều chúng tôi có thể nói từ quan sát: vòng đánh giá là bộ phận chịu lực — báo cáo và diff bất đồng đủ thường xuyên đến mức đọc cả hai là điều không thể bỏ qua — và các chỉnh sửa được định tuyến trở lại một agent còn nóng ngữ cảnh sẽ hội tụ nhanh. Nếu bạn tái lập điều này và đo lường phần làm lại một cách bài bản, chúng tôi muốn được xem, đặc biệt nếu nó phản bác chúng tôi.
Dữ liệu rộng hơn đã dạy chúng tôi điều gì
- Việc áp dụng là một dải chuyển tiếp, không phải một công tắc. Trên ứng dụng điều hành drone — nhỏ hơn, chuyển động nhanh hơn — 18% số phiên chạy theo mẫu fable-architect; trên monorepo SaaS lâu đời hơn là 9%. Dự án uỷ quyền mạnh nhất làm điều đó ở cả hai cấp độ cùng lúc: các bản tóm tắt triển khai trong phiên và 252 phiên pipeline được điều phối qua trình theo dõi issue.
- Đội CI không chạy skill — vì nó chính là người triển khai. Các phiên runner tự động của chúng tôi không bao giờ tạo ra subagent triển khai, và thoạt đầu điều đó bị đọc là không áp dụng. Nhưng các prompt nói điều ngược lại: mỗi phiên đều là một giai đoạn pipeline — verify, review, gap-evaluation — và khoảng sáu trong mười phiên làm việc với một issue hoặc PR cụ thể. Ở quy mô dự án, các runner pipeline chính là tầng người triển khai.
- Tầng rẻ nhất vẫn chưa có ngày làm việc đầu tiên. Toàn bộ hơn 78 lượt chạy triển khai đều thuộc hạng Opus; tầng Sonnet chuyên sửa máy móc chỉ mới được thêm gần đây và chưa từng được gọi. Dù đo được khoản tiết kiệm nào, đó cũng mới chỉ là mức sàn.
Giao diện mới là điểm mấu chốt: đưa vào bản tóm tắt, nhận về diff — đưa vào issue, nhận về PR. Vào ngày giá tăng, bạn thay người thợ xây, chứ không thay quy trình.
Công bố đầy đủ. Các model được xác minh từ chuỗi trong bản ghi phiên, không phải giả định. Chúng tôi đã tự sửa mình hai lần (một lần đếm thừa token theo từng dòng, rồi một lần bảng giá tạm). Phép đối chứng giả định rằng kiến trúc sư sẽ tiêu tốn đúng khối lượng token mà người triển khai đã dùng — sai số có thể lệch cả hai hướng. Các phiên pipeline nằm trong một kho bản ghi mà hai lượt khai thác đầu tiên của chúng tôi không quét tới; một ranh giới hạch toán đã che giấu một kênh uỷ quyền 9M token khỏi chúng tôi, và kho của bạn có lẽ cũng có một kênh như vậy. Đây là dự án của một kỹ sư, chủ yếu là công việc review-and-fix và phát triển tính năng — không phải một phép đo chuẩn có kiểm soát. Tập dữ liệu cũng khép lại trước khi Opus 5 ra mắt: mọi con số ở trên là Fable đóng vai kiến trúc sư trên những người triển khai thuộc hạng Opus 4. Giá của các bậc thang không thay đổi khi Opus 5 ra mắt, nên các tỷ lệ đo được vẫn đúng — nhưng xem phần tiếp theo để biết điều gì đã thay đổi.
Cập nhật — chiếc thang đã dịch chuyển dưới chân chúng tôi
Opus 5 ra mắt sau khi các đo lường này khép lại, và không có gì trong thang giá thay đổi: Opus vẫn là $5/$25 trên mỗi triệu token đầu vào/đầu ra, Fable vẫn là $10/$50, và biểu đồ ở trên vẫn đúng. Điều đã thay đổi là năng lực ở mỗi bậc thang. Anthropic định vị Opus 5 như một bước nhảy về suy luận sâu và công việc agent tầm xa — nói cách khác, đúng vào loại công việc tạo nên vai trò kiến trúc sư, với mức giá bằng một nửa tầng kiến trúc sư.
Điều đó chỉ thẳng vào nút thắt H2 của chính chúng tôi. Nếu chi phí chủ đạo của kiến trúc sư là đọc cache, và đọc cache chỉ được tính 10% giá đầu vào, thì một kiến trúc sư chạy trên Opus 5 đọc lại ngữ cảnh điều phối của mình với giá $0.50 mỗi triệu token thay vì $1.00 của Fable. Khoản mục từng tốn gấp 13 lần mọi thứ kiến trúc sư gõ ra sẽ bị cắt một nửa. Chúng tôi chưa đo điều này — đây chỉ là phép tính số học dưới cùng giả định khối lượng token bằng nhau mà chúng tôi đã nêu cho phép đối chứng 2.1×, và đây là thứ tiếp theo chúng tôi định kiểm nghiệm. Nếu điều đó đúng, câu hỏi thú vị sẽ không còn là chọn loại model nào mà trở thành liệu kiến trúc sư có cần bậc thang cao nhất hay không.
Ba điều ở tầng người triển khai mới làm thay đổi chính mẫu này, chứ không chỉ giá của nó:
- Nó sẵn sàng tìm đến subagent — ngược hẳn với thế hệ trước, vốn phải được thuyết phục mới chịu uỷ quyền. Một người triển khai lặng lẽ tạo ra những người triển khai của riêng nó sẽ nhân hoá đơn lên mà không ai để ý. Do đó mới có dòng
Uỷ quyền:trong bản tóm tắt: một lát cắt giờ đây nêu rõ liệu nó có được phép phân nhánh, và rộng đến đâu. - Nó tự kiểm tra công việc của mình mà không cần nhắc. Những chỉ dẫn kiểm tra viết cho các model cũ giờ chỉ mua thêm một lượt chạy thừa, nên chúng bị loại khỏi các bản tóm tắt. Vòng đánh giá của kiến trúc sư vẫn nguyên vẹn.
- Nó mở rộng phạm vi.
Ngoài phạm vi:không còn là dòng rập khuôn mà trở thành dòng giữ cho một lát cắt đúng là một lát cắt.
Và bậc thang mà chúng tôi chưa từng dùng cũng trở nên sắc bén hơn trong lúc chúng tôi không để ý: Sonnet 5 đạt chất lượng gần bằng Opus ở công việc viết code với mức $3/$15, cùng mức giá giới thiệu còn thấp hơn nữa đến hết tháng Tám. “Dù đo được khoản tiết kiệm nào, đó cũng mới chỉ là mức sàn” là một câu nói phòng thân khi chúng tôi viết nó. Giờ nó đọc như một cách nói giảm.
Phần 3 — Đích đến có chủ đích của hướng đi này
Chúng tôi đang chủ động lái theo hướng một sự phân tách mà chúng tôi cho rằng mọi đội kỹ thuật rồi cũng sẽ buộc phải áp dụng: model tiên tiến đắt tiền chỉ dùng để động não, thiết kế kiến trúc và đánh giá; model ngày càng rẻ để làm chính phần lập trình. Hiện nay những người triển khai của chúng tôi thuộc hạng Opus. Không có gì trong quy trình thay đổi khi chúng trở thành hạng Sonnet, hạng DeepSeek hay hạng Kimi — giao diện vốn không phụ thuộc model ngay từ thiết kế. Đó chính là toàn bộ giá trị chiến lược: vào ngày khoản trợ giá kết thúc và hoá đơn tăng gấp đôi, những đội có kỷ luật này chỉ đổi một dòng cấu hình. Những đội không có nó sẽ phải đàm phán lại toàn bộ cơ cấu chi phí trong tình thế bị ép.
Fable-architect mới là một bước đi chập chững — mức độ áp dụng còn một phần và tầng rẻ nhất vẫn chưa có lượt chạy đầu tiên. Nhưng đó là bước xây dựng cơ bắp: viết những bản tóm tắt đặc tả đầy đủ một lát cắt, đánh giá những diff mà bạn không gõ ra, và coi sự tập trung của model đắt tiền như một ngân sách. Và đợt thiết kế lại cho thấy cơ bắp đó dẫn tới đâu: một khi bản tóm tắt vận hành được, issue cũng vận hành được, và model đắt tiền không còn tham dự vào phần triển khai nữa.
Những gì bạn có thể làm ngay thứ Hai
- Tách vai trò trong bộ khung agent của bạn. Một quy tắc ở cấp phiên: model tiên tiến lập kế hoạch và đánh giá; uỷ quyền mọi chỉnh sửa tệp cho một agent triển khai rẻ hơn. Trong Claude Code, đây là một skill cộng với các định nghĩa subagent — một buổi chiều để thiết lập.
- Biến ranh giới thành cơ chế máy móc. Thêm một hook chặn trước khi sửa, thứ chất vấn chính những lần ghi tệp của model đắt tiền. Một quy tắc không tốn gì để phá vỡ sẽ bị phá vỡ trước thứ Sáu.
- Viết bản tóm tắt theo một mẫu cố định. Mục tiêu, ngữ cảnh, tệp, thiết kế, ràng buộc, ngoài phạm vi, ngân sách uỷ quyền, kiểm tra. Mẫu này chính là kỷ luật — và ngân sách uỷ quyền là thứ ngăn một người triển khai lặng lẽ tự tuyển thêm người.
- Đánh giá cả báo cáo lẫn diff. Đừng bao giờ tin riêng cái nào; hãy chạy lại những lệnh kiểm tra thực sự quan trọng.
- Đo lường sự phân tách của chính bạn. Các bản ghi phiên của bạn đã chứa dữ liệu — nhóm theo yêu cầu, tính giá theo model, và xem ai thực sự đang gõ phím. Của chúng tôi cho thấy một tầng rẻ chưa dùng đến và một kênh uỷ quyền 9M token mà chúng tôi không hề biết.
- Mở rộng giao diện từ bản tóm tắt sang issue. Một bản tóm tắt uỷ quyền một giờ làm việc; một issue uỷ quyền một ngày làm việc. Một khi các issue của bạn mang theo tiêu chí nghiệm thu mà một pipeline có thể hành động dựa trên đó, model đắt tiền có thể đưa công việc vào trình theo dõi và giám sát thay vì ngồi trong vòng lặp cho từng lát cắt.
- Giữ một lối thoát luôn ấm. Chạy một model rẻ hoặc model mở với vai trò người triển khai cho một lát cắt ít rủi ro mỗi tuần. Khả năng chuyển đổi mà bạn không bao giờ dùng đến là khả năng chuyển đổi bạn không có.
- Định giá lại kiến trúc sư, không chỉ người thợ xây. Mỗi lần model ra mắt đều dịch chuyển các bậc thang mà không dịch chuyển cả chiếc thang. Nếu phần lớn chi tiêu cho kiến trúc sư của bạn là ngữ cảnh chứ không phải gõ phím, một tầng kiến trúc sư rẻ hơn đáng giá hơn một tầng triển khai rẻ hơn — hãy kiểm tra xem bản ghi phiên của bạn nói bạn đang mua cái nào.
Các phòng thí nghiệm sẽ vẫn tiếp tục nói với chúng ta rằng những model hàng đầu của họ đáng giá ở mọi mức giá, và — một cách bực bội — với công việc đòi phán đoán thì phần lớn họ đúng. Nước đi không phải là từ bỏ. Mà là ngừng trả giá tiên tiến cho những vòng lặp for.
