


2026年最佳Browse AI替代品:8个网页抓取工具对比
寻找Browse AI替代品?我们对比了8个网页抓取和数据提取工具——从AI驱动的抓取器到完整的自动化平台——以找到最佳选择。...
2 分钟阅读
Web Scraping
Browse AI
+2
网页抓取已被AI彻底改变。传统爬虫每次网站更新HTML结构就会失效,而AI驱动的工具现在能语义化地理解页面内容——即使布局发生变化也能提取您需要的数据。2026年,最佳AI网页抓取工具将智能提取与工作流自动化相结合,无需人工干预即可将原始网络数据转化为可操作的业务输出。
本指南根据提取准确性、反爬虫处理、易用性、工作流集成和定价对10款最佳AI网页抓取工具进行排名。
| 工具 | 最适合 | 定价 | 免费版 | AI能力 |
|---|---|---|---|---|
| FlowHunt | 自动化工作流中的抓取 | 免费+按用量计费 | ✅ | 完整AI工作流集成 |
| Browse AI | 无代码监控与提取 | 从$48.75/月 | ✅(试用) | 变更检测AI |
| Apify | 使用预构建Actor的规模化抓取 | 免费/$49/月 | ✅ | Actor市场,AI提取 |
| Firecrawl | 适合LLM的网页内容提取 | 免费/$16/月 | ✅ | LLM优化Markdown输出 |
| Octoparse | 可视化无代码抓取 | 从$75/月 | ❌ | 点击式AI设置 |
| PhantomBuster | LinkedIn和销售数据抓取 | 从$56/月 | ✅(试用) | 销售导向提取 |
| Clay | 潜在客户数据丰富 | 从$149/月 | ✅ | AI丰富+个性化 |
| Bardeen | 基于浏览器的任务自动化 | 免费/$10/月 | ✅ | AI抓取脚本 |
| ScraperAPI | 开发者代理和抓取API | 免费/$49/月 | ✅ | 反爬虫绕过基础设施 |
| Bright Data | 企业级数据收集 | 定制 | ❌ | 最大代理网络,数据集 |
传统爬虫需要您指定精确的CSS选择器或XPath表达式。当网站更新其HTML时(这种情况经常发生),爬虫就会失效并需要手动修复。AI驱动的爬虫理解页面内容的语义含义,而不仅仅是其结构。“在此页面上找到产品价格"即使网站明天重新设计布局也能正常工作。
这一转变也首次使非开发者可以进行网页抓取。Browse AI和Octoparse等工具让营销分析师和销售研究人员无需编写一行代码即可提取数据。对于开发者,Firecrawl和Apify等工具提供了直接馈入AI管道的干净API。
FlowHunt与此列表上的所有其他工具不同,因为抓取不是一个独立功能——它是完全自动化AI工作流中的一个节点。FlowHunt不是提取数据然后手动决定如何处理它,而是让您构建管道,其中抓取触发AI分析,AI分析触发内容生成步骤,内容生成步骤触发CRM更新或电子邮件发送——全部自动完成。
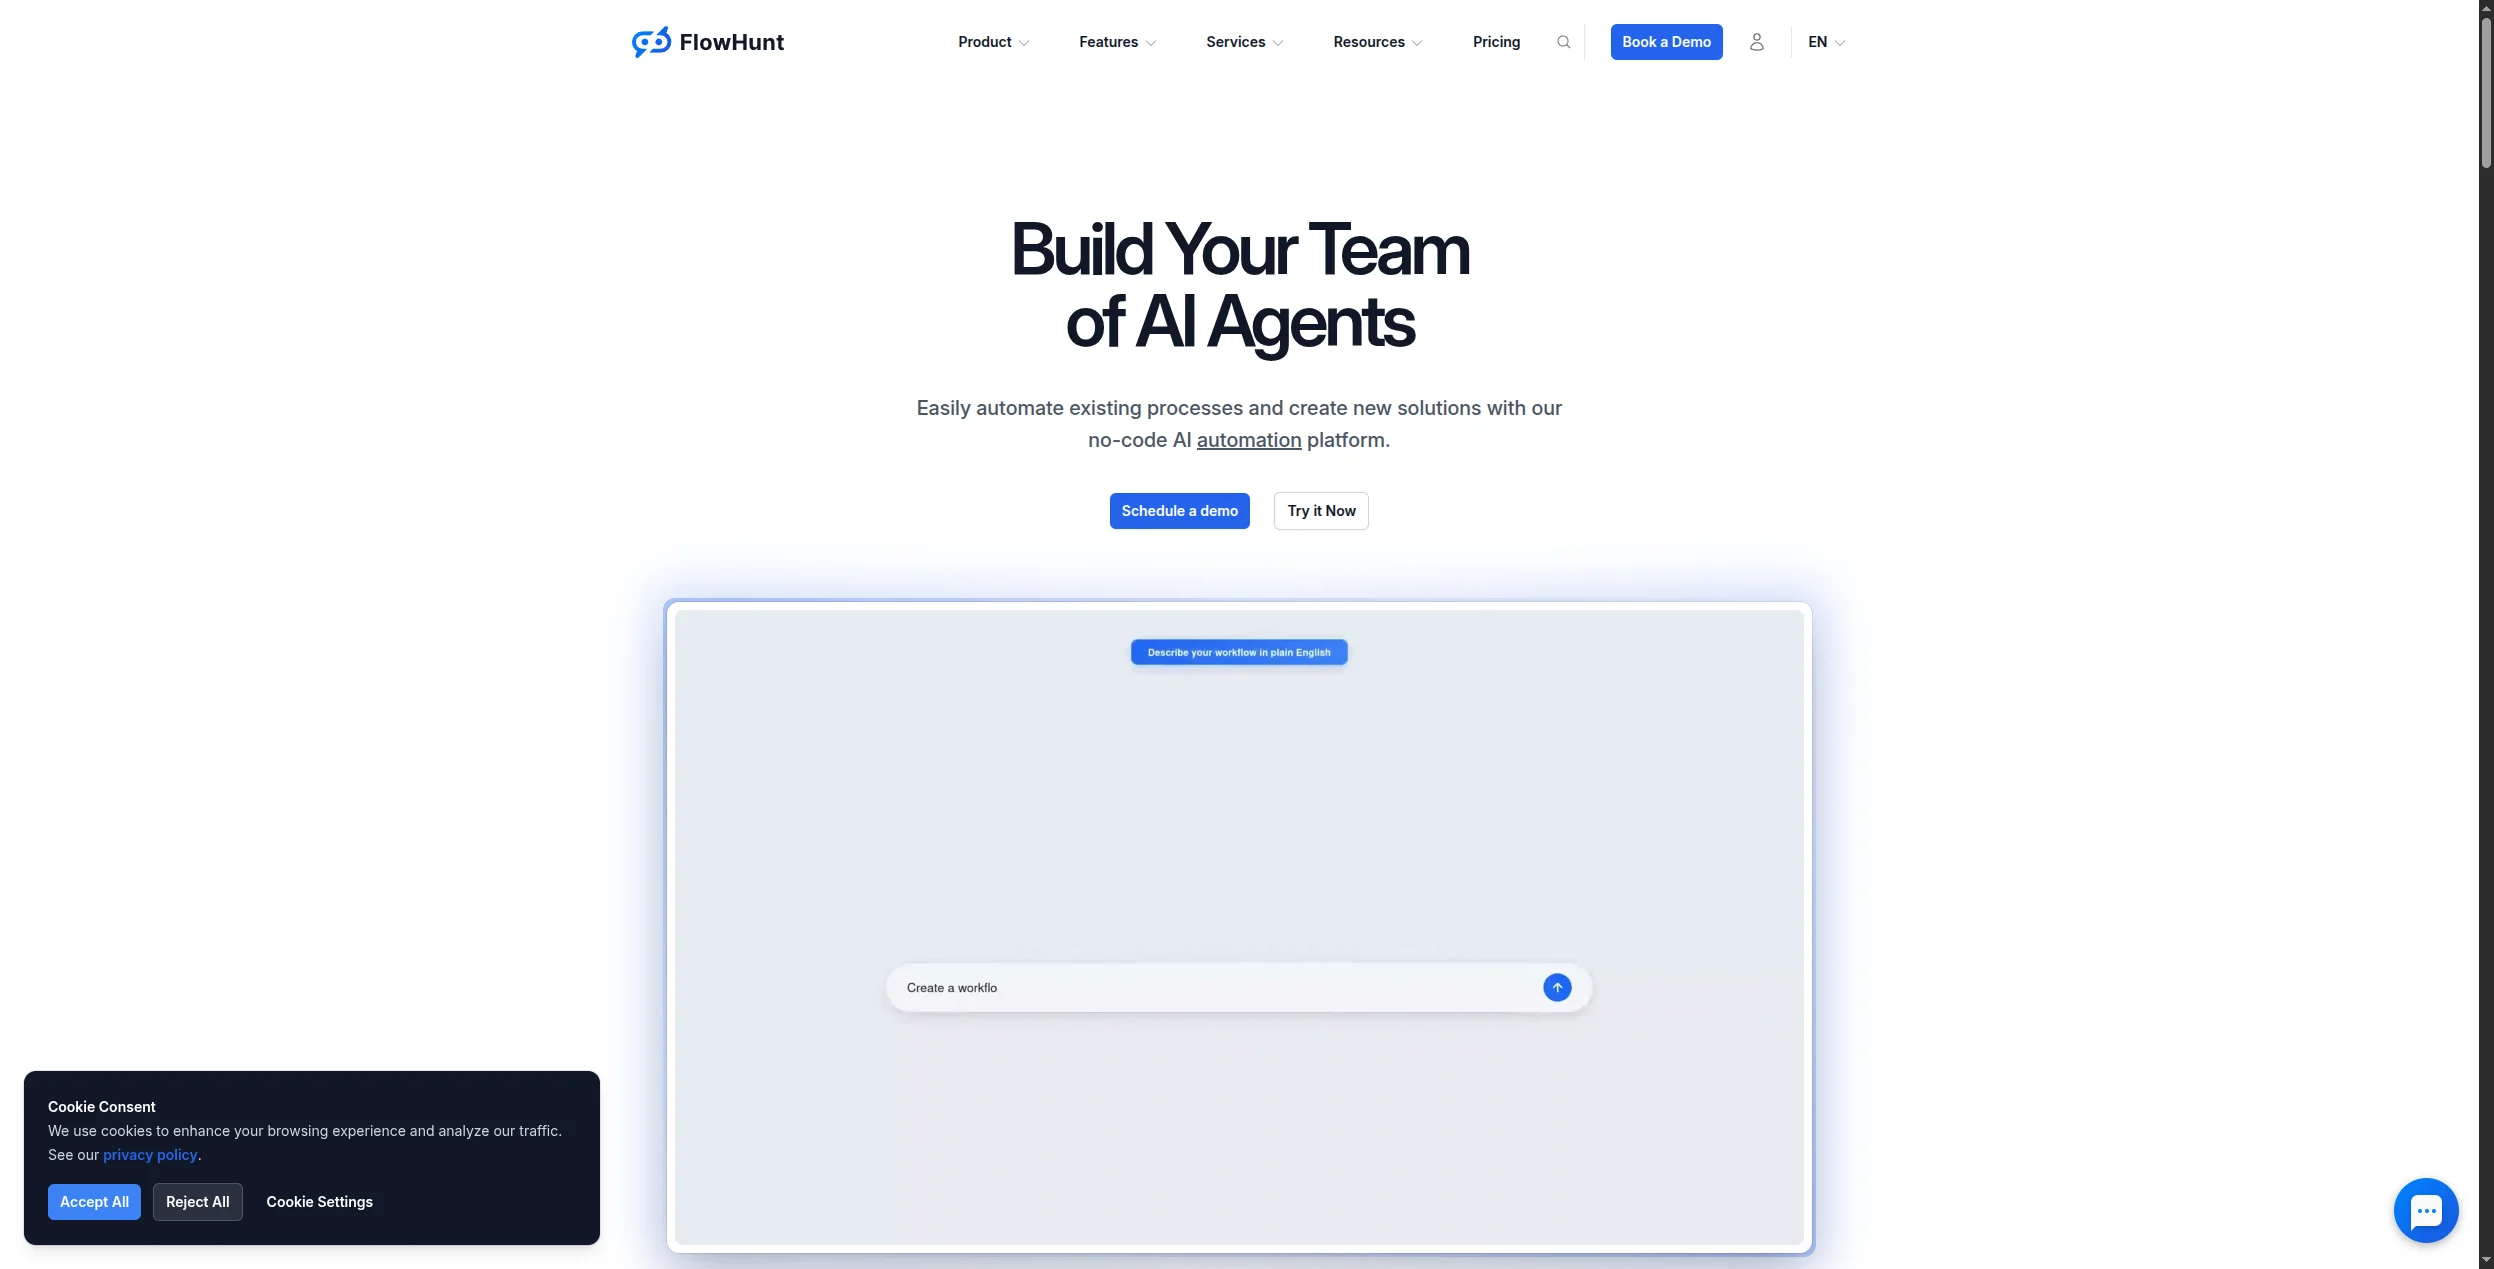
这对于商业用户来说是关键差异:您不仅仅获得数据,还获得该数据应该产生的输出。监控竞争对手定价页面,提取价格变化,并自动起草一封关于如何响应的电子邮件给您的销售团队——在单个自动化流程中完成。
FlowHunt的独特之处:
定价: 有执行积分的免费版。按使用量计费的付费计划。
优点:
缺点:
最适合: 需要自动处理网络数据的营销、销售和运营团队——而不仅仅是提取和导出。有关多代理研究管道,请参阅我们的多代理AI系统指南 。
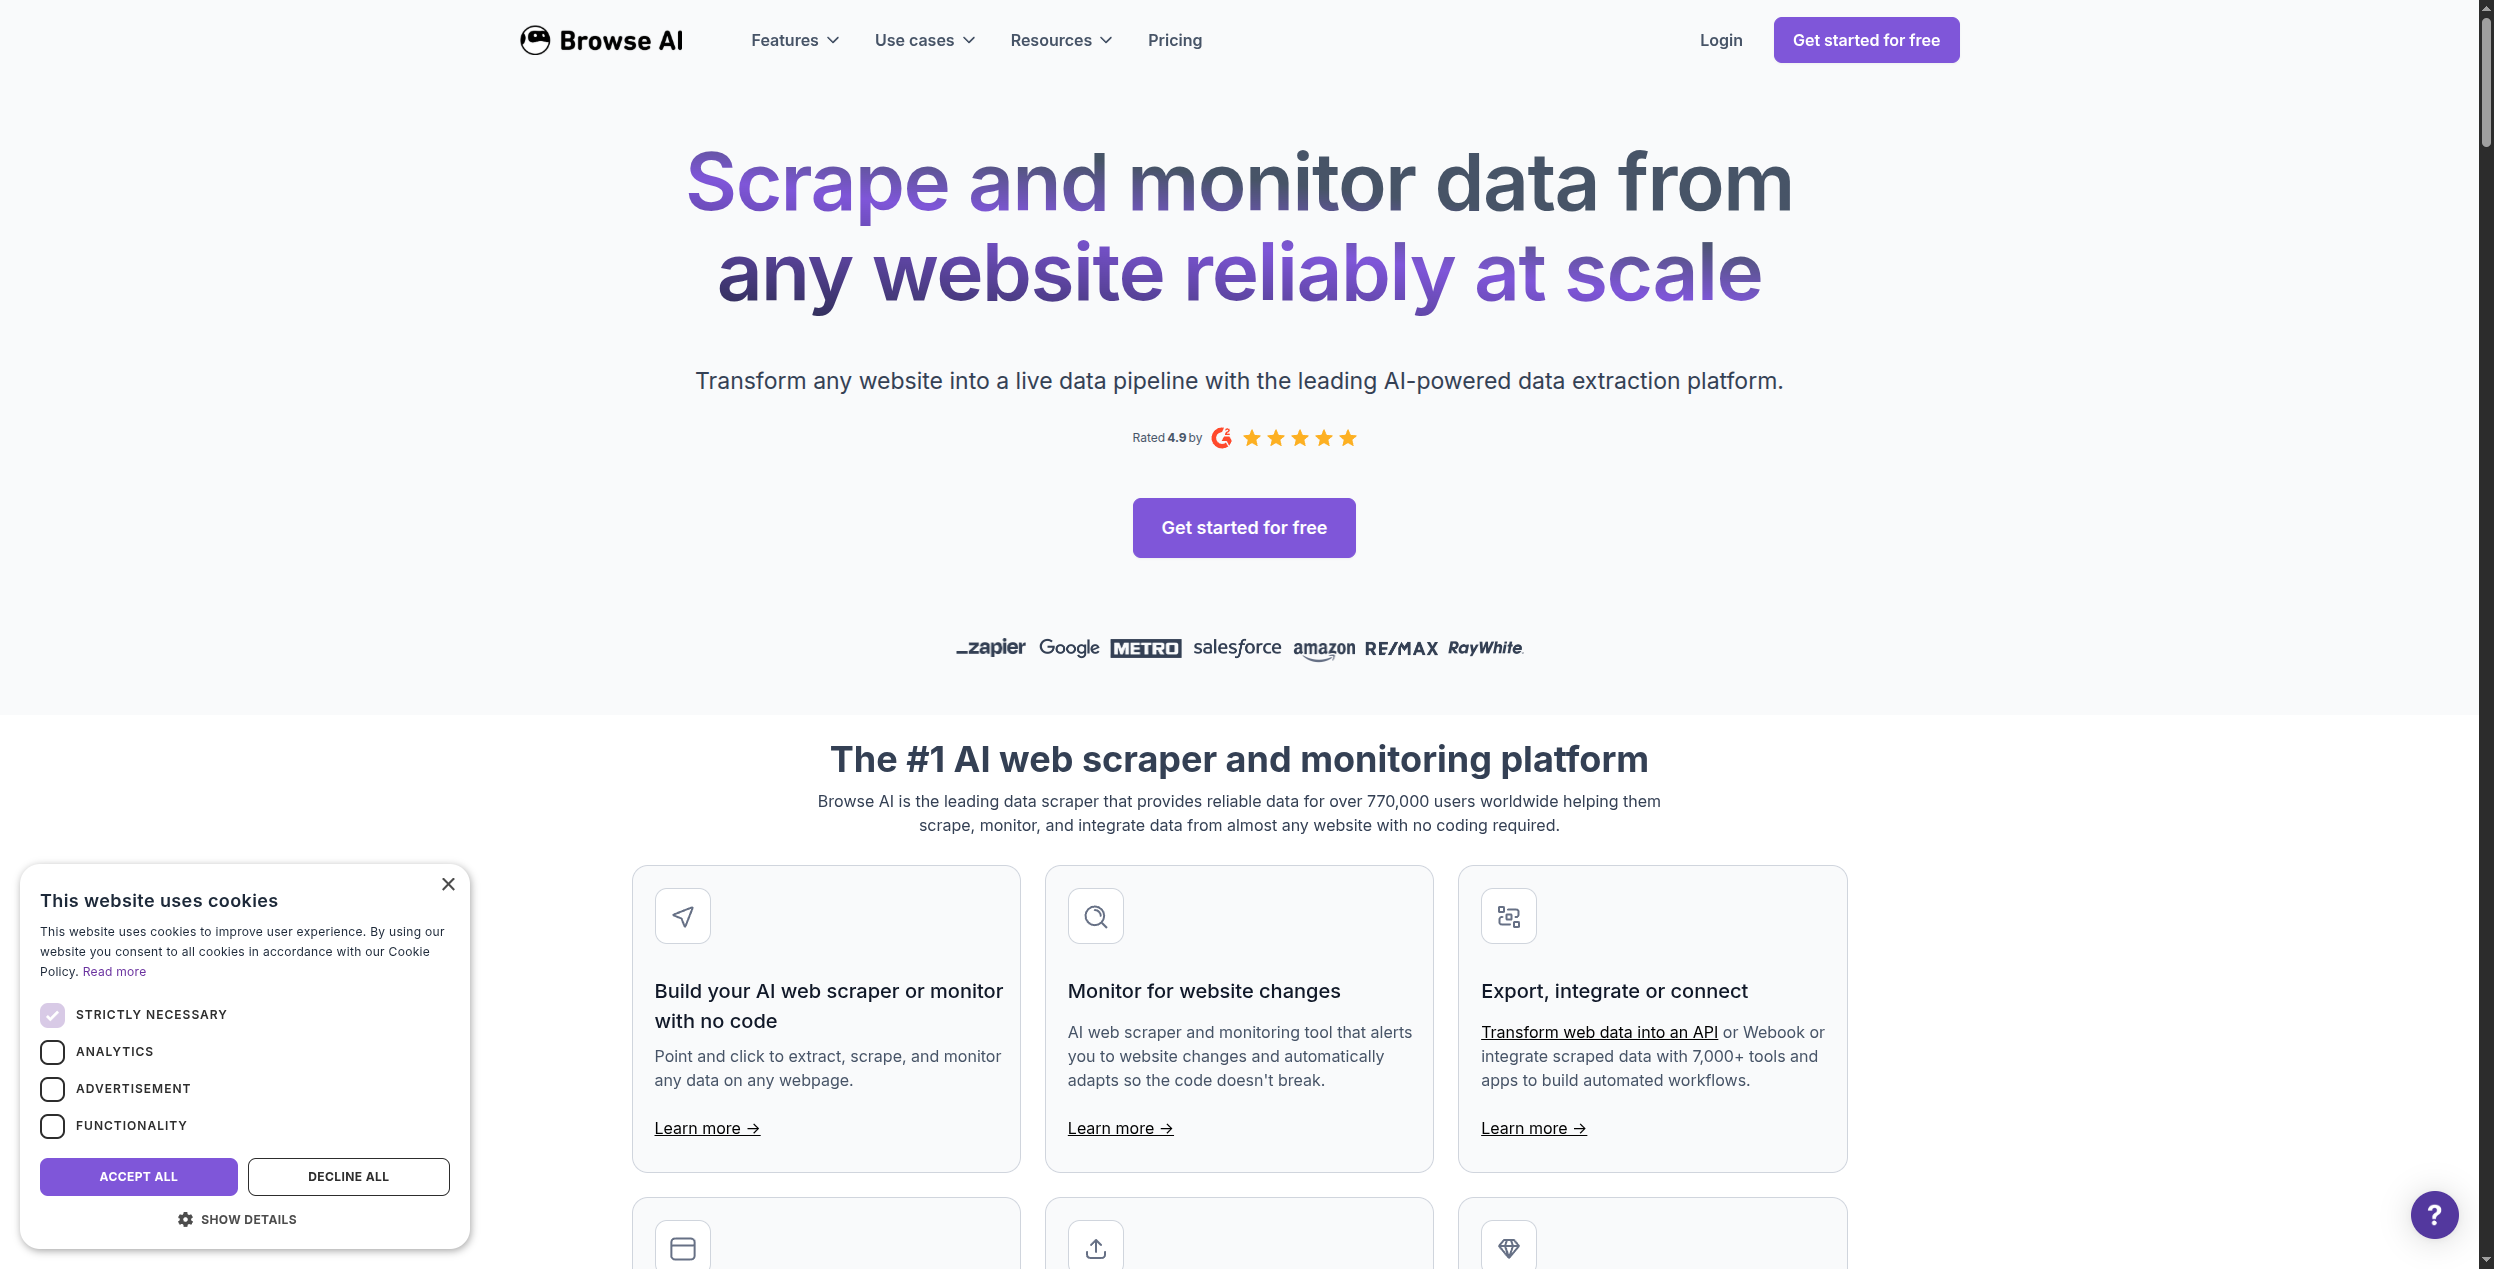
Browse AI是商业用户最易访问的无代码抓取工具。您通过点击网站上的元素来教它提取什么——无需代码,无需CSS选择器。然后它按计划运行,当数据变化时向您发出警报(或触发Zapier操作)。它在价格监控、列表跟踪和竞争对手情报方面特别强大。
优点:
缺点:
最适合: 需要在不涉及开发者的情况下监控特定网页变化的商业用户。

免费获取最新提示、趋势和优惠。
Apify是现有最完整的云端抓取平台。其市场包含1,500多个用于主要网站的预构建Actor(现成爬虫)——Amazon、LinkedIn、Instagram、Google Search等数百个。对于开发者,基于Playwright/Puppeteer的完整SDK让您可以构建在Apify云基础设施上运行的自定义爬虫。
优点:
缺点:
最适合: 需要可靠、可扩展云基础设施用于自定义和预构建网页抓取的开发者。
Firecrawl专为需要干净、结构化数据馈入LLM管道的AI团队而构建。其API将任何URL(或整个域名)转换为干净的Markdown,去除导航、广告和样板内容,并自动处理JavaScript渲染。输出经过优化,可直接传递给GPT-4、Claude或Gemini——无需预处理。
优点:
缺点:
最适合: 构建RAG管道、研究代理或任何需要将干净网络内容作为LLM输入的系统的AI开发者。
Octoparse是非开发者中最强大的可视化点击式网页爬虫。其桌面和基于云的界面让您可以可视化地选择元素、处理分页、设置需要登录的抓取以及安排云端运行。内置反爬虫绕过功能,包括IP轮换。
优点:
缺点:
最适合: 需要在没有编程技能的情况下从多页面网站提取复杂结构化数据的业务分析师和研究人员。
PhantomBuster不是通用爬虫——它专为从LinkedIn、Sales Navigator、Twitter和类似平台提取销售和潜在客户生成数据而构建。其Phantom(预构建爬虫)处理LinkedIn个人资料丰富、公司数据、连接请求和帖子参与度抓取。
优点:
缺点:
最适合: 需要自动化LinkedIn和社交平台数据提取用于潜在客户挖掘的销售开发团队。
Clay是一个潜在客户挖掘和数据丰富平台,将网页抓取与50多个外部数据源——LinkedIn、Clearbit、Hunter、ZoomInfo等——相结合,然后使用AI根据丰富的个人资料撰写个性化外联内容。它不太像纯爬虫,更像是完整的潜在客户情报工作流。
优点:
缺点:
最适合: 希望大规模进行AI个性化潜在客户挖掘、每位联系人结合多个数据源的出站销售团队。
Bardeen是一个Chrome扩展,让您可以构建在浏览器中运行的AI驱动自动化脚本。对于抓取,这意味着您可以从正在查看的页面提取数据,根据页面内容触发工作流,以及自动化重复的研究任务——所有这些都无需离开您的浏览器。
优点:
缺点:
最适合: 需要在日常工作中自动化基于浏览器的研究和数据收集任务的个人贡献者。
ScraperAPI不是抓取工具——它是使现有爬虫更可靠的基础设施层。它作为服务处理代理轮换、验证码解决、浏览器指纹和JavaScript渲染。向其传递URL;它返回HTML,就好像是真实用户访问的一样。对于构建自己的爬虫并需要可靠绕过基础设施的开发者来说是必不可少的。
优点:
缺点:
最适合: 构建自定义爬虫并需要可靠代理基础设施来避免封锁和验证码的开发者。
Bright Data是大规模网络数据操作的企业标准。其代理网络(7200万以上IP)是行业中最大的。除代理外,Bright Data还提供Web Scraper IDE、预收集数据集(可直接下载)和用于复杂JavaScript网站的浏览器API。它被财富500强公司和主要数据操作使用。
优点:
缺点:
最适合: 企业数据团队、市场情报公司以及运营大规模连续数据收集操作的组织。
按技术专业知识:
按使用场景:
按是否需要自动化: 如果您需要处理抓取的数据——而不仅仅是导出它——FlowHunt是此处唯一将抓取直接连接到下游AI工作流的工具。有关如何构建数据管道,请参阅我们的最佳工作流自动化工具指南 。
对于纯粹的大规模提取,Bright Data和Apify胜出。对于无代码商业用户,Browse AI是最易访问的工具。对于构建AI管道的开发者,Firecrawl提供最干净的输出。
但如果您的目标是自动将网络数据转化为业务行动——监控竞争对手、丰富CRM记录、从研究生成内容——FlowHunt是唯一无需手动步骤即可完成闭环的平台。它是真正能对所发现内容采取有用行动的爬虫。
阿尔西亚是 FlowHunt 的一名 AI 工作流程工程师。拥有计算机科学背景并热衷于人工智能,他专注于创建高效的工作流程,将 AI 工具整合到日常任务中,从而提升生产力和创造力。
寻找Browse AI替代品?我们对比了8个网页抓取和数据提取工具——从AI驱动的抓取器到完整的自动化平台——以找到最佳选择。...
Apify功能强大但对大多数用例来说复杂且昂贵。我们比较了8个Apify替代品用于网页抓取和数据提取——从无代码工具到开发者API。...
排名与评测:2026年最佳的12个工作流自动化工具。对比表、定价、免费层级,以及关于哪个平台适合您团队的明确建议。