


简要版本
- 我从 FlowHunt 的待办列表里拿了一个真实的 issue,让 Claude Code 在 Opus 5.5 上实现了 13 次,用了七套不同的指令配置。每次运行都从同一个 commit 开始,在各自的 clone 和各自的数据库里,并经过我们真实的 GitHub CI。两个盲审 Opus 评审给每个结果打分。
- 仓库里 33 KB 的 CLAUDE.md 并没有换来可衡量的质量。带着它运行,每次评审得到 2.0 个 blocker 和 major 问题。一次完全没有指令文件的运行得到同样的结果。一个 5.5 KB 的文件得到 1.0。
- 单独的规划阶段让情况更糟。两套先跑规划提示、再跑实现提示的配置,成本都高于它们用普通提示的对照版本,而且在全部 26 次评审的五个 blocker 中贡献了四个。
- 获胜者是一个 8 KB 的 CLAUDE.md、三个 skill、Sonnet worker,以及一段普通提示。它的两次运行按 API 标价平均 $6.68。带流水线提示的完整配置平均 $11.49,约为 1.7 倍,而且问题更多。
- 在我搭起来的所有结构里,活下来的是 brief:由主模型为更便宜的 worker 写的一段简短、已定稿的一小片工作描述。为主模型自己写的计划并没有回报。模型自己规划得就很好。
本文承接 architect 模式 那篇文章,它测量了应该由谁来敲代码。这篇则问:主模型在开工之前需要被告知多少。
我为什么跑这个测试
我们的 monorepo 积累了大量 agent 指令。根目录的 CLAUDE.md 有 33 KB:构建命令、测试节奏、代码风格、架构、关键路径、安全规则、权限与积分规则、两个 agent 界面、issue 提交、PR 约定。.claude/skills/ 下放着十个 skill。在此之上,我们的 CI 流水线(我们叫它 harnext)让一个 issue 依次经过打标签器、分类步骤、把计划写成 issue 评论的规划步骤,以及把计划读回来并写代码的实现步骤,每一步都有自己冗长的 system prompt。
那里的每一行都是出于某个理由加上去的,通常是在某个 agent 出错之后。但没人问过的问题是:它现在还有用吗。CLAUDE.md 会被载入每个会话,并在每一轮重新发送。如果模型本来就会做对的事,那些 token 就是一笔税;正如 上下文窗口的成本 所解释的,每一轮的税累积起来比看上去要快。
测试
这个 issue 是给新注册用户的定时邮件序列:管理员定义诸如"第 0 天:欢迎"和"第 5 天:你的试用期即将结束"这样的步骤,一个后台任务在正确的日子给每个账户发邮件,一旦对方购买了付费方案就停止,并跳过在发布之前创建的账户。它需要一次 migration、一个 repository、一个 service、一个 Celery beat 任务、REST 端点、给 agent 用的 MCP 工具,以及一个支持 11 种语言的控制台 UI。这是一个真实的"第一周"功能,而且它有几个容易漏掉的边界情况。
每次运行都是一个无头 Claude Code 会话,运行在 Opus 5.5 上,沙箱隔离在各自的 clone 和数据库中,并配一个脚本把它的 commit 推送到 draft PR,再把 CI 结果回喂给会话,最多三轮。成本是 Claude Code 自己的 total_cost_usd,包含主会话和每一个 subagent,按 API 标价计算。我用的是订阅,所以这衡量的是工作量,而不是我的账单。
七套配置:
| 配置 | 运行次数 | |
|---|---|---|
| A | 完整的 33 KB CLAUDE.md 和十个 skill,流水线提示(先规划,再实现) | 2 |
| B | 完整的 CLAUDE.md 和 skill,普通提示 | 3 |
| C | 无 CLAUDE.md,无 skill,普通提示 | 2 |
| D | 完整 CLAUDE.md 加上 architect skill,普通提示 | 2 |
| E | 8 KB CLAUDE.md,architect、grain-ponytail 和 unslop,流水线提示 | 1 |
| F | 5.5 KB CLAUDE.md,无 skill,普通提示 | 1 |
| G | 8 KB CLAUDE.md,architect、grain-ponytail 和 unslop,普通提示 | 2 |
A 到 D 先做。E 到 G 是根据它们显示出的结果搭出来的,第三次 B 运行作为对照与它们并列。8 KB 文件是 5.5 KB 那份加上一份简短的 skill 清单及何时加载它们,以及让 architect skill 委派给 Sonnet 的模型路由规则。
之后每个结果都交给两位 Opus 评审,他们只看到一个字母、diff、仓库和 issue。他们列出在批准之前会要求修改的每一处,评级为 blocker、major、minor 或 nit,并逐条对照文件和行号检查每个验收标准。
成本
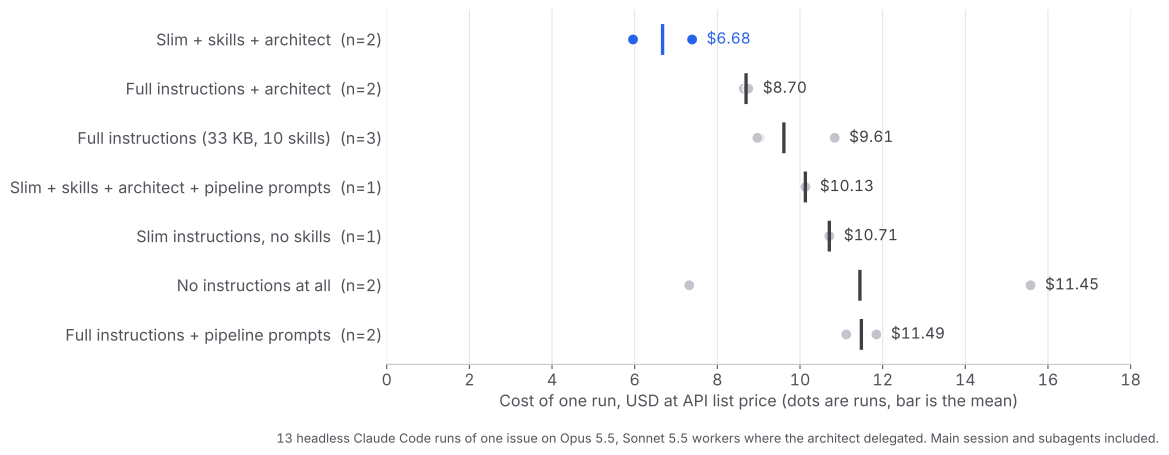
获胜配置 G 花了 $5.96 和 $7.39。带流水线提示的完整配置 A 花了 $11.12 和 $11.85。差距主要在于轮数和每一轮承载的内容。A 的主会话在 Opus 上跑了 172 和 144 轮,输入 token 为 2,400 万到 2,800 万。G 的跑了 79 和 95 轮,输入 token 为 1,300 万到 1,600 万,并把大约多出 60 轮交给 Sonnet worker,后者的计费只有一小部分费率。G 还在约 21 分钟内完成了工作,而 A 用了 45 分钟。
这张图上有两件事让我意外。完全没有指令并不是便宜选项:它的两次运行花了 $7.32 和 $15.58,而且贵的那次还 CI 失败,写出了整场测试中最大的 diff。而没有 skill 的 5.5 KB 文件 F,也并不比完整配置便宜。它写了更多代码,1,601 行产品代码,并为此付了钱。G 的节省并不只来自短文件。它来自短文件加上那两个改变工作方式的 skill。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
质量
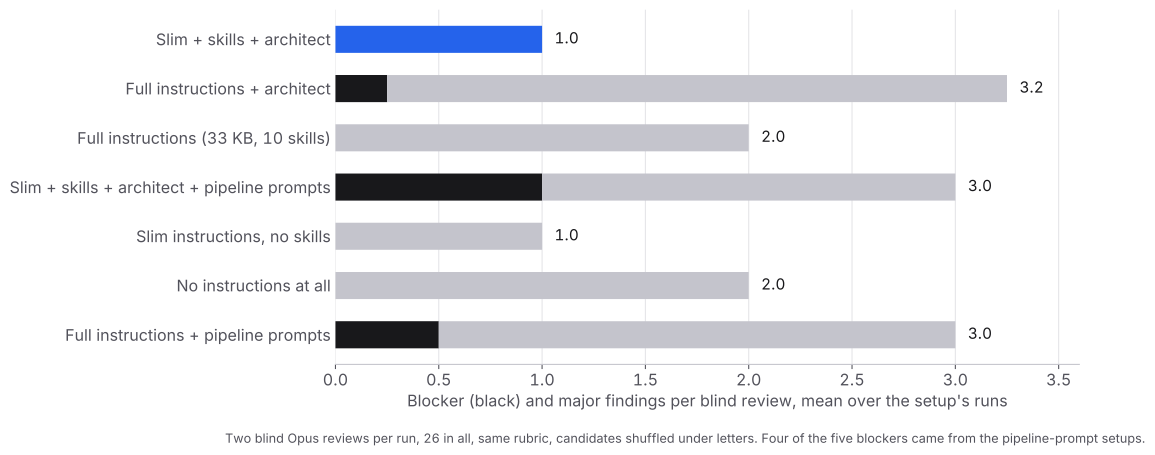
最便宜的配置严重问题也最少:没有 blocker,两次运行每次评审分别为 1.5 和 0.5 个 major。完整的 CLAUDE.md(B)三次运行都是 2.0 个 major,和完全没有 CLAUDE.md 一样。
这是我最在意的结果。这个文件里有很长的关于安全、权限和积分的章节,是因为某个 agent 曾经跳过它们才写的。有或没有这个文件,评审都发现了同样数量的严重问题,而且同样的几类问题在各配置间反复出现:注册后付费又取消的用户;worker 中途失败时邮件丢失或被发两次;编辑器覆盖了它无法显示的内容。这些都是关于状态随时间变化的推理缺口。CLAUDE.md 里没有任何规则清单覆盖它们,因为你无法为你还没想到的边界情况写规则。
真正覆盖它们的是两轮之间对 architect skill 的一处改动。现在,在主模型写任何 brief 之前,它会先写一张表:每条验收标准、当它所依赖的状态随时间变化时会发生什么、以及已定稿的行为。每一行随后带着一个具名测试进入 brief。G 的运行写了 774 和 818 行测试,而 B 是 510 到 670 行。
规划阶段
A 和 E 是两套跑了我们 CI 流水线提示的配置:一段写出计划的规划提示,然后一段读计划并执行它的实现提示。把每一套与它改用普通提示的对照版本比较。A 每次运行 $11.49,B 是 $9.61,而 A 有 blocker,B 没有。E 是 $10.13,G 是 $6.68,而 E 每次评审都有 blocker,G 没有。
我认为原因是:计划是模型为自己写的一份文档,然后必须把它当作外部指令读回来。第二个会话把计划当作规格说明,在它错的地方照做,还要花轮数把它和在代码里发现的情况对齐。如此有能力的模型,在即将动手做这项工作的那个会话内部规划得更好,因为计划和代码在同一个上下文里。
规划中活下来的那部分是 brief。当主模型把一小片工作交给 Sonnet worker 时,worker 从空上下文开始,完全照着被告知的去构建。这种交接需要一份写好的、已定稿的描述:目标、文件、要模仿的模式、边界情况、要写的测试。为自己写的计划是开销。为别人写的 brief 是工作得以传达的唯一方式。
grain-ponytail 做了什么
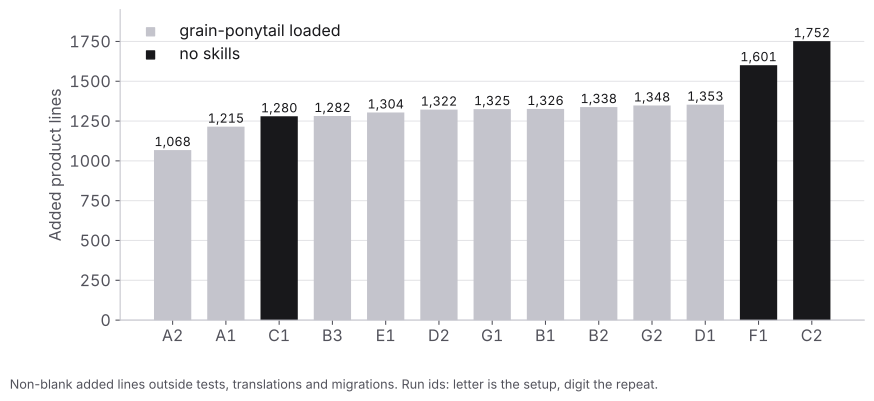
来自 顺势写代码 的这个 skill 让模型模仿最近的一个现有示例,并交付能起作用的最少代码。每一次加载了它的运行都写了 1,068 到 1,353 行产品代码。两个最大的 diff,1,601 和 1,752,来自没有 skill 的运行。有一次无 skill 的运行停在 1,280,所以这个 skill 本身并不决定规模,但它削掉了长尾。
这也是"什么样的指令仍然值得"最清楚的例子。“模仿最近的示例"改变了模型写每个文件时的做法。“函数用 snake_case"只是重述它本来就会做的事。
评审仍然抓到了什么
获胜的运行并不干净。测试之后,我把 G2 的工作 rebase 到 main 上,并让它走我们完整的 PR 检查,那会评审 diff、用一个失败的测试证明每一条发现,并在真实浏览器里驱动这项改动。它发现:当管理员编辑一个通过 MCP 创建的步骤时,步骤编辑器会丢掉除第一个 HTML 块之外的所有块;以及一次失败的 claim 释放可能给某些用户发两次邮件。两者都在 PR 提交人工评审之前带着测试修好了。
盲审还指出,architect 类运行中的过度设计比完整指令类运行更多:G 每次评审 2.5 项,而 A 和 B 的运行是 0 到 1.0。严重问题更少,琐碎问题更多。我愿意接受这笔交易,但它确实是一笔交易。
我改了什么
- 33 KB 的 CLAUDE.md 变成了 12 KB 的 AGENTS.md,Codex 也会读它,而 CLAUDE.md 现在只导入它。它保留了命令、测试节奏、架构,以及模型无法从代码中推断的规则,比如哪些路径是关键路径、两个 agent 界面必须保持同步。
- 流水线里的规划阶段没了。分类直接把 issue 交给实现阶段,其提示缩短到六步:读 issue、开分支、加载 architect 和 grain-ponytail skill、测试、commit、开 draft PR。
- architect skill 增加了边界情况表、brief 里的 Tests 字段,以及最后一遍检查:把整个 diff 对照 issue 而不是对照 brief 来核对。那个版本公开在 github.com/LivinTribunal/architect-skill 。
撰写本文时,仓库的改动正在评审中。
可以从中得到什么
如果你的 CLAUDE.md 是一次事故一次事故地长起来的,它很可能在为模型本来就会遵守的规则付费。把它削减到模型无法通过读代码得知的内容,并在一个真实任务上测量前后,而不是相信"指导越多越安全”。
保留那些改变工作方式的指令:谁来敲代码、一小片工作如何被 brief、要复制哪个现有模式。如果你的主模型是当前的前沿模型,就砍掉"先规划再执行"的流水线。为 worker 写 brief,而不是为自己写计划。
方法
2026 年 10 月 5 日,Claude Code 2.1.289 的 13 次无头运行,主模型 Opus 5.5,在 architect skill 委派时 worker 为 Sonnet 5.5。所有运行都从 FlowHunt monorepo 的同一个 commit 开始,各自在一个 APFS clone 中,有自己的 Postgres 数据库,与其他运行以及实验自身的文件沙箱隔离。一个 broker 把每次运行的 commit 推送到针对一个冻结的 base branch 的 draft PR,并用 CI 结果恢复会话,最多三轮。成本是每个会话的最大 total_cost_usd,在主会话及其 subagent 上求和。产品代码行是测试、翻译和 migration 之外的非空新增行。
每个结果都由 Opus 做了两次盲审,用同一套评分标准:正确性、验收标准、grain、私有字段与隐藏状态、过度设计、安全与权限、测试、migration。候选结果被打乱并用字母标记,评审可以读仓库但不能运行任何东西。每次评审的发现数是按某套配置的运行取平均。每套配置只有一到三次运行,请把单个配置的均值视为噪声很大。上面的结论是两轮都成立的那些。
