


大多数无法排名的内容并不是写得差,而是简报做得差。一位技术娴熟的写作者,如果被给予错误的搜索意图、看不到竞争对手的覆盖范围、也不知道这个查询真正需要哪些子主题,照样会写出一篇无法排名的页面。因为意图不匹配是技术过硬的页面无法排名最常见的原因 ,而这一不匹配在写出第一句话之前就已经被锁定了。
理解内容为什么无法排名,要从诊断简报开始,而不是修改草稿。以下是大多数排名问题背后的五种简报失败,以及如何逐一系统性地修复它们。
在动笔之前就扼杀排名的 5 种简报失败
这每一种失败都发生在简报阶段,这正是为什么事后再怎么修改都无济于事:
- 瞄准了错误的搜索意图 —— 内容类型与搜索者真正想要的东西不匹配。
- 忽视排名靠前的竞争对手覆盖了什么 —— 简报是在真空中写成的,而不是针对当前的 SERP 写成的。
- 缺失满足查询完整性的子主题 —— 大纲覆盖了关键词,但没有覆盖完整主题。
- 错误的受众和漏斗阶段 —— 文章在对错误的读者、在他们决策过程中的错误节点说话。
- 没有清晰的差异化角度 —— 简报产出的内容只是与竞争对手持平,而不是超越他们。
一旦文章带着其中任何一个问题发布出去,一次校对式修改是无法修复它的 。结构必须改变,往往连整个角度都要改变。
失败 1:瞄准了错误的搜索意图
成百上千个技术优化到位、外链强劲的页面无法排名,仅仅因为它们对于该查询来说是错误的内容类型。例如,一个服务页面试图瞄准 “如何做” 类搜索,或者一篇博文试图瞄准 “购买” 类搜索。搜索意图有四种核心类型:信息型、导航型、商业调研型和交易型。每一种都需要根本不同类型的页面,而不只是在同一种格式里塞进不同的关键词。
识别真实意图最可靠的方法,是阅读该关键词当前排名前五的结果,因为那正是 Google 已经认定与该查询匹配的内容。带有对比表格和购买者清单的对比文章会为商业调研类查询排名,而结构清晰的释义型科普文会为信息型查询排名。把两者混在一起,或者靠猜某个关键词需要哪一种,是最快写出没人想要的页面的方式之一。
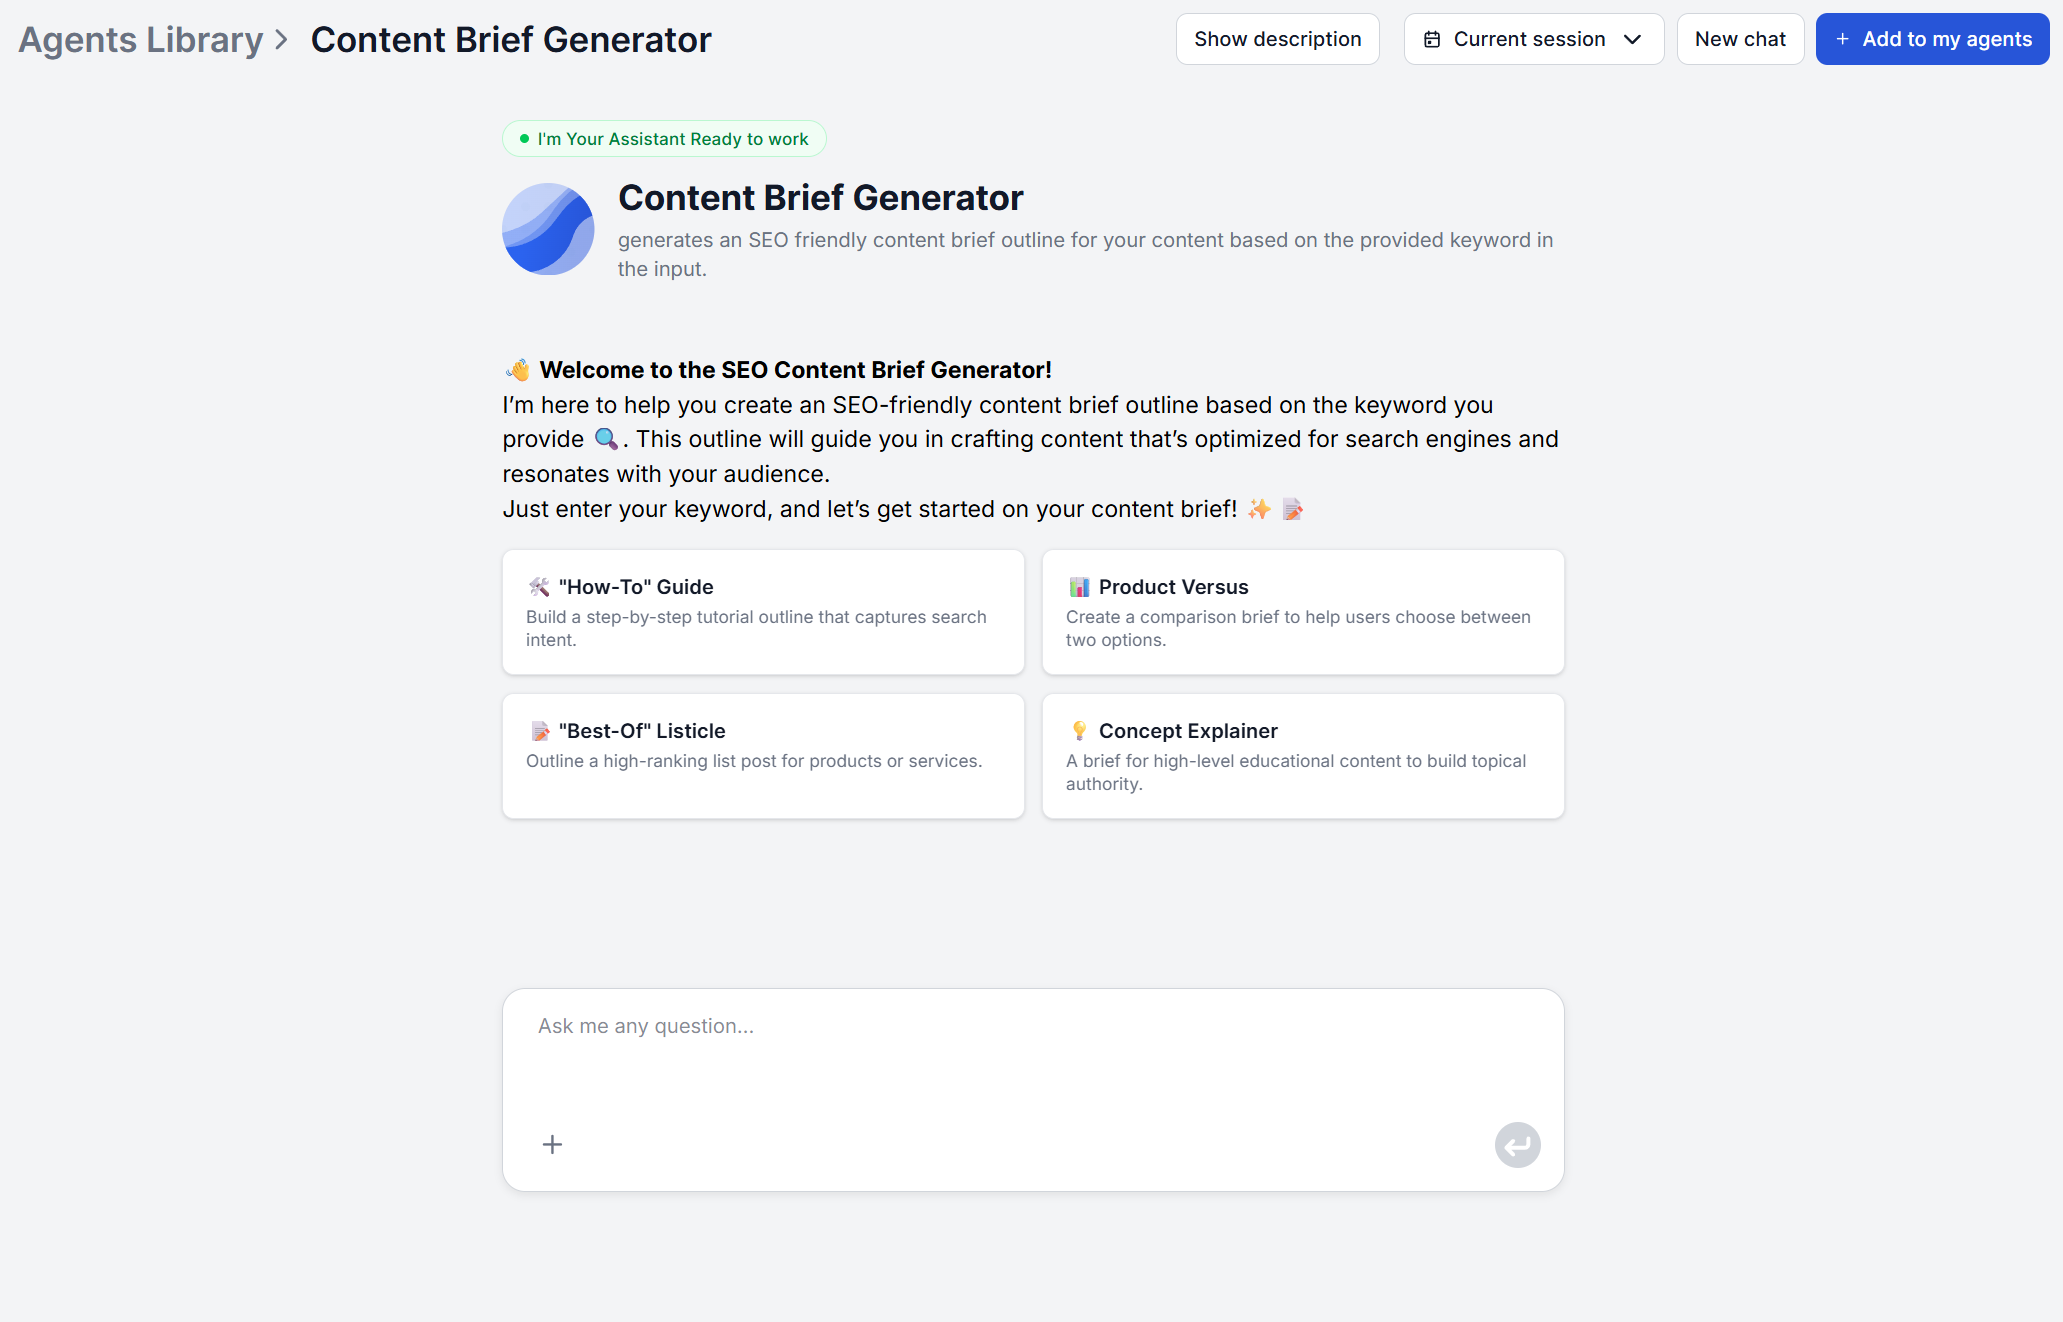
这正是 FlowHunt 的内容简报生成器 自动化的第一步。它会针对关键词运行一次实时 Google 搜索,在生成任何内容之前先分析实际排名的内容,而不是仅凭关键词文本去猜意图。
失败 2:忽视排名靠前的竞争对手覆盖了什么
一份基于通用 SEO 最佳实践、而非实际 SERP 写成的简报,产出的是泛泛的建议,而不是一篇为超越某个具体对手而构建的页面。如果你不知道前三名竞争对手已经覆盖了什么,你就无法判断自己的大纲是填补了空白,还是只是在重复已有内容。
要做一次快速的、覆盖整份简报的检查,内容简报生成器对排名靠前页面的结构分析就能胜任。而对于某个需要针对特定竞争对手做到标题级精度的、优先级很高的页面,网页内容差距分析 会更深入,把你的实际标题与竞争对手 URL 进行比对,并为每个段落返回 5–10 个长尾关键词建议。
失败 3:缺失满足查询完整性的子主题
Google 对内容的评估越来越看重对一个主题的完整覆盖,而不只是主关键词是否出现。关于主题权威度的研究发现,主题权威度强、排名在第 6–#10 位的页面,被 AI 系统引用的次数是主题权威度弱、排名第 #1 位页面的 2.3 倍 ,主题权威度(r=0.41)作为 AI 引用预测因子的作用远超域名权威度。另一项分析发现,主题权威度高的页面获取流量的速度比权威度低的页面快 57% ,并引用了 Graphite 关于这一规律的研究。
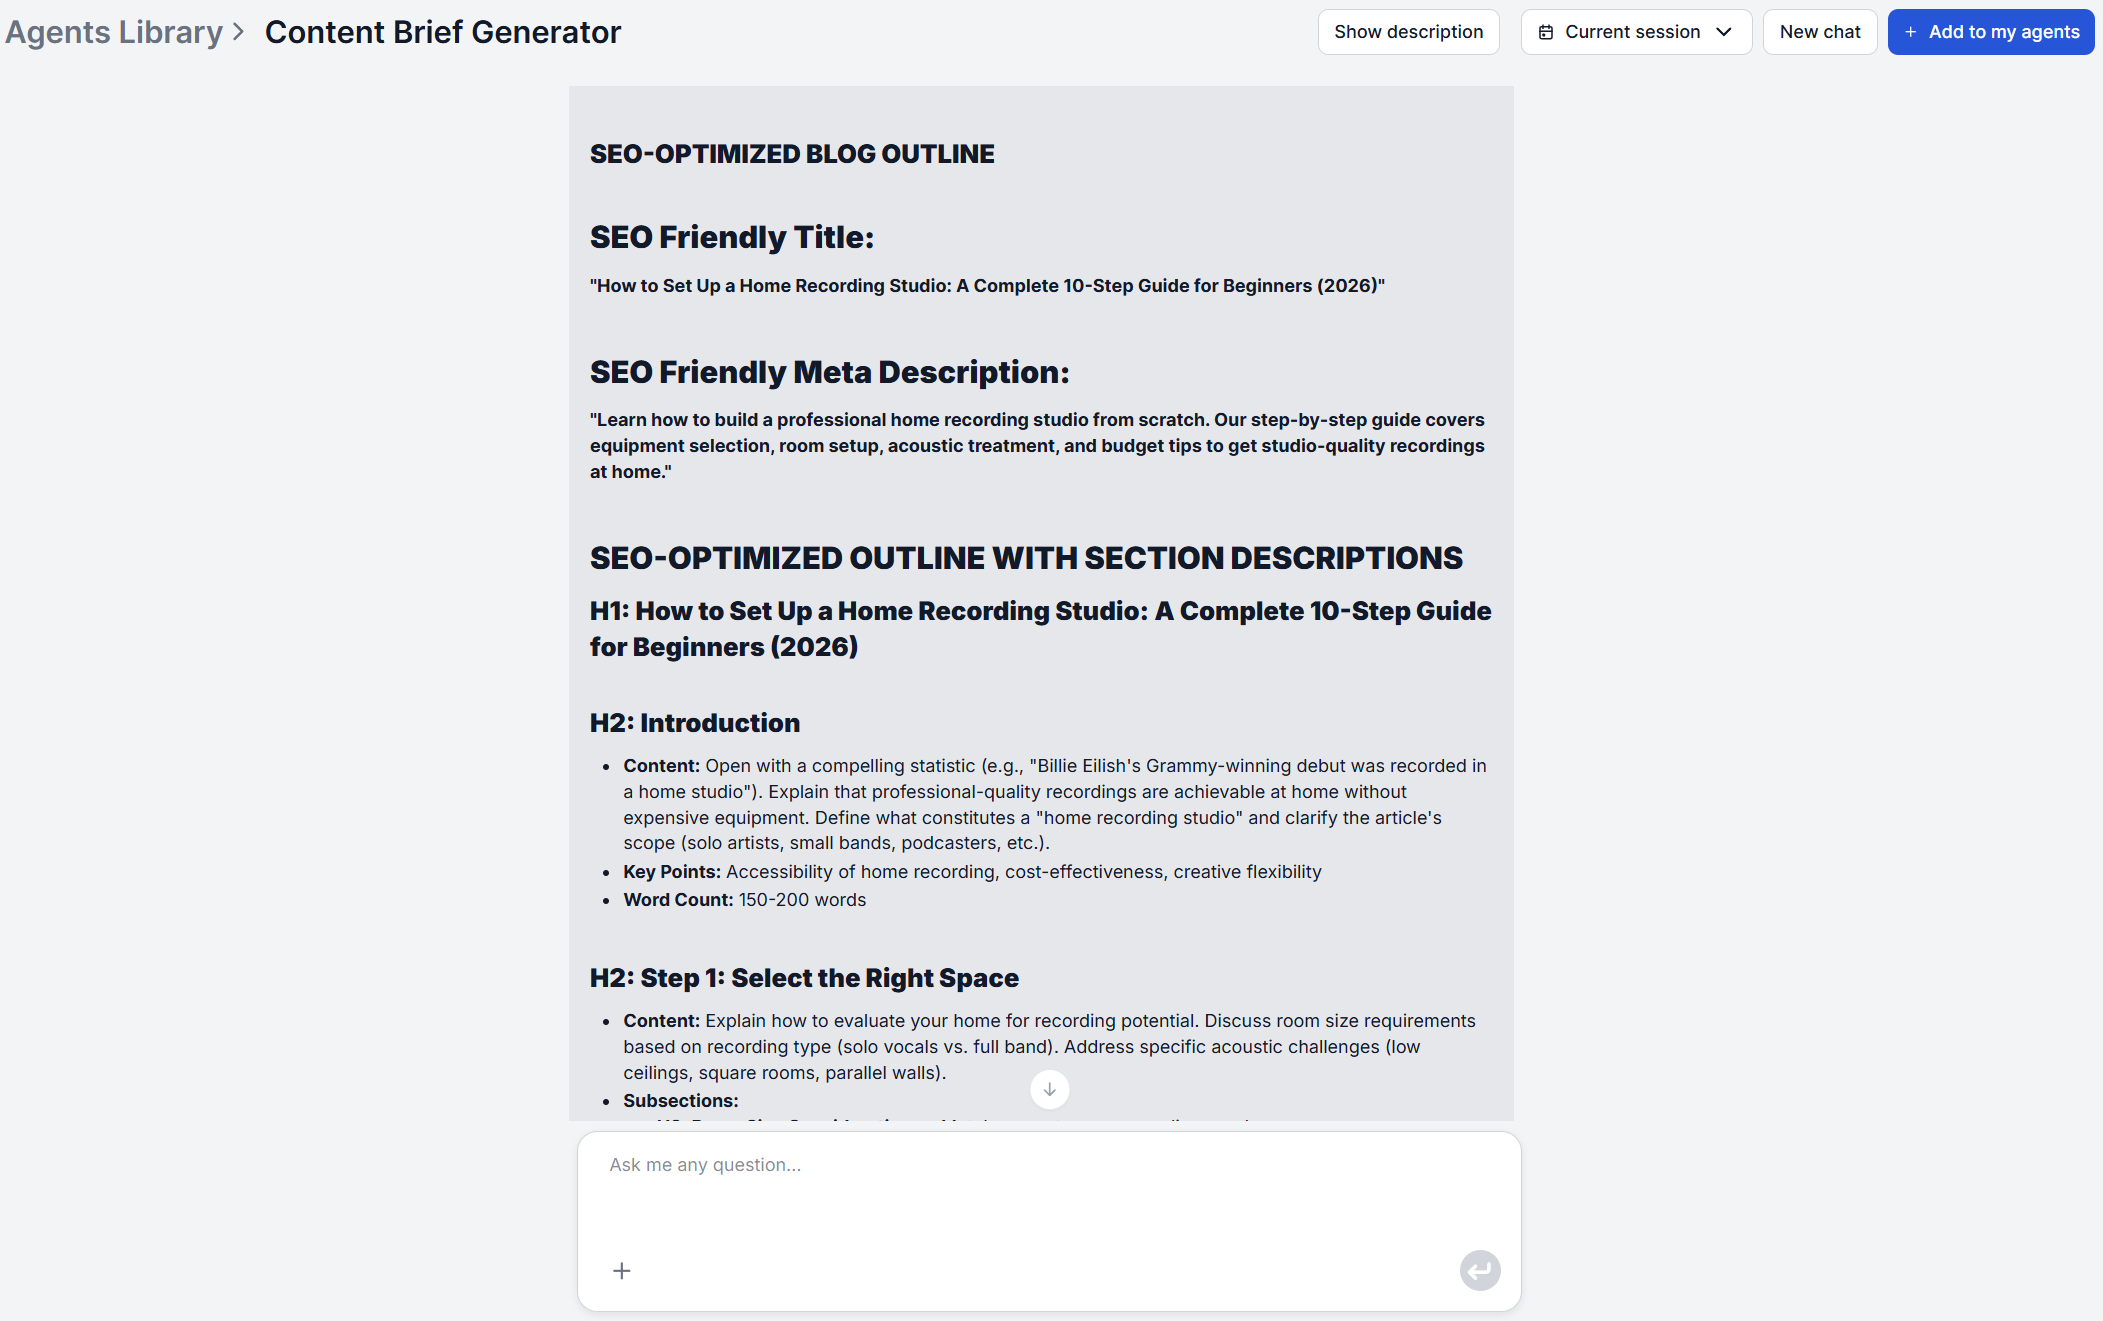
一份只列出光秃秃的标题、却不指导每个部分应覆盖什么的简报,会把子主题的完整性完全交给写作者当天的判断。FlowHunt 的简报避免了这一点,它为每个段落附上应包含内容的说明,依据的是实际排名的内容结构,而不仅仅是一份标题清单。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
失败 4:错误的受众和漏斗阶段
一篇为处于早期调研阶段的人写的文章,与一篇为准备购买的人写的文章,读起来完全不同,即使两者瞄准的是同一个关键词。当简报没有指明读者是谁、他们处于决策过程的哪个位置时,写作者就会默认采用一种通用的语气,而这对两类受众都不讨好。
这是一种任何 SERP 分析都无法单独完全解决的失败模式,因为搜索结果展示的是哪种内容类型胜出,而不是你的具体业务需要这些内容去对话的对象是谁。为同一个关键词排名的两个竞争对手,可能在为完全不同的读者写作。匹配胜出的内容类型(失败 1)并不等于匹配胜出的受众。读者是谁、他们已经知道什么、以及他们读完页面之后会发生什么,都必须成为简报的一部分,并由人工编辑重新核查。
失败 5:没有清晰的差异化角度
一份纯粹基于 “前三名竞争对手覆盖了什么” 构建的简报,产出的内容只能与它们持平,而无法超越它们。如果内容日历里每一份简报都只是镜像当前的 SERP,那最好的结果也只是竞争上的持平,永远无法给 Google 或读者一个理由去偏爱这个页面,而不是它模仿的那些页面。
解决办法是在 AI 生成的结构成型之后,刻意加入一个编辑步骤。加入专有数据点、一个真正不同的框架,或者一个排名靠前的页面所没有的具体观点。AI 简报能让你快速达到持平,但差异化角度仍然需要人来拍板。
AI 简报生成如何系统性地解决每一种失败
上述五种失败中的三种,正是基于实时 SERP 的 AI 简报 生来就要捕捉的问题。意图(失败 1)和竞争对手覆盖(失败 2)通过在写简报之前分析实际排名的内容来解决。子主题完整性(失败 3)则来自生成带有段落级指导的大纲章节,而这些指导同样以那份竞争对手分析为依据。
TIP: 你有已经发布但表现不佳的页面吗?试试博客优化智能体 。它会获取现有的 URL,将其与实时搜索结果交叉比对,并在一次操作中重写结构、数据和 SEO 格式。
TIP: 或者你是在写全新的内容,却没有写作者能接手?AI 博客写作者 可以接过这份简报所依据的同一个关键词,自行产出一篇完整草稿。
失败 4 和失败 5 —— 受众/漏斗阶段与差异化角度 —— 超出了任何基于 SERP 的工具所能自行推断的范围。再多的竞争对手分析也无法告诉 AI 你的具体读者是谁,或者你的业务能带来哪些竞争对手做不到的专有角度。不过,你可以把产品信息作为简报交给 AI,并确保它会去搜索这些差异化因素。无论哪种方式,你都应该让一位人工编辑去核实并补充这些内容。
在实践中,这意味着一个可重复的两步流程,而不是一次工具调用。先生成基于 SERP 的简报,消除失败 1 到失败 3,然后做一次简短的编辑审阅,确认受众和漏斗阶段与你的真实买家相符,并加入一件竞争对手排名靠前的页面所没有的东西。跳过第二步,团队就会得到技术上正确、却依然超越不了任何人的内容。
结论
如果内容没有排名,草稿不该是第一个检查的地方。先看简报。它是否基于实际排名的内容构建,是否覆盖了完整主题,是否知道内容写给谁。五种最常见的失败中有三种,可以通过把简报建立在实时 SERP 分析而非模板之上来解决。其余的,则可以在简报送到写作者手上之前,通过一次快速的人工编辑审阅来解决。
