Cosa ti compra davvero un Context Engine: abbiamo fatto eseguire 22 revisori di codice AI in cinque modi diversi
Stessa pull request, stesso prompt, stesso modello — solo il caricamento del contesto era diverso. Un digest del context engine più una lettura del file di policy ha battuto la lettura della documentazione sia in costi che in qualità. Tutti i dati qui.
Abbiamo assegnato lo stesso task di revisione del codice a 22 agenti AI. Stessa pull request, stesso commit bloccato, stesso prompt, stesso modello — l’unica variabile era come ogni agente caricava le regole del progetto. La configurazione più economica si è rivelata essere anche la più approfondita, e il motivo dice qualcosa di generale sull’ingegneria del contesto.
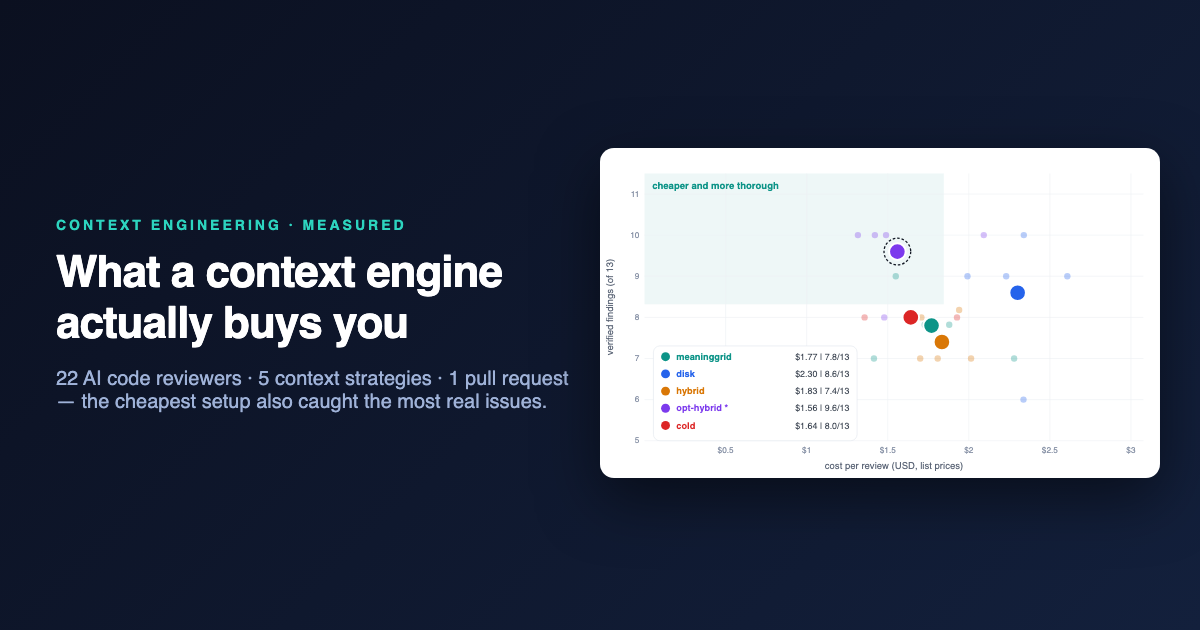
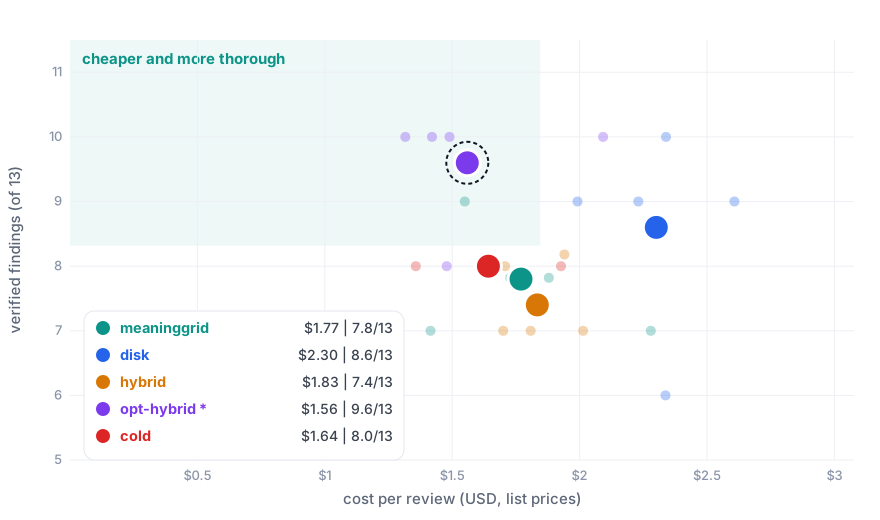
TL;DR: Un digest del context engine più una lettura diretta del file di policy leggibile da macchina ha battuto ogni altra strategia: $1,56 per revisione e 9,6/13 risultati verificati — più economico che leggere la documentazione ($2,30, 8,6/13) e migliore del solo digest ($1,77, 7,8/13). Leggere tutto ha ottenuto il peggior punteggio (7,4/13). Tutti i 22 agenti hanno eseguito su Claude Opus 4.8, e 21 su 22 hanno raggiunto lo stesso verdetto.
Cosa: un harness, un context engine e una pull request
Cos’è un “harness”?
Ogni serio tentativo di far lavorare gli agenti AI in un repository di produzione sviluppa due strati di governance.
Lo strato in prosa — convenzioni, regole di architettura, standard di test. Nel nostro repository è CLAUDE.md e docs/**: “il backend è snake_case”, “il dominio non importa mai infrastruttura”, “tutti i gestori di rotte sono async”. Gli umani lo leggono; ai agenti viene detto di leggerlo anche loro.
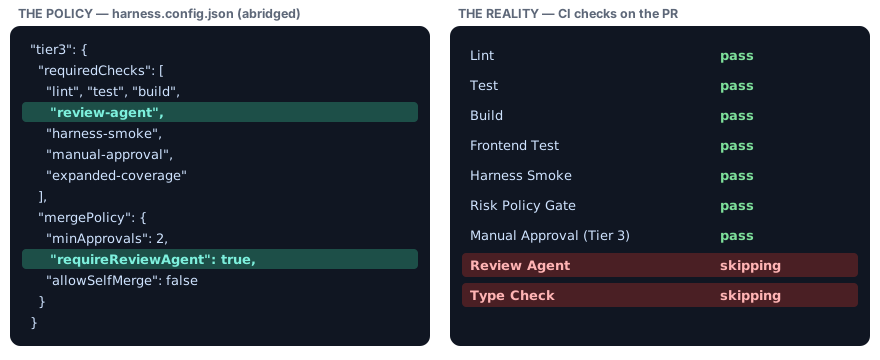
Lo strato leggibile da macchina — la configurazione dell’harness. La nostra è un singolo file JSON che classifica ogni percorso nel repository in livelli di rischio e allega gate eseguibili a ogni livello. CI lo legge. La policy di merge lo legge. Non è un consiglio — è una policy:
(Nota sulla terminologia: “harness” nomina anche il runtime dell’agente stesso — lo scaffolding di tool, abilità e server MCP che un agente agisce tramite, come in harnext
, “l’harness dell’agente di codifica”. In questo post, la configurazione dell’harness è il file di policy del repository che sia il runtime che il CI applicano.)
Un revisore di codice — umano o agente — non può giudicare “questa PR è autorizzata a fare il merge?” senza questo file. Una PR di Tier-3 con il check review-agent saltato è una violazione di policy anche se ogni test è verde. Tieni quell’esempio a mente; decide l’esperimento.
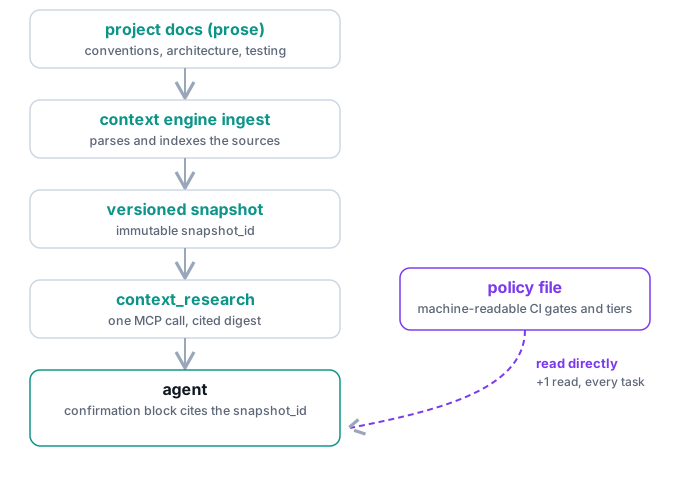
Poiché entrambi gli strati esistono, il repository impone un gate: nessun agente inizia il lavoro prima di caricare questo contesto — e provando che l’ha fatto, tramite un blocco di conferma che i revisori controllano. La domanda che questo post risponde è semplicemente: quale è il modo più economico corretto per soddisfare quel gate?
Conosci harnext e meaninggrid
meaninggrid è il Context Engine ospitato di harnext
, l’harness dell’agente di codifica provider-agnostico con licenza MIT di QualityUnit (sei tool — read, write, edit, bash, skill, mcp — npm i -g harnext). Il pitch del fornitore per il Context Engine è diretto: “il cervello del tuo agente.” Le fonti fluiscono in un indice continuamente aggiornato — “la griglia” — e per query il motore “la classifica e la pota in contesto efficiente in token, collegato direttamente all’harness”: indice continuo, ranking di rilevanza, dedup e cache. Il numero principale di harnext è −89% token per query in media. Questo è il claim del fornitore; uno scopo di questo esperimento era misurare, con i nostri numeri su un task reale, cosa quel tipo di compressione effettivamente salva — e cosa costa.
Nel nostro deployment la griglia acquisisce la documentazione in prosa del repository; ogni acquisizione produce uno snapshot immutabile e versionizzato. Gli agenti lo interrogano tramite MCP (meaninggrid.harnext.dev/mcp) con una singola chiamata context_research e ricevono un digest sintetizzato, citato timbrato con snapshot_id, che l’agente deve citare nel suo blocco di conferma — contesto verificabile reso concreto.
Cosa produce il gate — il blocco di conferma (esempio; specifiche del progetto omesse):
Caricato tramite: ibrido ottimizzato (digest del context engine + solo file di policy).

- context_research call #1 (convenzioni / layering / test / sicurezza /
  livelli di rischio) -> snapshot_id 9483af61cf8a40a2a0d790c7047fcf08
- context_research call #2 (checklist di integrazione del provider LLM +
  regole extra-care del flow-engine) -> snapshot_id 9483af61cf8a40a2a0d790c7047fcf08
- Leggi configurazione harness (completa) dal disco per pattern esatti di tier,
  requiredChecks, mergePolicy, evidenceConfig.
  NON hai letto CLAUDE.md o docs/* (coperto dal digest).
Lo snapshot_id è reale — un revisore può verificare esattamente quale versione delle regole l’agente ha usato.
Tre ipotesi
L’esperimento è stato progettato per stabilire tre previsioni testabili, scritte in anticipo:
H1 — Un digest è più economico che rileggere. Acquisire i documenti in prosa una volta, servire a ogni agente un digest sintetizzato compatto, invece che ogni agente rilegga ogni documento per ogni task. Se vero: costo significativamente inferiore per revisione, a verdetti uguali.
H2 — La parafrasi distrugge la policy. Un digest può trasmettere “Tier 3 richiede revisione umana” senza perdite. Non può trasmettere "requireReviewAgent": true senza perdite — i dettagli esatti e quotabili che un revisore ha bisogno di affermare una violazione muoiono nel riassunto. Se vero: gli agenti solo digest dovrebbero sistematicamente perdere violazioni di gate che gli agenti che hanno il file di policy letterale catturano.
H3 — Il contesto più snello legge più profondamente. Il contesto ha un costo doppio — una volta in dollari, una volta in attenzione: ogni documento ridondante nella finestra compete con il codice in revisione. Se vero: leggere tutto (digest + tutti i documenti) non dovrebbe vincere; il contesto più snello sufficiente dovrebbe.
Come l’abbiamo testato
Ventidue agenti hanno revisionato la stessa pull request di Tier-3 nel nostro repository di produzione monorepo (un’integrazione del provider LLM: 44 file, +2.111 righe, con posta reale — tabelle di fatturazione, routing del flow-engine). Cinque bracci, differenti solo nel passo di caricamento del contesto:
Braccio
Caricamento del contesto
n
meaninggrid
digest del context engine solo (2× context_research)
5
disk
legge 7+ documenti dal disco — nessun context engine
5
hybrid
digest + legge TUTTI i documenti
5
opt-hybrid
digest + legge UN file: la configurazione dell’harness
5
cold
nessun contesto di convenzione affatto (baseline)
2
Regole fondamentali: un commit bloccato, un corpo di prompt, un modello — Claude Opus 4.8 — tutti i bracci intercalati in un singolo batch concorrente. Agli agenti è stato vietato il thread di commenti della PR, quindi i round di esperimento precedenti non potevano filtrare. Ogni numero viene dai transcript grezzi dell’agente, con l’utilizzo di token deduplicato per richiesta API e prezzato ai prezzi di listino. La qualità è segnata contro 13 difetti reali verificati indipendentemente nella PR, pattern-matched nel corpo di ogni revisione e controllato manualmente per falsi positivi. Accordo del verdetto tra tutti i bracci: 21/22 ha detto REQUEST CHANGES.
Quindi cosa: la configurazione più economica ha anche vinto sulla qualità
Braccio
Costo / revisione
Risultati (su 13)
Risultati gate (su 3)
Wall clock
meaninggrid
$1,77
7,8
0,2
5:34
disk
$2,30
8,6
0,8
4:35
hybrid
$1,83
7,4
0,8
5:40
opt-hybrid ★
$1,56
9,6
1,4
4:55
cold
$1,64
8,0
0,5
4:13
★ = la configurazione che ora distribuiamo come skill di default del repository. Wall clock include contention condivisa dall’esecuzione di 22 agenti contemporaneamente.
H1 — confermato
Il braccio solo digest ha revisionato per $1,77 rispetto a $2,30 per leggere la documentazione (−23%), e il braccio vincente digest-più-un-file per $1,56 (−32%) — a verdetti uguali. Il risparmio si compone: il digest sostituisce uno stack di documenti che altrimenti cavalcherebbero attraverso ogni successiva chiamata API del contesto.
H2 — confermato, decisivamente
Il check review-agent saltato — una violazione genuina della merge-policy in questa PR — è stato catturato da 5 su 5 agenti che avevano il file di policy letterale, e da 1 su 5 agenti solo digest. Il meccanismo è esattamente quello che H2 ha predetto: per scrivere quel risultato, un agente deve corrispondere ai nomi esatti dei check CI contro i campi di configurazione esatti — una parafrasi non è prova quotabile, quindi gli agenti solo digest si coprono e lo lasciano cadere. Una lettura diretta lo ripristina.
H3 — confermato
L’ibrido che legge tutto ha portato il contesto più di qualsiasi braccio e ha ottenuto il punteggio peggiore (7,4/13), mentre il braccio più snello sufficiente ha ottenuto il migliore (9,6/13) — ed è stato il migliore di tutti i bracci nel singolo risultato più profondo, un bug di codice morto che richiede la traccia di un percorso di chiamata attraverso tre file. La prosa ridondante non ha aggiunto informazioni; ha competuto con il codice per l’attenzione.
Una nota onesta: il baseline cold (8,0/13 a $1,64) mostra che la maggior parte dei 13 difetti sono bug di codice semplice che un modello forte trova senza alcun contesto di convenzione. Quello che cold non può fare è la metà della policy del lavoro — gate, livelli, regole di merge — che è precisamente dove i bracci si separano.
Cura la prosa in un digest. Leggi il file di policy grezzo. Non leggere nulla due volte.
Divulgazione completa
Modello: ogni chiamata API di ogni agente ha eseguito su claude-opus-4-8 (Claude Opus 4.8) — verificato dal campo model di ogni riga di transcript, non assunto. I risultati potrebbero differire su altri modelli; i modelli più piccoli probabilmente dipendono di più dal contesto curato, non meno.
Prezzi: i costi utilizzano i prezzi di listino di Anthropic al momento della scrittura; la fatturazione effettiva può differire. I confronti relativi non sono interessati.
Dimensione del campione: n=5 per braccio (n=2 per cold), una PR, un repository, un tipo di task. L’effetto gate (5/5 vs 1/5) è netto; i tassi per risultato altrove sono ±1 agente. Trattalo come un pilot forte, non un benchmark.
Metrica di qualità: rilevamento di pattern sul testo di revisione (citazioni escluse), controllato manualmente per falsi positivi. Conta menzioni di difetti verificati, non l’eloquenza generale della revisione.
Tempistica: tutti i 22 agenti hanno condiviso una macchina e una quota API; i numeri wall-clock includono quella contention.
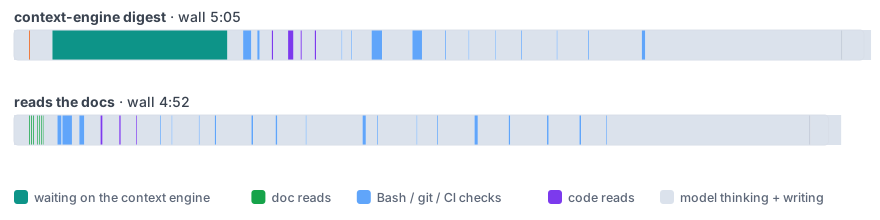
Ci siamo corretti due volte: i conteggi iniziali dei token erano gonfiati 2–3× (duplicazione dell’utilizzo per riga nei transcript; corretto da dedup per ID richiesta), e una timeline visiva precedente ha sottovalutato il wall time (corretto da attribuzione dell’intervallo completo). Entrambe le correzioni sono incorporate in ogni numero qui.
Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Il braccio vincente è ora la skill di default check-context-first del repository: estrai il digest del context engine (due chiamate), quindi leggi esattamente un file dal disco — la configurazione dell’harness — e emetti un blocco di conferma che cita lo snapshot e i gate esatti. Una debolezza misurata, una correzione di policy di una riga, ri-validata lo stesso giorno. Quel loop — misura, correggi la policy del contesto, ri-valida — è la parte che ti incoraggiamo a rubare, qualunque context engine usi.
Cosa puoi fare lunedì
Dividi il tuo contesto dell’agente in due: prosa (convenzioni, architettura, test) vs policy leggibile da macchina (gate CI, livelli di rischio, regole di merge).
Digerisci la prosa; non digerire mai la policy. Servi la prosa tramite un context engine — meaninggrid è il nostro — e rendi il file di policy una lettura letterale obbligatoria nel tuo context gate.
Rendi il contesto verificabile. Versionizza il contesto acquisito; richiedi agli agenti di citare lo snapshot id in un blocco di conferma che i revisori possono effettivamente controllare.
Misura prima di credere — incluso noi. Una manciata di agenti per braccio sul tuo repository è sufficiente per vedere il pattern. Valuta le revisioni contro i risultati verificati, non le vibrazioni.
Un invito aperto
Se esegui questo esperimento sul tuo repository — gli stessi bracci, il tuo modello, il tuo harness — ci piacerebbe davvero vedere i tuoi numeri, soprattutto se confutano i nostri. E se il tuo team vuole aiuto a impostare un context gate come questo, o vuole parlare di meaninggrid e dello stack harnext, contatta il team di FlowHunt o trova l’harness open-source su harnext.dev
. Replicazioni, domande e correzioni sono tutte benvenute.
Domande frequenti
Un context engine acquisisce la documentazione di un progetto una volta, la versionizza in uno snapshot immutabile, e fornisce agli agenti un digest compatto e citato tramite una singola chiamata di tool — invece che ogni agente rilegga ogni documento per ogni task. Nel nostro esperimento il digest conteneva uno snapshot_id che gli agenti citano come prova verificabile di quale versione delle regole hanno usato.
Un riassunto può trasmettere il significato della prosa senza perdite, ma distrugge i dettagli esatti e quotabili della policy leggibile da macchina — nomi esatti dei check CI, flag booleani, pattern di percorsi. Un agente che possiede solo una parafrasi non può affermare con sicurezza una violazione di policy concreta. Nel nostro test, gli agenti che avevano il file di policy letterale hanno catturato un check CI obbligatorio saltato 5 volte su 5; gli agenti che avevano solo il digest l'hanno catturato 1 volta su 5.
No — il contesto ha un costo doppio, una volta in token e una volta in attenzione. Nel nostro esperimento il braccio che leggeva tutto (digest più tutta la documentazione) ha ottenuto il peggior punteggio in qualità, mentre la configurazione più snella sufficiente ha ottenuto il migliore. Ogni documento ridondante compete con il codice effettivo per l'attenzione del modello.
Ogni agente nell'esperimento ha eseguito su Claude Opus 4.8, verificato dal campo model di ogni transcript. Il campione è piccolo (cinque agenti per braccio, una pull request, un repository), quindi trattalo come un pilot forte piuttosto che come un benchmark — e replicalo sul tuo repository prima di crederci. I modelli più piccoli probabilmente dipendono più dal contesto curato, non meno.
Dividi il contesto dell'agente in due: fornisci la documentazione in prosa (convenzioni, architettura, test) tramite un context engine come digest citato, e rendi il file di policy leggibile da macchina una lettura letterale obbligatoria. Richiedi agli agenti di citare lo snapshot id in un blocco di conferma in modo che i revisori possano verificare quale versione delle regole l'agente ha usato.
Štefan è un ingegnere AI e software che sta sviluppando FlowHunt. Oltre al prodotto stesso, progetta flussi di lavoro di ingegneria software agentici per sviluppatori che riducono i costi di sviluppo mentre aumentano la qualità del codice.
Štefan Moravík
Ingegnere AI e Software
Costruisci flussi di lavoro degli agenti che si ripagano da soli
FlowHunt aiuta i team di ingegneria a progettare flussi di lavoro agentic, context gate e integrazioni MCP che riducono i costi di sviluppo mentre aumentano la qualità del codice.
Sviluppare un'Applicazione Enterprise Completa con l'Agente di Codifica harnext
Dieci mesi, 1.409 PR unite, tre audit forensi: come una pipeline di agenti in stadi ha portato una base di codice enterprise dal 12% al 92% di sviluppo coinvolt...
Context Engineering per Agenti AI: Padroneggiare l’Ottimizzazione dei Token e le Prestazioni degli Agenti
Scopri come il context engineering ottimizza le prestazioni degli agenti AI gestendo strategicamente i token, riducendo il sovraccarico di contesto e implementa...
Lunga vita all'Ingegneria del Contesto: Costruire Sistemi AI di Produzione con Database Vettoriali Moderni
Scopri come l'ingegneria del contesto sta rivoluzionando lo sviluppo AI, l’evoluzione dal RAG ai sistemi pronti per la produzione e perché database vettoriali m...
21 min di lettura
AI
Vector Databases
+3
Consenso Cookie Usiamo i cookie per migliorare la tua esperienza di navigazione e analizzare il nostro traffico. See our privacy policy.
Questi cookie sono necessari per il funzionamento del sito web e non possono essere disabilitati.
Cookie Analitici
Questi cookie ci aiutano a capire come i visitatori interagiscono con il nostro sito web.
Cookie di Marketing
Questi cookie vengono utilizzati per misurare l'efficacia delle nostre campagne pubblicitarie e per supportare pubblicità pertinente su piattaforme di terze parti.
Cookie Funzionali
Questi cookie vengono utilizzati per ricordare le tue preferenze e migliorare la tua esperienza.