Co naprawdę kupuje Ci silnik kontekstowy: Przetestowaliśmy 22 recenzentów kodu AI na pięć różnych sposobów
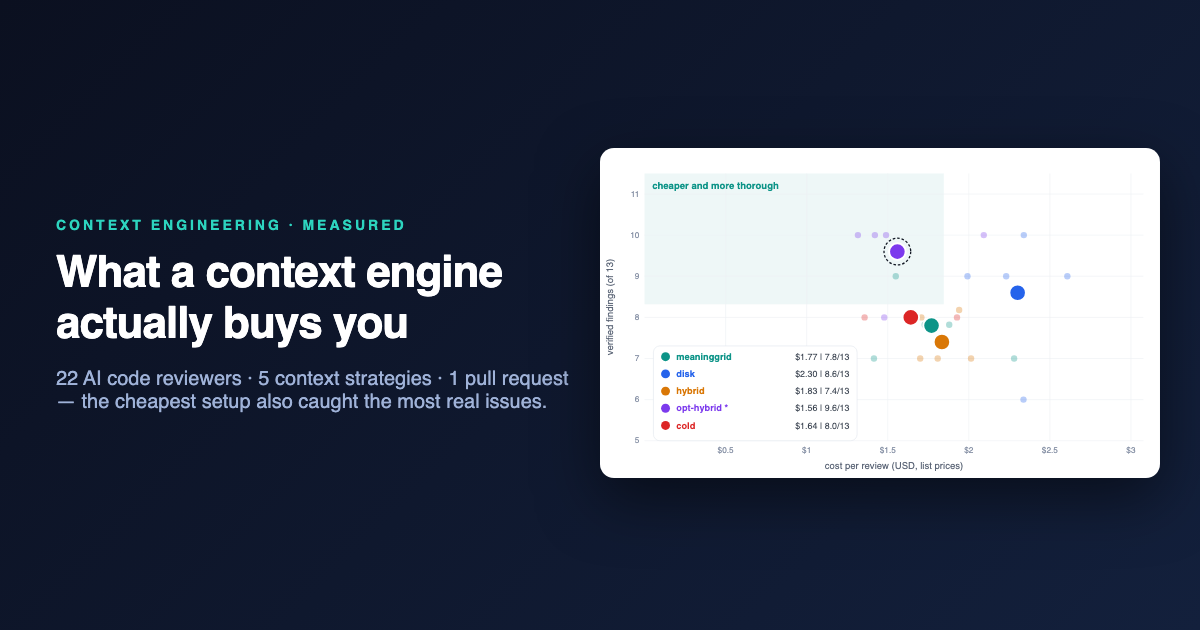
Ten sam pull request, ten sam prompt, ten sam model — zmieniało się tylko ładowanie kontekstu. Skrót silnika kontekstowego plus jedno bezpośrednie odczytanie pliku polityki pokonało czytanie dokumentacji zarówno pod względem kosztu, jak i jakości. Pełne dane w środku.
Daliśmy to samo zadanie przeglądu kodu 22 agentom AI. Ten sam pull request, ten sam przypiętty commit, ten sam prompt, ten sam model — jedyną zmienną było jak każdy agent ładował reguły projektu. Najtańsza konfiguracja okazała się być najdokładniejszą, a powód mówi coś ogólnego o inżynierii kontekstu.
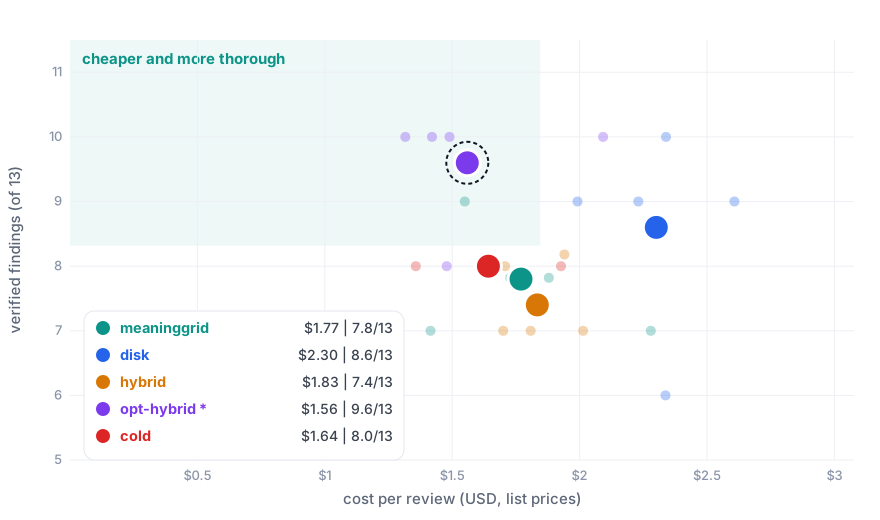
TL;DR: Skrót silnika kontekstowego plus jedno bezpośrednie odczytanie pliku polityki czytelnego dla maszyn pokonało każdą inną strategię: $1,56 za recenzję i 9,6/13 zweryfikowanych ustaleń — taniej niż czytanie dokumentów ($2,30, 8,6/13) i lepiej niż sam skrót ($1,77, 7,8/13). Czytanie wszystkiego uzyskało najgorszą ocenę ze wszystkich (7,4/13). Wszystkie 22 agenty działały na Claude Opus 4.8, a 21 z 22 doszło do tego samego wniosku.
Co: zespół, silnik kontekstowy i jeden pull request
Czym jest “zespół”?
Każda poważna próba pozwolenia agentom AI pracować w repozytorium produkcyjnym tworzy dwie warstwy nadzoru.
Warstwa prozą — konwencje, reguły architektury, standardy testowania. W naszym repozytorium to CLAUDE.md i docs/**: “backend to snake_case”, “domena nigdy nie importuje infrastruktury”, “wszystkie handlery tras są asynchroniczne”. Ludzie to czytają; agentom mówi się, aby czytali też.
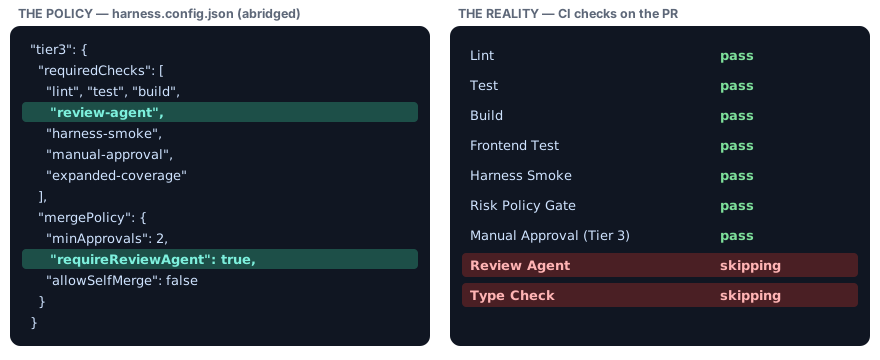
Warstwa czytelna dla maszyn — konfiguracja zespołu. Nasza to pojedynczy plik JSON, który klasyfikuje każdą ścieżkę w repozytorium na poziomy ryzyka i dołącza egzekwowalne bramki do każdego poziomu. CI to czyta. Polityka scalania to czyta. To nie rada — to polityka:
(Uwaga terminologiczna: “harness” również nazwie samego środowiska uruchomieniowego agenta — rusztowania narzędzi, umiejętności i serwerów MCP, które agent działa, jak w harnext
, “zespół kodowania agenta”. W tym poście konfiguracja zespołu to plik polityki repozytorium, który takie środowisko uruchomieniowe i CI egzekwują.)
Recenzent kodu — człowiek lub agent — nie może ocenić “czy ten PR może się scalić?” bez tego pliku. PR Tier-3 z pominięty check review-agent to naruszenie polityki nawet jeśli każdy test jest zielony. Pamiętaj ten przykład; decyduje eksperyment.
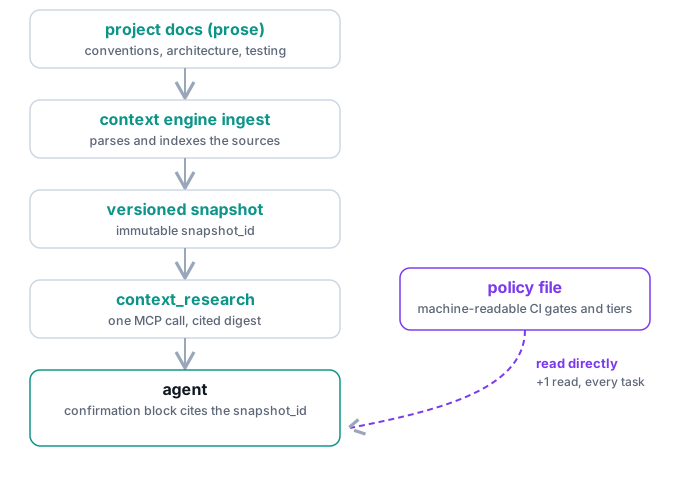
Ponieważ obie warstwy istnieją, repozytorium nakazuje bramkę: żaden agent nie zaczyna pracę przed załadowaniem tego kontekstu — i udowodnieniem, że to zrobił, poprzez blok potwierdzenia, który recenzenci sprawdzają. Pytanie, na które ten post odpowiada, jest po prostu: jaki jest najtańszy prawidłowy sposób spełnienia tej bramki?
Poznaj harnext i meaninggrid
meaninggrid to hostowany silnik kontekstowy z harnext
, zespołu kodowania agenta MIT-licensed, niezależny od dostawcy QualityUnit (sześć narzędzi — czytaj, pisz, edytuj, bash, umiejętność, mcp — npm i -g harnext). Skok sprzedawcy dla silnika kontekstowego jest prosty: “mózg Twojego agenta.” Źródła płyną do ciągle aktualizowanego indeksu — “siatki” — a na zapytanie silnik “klasyfikuje i przycina go do kontekstu oszczędzającego tokeny, podłączonego bezpośrednio do zespołu”: ciągły indeks, klasyfikacja istotności, deduplikacja i pamięć podręczna. Główna liczba harnext to −89% tokenów na zapytanie średnio. To roszczenie dostawcy; jednym celem tego eksperymentu było zmierzyć, z naszymi własnymi liczbami na rzeczywistym zadaniu, co tego rodzaju kompresja faktycznie oszczędza — i co ją kosztuje.
W naszym wdrożeniu siatka ingresuje dokumentację prozą repozytorium; każdy ingres tworzy niezmienną, wersjonowaną migawkę. Agenci odpytują ją poprzez MCP (meaninggrid.harnext.dev/mcp) z jednym wywołaniem context_research i otrzymują syntetyzowany, cytowany skrót oznaczony snapshot_id, który agent musi cytować w swoim bloku potwierdzenia — audytowalny kontekst ukonkretniony.
Co bramka produkuje — blok potwierdzenia (przykład; szczegóły projektu pominięte):
Załadowany poprzez: optymalizowany hybrydowy (skrót silnika kontekstowego + tylko plik polityki).

- context_research wywołanie #1 (konwencje / warstwowanie / testowanie / bezpieczeństwo /
  poziomy ryzyka) -> snapshot_id 9483af61cf8a40a2a0d790c7047fcf08
- context_research wywołanie #2 (checklist integracji dostawcy LLM +
  reguły dodatkowej opieki silnika przepływu) -> snapshot_id 9483af61cf8a40a2a0d790c7047fcf08
- Przeczytaj konfigurację zespołu (pełną) z dysku dla dokładnych wzorów poziomu,
  requiredChecks, mergePolicy, evidenceConfig.
  NIE czytaj CLAUDE.md lub docs/* (pokryte skrótem).
snapshot_id jest rzeczywisty — recenzent może zweryfikować dokładnie, z której wersji reguł agent pracował.
Trzy hipotezy
Eksperyment został zaprojektowany, aby rozstrzygnąć trzy testowalne przewidywania, napisane wcześniej:
H1 — Skrót jest tańszy niż ponowne czytanie. Ingresuj dokumenty prozą raz, podawaj każdemu agentowi zwięzły syntetyzowany skrót, zamiast tego, aby każdy agent ponownie czytał każdy dokument przy każdym zadaniu. Jeśli prawda: znacząco niższy koszt na recenzję, przy równych werdyktach.
H2 — Parafraza niszczy politykę. Skrót może przenosić “Tier 3 wymaga przeglądu człowieka” bez utraty. Nie może przenosić "requireReviewAgent": true bez utraty — dokładne, cytowalne szczegóły, których recenzent potrzebuje, aby twierdzić naruszenie, umierają w podsumowaniu. Jeśli prawda: agenci posiadający tylko skrót powinni systematycznie pominąć naruszenia bramki, które agenci posiadający dosłowny plik polityki łapią.
H3 — Leanersza kontekst czyta głębiej. Kontekst jest płacony dwa razy — raz w dolarach, raz w uwadze: każdy zbędny dokument w oknie konkuruje z kodem w trakcie przeglądu. Jeśli prawda: czytanie wszystkiego (skrót + wszystkie dokumenty) nie powinno wygrać; najleanersza wystarczająca kontekst powinna.
Jak to testowaliśmy
Dwadzieścia dwa agenty przeanalizowały ten sam pull request Tier-3 w naszym repozytorium produkcyjnym (integracja dostawcy LLM: 44 pliki, +2111 linii, rzeczywiste stawki — tabele rozliczeniowe, routing silnika przepływu). Pięć wariantów, różniących się tylko krokiem ładowania kontekstu:
Wariant
Ładowanie kontekstu
n
meaninggrid
skrót silnika kontekstowego tylko (2× context_research)
5
disk
odczytuje 7+ dokumentów z dysku — brak silnika kontekstowego
5
hybrid
skrót + odczytuje WSZYSTKIE dokumenty
5
opt-hybrid
skrót + odczytuje JEDEN plik: konfiguracja zespołu
5
cold
brak kontekstu konwencji (baseline)
2
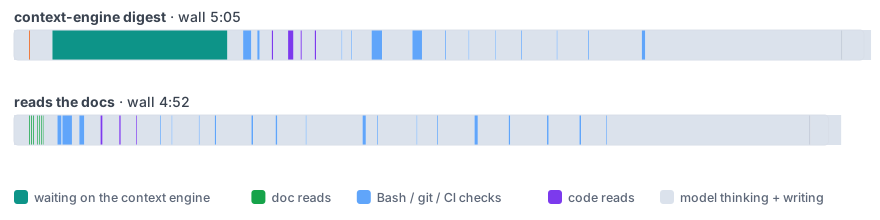
Reguły podstawowe: jeden przypiętty commit, jedno ciało prompta, jeden model — Claude Opus 4.8 — wszystkie warianty przeplatane w jednym współbieżnym wsadzie. Agentom zabroniono wątku komentarzy PR, więc wcześniejsze rundy eksperymentu nie mogły wyciec. Każda liczba pochodzi z surowych transkryptów agenta, ze zużyciem tokenów deduplikowanym na żądanie API i ceną według cen katalogowych. Jakość jest oceniana względem 13 niezależnie zweryfikowanych, rzeczywistych defektów w PR, dopasowanego wzorcem w treści każdego przeglądu i ręcznie sprawdzonego pod kątem fałszywych alarmów. Zgodność werdyktu we wszystkich wariantach: 21/22 powiedziało ŻĄDAJ ZMIAN.
A więc co: najtańsza konfiguracja również wygrała w jakości
Wariant
Koszt / recenzja
Ustalenia (z 13)
Ustalenia bramki (z 3)
Ściana zegara
meaninggrid
$1,77
7,8
0,2
5:34
disk
$2,30
8,6
0,8
4:35
hybrid
$1,83
7,4
0,8
5:40
opt-hybrid ★
$1,56
9,6
1,4
4:55
cold
$1,64
8,0
0,5
4:13
★ = konfiguracja, którą teraz wysyłamy jako domyślną umiejętność repozytorium. Ściana zegara obejmuje wspólną zawartość z uruchomieniem 22 agentów jednocześnie.
H1 — potwierdzona
Wariant sam skrót przeanalizował za $1,77 w stosunku do $2,30 za czytanie dokumentów (−23%), a wariant zwycięski skrót-plus-jeden-plik za $1,56 (−32%) — przy równych werdyktach. Oszczędność się składa: skrót zastępuje stos dokumentów, które w innym przypadku jechałyby poprzez każde kolejne wywołanie API kontekstu.
H2 — potwierdzona, decydująco
Pominięty check review-agent — rzeczywiste naruszenie polityki scalania w tym PR — został złapany przez 5 z 5 agentów posiadających dosłowny plik polityki i przez 1 z 5 agentów posiadających tylko skrót. Mechanizm jest dokładnie tym, co H2 przewidział: aby napisać to ustalenie, agent musi dopasować dokładne nazwy kontroli CI do dokładnych pól konfiguracji — parafraza nie jest cytowalnym dowodem, więc agenci posiadający tylko skrót wahają się i go porzucają. Jedno bezpośrednie odczytanie to przywraca.
H3 — potwierdzona
Hybrydowy wariant czytaj-wszystko zawierał najwięcej kontekstu ze wszystkich wariantów i uzyskał najgorszą ocenę (7,4/13), podczas gdy leanersza wystarczająca wariant uzyskała najlepszą (9,6/13) — i była najlepsza ze wszystkich wariantów w jednym najgłębszym ustaleniu, błędzie martwego kodu, który wymaga śledzenia ścieżki połączenia na trzech plikach. Zbędna proza nie dodała informacji; konkurowała z kodem o uwagę.
Jedno uczciwe przypisanie: baseline cold (8,0/13 za $1,64) pokazuje, że większość z 13 defektów to proste błędy kodu, które silny model znajduje bez żadnego kontekstu konwencji. Co cold nie może zrobić, to część polityki pracy — bramki, poziomy, reguły scalania — co jest dokładnie tam, gdzie warianty się rozdzielają.
Wyselekcjonuj prozę w skrót. Przeczytaj plik polityki surowy. Nie czytaj nic dwa razy.
Pełne ujawnienie
Model: każde wywołanie API każdego agenta działało na claude-opus-4-8 (Claude Opus 4.8) — zweryfikowane z pola model każdej linii transkryptu, nie założone. Wyniki mogą się różnić na innych modelach; mniejsze modele prawdopodobnie bardziej zależą od wyselekcjonowanego kontekstu, nie mniej.
Ceny: koszty używają cen katalogowych Anthropic w momencie pisania; rzeczywiste rozliczenia mogą się różnić. Porównania względne nie są zagrożone.
Wielkość próbki: n=5 na wariant (n=2 dla cold), jeden PR, jedno repozytorium, jeden typ zadania. Efekt bramki (5/5 vs 1/5) jest ostry; stawki na ustalenie w innym miejscu to ±1 agent. Traktuj to jako silny pilot, nie benchmark.
Metryka jakości: wykrywanie wzorca nad tekstem przeglądu (cytowania wykluczone), ręcznie sprawdzane pod kątem fałszywych alarmów. Liczy wzmianki o zweryfikowanych defektach, nie ogólną wymowę przeglądu.
Czas: wszystkie 22 agenty dzieliły jedną maszynę i jeden przydział API; liczby ściana zegara obejmują tę zawartość.
Poprawialiśmy się dwa razy: początkowe liczby tokenów były zawyżone 2–3× (duplikacja użycia na linię w transkryptach; naprawiono przez deduplikację identyfikatora żądania) i wcześniejsza wizualizacja osi czasu niedoliczyła czasu ściana (naprawiono przez pełną atrybuację interwału). Obie poprawy są wbite w każdą liczbę tutaj.
Gotowy na rozwój swojej firmy?
Rozpocznij bezpłatny okres próbny już dziś i zobacz rezultaty w ciągu kilku dni.
Wariant zwycięski to teraz domyślna umiejętność repozytorium check-context-first: wyciągnij skrót silnika kontekstowego (dwa wywołania), następnie przeczytaj dokładnie jeden plik z dysku — konfigurację zespołu — i wyemituj blok potwierdzenia cytujący migawkę i dokładne bramki. Jedna zmierzona słabość, jedna poprawka polityki jednolinijkowej, ponownie zwalidowana tego samego dnia. Ta pętla — mierz, napraw politykę kontekstu, ponownie waliduj — to część, którą zachęcamy Cię do kradzieży, niezależnie od tego, jaki silnik kontekstowy używasz.
Co możesz zrobić w poniedziałek
Podziel kontekst agenta na dwie części: proza (konwencje, architektura, testowanie) vs polityka czytelna dla maszyn (bramki CI, poziomy ryzyka, reguły scalania).
Skróć prozę; nigdy nie skracaj polityki. Podawaj prozę poprzez silnik kontekstowy — meaninggrid jest nasz — i uczynić plik polityki obowiązkowym dosłownym odczytaniem w bramce kontekstu.
Uczynić kontekst audytowalnym. Wersjonuj ingresowany kontekst; wymagaj od agentów cytowania identyfikatora migawki w bloku potwierdzenia, który recenzenci mogą faktycznie sprawdzić.
Mierz, zanim uwierzysz — również nas. Garstka agentów na wariant na własnym repozytorium wystarczy, aby zobaczyć wzór. Oceniaj przeglądy względem zweryfikowanych ustaleń, nie vibów.
Otwarte zaproszenie
Jeśli uruchomisz ten eksperyment na własnym repozytorium — te same warianty, Twój model, Twój zespół — chętnie chcielibyśmy zobaczyć Twoje liczby, szczególnie jeśli je obalają. I jeśli Twój zespół chce pomocy w ustawieniu bramki kontekstu takiej jak ta, lub chce porozmawiać o meaninggrid i stosie harnext, skontaktuj się z zespołem FlowHunt lub znajdź zespół open-source na harnext.dev
. Replikacje, pytania i poprawki są wszystkie mile widziane.
Najczęściej zadawane pytania
Silnik kontekstowy ingresuje dokumentację projektu raz, wersjonuje ją w niezmienną migawkę i dostarcza agentom zwięzły, cytowany skrót poprzez jedno wywołanie narzędzia — zamiast tego, aby każdy agent ponownie czytał każdy dokument przy każdym zadaniu. W naszym eksperymencie skrót zawierał snapshot_id, który agenci cytują jako weryfikowalny dowód, z której wersji reguł pracowali.
Podsumowanie może przenosić znaczenie prozy bez utraty, ale niszczy dokładne, cytowalne szczegóły polityki czytelnej dla maszyn — dokładne nazwy kontroli CI, flagi logiczne, wzorce ścieżek. Agent, który posiada tylko parafrazę, nie może pewnie twierdzić o konkretnym naruszeniu polityki. W naszym teście agenci posiadający dosłowny plik polityki złapali pominięty obowiązkowy check CI 5 razy na 5; agenci posiadający tylko skrót złapali to 1 raz na 5.
Nie — kontekst jest płacony dwa razy, raz w tokenach i raz w uwadze. W naszym eksperymencie wariant, który czytał wszystko (skrót plus cała dokumentacja), uzyskał najgorszą ocenę jakości, podczas gdy najleanersza wystarczająca konfiguracja uzyskała najlepszą. Każdy zbędny dokument konkuruje z rzeczywistym kodem o uwagę modelu.
Każdy agent w eksperymencie działał na Claude Opus 4.8, zweryfikowany z pola model każdego transkryptu. Próbka jest mała (pięciu agentów na wariant, jeden pull request, jedno repozytorium), więc traktuj to jako silny pilot, a nie benchmark — i powiel go na własnym repozytorium, zanim w to uwierzysz. Mniejsze modele prawdopodobnie bardziej zależą od wyselekcjonowanego kontekstu, nie mniej.
Podziel kontekst agenta na dwie części: podaj dokumentację prozą (konwencje, architekturę, testowanie) poprzez silnik kontekstowy jako cytowany skrót i uczynić plik polityki czytelny dla maszyn obowiązkowym dosłownym odczytaniem. Wymagaj od agentów cytowania identyfikatora migawki w bloku potwierdzenia, aby recenzenci mogli zweryfikować, z której wersji reguł korzystał agent.
Štefan to inżynier AI i oprogramowania budujący FlowHunt. Poza samym produktem projektuje przepływy pracy inżynierii oprogramowania dla programistów, które zmniejszają koszty rozwoju przy jednoczesnym podnoszeniu jakości kodu.
Štefan Moravík
Inżynier AI i Oprogramowania
Buduj przepływy pracy agentów, które się opłacają
FlowHunt pomaga zespołom inżynierskim projektować przepływy pracy agentów, bramki kontekstowe i integracje MCP, które obniżają koszty rozwoju i podnoszą jakość kodu.
Jak agenci AI faktycznie implementuja umiejetnosci: Kompletne porownanie miedzyplatformowe
Szczegolowe porownanie techniczne tego, jak 11 glownych frameworkow agentow AI -- od Claude Code i CrewAI po Voyager i DSPy -- wstrzykuje umiejetnosci, narzedzi...
Opracowanie w pełni funkcjonalnej aplikacji enterprise z agentem kodowania harnext
Dziesięć miesięcy, 1409 połączonych PR-ów, trzy audyty kryminalistyczne: jak potokowa linia agentów przesunęła jeden repozytorium korporacyjne z 12% na 92% rozw...
Rozszyfrowanie modeli agentów AI: Ostateczna analiza porównawcza
Poznaj świat modeli agentów AI dzięki kompleksowej analizie 20 najnowocześniejszych systemów. Odkryj, jak myślą, rozumują i realizują różnorodne zadania, a takż...
4 min czytania
AI Agents
Comparative Analysis
+7
Zgoda na Pliki Cookie Używamy plików cookie, aby poprawić jakość przeglądania i analizować nasz ruch. See our privacy policy.