


我们每天都会给编程智能体派真实的工单,它们几乎总能交付可用的东西。这从来不是我们担心的地方。我们担心的是它们如何工作:在已有三个同类助手旁边再加一个新的,为唯一的调用方新建一层抽象,一个修复只补了工单提到的那一条路径,却让四个兄弟路径继续坏着,一个"大概是 bug"的发现却没有任何证据。每一次改动在局部都是合理的,但聚合起来就是熵增。
太长不看: 在我们智能体编排核心的五个 Tier-3 pull request 中,三项可组合的技能——
ponytail(减法)、grain(对齐)和review-proof(证明)——在交付五个功能的同时删除了 821 行代码,捕获了一处仅凭"看起来合理"就会被合并的静默契约破坏,并让每一次改动都顺着既有架构的纹理推进。以下是每项技能的作用,以及支撑它们的真实 diff。
拿走护栏,编程智能体就是一台极速生产"看起来合理的负债"的机器。所以我们依靠三项反向发力的小技能——各对应一种本能:减法、对齐、证明。
ponytail—— 写能真正生效的最偷懒的东西。先删再加。(这个不是我们写的——它是 Dietrich Gebert 的开源技能 ,我们为自家技术栈做了适配。)grain/grain-review—— 把它放到代码库早已决定它该去的地方。别发明第二种做法。review-proof—— 在一个发现能被复现为失败测试之前,不要相信它。
grain 和 review-proof 是我们以 ponytail 的同一精神自研的,并针对我们的架构做了调优。下面五个 PR 中的每一个都触及我们的智能体编排核心——仓库里最容易因为马虎而出事的地方——而且每一个都被归为 Tier 3:在自动审查器之外,额外增加测试覆盖和人工审查,没有例外。
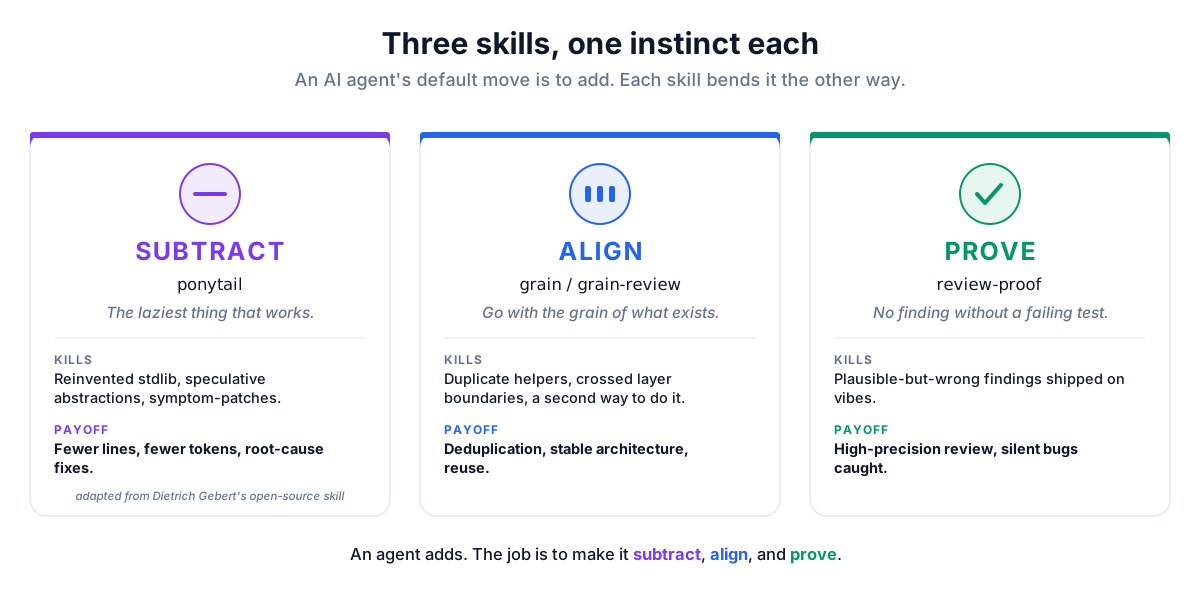
三项技能一览:ponytail 做减法,grain 做对齐,review-proof 做证明。
第一部分 · 是什么 —— 熵增才是默认状态
当你把一个仓库交给 AI 智能体时,没有人会提醒你这件事:每个智能体只做局部优化,而且什么都不记得。 它看到的是工单,而不是你团队花了几个月收敛出来的约定。它没有理由优先选用你现有的邮件服务而不是新建一个,不记得重定向状态集合已经在三个文件之外定义过了,也没有那种"修复应该落在共享函数里,而不是这个调用方"的本能。放任运行,N 个智能体就会产出 N 种略有差异的做事方式。这不是靠 lint 就能清掉的代码质量问题——而是一种会不断复利的结构性漂移。
这三项技能各自针对这种漂移的一个维度。
ponytail —— 能生效的最偷懒做法
Ponytail 是一位资深开发者,他曾因为别人炫技式的抽象在凌晨三点被呼起,并且拒绝写出下一个。它运行一把梯子,停在第一根能承重的横档上:这东西到底需不需要存在(YAGNI)→ 本代码库里是不是已经有了 → 标准库能不能做 → 原生平台特性能不能做 → 已安装的依赖能不能做 → 能不能只用一行 → 只有到这时,才写能生效的最少代码。
对智能体来说最重要的那一档是 “本代码库里是不是已经有了?” 重新实现几个文件之外已有的东西,是智能体垃圾产出中最常见的一种。而 ponytail 的 bug 修复规则让 diff 保持诚实:修根因,不修症状。 对你即将改动的函数,grep 它的每一个调用方;在共享函数里加一道防护,比在每个调用方各加一道防护 diff 更小——而且不会让兄弟路径继续坏着。
grain / grain-review —— 顺着纹理走
如果说 ponytail 管的是你写得多少,那 grain 管的就是它放在哪里、长成什么形状。它只有一条规则:找到最近的一个既有范例,照抄它的形状,并说明你抄的是谁。 新代码读起来,应该像写旁边那个文件的人顺手也写了这个文件。
Grain 也是架构得以强制执行的地方。我们的后端是相当标准的垂直切片 + 六边形布局——表现层调用应用层,应用层调用领域层,基础设施向内依赖,领域层永不向外回伸。像*“这个路由跳过了它的控制器,直接拉取了服务”*这样的发现并不是吹毛求疵——它决定了下个月代码库还是不是一个智能体能走得通的地方。grain-review 正是专门猎捕这类问题:重复的辅助函数、被跨越的层边界、伸手去掏另一个功能的内部实现、为一件已经统一做法的事引入第二种约定。
review-proof —— 让发现配得上它的存在
标准的 AI 代码审查会产出看起来合理的发现。有些是真的;有些是自信的胡说;从外面看它们一模一样。review-proof 拒绝相信自己:它先审查,然后强制每一条正确性发现都复现为一个真实的失败测试或可运行的复现脚本,凡做不到的一律丢弃。最后它会跑一遍 grain-review 检查结构契合度。交付的是一份每一条都带有可执行证据的审查——而不是一种感觉。
如果这招管用,我们应该看到什么
- H1 —— 删除会出现在功能 PR 中。 如果 ponytail + grain 在起作用,添加功能应该经常减少净结构,而不只是增加。
- H2 —— 修复只落一次,落在共享的位置。 根因修复应该把许多调用点收敛到一道防护上,而不是在每个调用方撒一把防护。
- H3 —— 审查能捕获人类一眼扫过去的契约破坏。 有证据支撑的审查应该暴露出"看起来没问题"式审查漏掉的 bug——尤其是静默的那类。
第二部分 · 那又怎样 —— 五个 PR,各一种本能
对我们智能体核心的五次真实改动。我们有意把内部细节说得含糊——仓库是私有的——但数字都是从真实 diff 里算出来的,而可迁移的部分是这些经验教训。
减法:一道防护替代十几个抓取点
有一类流程步骤会抓取用户提供的 URL,却没有 DNS 解析安全检查,于是解析到内网地址的主机名可以从后端触及云元数据。诱人的修法是在那十几个抓取点各加一道检查。Ponytail 的答案恰恰相反:一个共享的、带防护的抓取辅助函数,处处使用——而且我们删掉了一张手写的私有网络表(一个通配符 DNS 技巧就能直接绕过去),外加三段重复的重定向循环,以及被复制粘贴到多个文件里的网络检查。
这个 diff 添加了共享辅助函数,并在 22 个文件中删除了约 90 行重复代码。这次删除才是重点:这是活生生的 H2——根因修复让每个调用方都走同一道防护,而不是只补工单点名的那一条路径。
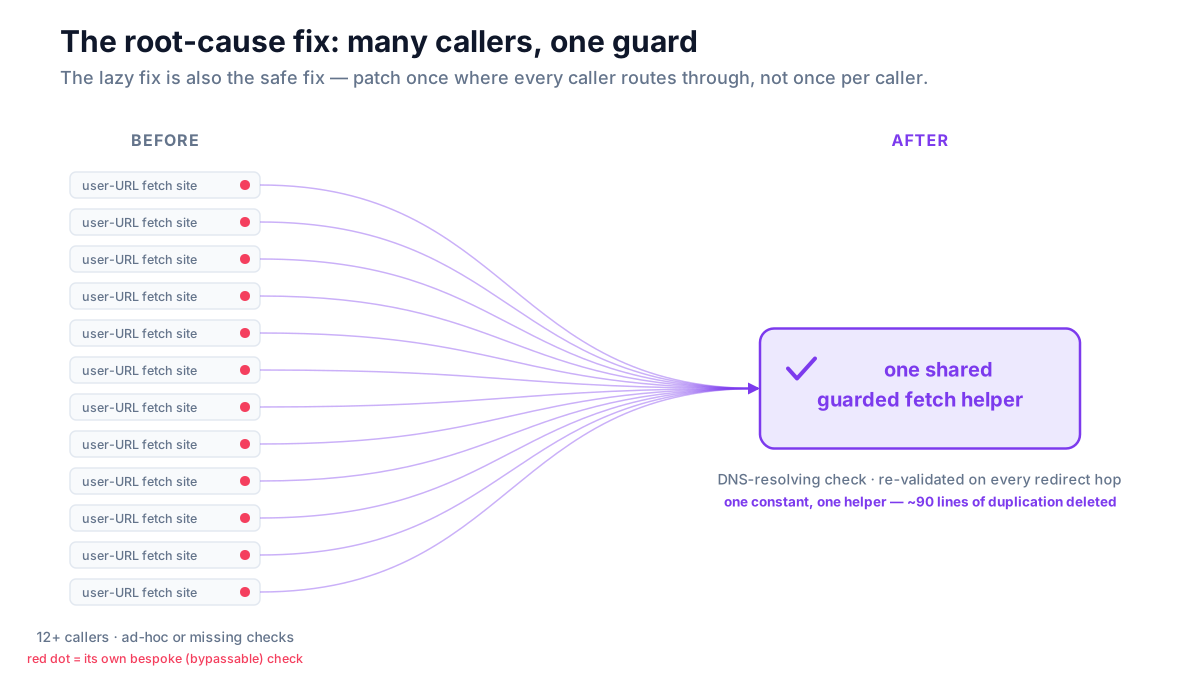
根因修复:十几个临时抓取点收拢到一个共享的、带防护的辅助函数上。偷懒的修法和安全的修法是同一个修法。
减法 + 证明:一个形状防护,在真实运行时上得到证明
我们的 worker 运行时会以序列化字符串的形式持久化一次运行的结果,有时会被包在单元素列表里。期待纯对象的消费方因此崩溃。错误的修法是在每个消费方散布防御性类型检查。相反:一个小的形状规范化辅助函数,让每个消费方都改指向它——这几乎是一次纯粹的单防护添加,取代了纪律较差的智能体本来会写下的 N 个临时防护(+558 / −24,7 个文件)。
让这件事成为 review-proof 故事的是那个测试。我们没有针对假定的序列化形状做断言,而是让一个真实工作流跑过真实的运行时和存储——不用任何 mock——并证明了运行时实际持久化的形状。工单里悬而未决的问题字面上就是运行时在这里到底序列化成了什么?——唯一诚实的答案就是一个你能跑出来的答案。
证明:审查捕获了一处静默的契约破坏
功能:按节点配置的备用模型,让固定在某个提供商的流程在服务中断时能优雅降级。最直观的第一版是把模型包进框架内置的备用组合器里。
它在顺风路径上能跑通。但它同时静默地关掉了两项通过 isinstance 依据具体模型类型来启用的提供商功能——被包装后的对象不再是那个类型,于是原生结构化输出和提示词缓存都悄悄关闭了。没有报错。没有失败的顺风路径测试。这正是人类审查会一眼扫过去、而"看起来没问题"的智能体会批准的那类东西。
review-proof 没有批准它——它把两处破坏都复现成了失败测试,从而迫使重新设计:把备用逻辑下移到执行时应用,这样每个模型都保持其具体类型,类型门控的功能也继续可用。H3 被决定性地证实:证据捕获了一个"看起来合理"就会发出去的 bug。
对齐:一个选择器,而不是两份拷贝
增加第二个通知渠道意味着渠道选择器 UI 现在有两个家——一个创建向导和一个设置弹窗。默认的智能体动作是给两处都加上新分支,于是同一个状态机长出了两份拷贝。grain 说:这东西本来就应该只有一种形状——让它共享。 我们抽出了一个选择器 hook,让两个界面都通过它驱动,把新渠道插入既有的配置联合类型,并复用现有的邮件服务,而不是新增一套发送机制。
24 个文件 +1,735 / −340。 这种规模的功能却移除了 340 行,这正是 H1 的直观体现:把两份选择器拷贝去重成一份,替新渠道付掉了相当一部分成本。
对齐 + 证明:复用端点,镜像路径
让用户在创建 issue 时附加文件,本可以意味着一个新的上传端点、一套新的分发机制、一条新的提示词路径。grain 几乎把所有内容都引到既有轨道上:既有的上传端点、一个与后端白名单完全镜像的前端可接受列表,以及一个复用了定时任务已经在用的资格判定机制的延迟分发修复。它带着有证据支撑的修复一起上线,其中包括一个在并行上传下会丢数据的真实事务隔离 bug。27 个文件 +1,776 / −218——一个大型功能,却仍然通过接入既有切片而不是发明新切片,找到了 218 行可以删的东西。
记分牌
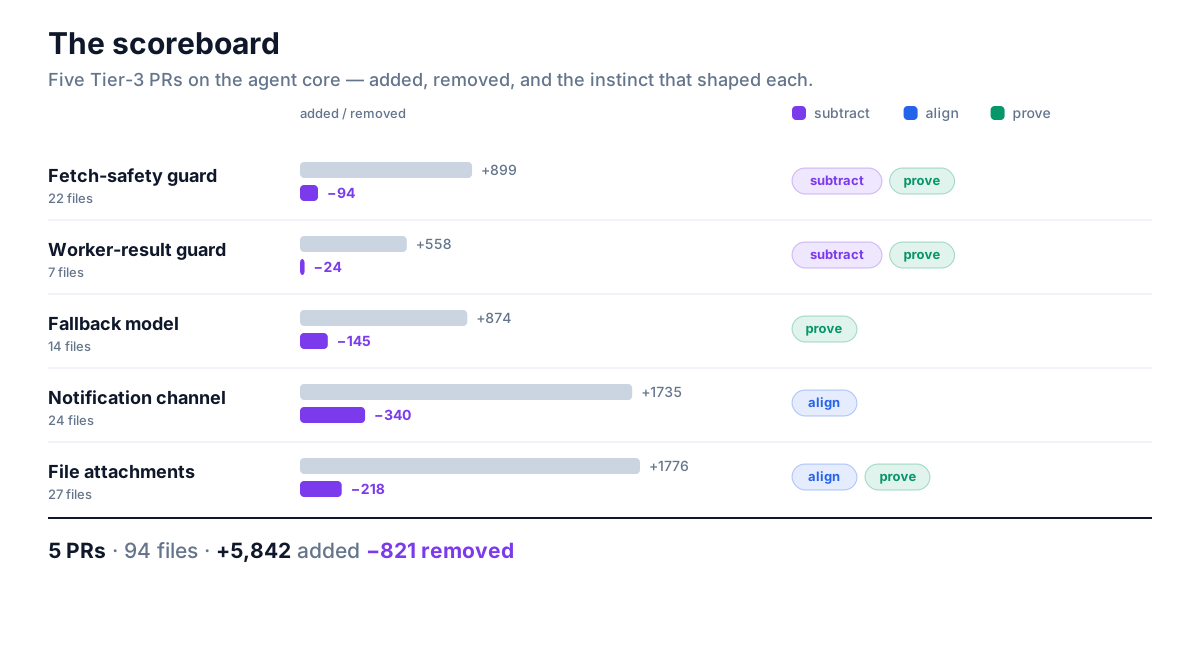
五个 Tier-3 PR:各自增加了什么,删除了什么,以及背后的本能是什么。
智能体核心上的五个功能与修复 PR 删除了 821 行——不是靠做得更少,而是靠拒绝重复已有的东西,也拒绝保留那些根因修复之后已属多余的治标补丁。
完全披露
- 这些是技能,不是研究。 这不是带基线对照组的受控实验;它是五个真实 PR,纪律被施加其上。反事实——同一个智能体在没有这些技能时会交付什么——是有依据的估计,不是测量值。静默契约破坏那个故事是最干净的证据,因为我们在重新设计之前亲眼看着审查复现了那个 bug。
- 行数是代理指标。 −821 是从 diff 得出的真实数字,但"删除的行数"代表的是"被避免的重复和无效灵活性"。一项技能如果劝住智能体不要写 200 行投机性代码,那在 diff 里完全不会留下痕迹——这里最大的胜利是看不见的。
- token 节省是方向性的。 更小的 diff、更少的文件改动、复用的结构,意味着在生成、审查和反复审查上花的 token 更少——但我们不会给出每个 PR 硬性的 token 差值。
ponytail不是我们的。 它是 Dietrich Gebert 的开源技能 ;我们做了适配。grain和review-proof是我们的,以同一精神构建。三者都作为 Claude Code 上的本地项目技能运行——是提示词加流程,不是你要安装的二进制文件。

第三部分 · 接下来怎么办
交付了什么。 三项可组合的技能。ponytail 和 grain 在编写过程中运行;ponytail-review、grain-review 和 review-proof 针对一个 diff 运行。review-proof 把 grain-review 串成自己的最后阶段,所以一次带证据的审查同时也免费获得一次结构检查。
你周一就能做的事 —— 你不需要我们这套确切的技能:
- 把"复用"放到第二档,而不是第十档。 在智能体写一个辅助函数之前,先让它 grep 有没有现成的。“本代码库里是不是已经有了?“应该排在"我能不能把它写得干净?"前面。
- 在根因处修复,用调用方清单来证明。 要求每个 bug 修复都列出被改动函数的每一个调用方。共享函数里的一道防护胜过每个调用方一道防护——而且 diff 更小。
- 给新代码一个最近的兄弟去照抄。 “找到最近的既有范例并镜像它的形状"能把架构从一份没人读的文档,变成智能体默认遵循的惯例。
- 在 CI 里强制层边界,而不是靠感觉。 一个只在新增跨层导入时失败的棘轮机制,让你能在不把既有债务一锅端的情况下守住底线。
- 不要交付你无法复现的发现。 让智能体先写失败的测试。如果它无法让 bug 复现,那就不是 bug——那只是观点。丢掉它。
- 让审查去删除。 专门针对过度设计跑一遍审查——“我们能砍掉什么”——与正确性检查分开。一个 diff 最好的结局是它变得更短。
试一试,尤其是当它在你那里失败时。 如果你在真实代码库上跑编程智能体,熵增已经在发生了——你只是还没测量过。把其中一项变成审查环节,用在你接下来的十个智能体 PR 上,数一数删掉了多少。如果减法-对齐-证明并没有缩小你的 diff,也没有捕获静默的破坏,我们真的很想听听。尤其欢迎指正和反例。
智能体负责添加。我们的工作是让智能体为每一行都挣得存在的理由。
