


1つの数字を探すために200ページのPDFをスクロールするのはやめましょう。47ページ目に埋もれた契約条項であれ、研究論文の奥深くにある方法論の詳細であれ、四半期報告書のどこかにある売上高であれ、密度の高い文書を手作業で探し回るのは、午後を無駄にする確実な方法です。
同じ情報は、簡単な会話をすることでより早く得られます。AI Chat with PDFs を使えば、文書をアップロードし、平易な言葉で質問するだけで、ファイルから直接引き出した正確な回答を数秒で得られます。ここでは、この技術の仕組み、ステップごとの使い方、そして最も時間を節約できる7つのプロフェッショナルなシナリオを紹介します。
AI PDFチャットとは何か、どのように機能するのか?
AI PDFリーダーは、見栄えを良くしただけの検索バーではありません。文書をアップロードして質問すると、システムはキーワードマッチングとは意味のある形で異なる処理を行います。つまり、回答を生成する前にファイルレトリーバーを使って文書内で最も関連性の高い箇所を特定します。このステップ、すなわち「推論の前の検索」が、正確な回答とおおよその回答を分けるものです。
手順を平易な言葉で説明します。
1. PDFをアップロードします。 システムがそのコンテンツを検索できるように文書が処理されます。
2. 質問をします。 レトリーバーが、あなたの特定のクエリに最も関連する箇所を文書内から検索します。
3. AIはそれらの箇所から回答します。 回答はモデルの学習データや外部ソースではなく、実際の文書テキストに基づいています。回答はPDFからのみ得られます。
4. 会話の文脈はセッション全体を通じて維持されます。 フォローアップ質問も一貫性を保ちます。アシスタントは会話で交わされたすべての内容を追跡するため、文脈を再度説明したり、何について尋ねているのかを言い直したりする必要はありません。
理解しておく価値のある重要なアーキテクチャ上の詳細は、検索がアップロード時に一度だけではなく、すべてのクエリで行われることです。これにより、200ページの報告書の83ページ目にある特定の数値について尋ねた場合でも、フォローアップ質問が最初の回答に依存する場合でも、回答が正確に保たれます。
事前に知っておくべき制約が1つあります。デフォルトでは、このツールはテキストベースのPDFのみで動作します。つまり、テキストがデジタルで埋め込まれ、選択可能な文書です。テキストが埋め込まれていない画像ファイルであるスキャンPDFは、デフォルトでは検索対象にできません。
スキャンしたPDFは、まずOCR に通してテキストを取得できます。メインのチャットワークフロー内でOCRを有効にすることもできますが、チャットワークフローに不要な処理時間とコストが加わる可能性があるため、おすすめしません。スキャンした文書を日常的に扱う場合は、まずOCR処理 に通してテキストを選択可能にしてください。
質問が曖昧な場合、たとえば3つの価格表がある文書で「価格セクション」について尋ねた場合、アシスタントは推測せずに確認の質問をします。自信を持って間違った回答をするよりも、確認を促す方が役立つからです。これはまた、このツールが文書に含まれる内容の範囲について正直であることを意味します。PDFが扱っていない事柄について尋ねた場合、外部の情報を引き出すのではなく、その旨を伝えます。
PDFをアップロードして質問を始める方法
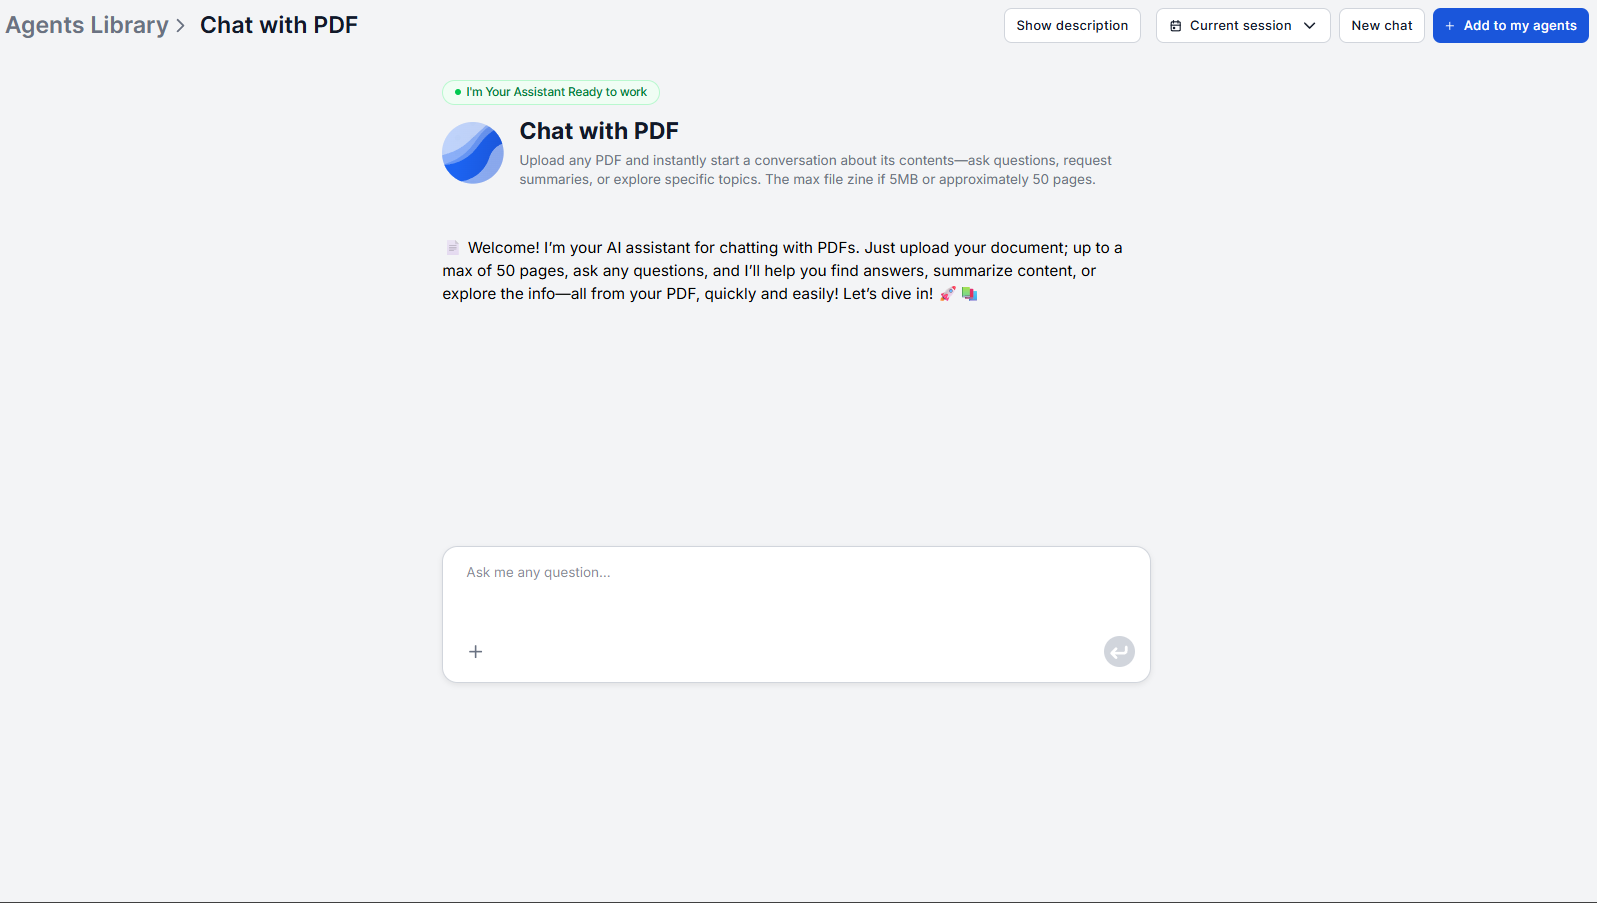
ワークフローはシンプルです。PDF Q&A AIツール を開き、文書をアップロードして、入力し始めるだけです。設定もタグ付けも事前準備も不要です。
ステップ1:文書をアップロードします。 ファイルアップロードのインターフェースを使ってPDFを添付します。テキストベースのPDFであればどれでも動作します。
ステップ2:最初の質問を平易な言葉でします。 検索クエリのように質問を表現する必要はありません。「解約条項は何ですか?」は「termination」と入力するのと同じように機能します。解釈はレトリーバーが行います。
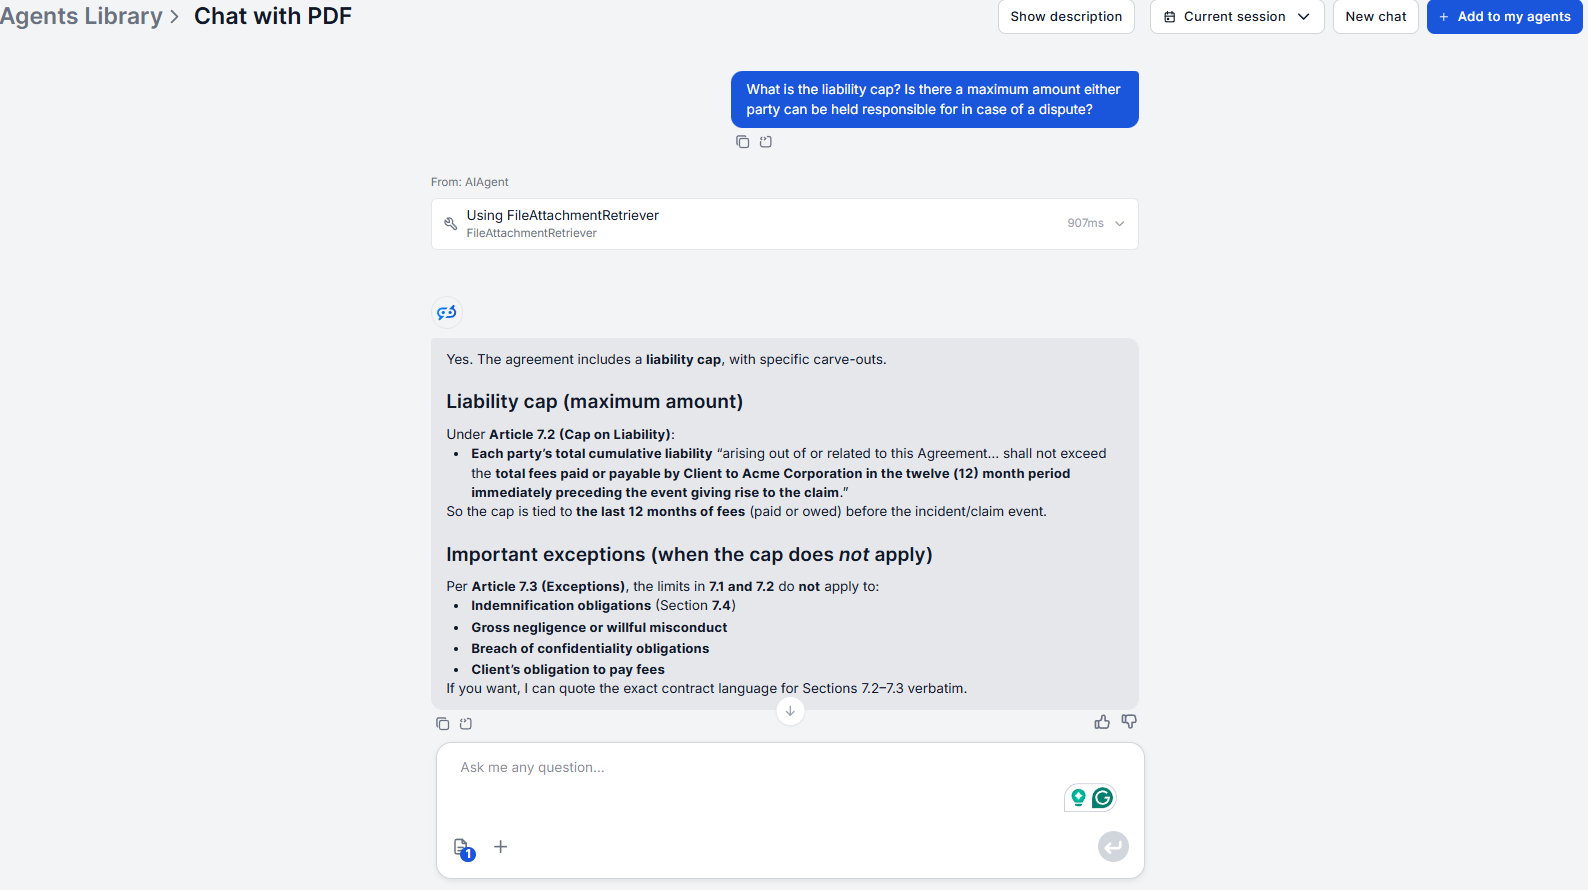
ステップ3:回答を読み、自然にフォローアップします。 アシスタントは文書からの関連する文脈を添えた簡潔な回答を提供します。セッションは会話履歴全体を保持するため、フォローアップ質問は人間との会話とまったく同じように機能します。「そのセクションには通知期間について何と書かれていますか?」は、前の回答の続きから引き継がれます。
ステップ4:必要に応じて要約を依頼します。 質問応答だけでなく、特定のセクションや文書全体の要約をアシスタントに依頼できます。要約はキャッシュされた概要ではなく実際のコンテンツから生成されるため、文書を正確に反映します。

Chat with PDFが数時間を節約する7つの活用シーン
すべての活用シーンに共通する点は同じです。答えは文書の中にあるものの、手作業で見つけるには時間がかかりすぎるということです。AI文書チャットは、驚くほど幅広いプロフェッショナルなタスクでこのボトルネックを取り除きます。それぞれの詳細と具体的なクエリ例については、Chat with PDF:7つの活用シーン をご覧ください。
- 法的契約書のレビュー — 文書を最初から最後まで読むことなく、特定の条項、義務、責任条件、更新条項を特定する
- 学術研究 — 論文から知見、方法論の詳細、統計結果、引用をすばやく抽出する
- 財務報告書の分析 — 提出書類から特定の指標、セグメント別の内訳、脚注の開示情報を引き出す
- 技術文書 — マニュアル、API仕様書、アーキテクチャ文書から手作業で検索するのではなく直接答えを得る
- 学生の課題 — 教科書の章や課題図書について質問し、理解を確認したり試験に備えたりする
- ビジネス提案書とRFP — 長い文書に埋もれた要件、評価基準、価格条件をすばやく洗い出す
- 医学・科学論文 — 臨床または研究レビューのために、研究結果、投与量データ、特定の方法論的詳細を抽出する
AI PDFチャット vs 手作業の検索:時間の比較
| タスク | 手作業の検索 | Chat with PDF AI |
|---|---|---|
| 特定の条項の特定 | 20〜40分 | 1分未満 |
| 論文から主要な知見を抽出 | 45〜90分 | 5〜10分 |
| 財務報告書から数値を引き出す | 30〜60分 | 5〜10分 |
| 特定のセクションを要約 | 15〜30分 | 1分未満 |
| 関連する質問でフォローアップ | 最初からやり直し | 瞬時、文脈は維持 |
週に複数の文書を処理するナレッジワーカーにとって、1か月にわたって積み重なる時間の節約は大きなものです。このツールは、必要な特定の情報をすばやく得るための第一段階として最も効果を発揮し、その後、より深く読む価値のあるセクションについてのみ全文書に戻るのが良いでしょう。
単一の文書を超えるワークフローでは、検索可能なナレッジベースを構築し、ナレッジソース 機能を通じてチャットボットが同時にアクセスできる複数の文書を接続できます。また、ソース資料を検索するのではなくそこから技術文書を生成する場合には、AIドキュメントライター がワークフローのその部分を担います。
本格的に導入する前にPDFチャットツールを比較するなら、ChatPDF vs FlowHuntの比較 で4つのツールすべてを同じ文書でテストし、精度、価格、スキャンPDFの対応を検証しています。
