


手动发票处理会实实在在地消耗时间。行业基准显示,计入数据录入、核对和流转后,完整的处理流程为每张发票 10 至 15 分钟 ,而手动键入的数据录入错误率约为 1.6% 至 4% ,具体取决于操作人员的熟练度和疲劳程度。随着发票数量增长,这些错误会不断累积。
AI 发票数据提取 可读取任意发票格式,并在几秒内输出结构化数据。以下是确切的流程,以及在数据触及您的会计系统之前需要核验的内容。
手动发票处理的隐性成本
每一张落入共享收件箱的发票都会触发同一套流程:有人打开它,读取字段,把它们键入电子表格或 ERP,然后归档原件。将其乘以每月数百或数千张发票,成本便会迅速累积。计入人力、错误纠正和逾期付款罚金后,手动发票处理每张的综合成本为 12-16 美元 ,而自动化处理仅为 2-5 美元。
更大的问题在于,错误率并不会随着业务量的增长而保持平稳。一张被误输的总额或颠倒的发票号,在每月十张发票时只是小麻烦。到了每月一千张,同样的 1.6-4% 错误率就意味着账面上躺着数十张数据错误的发票,每一张都可能在核账时造成不匹配,或在日后成为审计标记。
还有一个与准确率无关的扩展性问题。手动处理时间大致是线性的:发票量翻倍,所需的人力工时也大致翻倍,无论是现有团队加班还是新增人手。这些时间没有一分钟花在判断上,而是花在从页面上读取数字、再重新键入到别处。这正是 AI 发票处理工具要解决的问题。
AI 发票数据提取的工作原理
一款 发票 OCR AI 工具结合了两个层面。光学字符识别读取页面上的文本,语言模型则解读这些文本的含义——它能识别出“Total”一词附近的数字就是发票总额,无论它位于页面的什么位置,也无论发票使用何种语言。
这与通用的文档问答工具不同。如果您需要就合同或长篇 PDF 报告提出开放式问题,Chat with PDF 这类工具正是为这种对话式检索而构建的。发票提取在设计上更为狭窄、结构化程度更高:它总是查找相同的字段,并总是以相同的格式返回,这正是其输出无需人工清理即可使用的原因。
这种结构也是该工具无需模板的原因。未与语言模型配合的传统 OCR 软件,通常需要为每种供应商版式单独制作模板。AI 发票处理工具是从概念上查找项目(“总金额”“发票号”),而不是查找页面上某个位置,因此新供应商的发票第一次上传就能处理。
分步操作:处理您的第一批发票
FlowHunt 的发票数据提取器 以简单的聊天流程运行。端到端的过程如下:
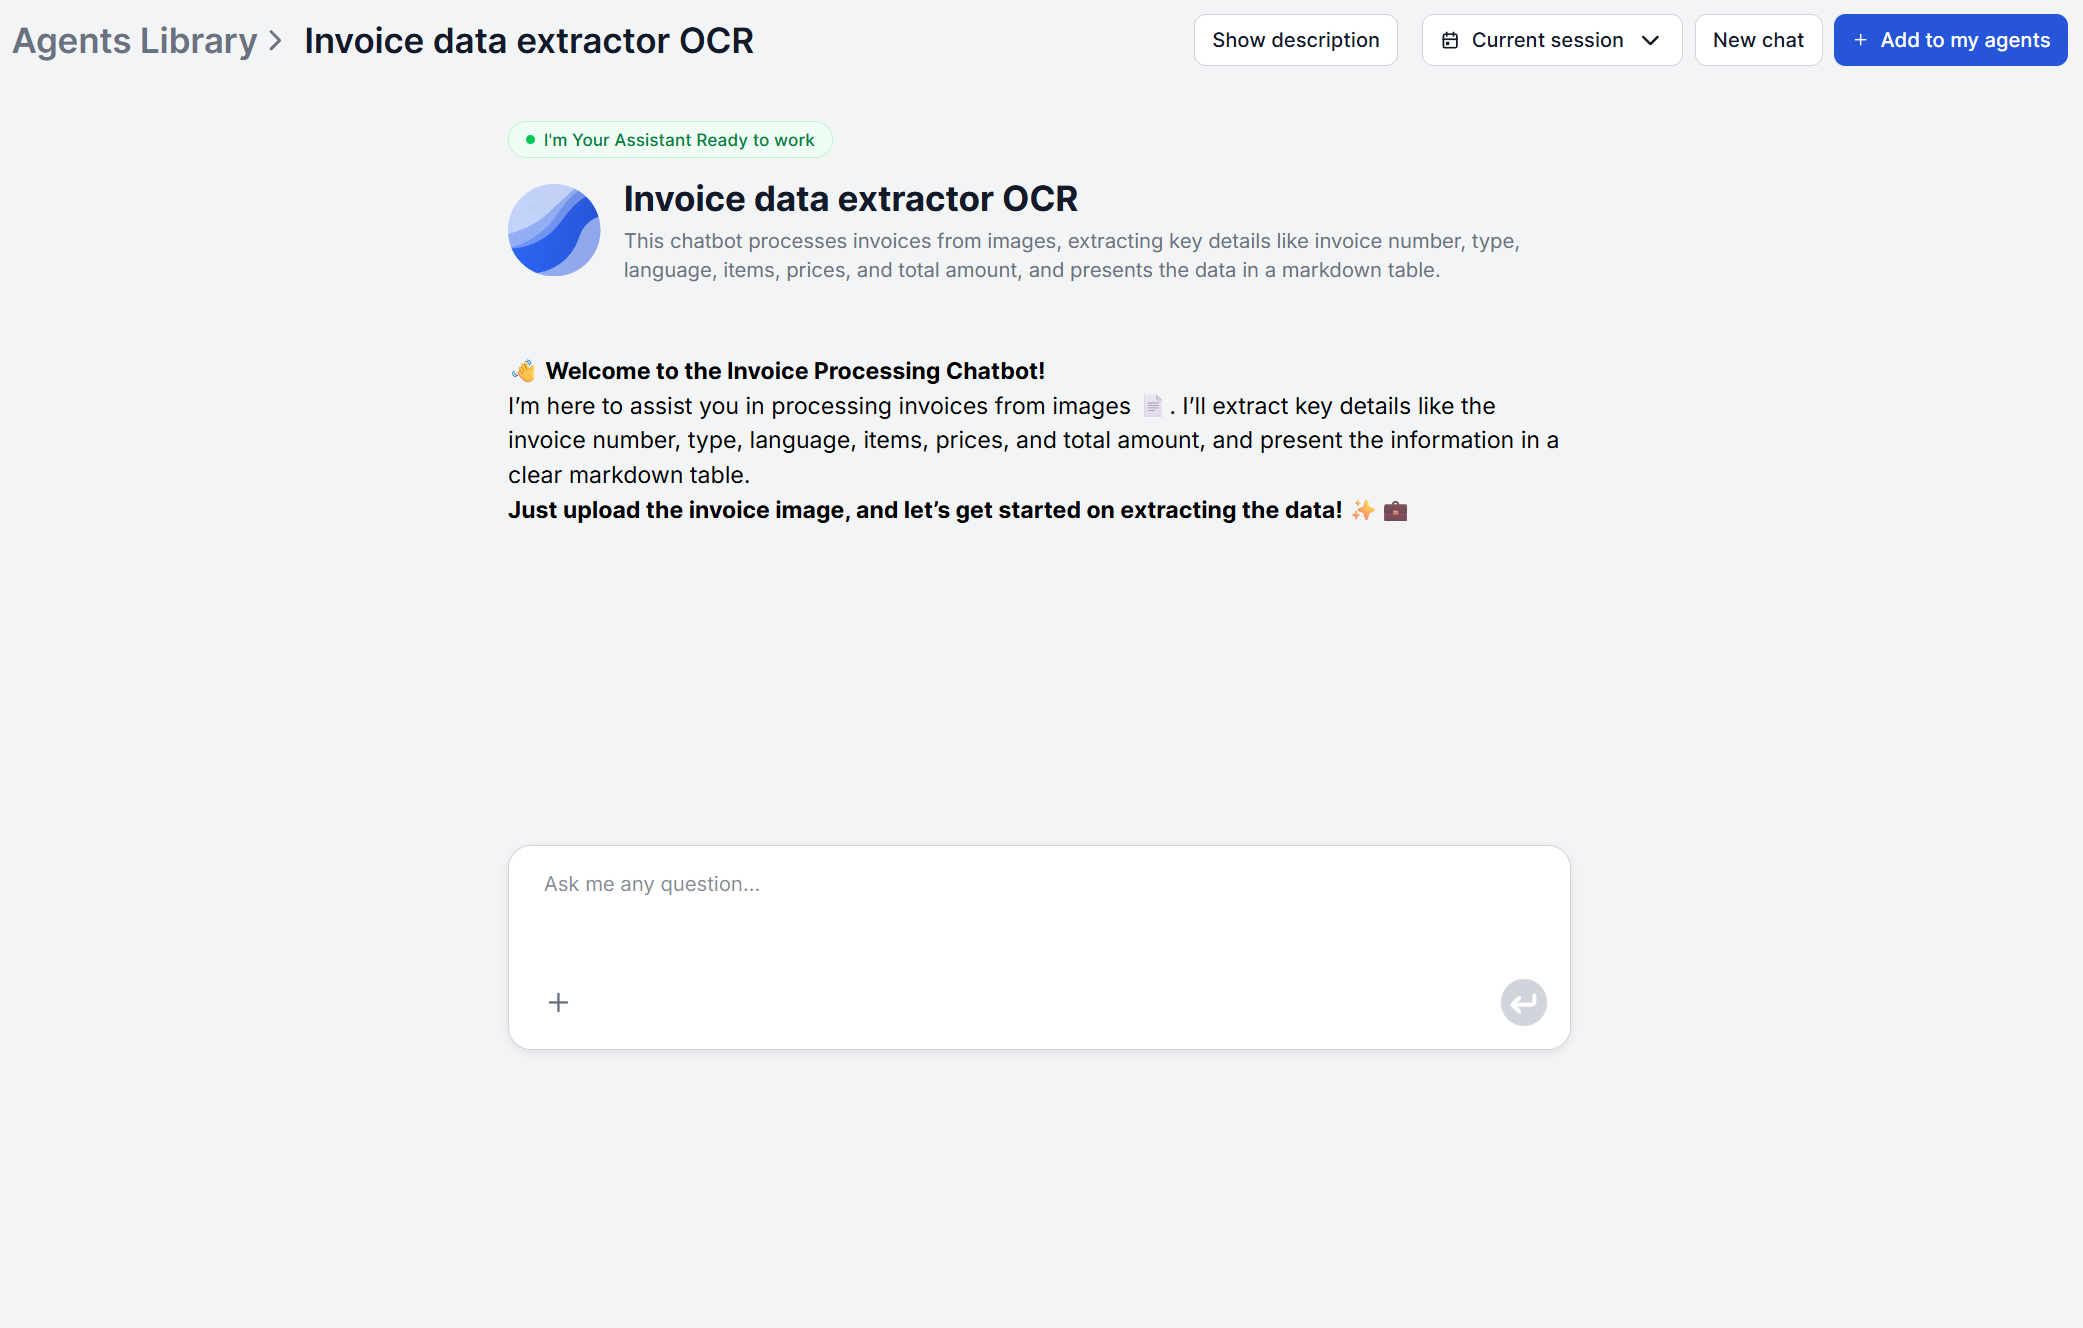
- 打开聊天机器人。 欢迎消息会说明需要上传什么。您无需配置任何内容。
- 上传发票图像。 扫描文档、照片或数字截图均可使用。
- AI 读取并提取数据。 结构化提示驱动模型执行 OCR 并提取出所有字段。
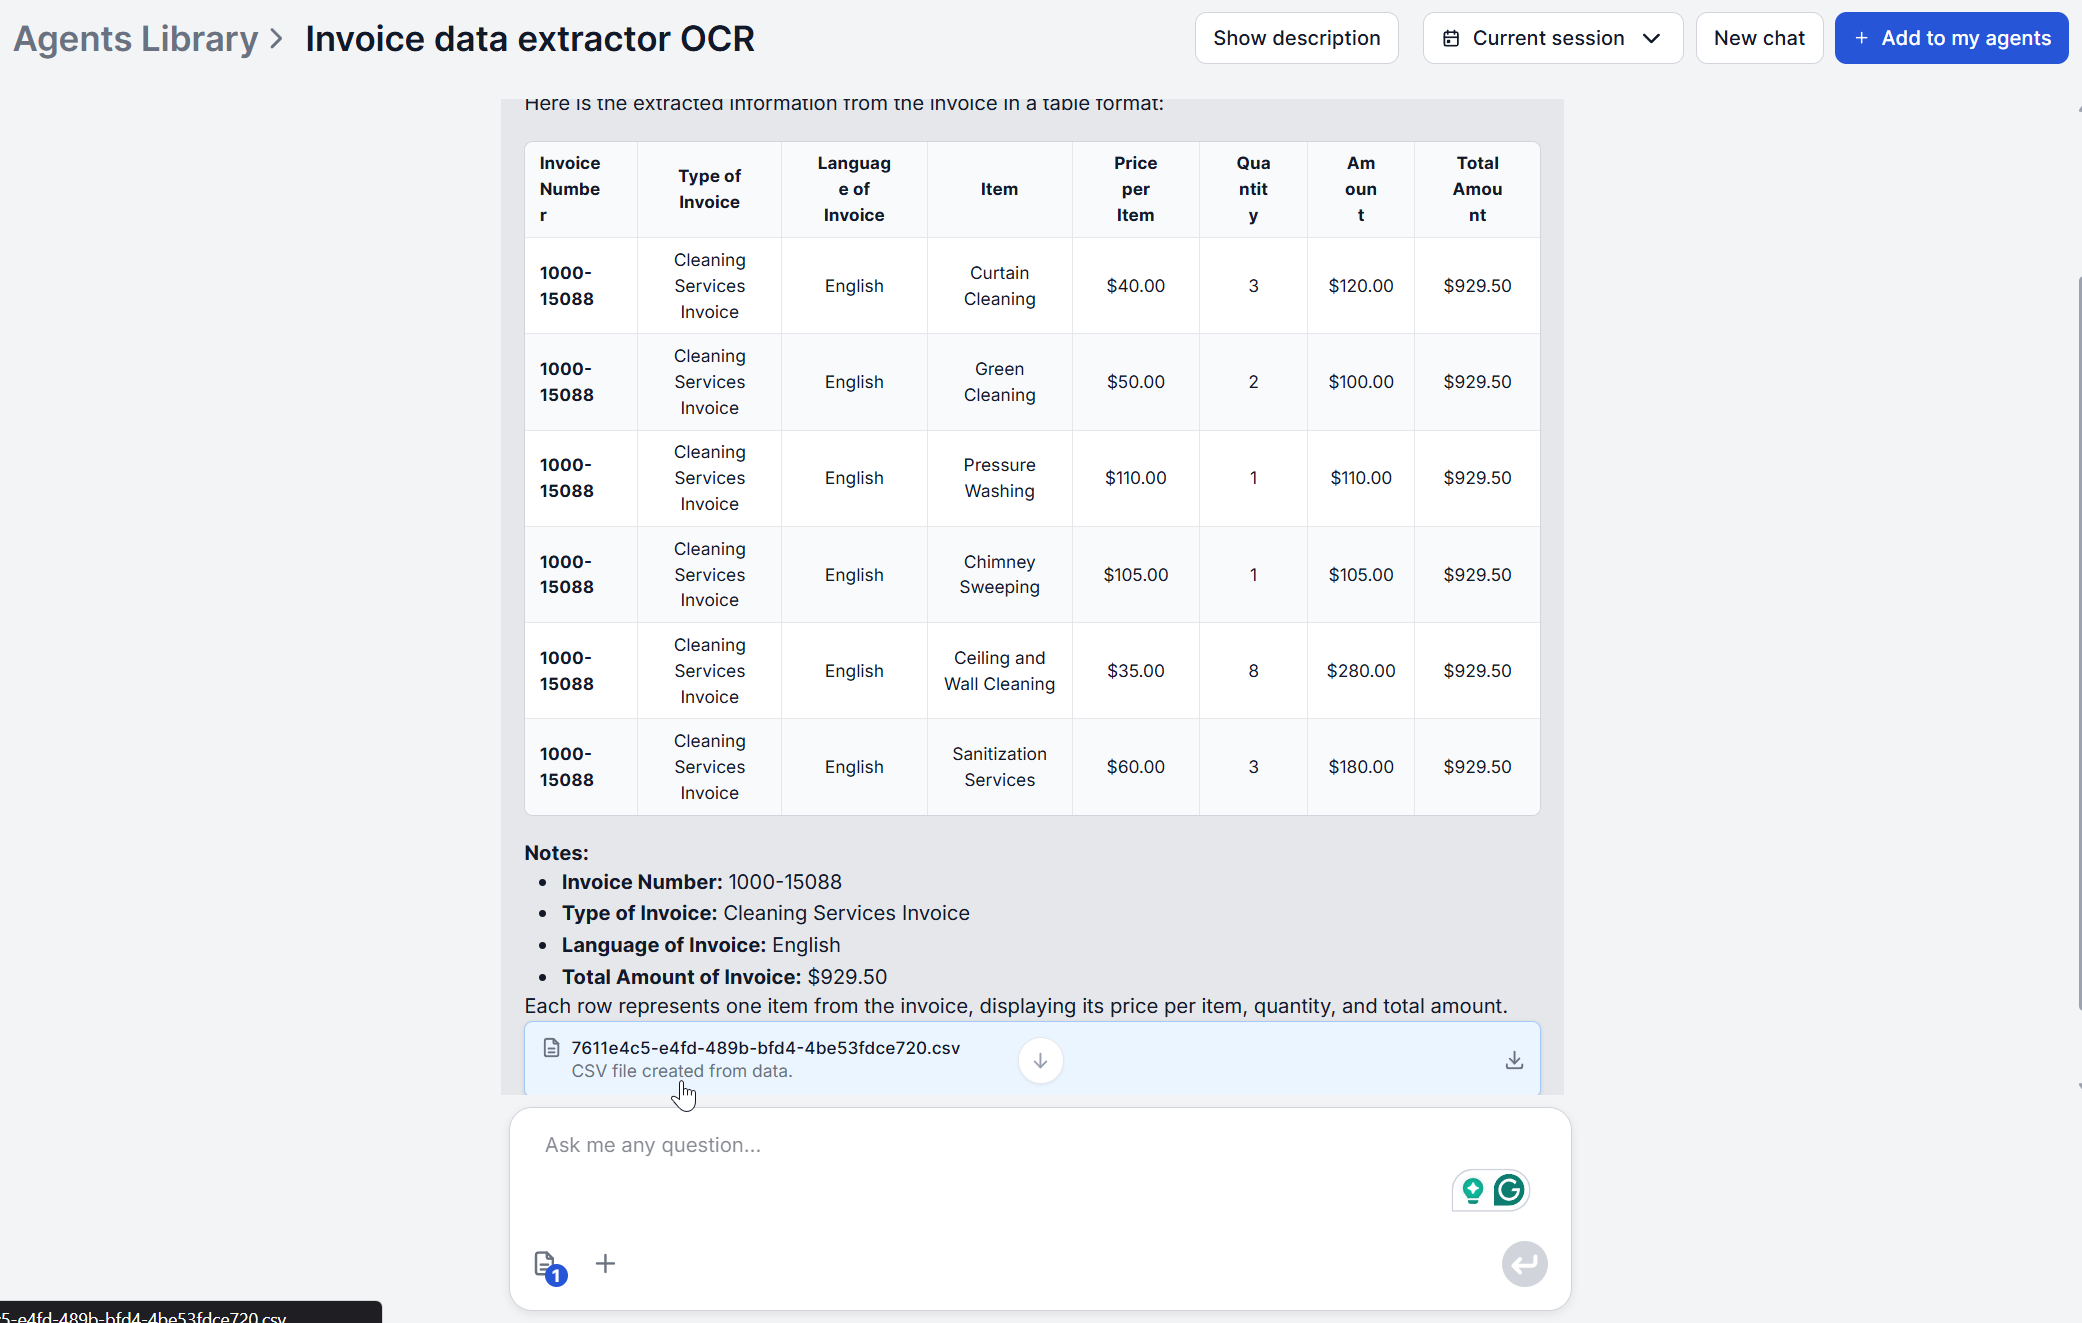
- 查看 markdown 表格。 结果会返回在聊天中,每个发票明细行占一行,便于一眼核对。
- 获取结构化导出文件。 同时,工作流会生成一份详细的 CSV,可直接下载并导入您的会计系统。
应用场景:财务团队的应付账款自动化
应付账款团队是最契合的场景。一个每月处理数百张供应商发票的财务团队,会把全职岗位中相当大的一部分时间花在数据录入上——打开每份 PDF 或扫描件,将总额与采购订单核对,再把数字键入总账。
而将发票交由自动发票数据录入处理,就把它变成了“上传并复核”。提取器负责读取和结构化,团队的时间则从转录转向核账和异常处理。
由于 CSV 输出除金额外还包含增值税号和公司名称,它被设计为可直接嵌入现有的应付账款工作流,而无需新增系统。如果会计平台是 Xero,FlowHunt 通过 MCP 实现的 Xero 集成 可让提取出的数据直接进入会计工作流,而无需手动导入 CSV。
对应付账款团队而言,另一项变化是月末结账的样子。当每张发票都已按相同方式读取、结构化并导出后,将发票与采购订单匹配、标记差异就变成了一项复核任务,而不再是数据收集任务。

加入我们的新闻通讯
免费获取最新提示、趋势和优惠。
应用场景:中小企业的费用管理
规模较小的团队会遇到同样的问题,只是量级不同。不是源源不断的供应商发票,而是员工提交的费用收据——用手机拍摄的照片,语言和货币取决于供应商恰好使用什么。一款能处理照片而非清晰扫描件的发票自动化工具在这里很重要,因为费用收据很少是干净规整的文档。
目前要在月底核对一鞋盒收据的创始人或行政经理,会改为得到一张结构化明细行表格。无需重新键入,也不必依赖三周后还记得一张褪色收据上写了什么。
而当问题不是“这张收据写了什么”,而是“这份费用报告是否符合我们的差旅政策”时,这正是将提取与文档问答工具(如 Chat with PDF )配合使用的好时机,用来核查政策文件本身。先用提取处理收据以获取数字,再直接向政策文件询问某个费用类别是否可报销——两个各司其职的专用工具,而不是让一个工具同时做两件事。
准确率与验证:过账前该检查什么
没有任何基于 OCR 的系统能 100% 准确,了解风险究竟在哪里是值得的。仅使用 OCR 的系统通常达到 85-95% 的准确率 ,而将 OCR 与 AI/LLM 推理结合可把准确率推升至 95% 以上,一些基准显示在机器可读文档上接近 99%。
在将提取的数据过账到会计系统之前,有几件事值得检查:核对总额与明细行之和(对任何一次提取运行来说都是很好的合理性检查)、检查国际或陌生供应商的增值税号和发票号,以及任何手写内容,因为手写体和非常规字体仍是所有 OCR 流程中最难处理的情况。请把输出视为一次初稿,它在绝大多数情况下都是正确的。
一个实用的验证习惯是抽查样本,而不是逐张检查。在刚开始处理某个新供应商的发票时,从其发票中抽取几张,确认字段对得上,然后再逐步提高信心。一旦某供应商的发票版式连续几次都被正确提取,说明版式本身没有变化,那么该供应商出现新错误的风险会大幅下降。新供应商、版式异常的发票以及金额较大的单次发票,才值得多花三十秒再看一眼。
准备好不再手动键入发票数据了吗? 试用发票数据提取器 ,一分钟内看到您的第一张发票变成结构化数据。
