


Manuell fakturabehandling spiser virkelig tid. Bransjetall viser at full behandling tar 10 til 15 minutter per faktura når du regner med dataregistrering, verifisering og ruting, og manuell tasting har en feilrate ved dataregistrering på omtrent 1,6 % til 4 % , avhengig av operatørens dyktighet og tretthet. Disse feilene forsterkes etter hvert som fakturamengden vokser.
Et AI-basert uttrekk av fakturadata leser alle fakturaformater og gir strukturerte data på sekunder. Her er den nøyaktige prosessen, og hva du bør verifisere før den berører regnskapssystemet ditt.
Den skjulte kostnaden ved manuell fakturabehandling
Hver faktura som lander i en delt innboks, utløser den samme sekvensen. Noen åpner den, leser feltene, taster dem inn i et regneark eller ERP-system og arkiverer originalen. Multipliser det med hundrevis eller tusenvis av fakturaer i måneden, og kostnaden vokser raskt. Manuell fakturabehandling koster 12–16 dollar per faktura med alle kostnader inkludert når du tar med arbeidskraft, feilretting og gebyrer for sen betaling, mot 2–5 dollar for automatisert behandling.
Det større problemet er at feilraten ikke holder seg flat når volumet vokser. En enkelt feiltastet totalsum eller et ombyttet fakturanummer er en bagatell ved ti fakturaer i måneden. Ved tusen blir den samme feilraten på 1,6–4 % til dusinvis av fakturaer med feil data i regnskapet ditt, og hver av dem er et potensielt avvik under avstemmingen eller et revisjonsflagg senere.
Det finnes også et skaleringsproblem som ikke har noe med nøyaktighet å gjøre. Manuell behandlingstid er omtrent lineær. Dobbelt fakturamengde betyr omtrent dobbelt så mange arbeidstimer, enten det betyr overtid for et eksisterende team eller en nyansettelse. Ingen av disse timene brukes på skjønnsvurderinger, men på å lese tall fra en side og taste dem inn et annet sted. Dette er akkurat det et AI-verktøy for fakturabehandling løser.
Hvordan AI-basert uttrekk av fakturadata fungerer
Et verktøy for faktura-OCR med AI kombinerer to lag. Optisk tegngjenkjenning leser teksten på siden, og en språkmodell tolker hva teksten betyr og gjenkjenner at et tall nær ordet «Total» er fakturaens totalsum, uansett hvor på siden det står eller hvilket språk fakturaen er på.
Dette er annerledes enn et generelt verktøy for dokument-Q&A. Hvis du trenger å stille åpne spørsmål om en kontrakt eller en lang PDF-rapport, er et verktøy som Chat with PDF bygget for den typen samtalebasert gjenfinning. Fakturauttrekk er smalere og mer strukturert av design. Det ser alltid etter de samme feltene og returnerer dem alltid i samme format, og nettopp det gjør resultatet brukbart uten manuell opprydding.
Denne strukturen er også det som gjør verktøyet uten behov for maler. Tradisjonell OCR-programvare som ikke er kombinert med en språkmodell, trenger vanligvis én mal per leverandøroppsett. Et AI-verktøy for fakturabehandling ser etter elementer konseptuelt («totalbeløpet», «fakturanummeret»), ikke etter hvor på siden det skal lete, så en ny leverandørs faktura fungerer ved første opplasting.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Steg for steg: Behandle din første fakturabatch
FlowHunts Invoice Data Extractor kjører som en enkel chatflyt. Her er hva som skjer fra start til slutt:
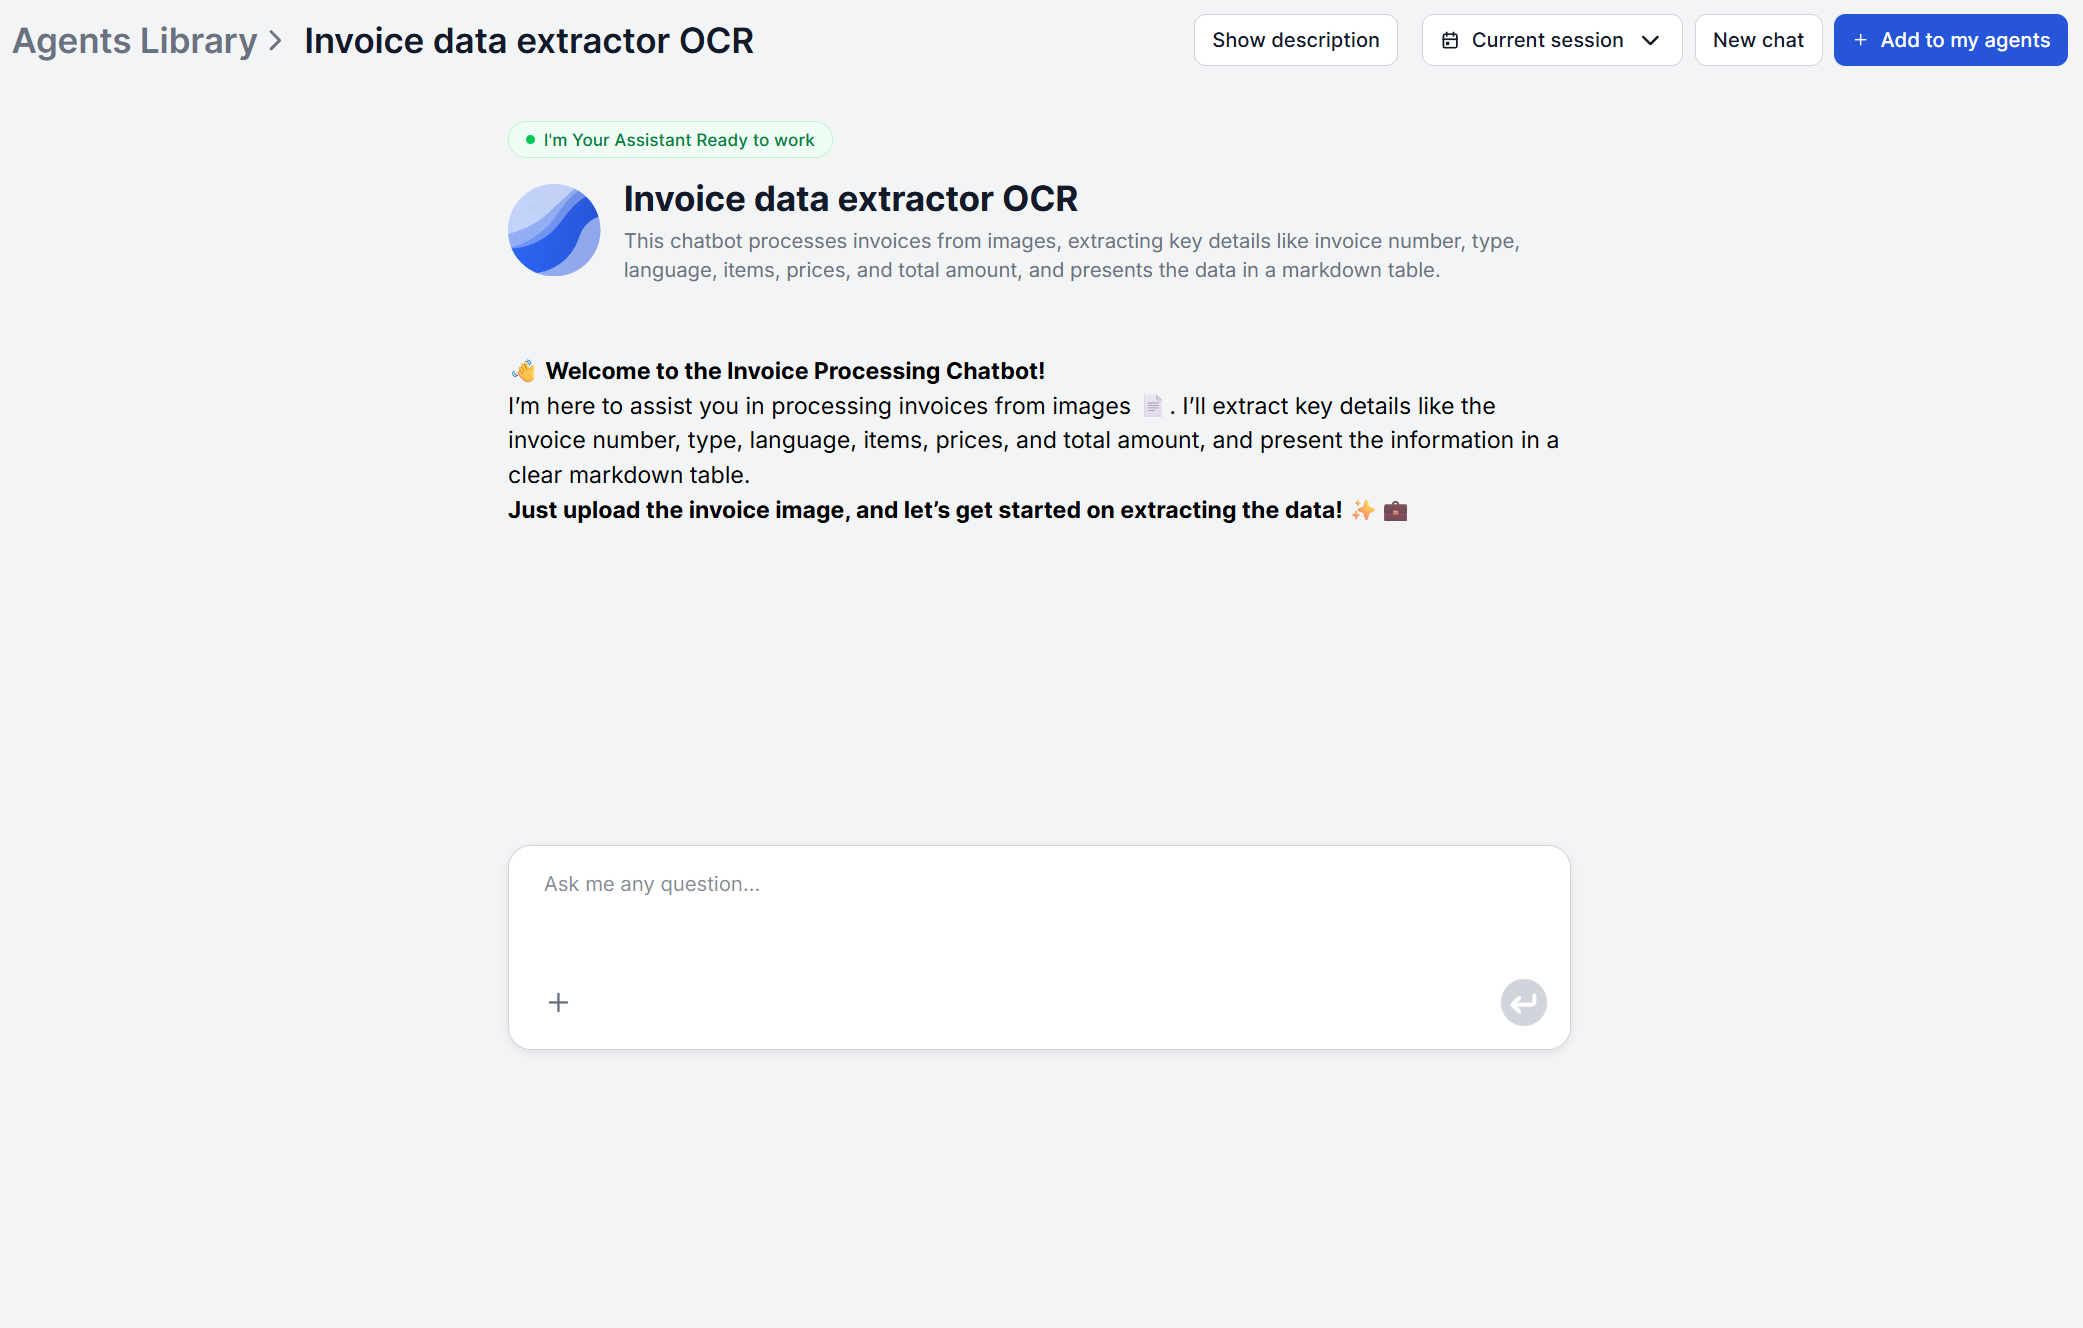
- Åpne chatboten. En velkomstmelding forklarer hva du skal laste opp. Du trenger ikke konfigurere noe.
- Last opp faktuarbildet. Skannede dokumenter, bilder eller digitale skjermbilder fungerer alle.
- AI-en leser og trekker ut dataene. En strukturert prompt får modellen til å utføre OCR og hente ut alle feltene.
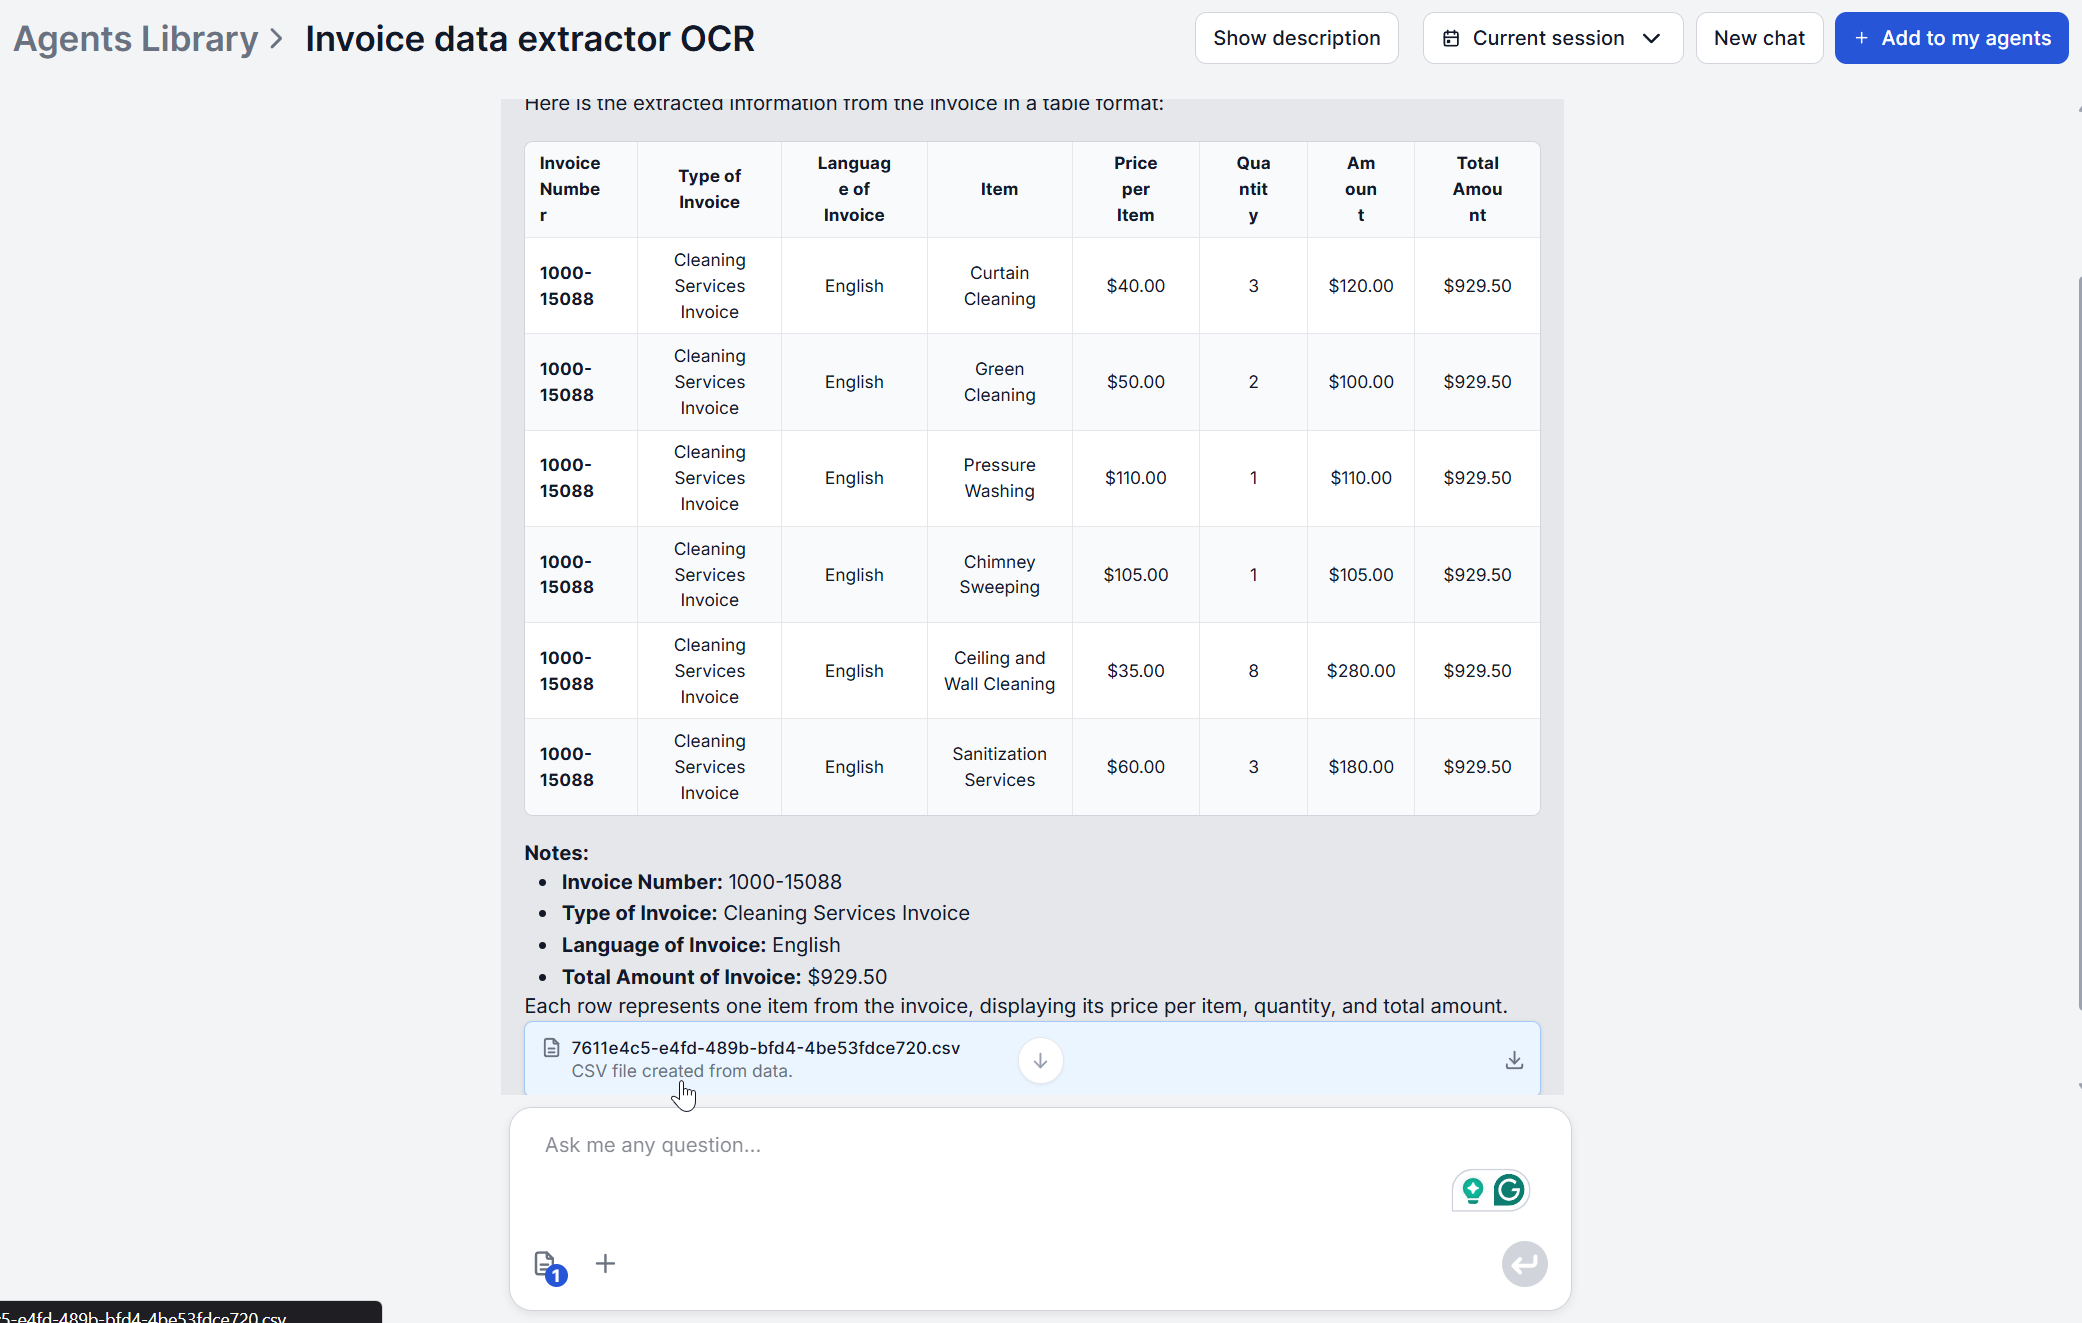
- Se gjennom markdown-tabellen. Resultatene kommer tilbake i chatten med én rad per fakturalinje, så du kan kontrollere dem med et blikk.
- Få den strukturerte eksporten. Samtidig genererer arbeidsflyten en detaljert CSV, klar til å lastes ned og legges inn i regnskapssystemet ditt.
Brukstilfelle: Automatisering av leverandørgjeld for økonomiteam
Team for leverandørgjeld er den klareste match. Et økonomiteam som behandler noen hundre leverandørfakturaer i måneden, bruker en betydelig del av en heltidsstilling bare på dataregistrering: åpne hver PDF eller skann, sjekke totalen mot innkjøpsordren og taste tallene inn i hovedboken.
Å sende fakturaer gjennom automatisk registrering av fakturadata gjør i stedet dette til last opp og se gjennom. Uttrekksverktøyet tar seg av lesingen og struktureringen, og teamets tid flyttes til avstemming og avvik i stedet for transkribering.
Fordi CSV-utdataene inkluderer MVA-nummer og firmanavn sammen med beløpet, er de bygget for å gli inn i eksisterende AP-arbeidsflyter i stedet for å kreve et nytt system. Der regnskapsplattformen er Xero, lar FlowHunts Xero-integrasjon via MCP uttrukne data flyttes direkte inn i regnskapsarbeidsflyten i stedet for en manuell CSV-import.
Det andre som endrer seg spesielt for AP-team, er hvordan en månedsavslutning ser ut. Når hver faktura allerede er lest, strukturert og eksportert på samme måte, blir det å matche fakturaer mot innkjøpsordrer og flagge avvik en gjennomgangsoppgave i stedet for en datainnsamlingsoppgave.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Brukstilfelle: Utgiftsstyring for SMB-er
Mindre team støter på det samme problemet i en annen skala. I stedet for en jevn strøm av leverandørfakturaer, er det ansatte som sender inn utgiftskvitteringer. Bilder tatt med telefon, på hvilket språk og i hvilken valuta leverandøren tilfeldigvis brukte. Et verktøy for fakturaautomatisering som fungerer fra et bilde i stedet for en ren skann, betyr noe her, siden utgiftskvitteringer sjelden er plettfrie dokumenter.
Gründeren eller kontorlederen som i dag avstemmer en skoeske full av kvitteringer ved månedens slutt, får i stedet en tabell med strukturerte linjeelementer. Ingen ny tasting nødvendig, og ingenting avhenger av å huske hva en falmet kvittering sa tre uker senere.
Og når spørsmålet ikke er «hva står det på denne kvitteringen», men «stemmer denne utgiftsrapporten med reisepolicyen vår», er det et godt øyeblikk å kombinere uttrekk med et verktøy for dokument-Q&A som Chat with PDF for å sjekke selve policydokumentet. Kjør kvitteringen gjennom uttrekk for å få tallene, og spør deretter policydokumentet direkte om en gitt utgiftskategori er refunderbar — to smale verktøy som gjør det hver av dem er bygget for, i stedet for ett verktøy som prøver å gjøre begge deler.
Nøyaktighet og validering: Hva du bør sjekke før postering
Ingen OCR-basert system er 100 % nøyaktig, og det er verdt å vite hvor risikoen faktisk ligger. Systemer med kun OCR lander typisk på 85–95 % nøyaktighet , mens kombinasjonen av OCR og AI-/LLM-resonnering presser nøyaktigheten opp i høye 90-tall, med enkelte referansemålinger som viser nær 99 % på maskinlesbare dokumenter.
Før du posterer uttrukne data i regnskapssystemet, er det verdt å sjekke noen ting. Kontroller totaler mot summen av linjeelementene (en god fornuftssjekk for enhver uttrekkskjøring), MVA-numre og fakturanumre hos internasjonale eller ukjente leverandører, og alt håndskrevet, siden kursiv og uregelmessige skrifttyper fortsatt er det vanskeligste tilfellet for enhver OCR-pipeline. Behandle resultatet som en første gjennomgang som er riktig i overveldende flertall av tilfellene.
En praktisk valideringsvane er å stikkprøvesjekke et utvalg i stedet for hver faktura. Ta noen få fra hver nye leverandør første gang du begynner å behandle fakturaene deres, bekreft at feltene stemmer, og øk tilliten derfra. Når en leverandørs fakturaformat er trukket ut riktig noen ganger på rad, har selve formatet ikke endret seg, så risikoen for en ny feil hos samme leverandør faller kraftig. Nye leverandører, uvanlig formaterte fakturaer og store engangsbeløp er der et nytt blikk er verdt de ekstra tretti sekundene.
Klar til å slutte å taste fakturadata manuelt? Prøv Invoice Data Extractor og se din første faktura bli gjort om til strukturerte data på under et minutt.
