


Ruční zpracování faktur zabírá reálný čas. Oborové benchmarky uvádějí celkové zpracování na 10 až 15 minut na fakturu , když započítáte zadávání dat, ověřování a směrování, a ruční přepisování má míru chybovosti při zadávání dat přibližně 1,6 % až 4 % v závislosti na zkušenosti a únavě operátora. Tyto chyby se s rostoucím objemem faktur násobí.
AI extrakce dat z faktur přečte jakýkoli formát faktury a během několika sekund vytvoří strukturovaná data. Zde je přesný postup a co si ověřit, než se data dostanou do vašeho účetního systému.
Skryté náklady ručního zpracování faktur
Každá faktura, která dorazí do sdílené schránky, spustí stejnou sekvenci. Někdo ji otevře, přečte pole, přepíše je do tabulky nebo ERP a založí originál. Vynásobte to stovkami nebo tisíci faktur za měsíc a náklady rychle narostou. Ruční zpracování faktur stojí 12-16 $ na fakturu včetně všech nákladů , když započítáte práci, opravu chyb a penále za pozdní platby, oproti 2-5 $ u automatizovaného zpracování.
Větší problém je, že míra chybovosti s rostoucím objemem nezůstává stejná. Jedna chybně napsaná celková částka nebo přehozené číslo faktury je při deseti fakturách měsíčně drobná nepříjemnost. U tisíce faktur se stejná chybovost 1,6-4 % promění v desítky faktur s nesprávnými daty ve vašem účetnictví, z nichž každá je potenciálním nesouladem při rekonciliaci nebo upozorněním při auditu.
Existuje také problém škálování, který nemá nic společného s přesností. Čas ručního zpracování je zhruba lineární. Dvojnásobný objem faktur znamená zhruba dvojnásobek pracovních hodin, ať už to znamená přesčasy pro stávající tým, nebo nového zaměstnance. Žádný z toho času se netráví úsudkem, ale čtením čísel ze stránky a jejich přepisováním jinam. Přesně tento problém řeší nástroj pro AI zpracování faktur.
Jak funguje AI extrakce dat z faktur
Nástroj pro faktura OCR AI kombinuje dvě vrstvy. Optické rozpoznávání znaků čte text na stránce a jazykový model interpretuje, co tento text znamená — rozpozná, že číslo poblíž slova “Total” je celková částka faktury, bez ohledu na to, kde na stránce leží nebo v jakém jazyce je faktura napsána.
To se liší od obecného nástroje pro Q&A nad dokumenty. Pokud potřebujete klást otevřené otázky ke smlouvě nebo dlouhé PDF zprávě, nástroj jako Chat with PDF je stavěný pro tento typ konverzačního vyhledávání. Extrakce faktur je užší a svou podstatou strukturovanější. Vždy hledá stejná pole a vždy je vrací ve stejném formátu, což je to, co činí výstup použitelným bez ručního čištění.
Tato struktura je také důvodem, proč je nástroj bez šablon. Tradiční OCR software, který není spojen s jazykovým modelem, obvykle potřebuje šablonu pro každé rozvržení dodavatele. Nástroj pro AI zpracování faktur hledá položky konceptuálně (“celková částka”, “číslo faktury”), nikoli podle toho, kde na stránce je hledat, takže faktura od nového dodavatele funguje už při prvním nahrání.

Připraveni rozšířit své podnikání?
Začněte svou bezplatnou zkušební verzi ještě dnes a viďte výsledky během několika dní.
Krok za krokem: Zpracujte svou první dávku faktur
FlowHunt Invoice Data Extractor funguje jako jednoduchý chatovací tok. Zde je, co se děje od začátku do konce:
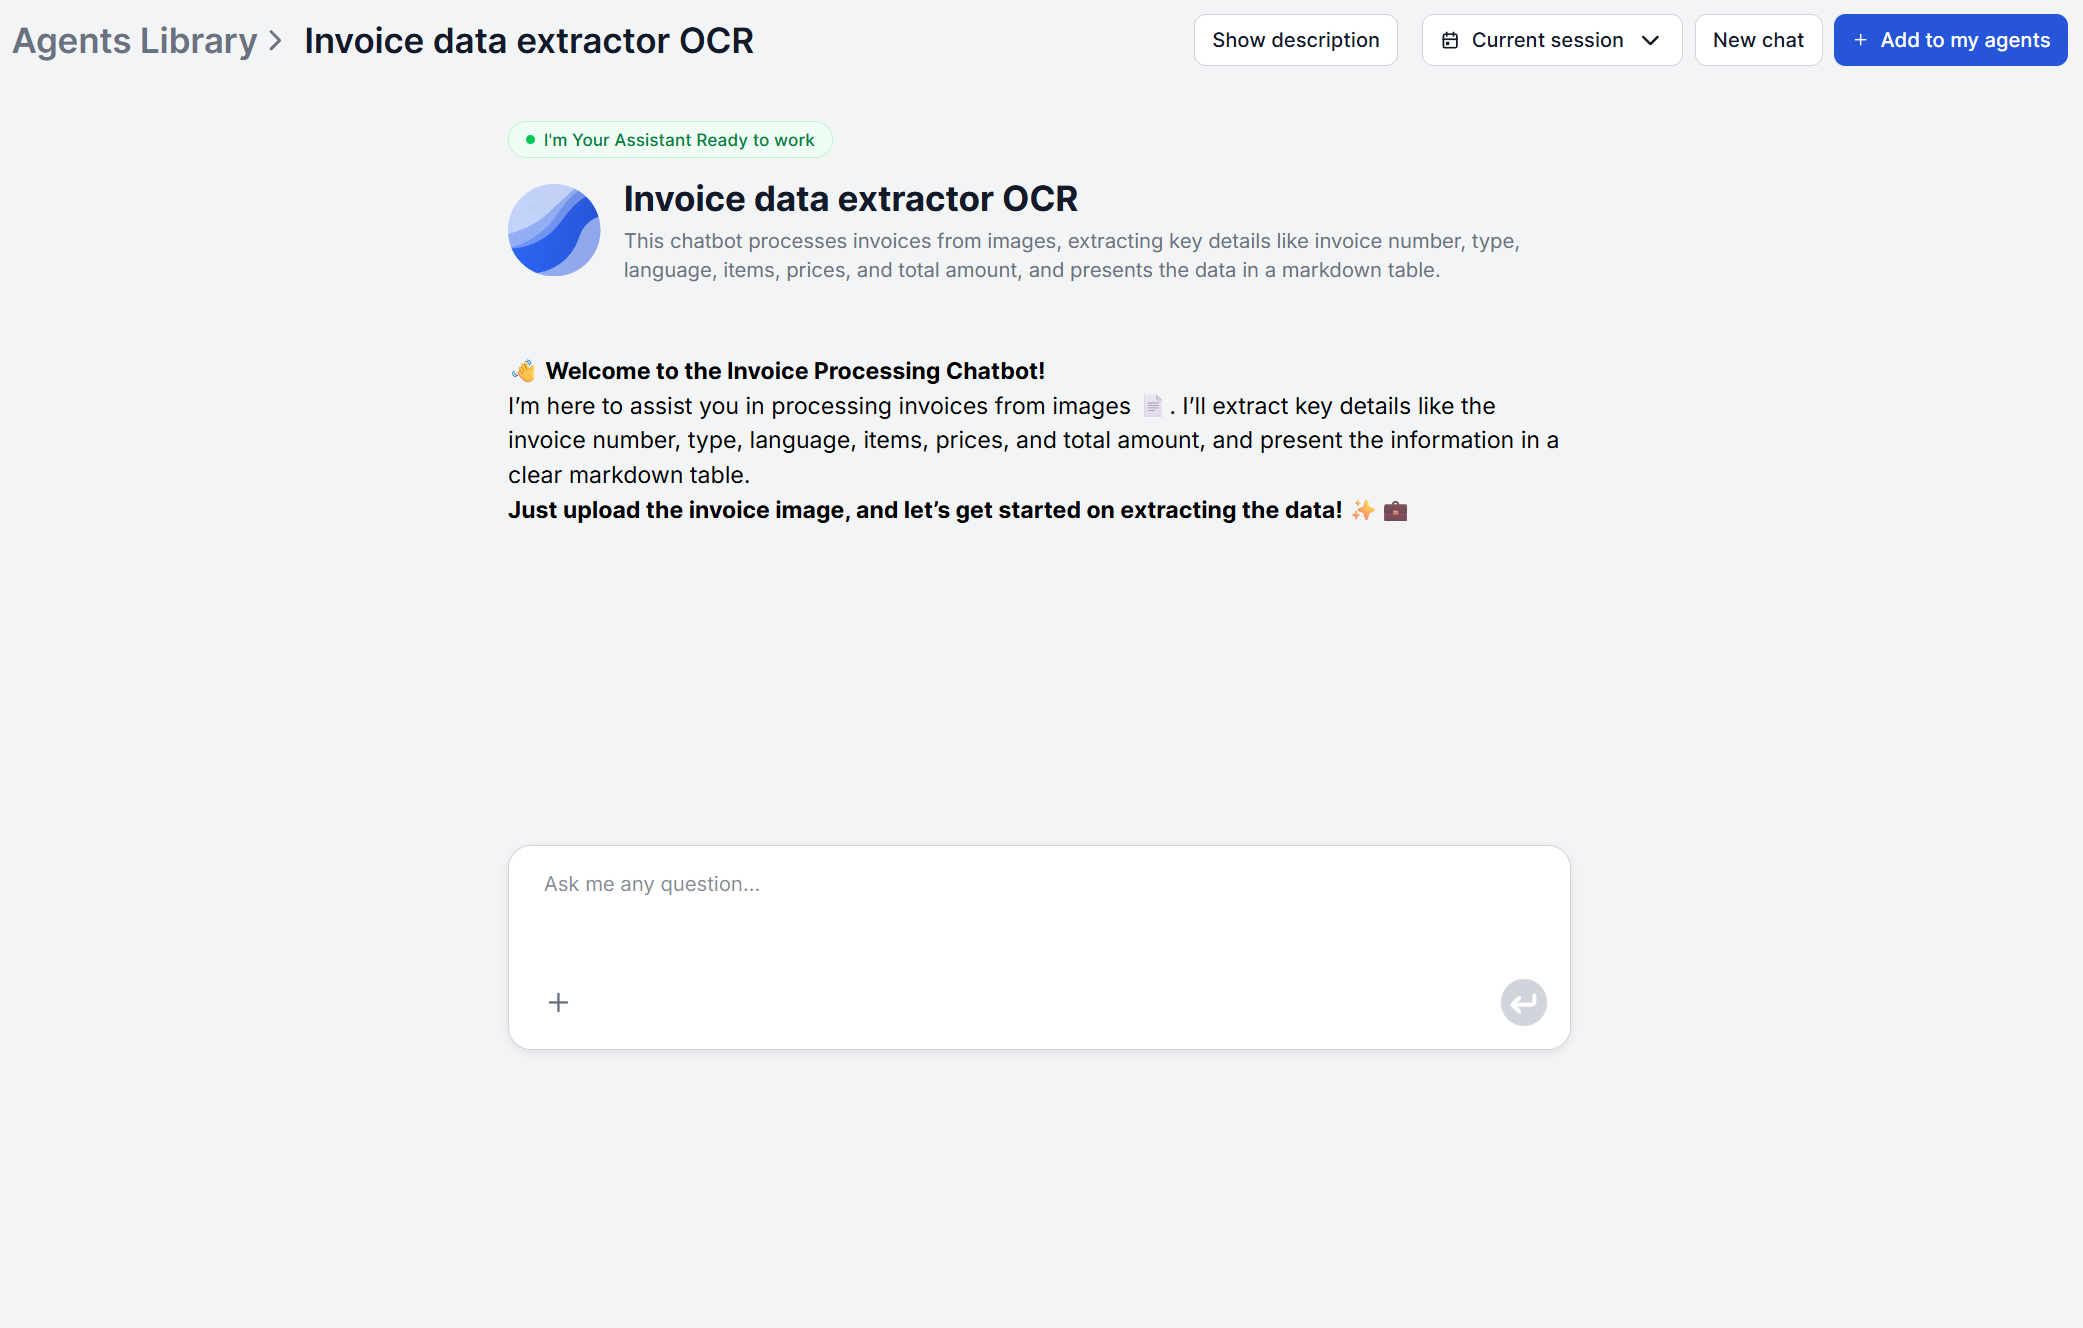
- Otevřete chatbota. Uvítací zpráva vysvětlí, co nahrát. Nemusíte nic konfigurovat.
- Nahrajte obrázek faktury. Naskenované dokumenty, fotografie i digitální snímky obrazovky fungují.
- AI data přečte a extrahuje. Strukturovaný prompt vede model k provedení OCR a vytažení všech polí.
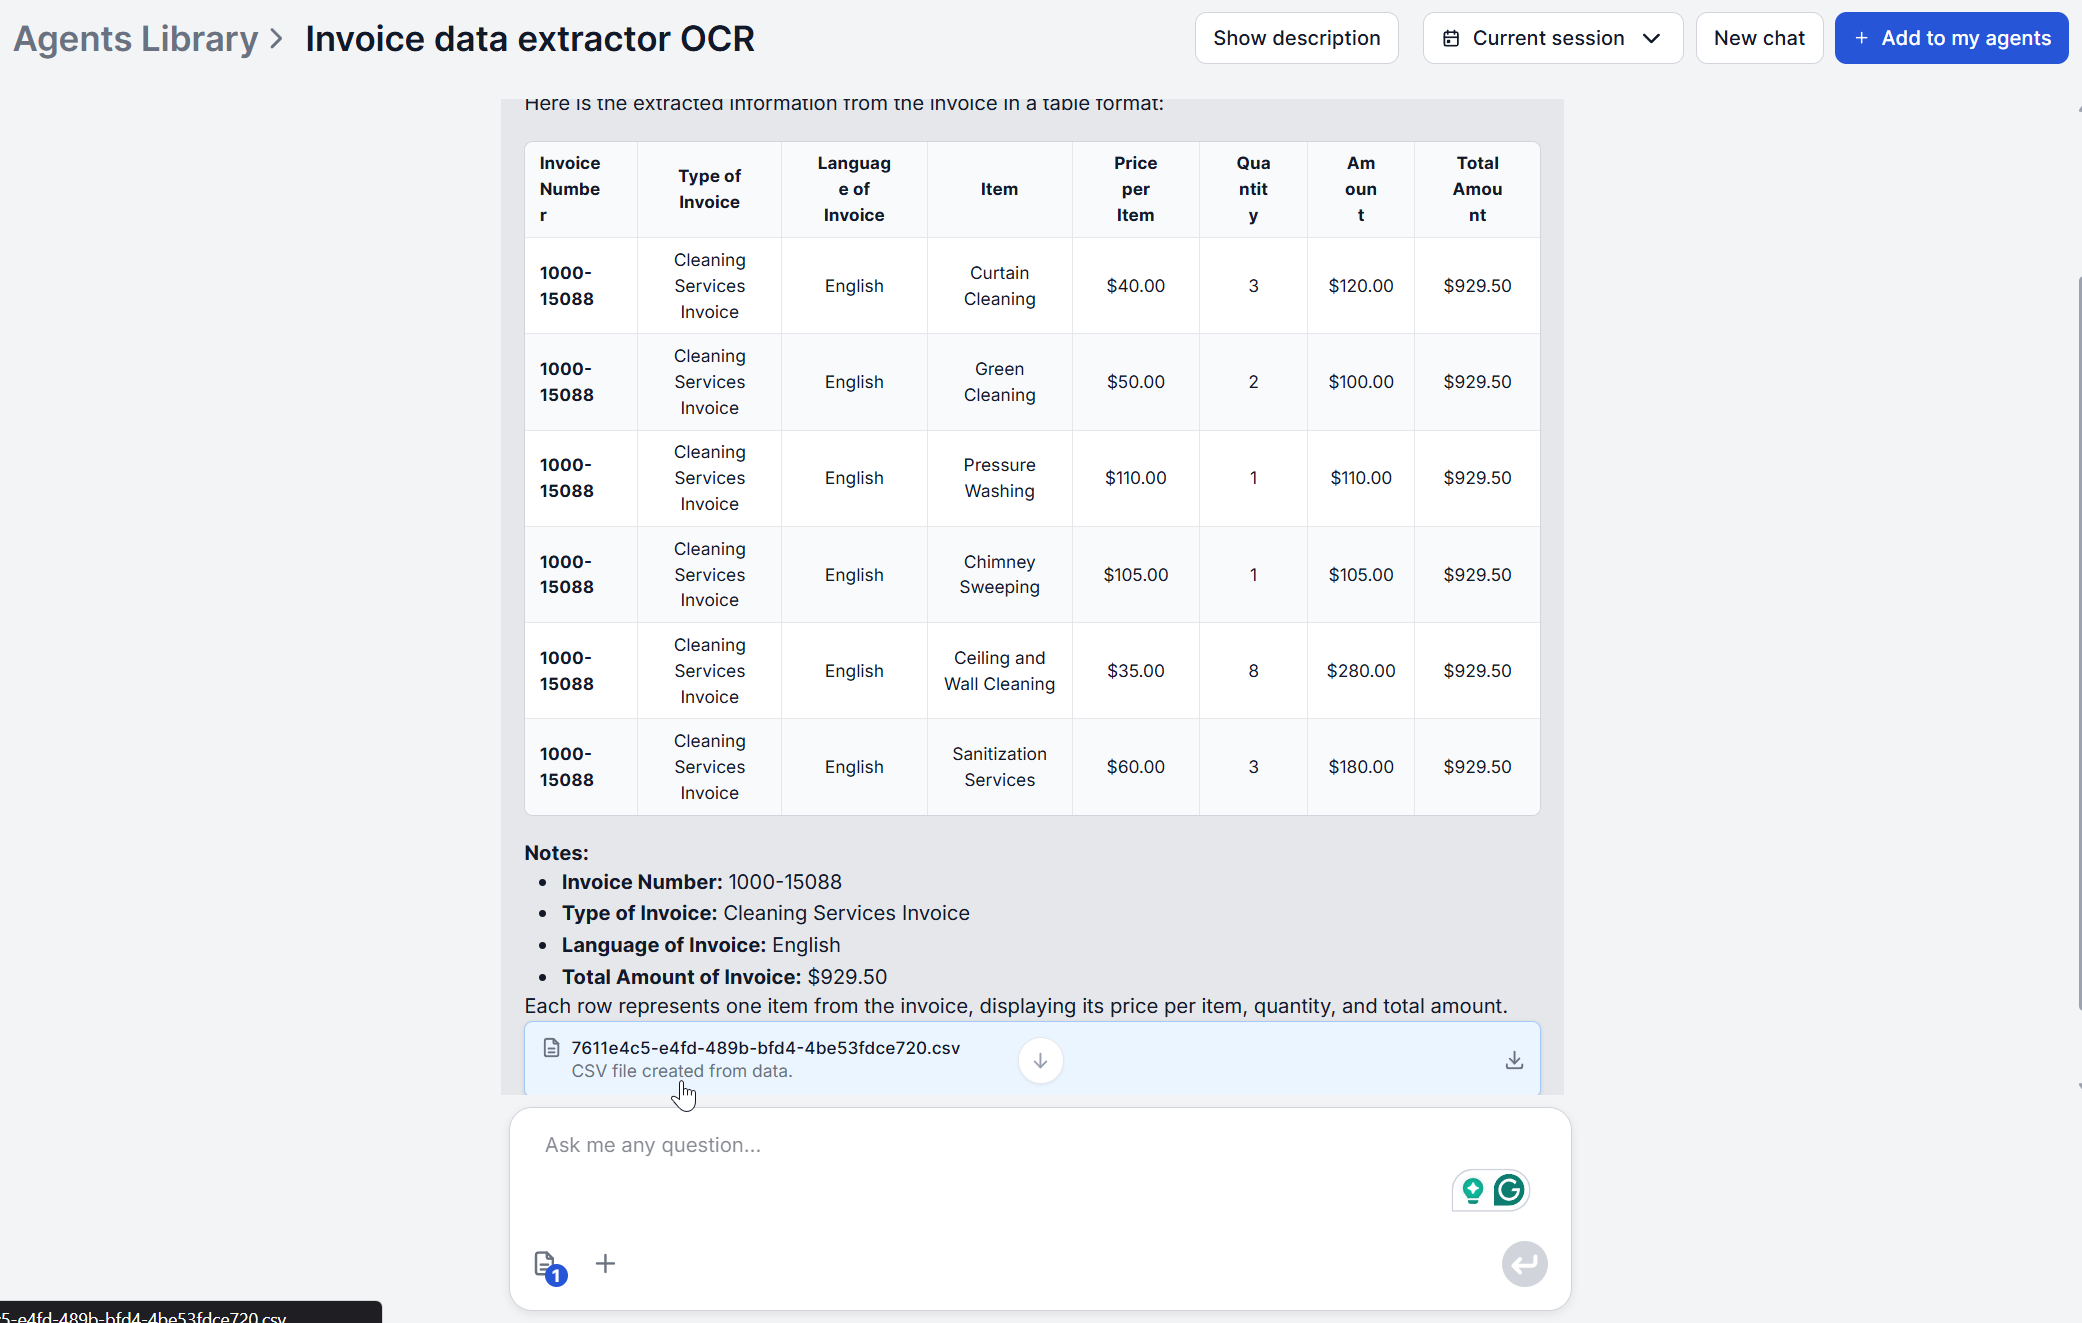
- Zkontrolujte markdown tabulku. Výsledky se vrátí v chatu s jedním řádkem na každou položku faktury, takže je můžete zkontrolovat na první pohled.
- Získáte strukturovaný export. Paralelně workflow generuje podrobný CSV, připravený ke stažení a vložení do vašeho účetního systému.
Případ užití: Automatizace AP pro finanční týmy
Týmy závazků (accounts payable) jsou nejzřetelnější cílovou skupinou. Finanční tým zpracovávající několik stovek dodavatelských faktur měsíčně tráví značnou část jedné pozice jen zadáváním dat. otevíráním každého PDF nebo skenu, kontrolou celkové částky proti objednávce a přepisováním čísel do účetní knihy.
Naproti tomu protlačení faktur přes automatické zadávání dat z faktur z toho dělá nahrání a kontrolu. Extraktor zajišťuje čtení a strukturování a čas týmu se přesouvá k rekonciliaci a výjimkám místo k přepisování.
Protože výstup CSV obsahuje DIČ a název společnosti vedle částky, je stavěný tak, aby zapadl do stávajících AP workflow, aniž by vyžadoval nový systém. Tam, kde je účetní platformou Xero, umožňuje integrace s Xero od FlowHunt přes MCP přesunout extrahovaná data přímo do účetního workflow místo ručního importu CSV.
Další věc, která se u AP týmů mění, je podoba uzávěrky na konci měsíce. Když je každá faktura už přečtená, strukturovaná a exportovaná stejným způsobem, párování faktur s objednávkami a označování nesrovnalostí se stává kontrolní úlohou místo úlohy sběru dat.
Přihlaste se k odběru newsletteru
Získejte nejnovější tipy, trendy a nabídky zdarma.
Případ užití: Správa výdajů pro malé a střední firmy
Menší týmy narážejí na stejný problém v jiném měřítku. Místo stálého proudu dodavatelských faktur jde o zaměstnance odevzdávající účtenky za výdaje. Fotografie pořízené mobilem, v jakémkoli jazyce a měně, kterou dodavatel zrovna použil. Nástroj pro automatizaci faktur, který funguje z fotografie místo z čistého skenu, je zde důležitý, protože účtenky za výdaje jsou jen zřídka dokonalé dokumenty.
Zakladatel nebo office manažer, který dnes na konci měsíce rekonciliuje krabici od bot plnou účtenek, místo toho dostane tabulku strukturovaných položek. Bez přepisování a bez toho, aby cokoli záviselo na vzpomínce, co stálo na vybledlé účtence před třemi týdny.
A když otázka nezní “co je na této účtence”, ale “odpovídá tento výkaz výdajů našim pravidlům pro cestování”, je to dobrý moment spojit extrakci s nástrojem pro Q&A nad dokumenty, jako je Chat with PDF , a zkontrolovat samotný dokument s pravidly. Prožeňte účtenku extrakcí kvůli číslům a pak se přímo zeptejte dokumentu s pravidly, zda je daná kategorie výdaje proplatitelná — dva úzké nástroje dělající to, pro co byly stavěny, místo jednoho nástroje, který se snaží dělat obojí.
Přesnost a validace: Co zkontrolovat před zaúčtováním
Žádný systém založený na OCR není stoprocentně přesný a vyplatí se vědět, kde riziko skutečně leží. Systémy pouze s OCR obvykle dosahují přesnosti 85-95 % , zatímco kombinace OCR s uvažováním AI/LLM posouvá přesnost do vysokých devadesátých procent, přičemž některé benchmarky uvádějí téměř 99 % u strojově čitelných dokumentů.
Než zaúčtujete extrahovaná data do svého účetního systému, vyplatí se zkontrolovat několik věcí. Zkontrolujte celkové částky proti součtu položek (dobrá rozumová kontrola u každého běhu extrakce), DIČ a čísla faktur u mezinárodních nebo neznámých dodavatelů a cokoli ručně psaného, protože psací a nepravidelné fonty zůstávají nejtěžším případem pro jakýkoli OCR proces. Berte výstup jako první průchod, který je správný v naprosté většině případů.
Praktickým validačním návykem je namátkově kontrolovat vzorek místo každé faktury. Když začnete zpracovávat faktury od nového dodavatele, vezměte několik z nich, ověřte, že pole sedí, a odtud zvyšujte důvěru. Jakmile je formát faktury daného dodavatele několikrát za sebou extrahován správně, samotný formát se nezměnil, takže riziko nové chyby u stejného dodavatele prudce klesá. Noví dodavatelé, neobvykle formátované faktury a velké jednorázové částky jsou místa, kde se druhý pohled vyplatí za těch třicet sekund navíc.
Chcete přestat psát data z faktur ručně? Vyzkoušejte Invoice Data Extractor a sledujte, jak se vaše první faktura promění ve strukturovaná data za méně než minutu.
