


Manuel fakturabehandling spiser rigtig meget tid. Branchebenchmarks anslår den fulde behandling til 10 til 15 minutter pr. faktura , når man regner dataindtastning, verifikation og videresendelse med, og manuel indtastning har en fejlrate ved dataindtastning på cirka 1,6 % til 4 % afhængigt af operatørens rutine og træthed. Disse fejl vokser, efterhånden som fakturamængden stiger.
En AI-baseret udtrækning af fakturadata læser ethvert fakturaformat og leverer strukturerede data på få sekunder. Her er den præcise proces, og hvad du bør kontrollere, før den rører dit regnskabssystem.
Den skjulte omkostning ved manuel fakturabehandling
Hver faktura, der lander i en fælles indbakke, udløser den samme sekvens. Nogen åbner den, læser felterne, taster dem ind i et regneark eller ERP-system og arkiverer originalen. Gang det med hundreder eller tusinder af fakturaer om måneden, og omkostningen løber hurtigt op. Manuel fakturabehandling koster 12-16 USD pr. faktura med alle omkostninger inkluderet , når man medregner arbejdskraft, fejlretning og gebyrer for sen betaling, mod 2-5 USD for automatiseret behandling.
Det større problem er, at fejlraten ikke forbliver konstant, når mængden vokser. Et enkelt forkert indtastet totalbeløb eller et ombyttet fakturanummer er en mindre gene ved ti fakturaer om måneden. Ved tusind bliver den samme fejlrate på 1,6-4 % til snesevis af fakturaer med forkerte data i dit regnskab, og hver af dem er en potentiel uoverensstemmelse under afstemningen eller et flag i en revision senere hen.
Der er også et skaleringsproblem, som intet har med præcision at gøre. Manuel behandlingstid er cirka lineær. Dobbelt så mange fakturaer betyder cirka dobbelt så mange medarbejdertimer, uanset om det betyder overarbejde for et eksisterende team eller en ny ansættelse. Ingen af den tid bruges på vurderinger, men på at læse tal fra en side og taste dem ind et andet sted. Det er præcis det, et AI-værktøj til fakturabehandling løser.
Sådan fungerer AI-baseret udtrækning af fakturadata
Et faktura OCR AI -værktøj kombinerer to lag. Optisk tegngenkendelse læser teksten på siden, og en sprogmodel fortolker, hvad teksten betyder, og genkender, at et tal nær ordet “Total” er fakturaens totalbeløb, uanset hvor på siden det står, eller hvilket sprog fakturaen er på.
Det er anderledes end et generelt værktøj til dokument-Q&A. Hvis du har brug for at stille åbne spørgsmål til en kontrakt eller en lang PDF-rapport, er et værktøj som Chat with PDF bygget til den slags samtalebaserede søgning. Fakturaudtrækning er snævrere og mere struktureret af design. Det leder altid efter de samme felter og returnerer dem altid i samme format, og det er det, der gør outputtet brugbart uden manuel oprydning.
Den struktur er også det, der gør værktøjet skabelonfrit. Traditionel OCR-software, der ikke er parret med en sprogmodel, har typisk brug for en skabelon pr. leverandørlayout. Et AI-værktøj til fakturabehandling leder efter elementer begrebsmæssigt (“totalbeløbet”, “fakturanummeret”), ikke efter hvor på siden det skal kigge, så en ny leverandørs faktura fungerer ved første upload.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Trin for trin: Behandl dit første fakturaparti
FlowHunts Invoice Data Extractor kører som et simpelt chatflow. Her er, hvad der sker fra start til slut:
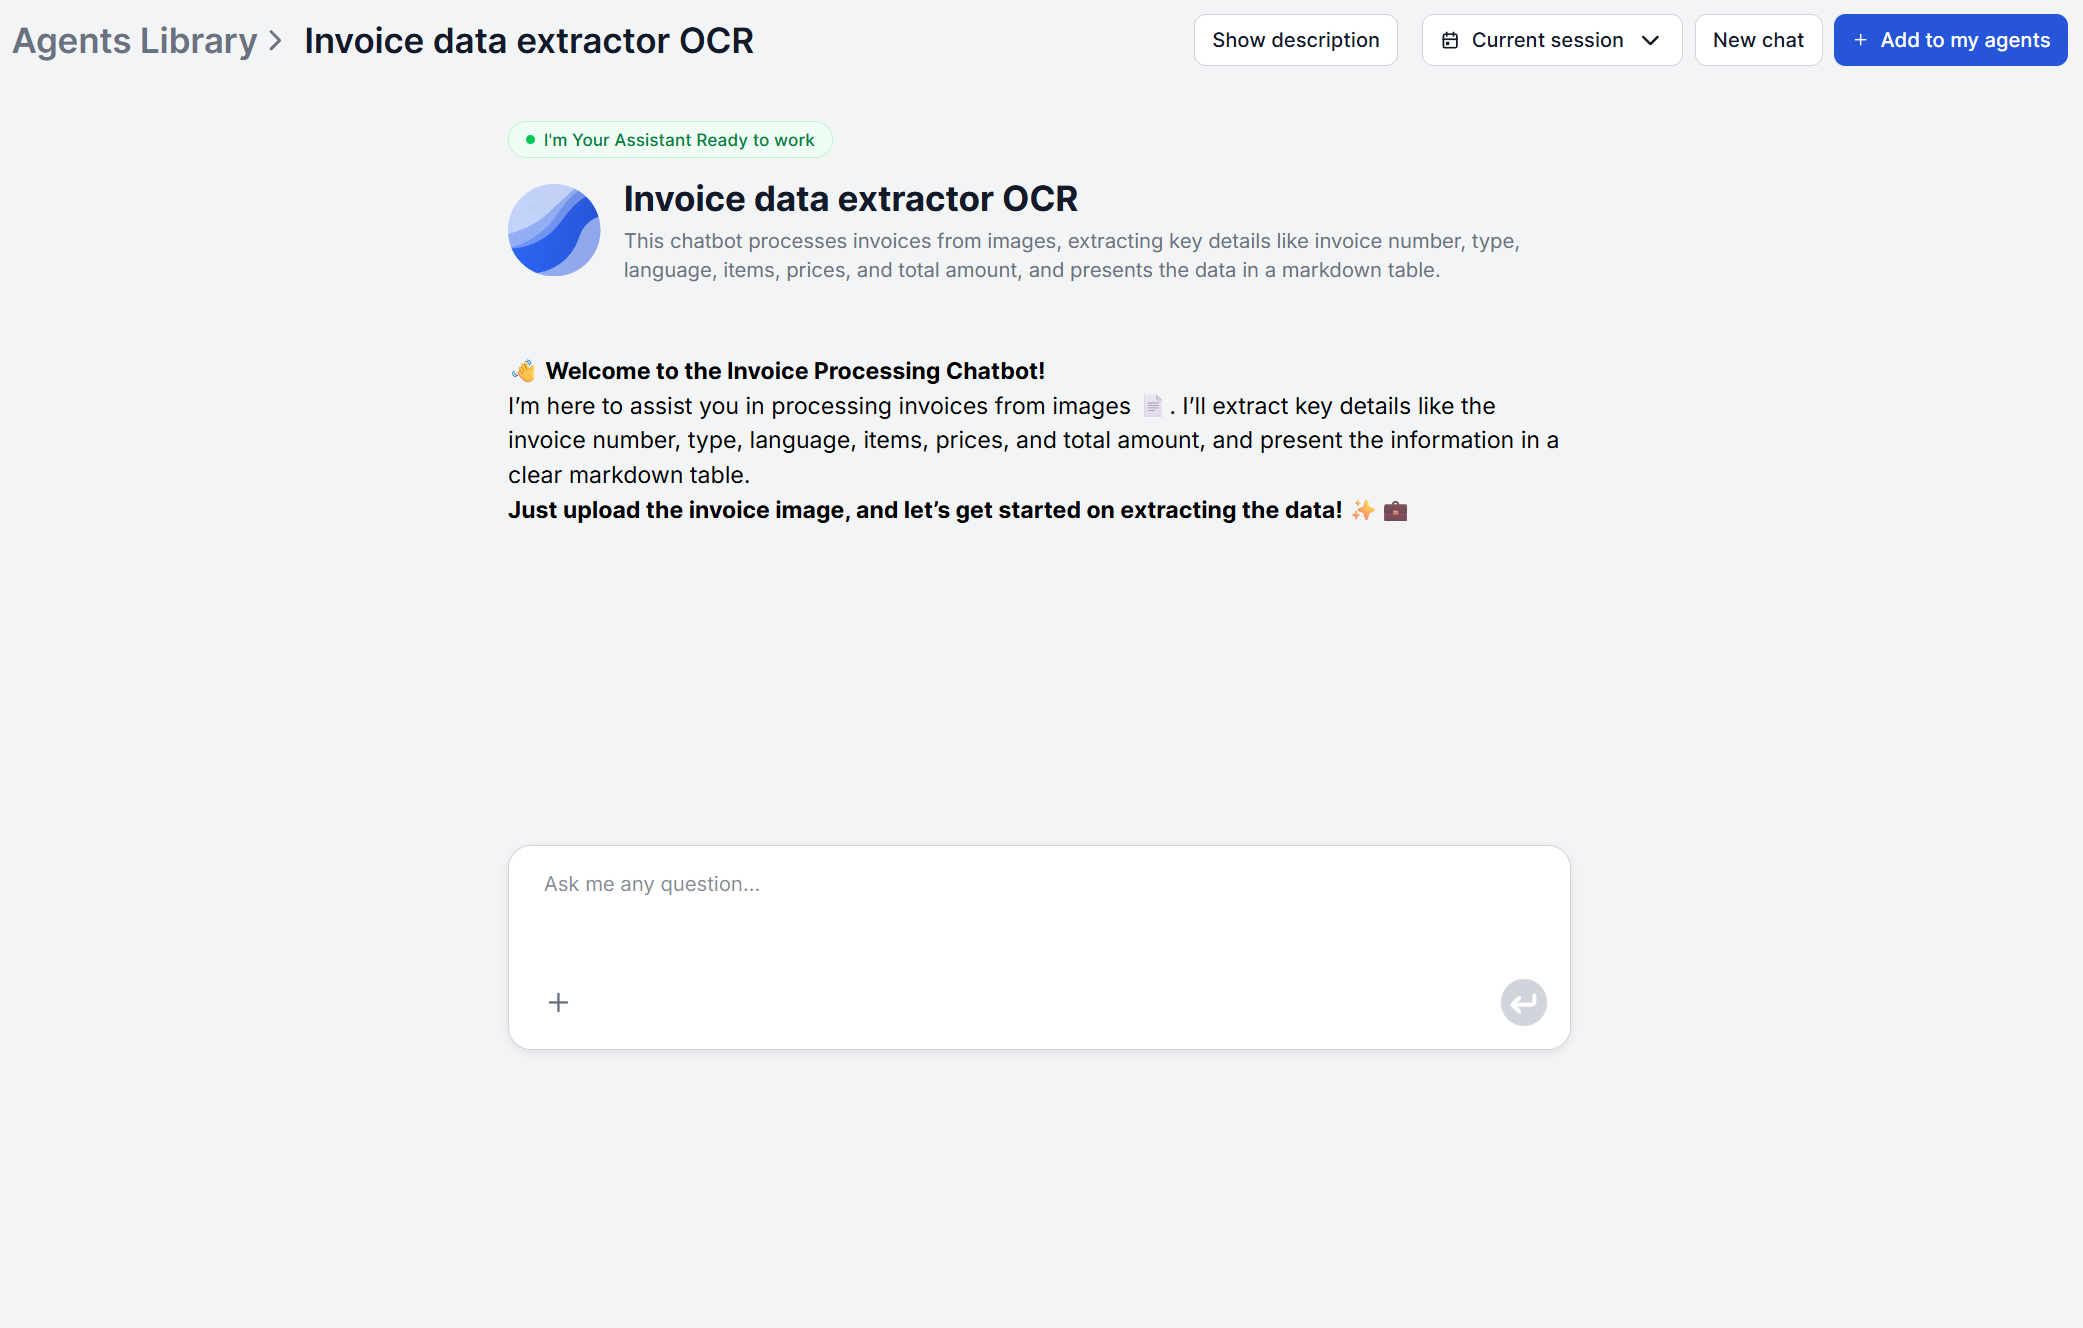
- Åbn chatbotten. En velkomstbesked forklarer, hvad du skal uploade. Du behøver ikke konfigurere noget.
- Upload fakturambilledet. Scannede dokumenter, fotos eller digitale skærmbilleder fungerer alle sammen.
- AI’en læser og udtrækker dataene. En struktureret prompt får modellen til at udføre OCR og trække alle felterne ud.
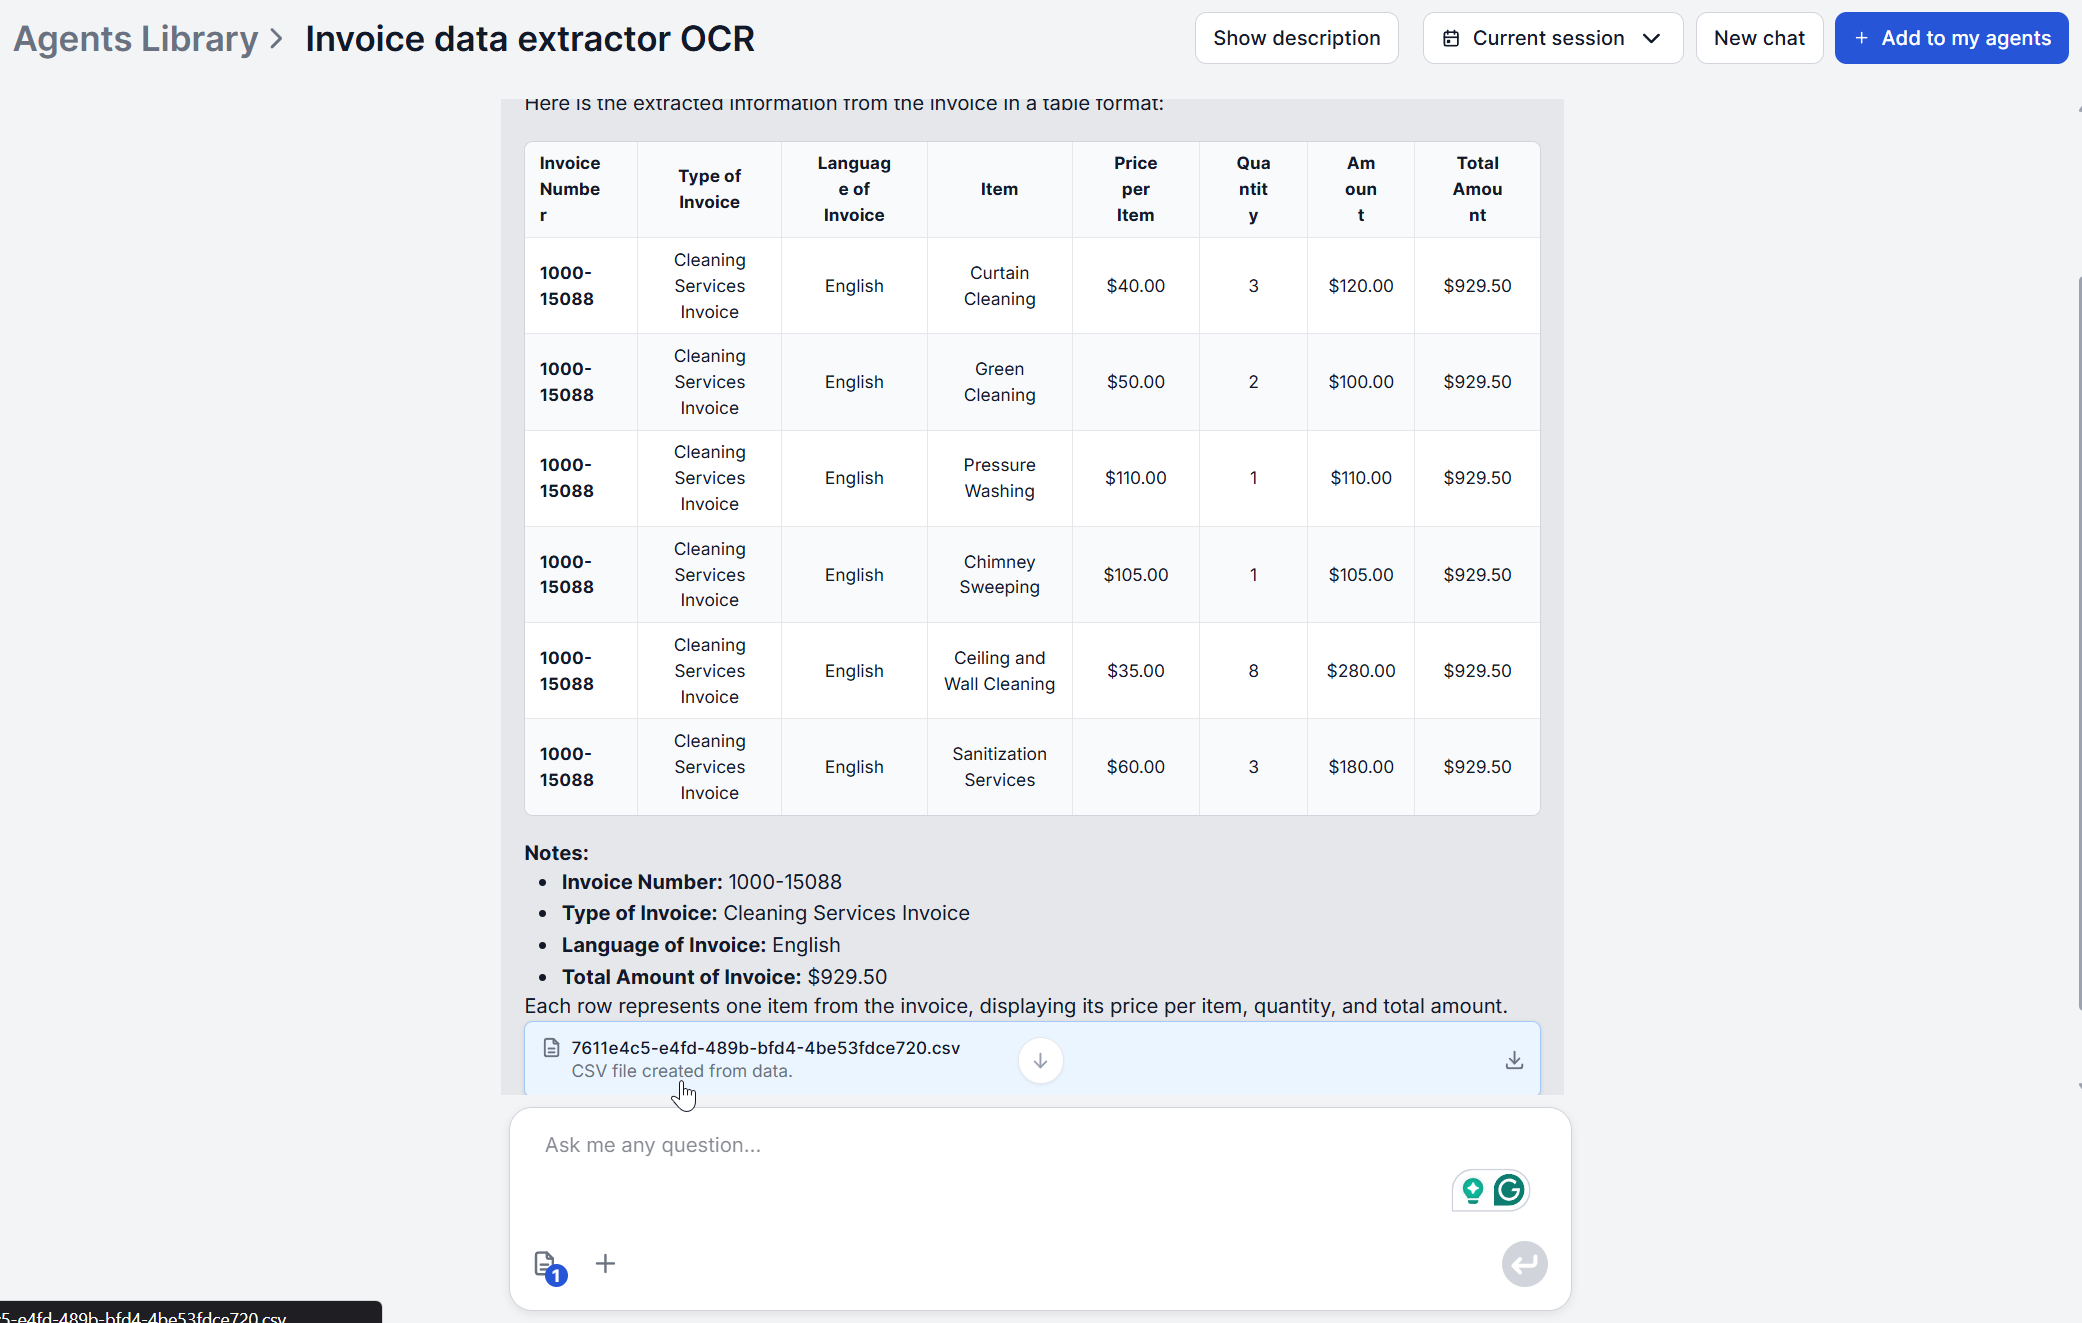
- Gennemgå markdown-tabellen. Resultaterne kommer tilbage i chatten med én række pr. fakturalinje, så du kan kontrollere dem med et blik.
- Hent det strukturerede eksportoutput. Samtidig genererer workflowet en detaljeret CSV, klar til at downloade og lægge ind i dit regnskabssystem.
Anvendelsescase: AP-automatisering for finansenheder
Teamet for leverandørgæld (accounts payable) er den tydeligste matchning. Et finansenhed, der behandler et par hundrede leverandørfakturaer om måneden, bruger en betydelig del af en fuldtidsstilling bare på dataindtastning. Åbne hver PDF eller scanning, kontrollere totalbeløbet op mod indkøbsordren og taste tallene ind i hovedbogen.
At føre fakturaer gennem automatisk indtastning af fakturadata gør det i stedet til upload-og-gennemgå. Extractoren klarer læsningen og struktureringen, og teamets tid flytter sig til afstemning og undtagelser i stedet for afskrivning.
Fordi CSV-outputtet inkluderer VAT-nummer (momsnummer) og firmanavn sammen med beløbet, er det bygget til at passe ind i eksisterende AP-workflows i stedet for at kræve et nyt system. Hvor regnskabsplatformen er Xero, lader FlowHunts Xero-integration via MCP udtrukne data flytte direkte ind i regnskabsflowet i stedet for en manuel CSV-import.
Det andet, der ændrer sig specifikt for AP-teams, er, hvordan en månedsafslutning ser ud. Når hver faktura allerede er læst, struktureret og eksporteret på samme måde, bliver afstemning af fakturaer mod indkøbsordrer og markering af afvigelser en gennemgangsopgave i stedet for en dataindsamlingsopgave.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Anvendelsescase: Udgiftsstyring for SMV’er
Mindre teams støder ind i det samme problem i en anden skala. I stedet for en jævn strøm af leverandørfakturaer er det medarbejdere, der indsender udgiftsbilag. Fotos taget med en telefon, på det sprog og i den valuta leverandøren nu engang brugte. Et værktøj til fakturaautomatisering, der arbejder ud fra et foto i stedet for en ren scanning, betyder noget her, da udgiftsbilag sjældent er fejlfri dokumenter.
Grundlæggeren eller kontorchefen, som i dag afstemmer en skotøjsæske fuld af bilag ved månedens udgang, får i stedet en tabel med strukturerede linjeelementer. Ingen genindtastning nødvendig, og intet afhænger af at huske, hvad et falmet bilag sagde for tre uger siden.
Og når spørgsmålet ikke er “hvad står der på dette bilag”, men “passer denne udgiftsrapport til vores rejsepolitik”, er det et godt tidspunkt at kombinere udtrækning med et værktøj til dokument-Q&A som Chat with PDF for at tjekke selve politikdokumentet. Kør bilaget gennem udtrækning for at få tallene, og spørg derefter politikdokumentet direkte, om en given udgiftskategori er refunderbar — to snævre værktøjer, der hver især gør det, de er bygget til, i stedet for ét værktøj, der forsøger at gøre begge dele.
Præcision og validering: Hvad du bør tjekke, før du bogfører
Intet OCR-baseret system er 100 % præcist, og det er værd at vide, hvor risikoen reelt ligger. Systemer, der kun bruger OCR, lander typisk på 85-95 % præcision , mens kombinationen af OCR og AI/LLM-ræsonnering løfter præcisionen op i slutningen af 90’erne, og nogle benchmarks nævner tæt på 99 % på maskinlæsbare dokumenter.
Før du bogfører udtrukne data i dit regnskabssystem, er det værd at tjekke et par ting. Kontrollér totaler mod summen af linjeelementerne (en god sanity check på enhver udtrækningskørsel), momsnumre og fakturanumre hos internationale eller ukendte leverandører, og alt håndskrevet, da kursiv og uregelmæssig skrift fortsat er det sværeste tilfælde for enhver OCR-pipeline. Betragt outputtet som et første gennemløb, der er korrekt i langt de fleste tilfælde.
En praktisk valideringsvane er at stikprøvekontrollere et udvalg i stedet for hver eneste faktura. Tag en håndfuld fra hver ny leverandør, når du begynder at behandle deres fakturaer, bekræft at felterne stemmer, og øg derfra tilliden gradvist. Når en leverandørs fakturaformat er udtrukket korrekt et par gange i træk, har formatet i sig selv ikke ændret sig, så risikoen for en ny fejl hos samme leverandør falder kraftigt. Nye leverandører, usædvanligt formaterede fakturaer og store engangsbeløb er der, hvor et ekstra blik er de ekstra tredive sekunder værd.
Klar til at stoppe med at taste fakturadata i hånden? Prøv Invoice Data Extractor og se din første faktura blive omdannet til strukturerede data på under et minut.
