


Denne FlowHunt AI-ejendomsscraper-tutorial vil guide dig gennem hvert trin fra indtastning af dit målmarked til arbejdet med det strukturerede output. For kontekst om hvornår og hvorfor du bør bruge værktøjet, anvendelsestilfælde, sammenligninger og workflow-idéer, se hvordan du scraper ejendomsopslag med AI .
Det skal du have på plads, før du starter
Før din første kørsel skal du have to ting klar:
- En FlowHunt-konto. Du kan prøve grundværktøjet gratis, før du forpligter dig her: AI-ejendomsscraper . Til omfattende brug eller tilpasninger af flowet skal du have en konto. En 7-dages gratis prøveperiode lader dig køre flere analyser samt andre workflows, før du forpligter dig fuldt ud.
- Et klart målmarked. Kend det område, du vil analysere, og hvilken type ejendom du er interesseret i. Inputtet er en beskrivelse i almindeligt sprog uden behov for teknisk konfiguration. Jo mere specifik du er, jo mere fokuseret bliver outputtet.
Hvis du vil analysere dit eget datasæt (et regneark med opslag, en dataeksport fra et andet værktøj), kan du have det klar til at uploade sammen med din markedsbeskrivelse.
Ingen API-nøgler, ingen dataconnectors, ingen udvikleropsætning, medmindre du vil opsætte brugerdefinerede integrationer. Værktøjet håndterer hele pipelinen automatisk, når du først har indsendt dit input.
Trin 1: Definér dine søgeparametre for ejendomme
Åbn Flow-biblioteket og søg efter AI-ejendomsscraperen. Føj den til dine agenter. Tænk igennem, hvad du vil have analysen til at dække, før du skriver noget. En klar afgrænsningsbeskrivelse giver en mere brugbar rapport end en vag en.
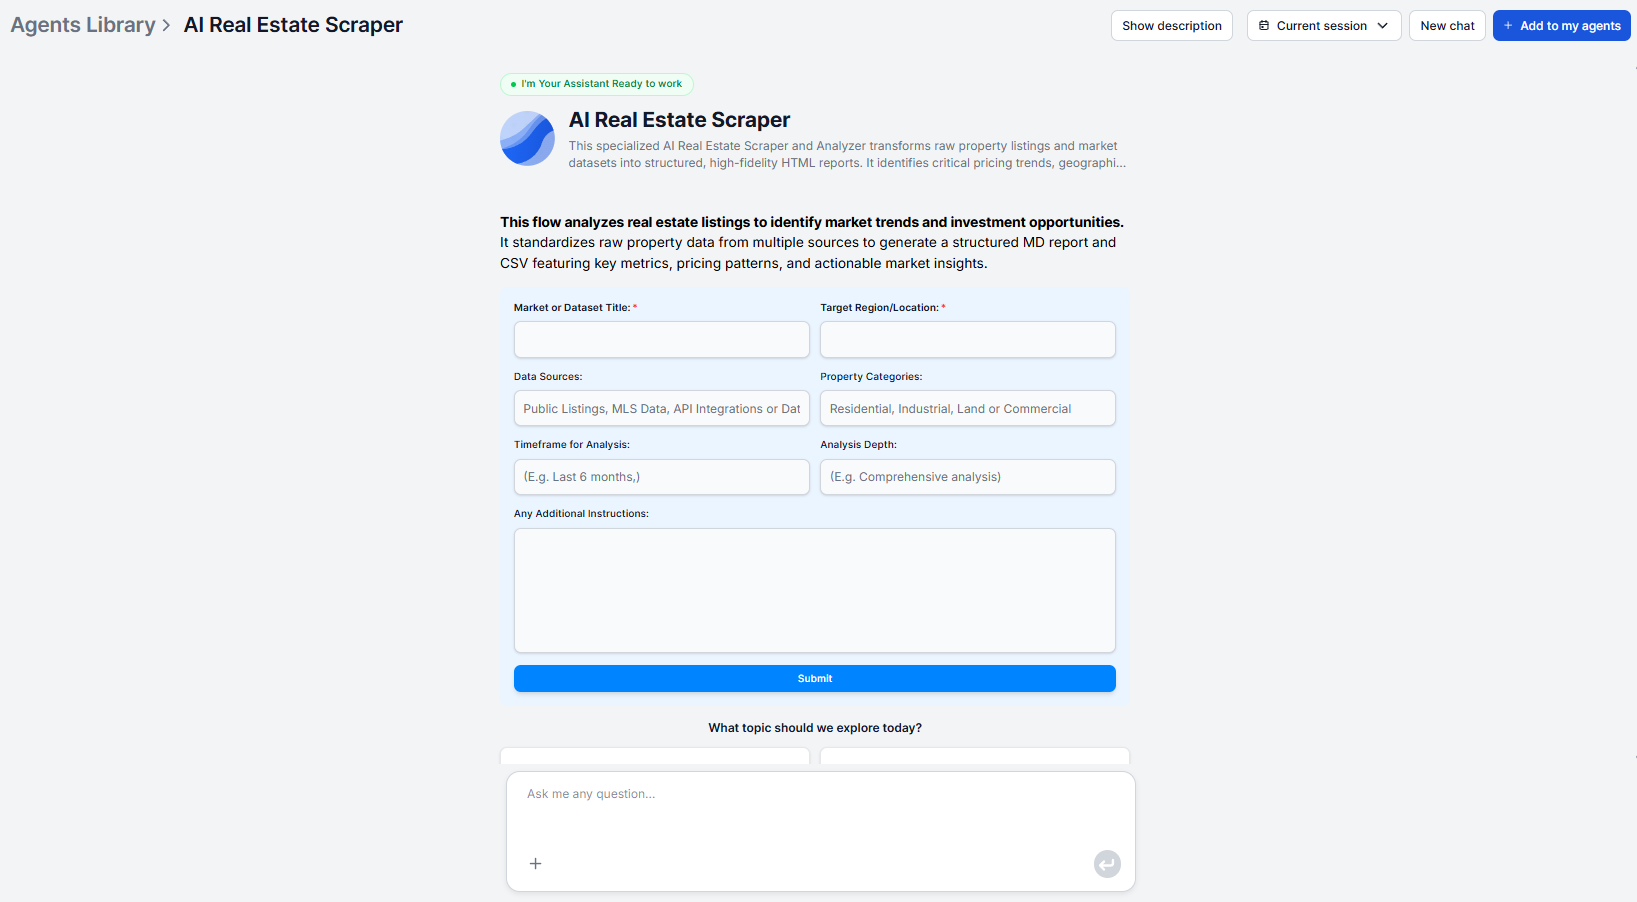
Det bør din målmarkedsbeskrivelse indeholde:
- Geografisk område — by, kvarter, distrikt eller region. Jo strammere området er, jo mere præcise bliver prisammenligningerne. Med andre ord giver “Central Lissabon” en mere fokuseret analyse end “Portugal.”
- Ejendomstype — boliglejligheder, enfamilieshuse, erhvervsenheder eller en blanding. Hvis ejendomstypen er vigtig for din analyse, så nævn den eksplicit.
- Prisinterval — hvis du analyserer et bestemt investeringsniveau, angiv intervallet. “Under 300.000 €” eller “mellem 500.000 $ og 1 mio. $” fokuserer datasættet på det segment, du vurderer.
- Alle andre relevante kriterier — antal værelser, nybyggeri vs. eksisterende byggeri, by vs. forstad. Medtag alt, der er relevant for dit researchmål.
Eksempler på input:
- “Boliglejligheder i Austin, TX”
- “3-værelses enfamilieshuse under 400.000 € i forstæderne til München”
- “Erhvervsenheder i det centrale Manchester mellem 200.000 £ og 500.000 £”
En simpel by og ejendomstype er altid nok til at komme i gang. Finjusteringer kommer efter din første kørsel, når du ser, hvad outputtet dækker.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Trin 2: Konfigurér scraperen til dit målområde
Værktøjet kører alene med den målmarkedsbeskrivelse, du definerede i trin 1. Der findes ingen separat konfigurationspanel. Inputtet i naturligt sprog er konfigurationen.
Hvis du vil justere, hvad analysen fokuserer på, eller hvordan outputtet er struktureret, har du to muligheder:
Medtag specifikke detaljer i din beskrivelse. Hvis din analyse skal fokusere på et bestemt prisbånd, en ejendomstype eller et delområde, så gør det eksplicit i inputtet i stedet for at regne med, at værktøjet udleder det.
Medbring dit eget datasæt. Hvis du har en eksisterende datafil, fx et regneark med opslag, du har indsamlet, en eksport fra et andet værktøj eller et proprietært datasæt, kan du uploade den sammen med din markedsbeskrivelse. Værktøjet indarbejder den sammen med data indsamlet fra onlinekilder og anvender samme proces.
Tilpas det underliggende flow. Til tilbagevendende anvendelsestilfælde, hvor du altid ønsker samme afgrænsning og outputstruktur, eller til brugerdefinerede outputintegrationer kan det underliggende flow i FlowHunt ændres til at målrette bestemte ejendomstyper, justere hvilke målinger der vises, eller ændre outputformatet. Det er nyttigt, hvis rapporterne føres ind i en fast rapporteringsskabelon eller et dashboard.
Trin 3: Kør din første udtrækning
Indsend din målmarkedsbeskrivelse. Værktøjet starter straks pipelinen med fire faser:
Fase 1 — Dataindsamling: Scraperen samler ejendomsopslag fra troværdige onlineplatforme og API’er inden for den afgrænsning, du har defineret.
Fase 2 — Datarensning og strukturering: Alle indsamlede opslag standardiseres, før analysen kører. Prisformater normaliseres, ejendomstyper mappes til ensartede kategorier, areal og facilitetsdata tilpasses, og ufuldstændige, dublerede eller upålidelige poster filtreres fra.
Fase 3 — Evaluering og mønstergenkendelse: Det rensede datasæt analyseres for prismønstre, tilgængelighedstendenser og sammenhænge mellem ejendomsegenskaber og pris.
Fase 4 — Generering af indsigter: Resultaterne sammensættes til handlingsorienterede indsigter, herunder prisfordeling, nye markedstendenser, afvigelser, undervurderede områder og potentielle investeringsmuligheder.
Pipelinen kører uden behov for yderligere input fra din side efter den første indsendelse. Når den er færdig, er den strukturerede rapport klar til gennemgang.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Trin 4: Gennemgå rapportens output
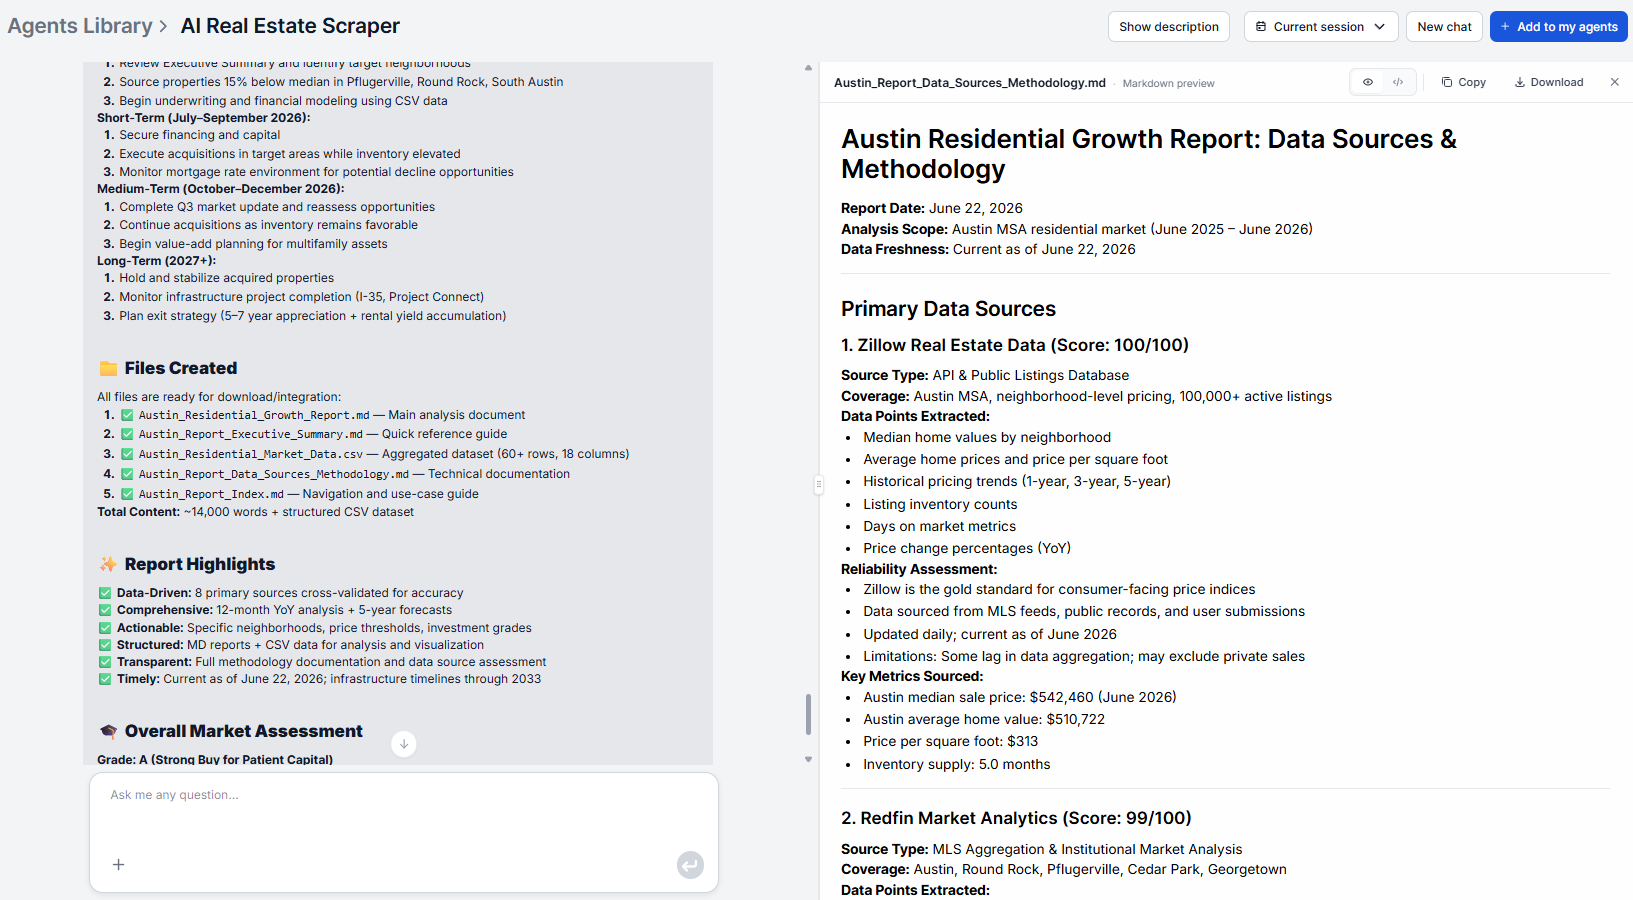
Outputtet er en struktureret rapport. Her er, hvad hvert afsnit indeholder:
Overblik over datasættet — et resumé af den dækkede afgrænsning og de tilgåede kilder, som giver dig et udgangspunkt for, hvor omfattende datasættet er.
Nøglemålinger og statistik — gennemsnitspriser, medianejendomsstørrelser og fordeling af ejendomstyper i datasættet. Det er de overordnede tal til at forstå markedet med et hurtigt blik.
Trendanalyse — betydningsfulde pris- og tilgængelighedsmønstre identificeret i dataene. Prisforskelle mellem by og forstad, sæsonbestemte markedsskift, nye kvarterer og sammenhænge mellem ejendomsegenskaber og pris.
Mønsterindsigter — Undervurderede områder, hvor priserne er lavere, end egenskabsprofilen ville forudsige, afvigelser i begge ender af prisfordelingen og sammenhænge mellem bestemte karakteristika (størrelse, beliggenhed, faciliteter) og pris inden for målmarkedet.
Læs hele outputtet ved din første kørsel, før du drager konklusioner. Særligt afsnittet med mønsterindsigter fremhæver signaler, der ikke er tydelige ud fra de overordnede tal alene.
Hvis noget i outputtet ser uventet ud, så stikprøvekontrollér det mod en manuel gennemgang af en håndfuld opslag i det markerede område. Nogle gange afspejler en afvigelse et ægte markedssignal, andre gange et dataartefakt fra et enkelt usædvanligt opslag.
Trin 5: Eksportér og analysér
Outputtet er struktureret HTML, hvilket betyder, at det nemt kan flyttes ind i ethvert system, der accepterer HTML eller rig tekst, uden omformatering.
Almindelige destinationer for rapporten:
- Investorportaler og CMS-systemer — indsæt HTML’en direkte; strukturen vises korrekt uden ekstra formateringsarbejde
- Notion eller Confluence — indsæt som referencedokument linket fra den relevante deal- eller markedsresearchmappe, med datoen i dokumenttitlen, så rapporter fra forskellige kørsler er nemme at sortere
- Google Docs — indsæt outputtet, tilføj et kort fortolkningslag øverst (de to eller tre resultater, der er mest relevante for den aktuelle beslutning), og del med interessenter, der har brug for kontekst sammen med dataene
- Dashboards eller analysesystemer — HTML-strukturen er ens på tværs af hver kørsel, hvilket gør det ligetil at parse eller integrere i en overvågningspipeline
Pro-tips: Sådan får du mere præcise og komplette data
Vær specifik frem for bred. En stram geografisk afgrænsning med en defineret ejendomstype giver mere handlingsorienteret analyse end en bred region uden typefilter. Du kan altid køre flere fokuserede analyser og sammenligne dem i stedet for én bred analyse, der gennemsnitliggør segmenter, du værdsætter forskelligt.
Medbring dine egne data, når du har dem. Hvis du har eksisterende research, et porteføljedatasæt eller en kurateret liste af opslag, gør det analysen mere relevant for dine faktiske investeringsparametre at tilføje det sammen med de scrapede kilder. Værktøjet normaliserer begge kilder sammen.
Kør med fast kadence for at se tendenser. En enkelt rapport fortæller dig, hvordan markedet ser ud nu. Sammenligning af rapporter fra samme målmarked kørt månedligt afslører de egentlige indsigter. Det ensartede outputformat på tværs af hver kørsel gør sammenligning ligetil og gør det nemt at opdage ændringer i medianpris, nye kvarterer eller skiftende afvigelser.
Tilpas flowet til tilbagevendende anvendelsestilfælde. Hvis du kører samme analyse regelmæssigt, sparer det tid og sikrer ensartethed på tværs af hver kørsel at ændre det underliggende flow, så din standardafgrænsning og outputstruktur låses fast.
For et konkret eksempel på, hvordan et tilbagevendende ejendomsresearch-workflow ser ud i praksis, inklusive opdelingen af tid før og efter, se hvordan ejendomsinvestorer finder deals hurtigere med AI .
