


Jede Codebasis hat einen Dokumentationsordner, der in der Woche des Launches großartig aussah. Ein halbes Jahr später beschreibt die Hälfte der Seiten eine Version des Produkts, die es nicht mehr gibt, und die neuesten Features haben überhaupt keine Dokumentation.
Das ist ein strukturelles und ein Zeitproblem. Zu verstehen, warum manuelle Dokumentation nach einem vorhersehbaren Muster verfällt, ist der erste Schritt, um die Dokumentation dauerhaft zu verbessern, statt jedes Jahr dasselbe Rewrite-Projekt zu fahren. Hier erfährst du, warum der traditionelle Ansatz für Entwicklerdokumentation konstruktionsbedingt scheitert und was den Kreislauf tatsächlich durchbricht.
Das Problem der Dokumentationsschulden: Wie Teams dort landen
Dokumentationsschulden funktionieren wie ihr berühmterer Verwandter, die technischen Schulden – nur sind sie schwerer zu sehen. Eine Abkürzung im Code verursacht irgendwann einen Bug, den jemand beheben muss. Eine veraltete Doku sitzt einfach still da und ist falsch, und niemand merkt es, bis ein neuer Kollege ihr folgt und etwas kaputtmacht oder ein Support-Ticket zeigt, dass die Setup-Anleitung seit vier Monaten ein veraltetes Flag beschreibt.
Der Verlauf ist fast immer derselbe. Zum Launch ist die Dokumentation gründlich, weil das Team motiviert ist und die Oberfläche klein. Drei Monate und fünf Feature-Releases später sind zwei dieser Features dokumentiert, und die anderen drei existieren nur in den Köpfen der Menschen, die sie gebaut haben. Wenn dann irgendwann jemand die Docs auditiert, ist die Lücke zwischen dem, was geschrieben steht, und dem, was stimmt, so groß geworden, dass die Behebung wie ein Projekt aussieht statt wie eine Gewohnheit.
Das ist auch kein hypothetischer Kostenfaktor. Die Forschung von Stack Overflow zeigt, dass Dokumentation bereits rund 11 % der Arbeitsstunden von Entwicklern verbraucht, und GetDX schätzt , dass Engineers 3–10 Stunden pro Woche damit verlieren, nach Informationen zu suchen, die längst aufgeschrieben sein sollten – Stunden, die auf keiner Roadmap auftauchen, aber trotzdem aus dem tatsächlichen Output verschwinden.
Warum manuelle Dokumentation immer hinter der Entwicklung zurückbleibt
Codeänderungen sind billig zu machen und teuer zu dokumentieren. Ein Ein-Zeilen-Fix an einem Rate Limiter ist vielleicht in fünf Minuten geschrieben und ausgeliefert, aber ihn korrekt zu erklären – was sich geändert hat, warum, und was das für alle bedeutet, die diesen Endpoint aufrufen – braucht echte, ununterbrochene Schreibzeit, die es in einem Sprint voller anderer Verpflichtungen nicht gibt.
Jeder Commit ist ein kleiner, stiller Entscheidungspunkt. Jemand muss bemerken, dass die Änderung wichtig genug ist, um dokumentiert zu werden, sich daran erinnern und dann die Zeit dafür finden. Manuelle Dokumentation hängt davon ab, dass alle drei Dinge konsistent passieren – bei jeder relevanten Änderung. Es reicht, dass eines davon hin und wieder ausfällt, und die Schulden beginnen sich anzustauen.
Die Überzeugung, dass sauberer Code selbsterklärend sein sollte, hilft nicht. Gut benannte Funktionen und klare Logik erklären jemandem, der bereits mit der Codebasis vertraut ist, was der Code tut. Sie erklären nicht, warum oder warum genau dieses Was, wie man ihn verwendet oder wie er ins größere System passt. Genau diese Art von Information soll manuelle Dokumentation liefern – und genau diese Information wird übersprungen, wenn die Zeit knapp ist.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Die 3 Hauptursachen für unvollständige Entwickler-Docs
Unter der allgemeinen Klage “unsere Docs sind schlecht” liegen drei konkrete, behebbare Mechanismen:
- Die Zuständigkeit ist diffus. Wenn Dokumentation “die Verantwortung aller” ist, ist sie faktisch die von niemandem. Ohne eine konkrete Person oder einen Auslöser, der für die Aktualisierung eines konkreten Dokuments verantwortlich ist, landet sie bei demjenigen, der zufällig merkt, dass sie falsch ist – oft ein verwirrter neuer Kollege oder ein frustrierter Kunde. Zusätzlich bringt dieser Ansatz inkonsistentes Formatieren, inkonsistente Sprache und inkonsistente Schreibstile hervor.
- Die Kosten sind asymmetrisch. Eine Änderung zu schreiben geht schneller, als eine akkurate Erklärung dieser Änderung für jemand anderen zu schreiben. Unter Termindruck verliert die Aufgabe, die direkt mit dem Ausliefern konkurriert.
- Es gibt keinen Auslösemechanismus. Die meisten Teams koppeln ein Dokumentationsupdate nicht an ein konkretes Ereignis wie einen gemergten Pull Request oder ein Release. Ohne diesen Auslöser wird Dokumentation nur reaktiv angegangen – nachdem ein Support-Ticket oder ein gescheitertes Onboarding das Problem erzwungen hat. Das heißt, die Korrektur kommt immer erst, nachdem die Kosten bereits bezahlt wurden.
Wie KI die Lücke zwischen Code und Dokumentation schließt
Ein KI-Dokumentations-Writer adressiert diese drei Ursachen direkt, weil er die Ökonomie verändert, statt Menschen zu bitten, sich unter denselben Einschränkungen anders zu verhalten.
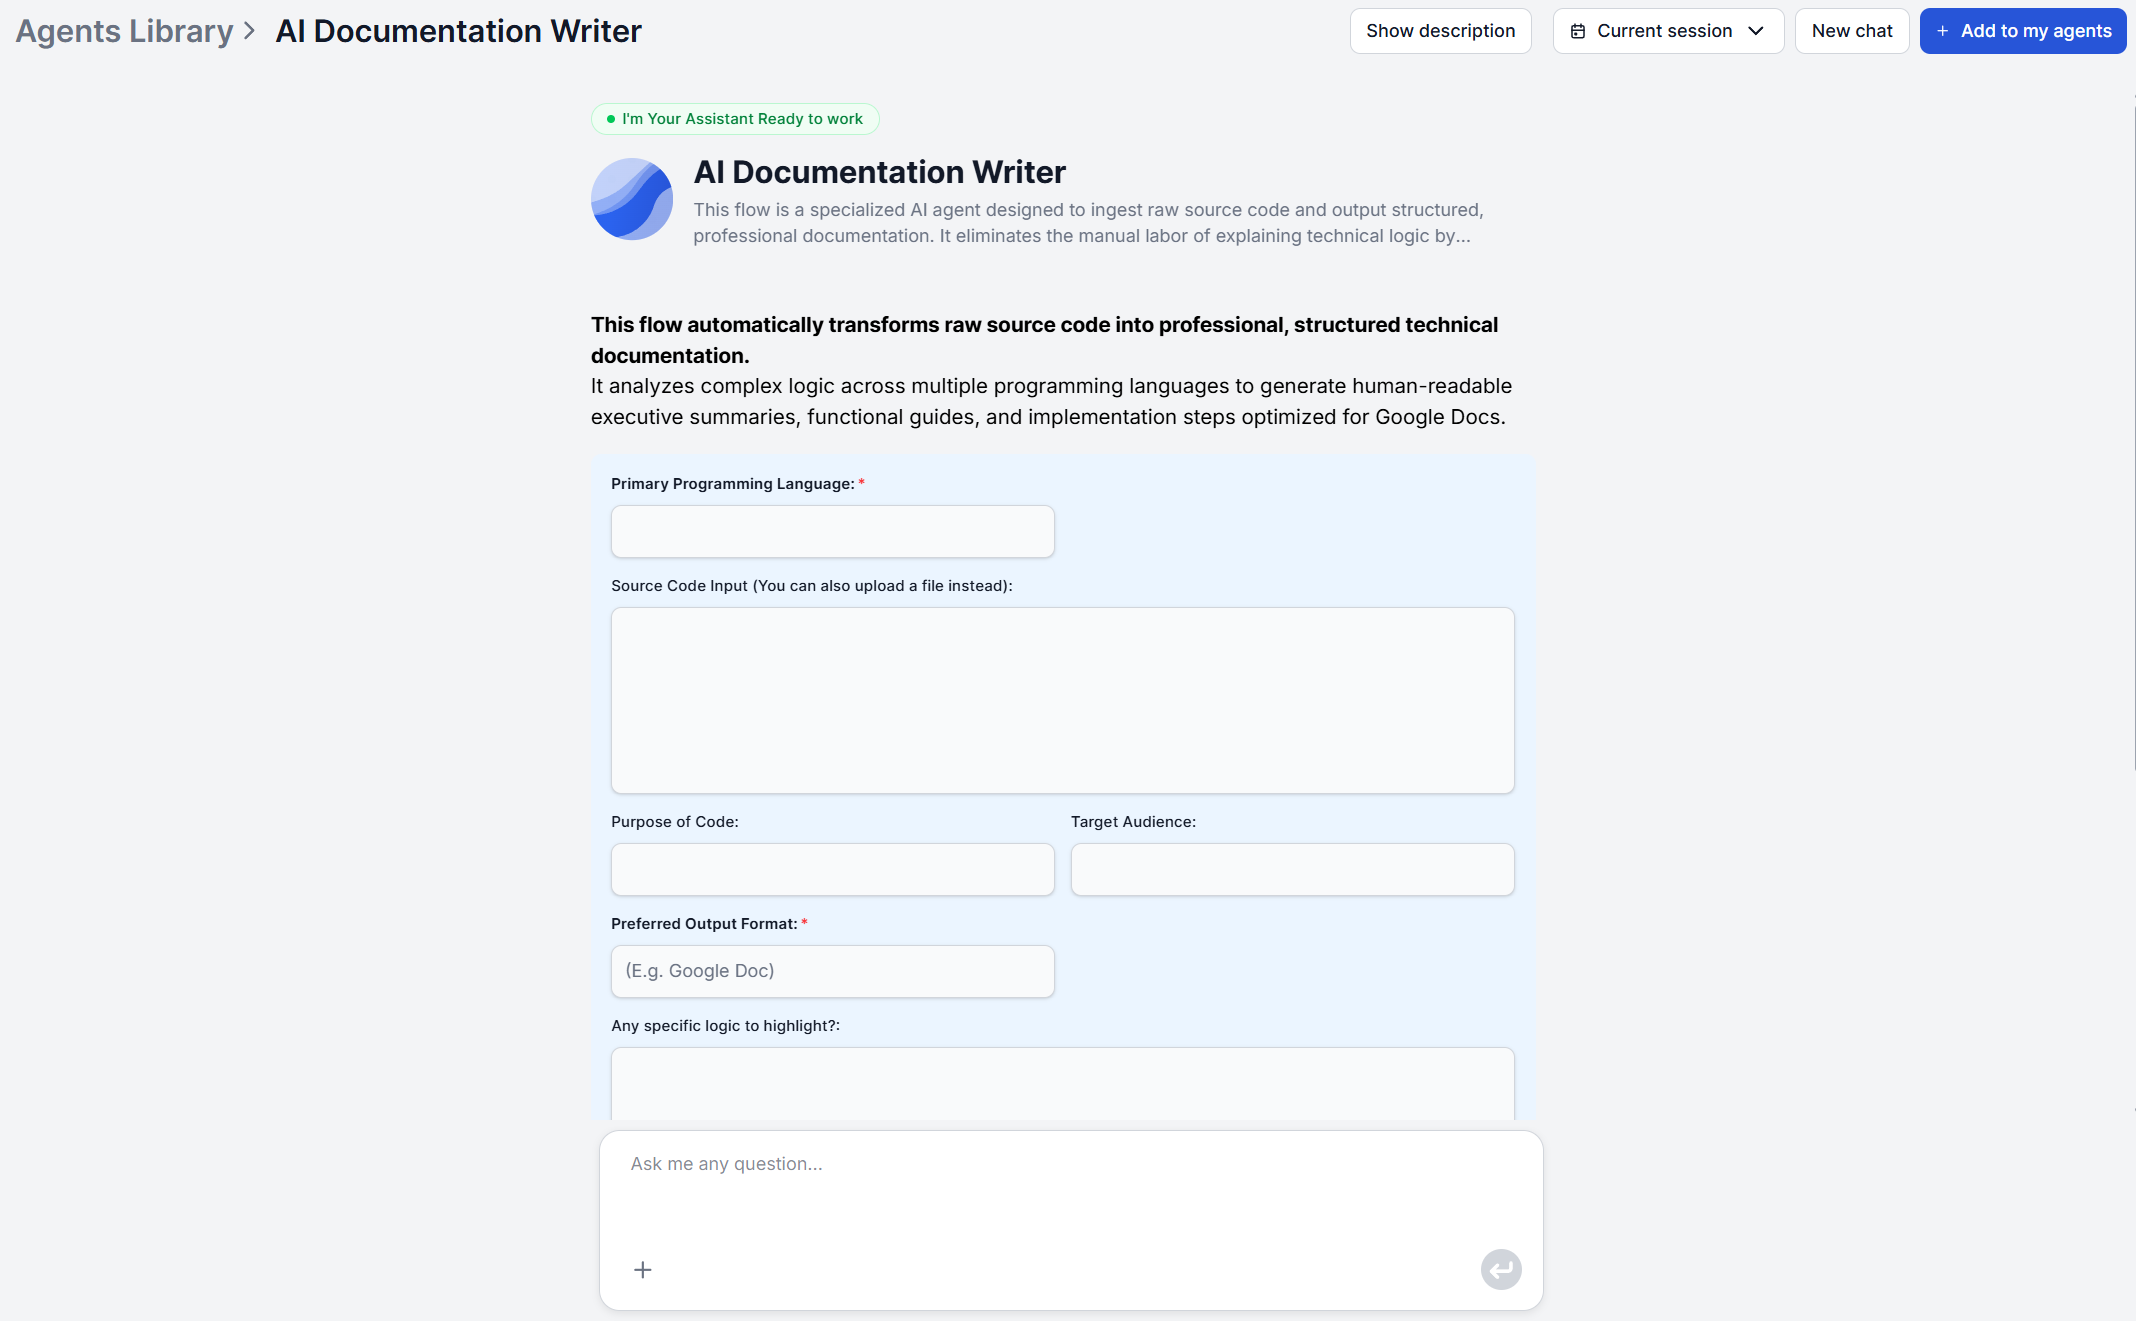
Der AI Documentation Writer von FlowHunt arbeitet in drei Stufen . Zuerst analysiert er den Code, dann übersetzt er die Logik, und zuletzt strukturiert er das Ausgabedokument. Du gibst den Quellcode an, die primäre Sprache, den Zweck, deine Zielgruppe und alle weiteren Informationen, die du für sinnvoll hältst oder die das Formular verlangt.
Das fertig generierte Dokument deckt eine Management Summary, funktionale Fähigkeiten, technische Architektur, Logikfluss, zentrale Funktionen und Komponenten sowie Nutzungshinweise ab.
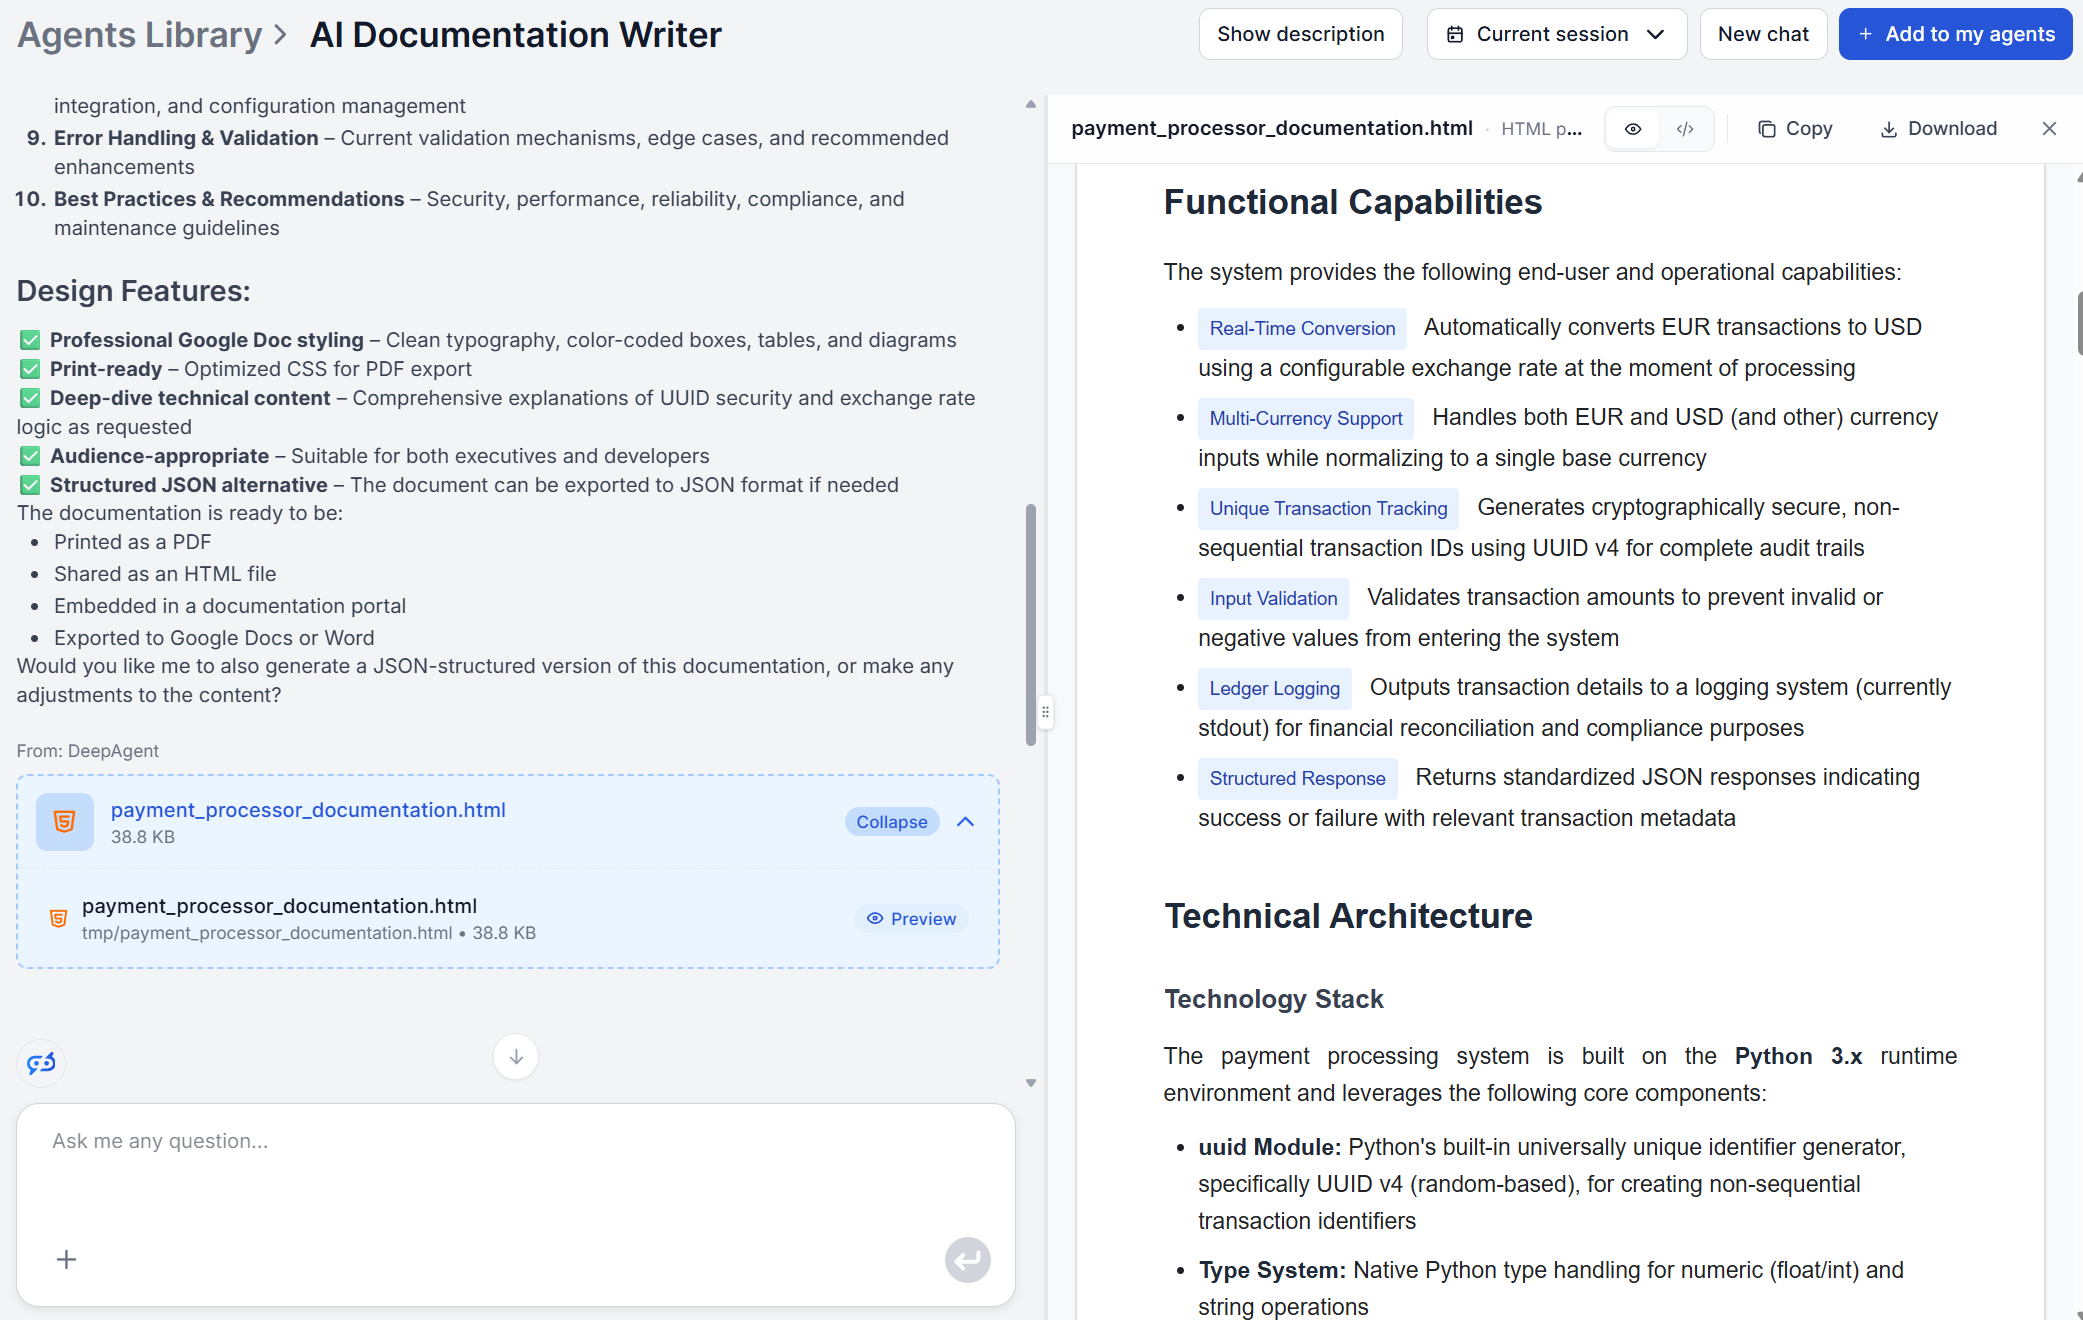
Dieser Prozess behebt die Kostenasymmetrie direkt. Wenn das Neugenerieren akkurater Dokumentation aus dem aktuellen Code ein paar Minuten dauert statt einen halben Tag sorgfältigen Schreibens, verliert es den Prioritätenkampf gegen das Ausliefern von Code nicht mehr.
Er schwächt auch das Zuständigkeitsproblem ab, denn ein schneller Prozess mit geringem Aufwand lässt sich realistisch der Person zuweisen, die die Änderung merged, statt jedes Mal eine dedizierte Autorin einbinden zu müssen. Kleine, aber zeitintensive Aufgaben aus den Händen der Autorinnen zu nehmen, erlaubt es ihnen außerdem, den Inhalten mit hohem Einsatz mehr Sorgfalt zu widmen.
Der Auslösemechanismus muss weiterhin bewusst gewählt werden. FlowHunt überwacht dein Repository nicht von selbst, aber da es eine Workflow-Automatisierungsplattform ist, kann der Flow an einen Webhook gekoppelt werden, der ausgelöst wird, sobald ein Pull Request gemergt wird, der ein dokumentiertes Modul berührt.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Ein Dokumentationssystem aufbauen, das aktuell bleibt
Ein Dokumentationssystem, das die ersten paar Monate überlebt, braucht mehr als einen schnellen Generierungsschritt. Ein funktionierender Kreislauf sieht so aus:
Auslöser. Ein gemergter Pull Request oder ein Release-Cut schickt den relevanten Quellcode in den Dokumentations-Writer, mit Zielgruppe und Zweck, die für diesen konkreten Dokumenttyp festgelegt sind (eine API-Referenz, ein Nutzerleitfaden, ein internes SOP).
Erfassen, was nicht im Code steht. Manche Kontexte schaffen es nie in den Quellcode, etwa warum ein Deployment-Skript so funktioniert, wie es funktioniert – meist existiert das nur als mündliche Erklärung eines Engineers. Es hilft immer, diese Informationen zusammen mit dem Code selbst in das Tool einzuspeisen. Die Erklärung liefert mehr Kontext und Tiefe und sorgt dafür, dass menschennäherer und spezifischerer Inhalt entsteht.
Externen Kontext gegenprüfen, wenn es darauf ankommt. Prüfe alle Branchenstandards, Protokolle oder Konventionen, die es wert sind, gegen externe Quellen verifiziert zu werden. Prüfe außerdem proprietäre Daten, die du der KI gibst, erneut – sie könnten veraltet sein.
Vor dem Veröffentlichen reviewen. Eine Person, die das System kennt, bestätigt, dass die Setup-Schritte tatsächlich funktionieren, prüft, dass jedes Legacy-Element, das die KI nicht allein aus dem Code ableiten konnte, korrekt ist, und verifiziert, dass die Ausgabe für die beabsichtigte Zielgruppe korrekt lesbar ist.
Beim nächsten Change erneut auslösen. Du kannst die Neugenerierung nach Zeitplan oder über einen eigenen Trigger einrichten. Du kannst den Kreislauf zum Beispiel beim nächsten Merge wiederholen lassen – der beste Weg, um die Lücke zwischen Code und Dokumentation klein zu halten.
Wie gute Entwicklerdokumentation tatsächlich aussieht
Gute Dokumentation definiert sich nicht über Länge oder Feinschliff, sondern darüber, ob sie die Fragen beantwortet, die ein Leser tatsächlich hat – in der Reihenfolge, in der er sie stellen würde. Eine nützliche Struktur deckt ab:
- Was es tut – eine kurze Zusammenfassung von Zweck und Umfang, damit ein Leser in einem Absatz erkennt, ob er hier richtig ist.
- Was es ermöglicht – die konkreten Fähigkeiten und Features, nicht nur eine Wiederholung des Codes.
- Wie es gebaut ist – genug Architekturkontext (Stack, Komponenten, Abhängigkeiten), damit jemand über das System nachdenken kann, statt es nur zu verwenden.
- Wie es funktioniert – der Logikfluss und die zentralen Operationen, erklärt als Prozess statt als Liste von Funktionsnamen.
- Wie man es verwendet – Setup, Konfiguration und Nutzungshinweise, geschrieben für den tatsächlichen Leser, nicht für die Person, die den Code geschrieben hat.
Das ist – nicht zufällig – auch ziemlich genau das, was ein codebasierter Generierungsprozess von Natur aus produziert, da jeder Abschnitt auf eine Frage abbildet, die ein echter Leser stellt, statt auf einen Abschnitt, den eine Autorin sich verpflichtet fühlte aufzunehmen.
Von Dokumentationsschulden zum Dokumentationsvermögen
Dokumentationsschulden und Dokumentation als Asset sind dasselbe zugrunde liegende Material – Quellcode und institutionelles Wissen – auf zwei verschiedenen Stufen der Wartungskosten. In dem Moment, in dem das Neugenerieren eines Dokuments günstig genug ist, um es bei jeder relevanten Änderung zu tun, beginnt dieselbe Information, die früher zu Schulden verfiel, sich zu etwas zu verzinsen, auf das sich das Team verlassen kann.
Schreibe bessere Dokumentation mit KI und sieh, wie viel deiner aktuellen Dokumentationsschulden wirklich nur ein Kostenproblem ist, das auf einen schnelleren Prozess wartet.
Für die vollständige Mechanik des zugrunde liegenden Generierungsprozesses siehe wie man technische Dokumentation automatisch mit KI schreibt , und für konkrete Dokumenttypen, die dieser Ansatz gut abdeckt, siehe fünf Dokumenttypen, die KI schneller schreibt .
