


Enhver kodebase har en dokumentationsmappe, der så fantastisk ud i den uge, den blev lanceret. Seks måneder senere beskriver halvdelen af siderne en version af produktet, der ikke længere findes, og de nyeste funktioner har slet ingen dokumentation.
Det er et strukturelt og tidsmæssigt problem, og at forstå hvorfor manuel dokumentation forringes efter en forudsigelig plan, er første skridt til reelt og varigt at forbedre dokumentationen i stedet for at køre det samme omskrivningsprojekt hvert år. Her er hvorfor den traditionelle tilgang til udviklerdokumentation fejler per design, og hvad der reelt bryder cirklen.
Problemet med dokumentationsgæld: hvordan teams ender der
Dokumentationsgæld fungerer som sin mere berømte fætter, den tekniske gæld, bortset fra at den er sværere at se. En genvej i koden forårsager på et tidspunkt en fejl, som nogen må rette. En forældet dokumentside ligger bare der og er stille og roligt forkert, og ingen opdager det, før en nyansat følger den og ødelægger noget, eller en supporthenvendelse afslører, at opsætningsguiden har beskrevet et forældet flag i fire måneder.
Forløbet er næsten altid det samme. Ved lanceringen er dokumentationen grundig, fordi teamet er motiveret, og overfladen er lille. Tre måneder og fem funktionsudgivelser senere er to af de funktioner blevet dokumenteret, og de tre andre findes kun i hovedet på dem, der byggede dem. Når nogen først reviderer dokumentationen, er kløften mellem det skrevne og det sande blevet så stor, at det at rette den ligner et projekt i stedet for en vane.
Det er heller ikke en hypotetisk omkostning. Stack Overflows undersøgelse viste, at dokumentation allerede bruger cirka 11 % af udviklernes arbejdstimer, og GetDX anslår , at ingeniører mister 3-10 timer om ugen på at jagte information, der allerede burde være skrevet ned – timer, der ikke optræder nogen steder på et roadmap, men som alligevel forsvinder fra den faktiske produktion.
Hvorfor manuel dokumentation altid sakker bagud for udviklingen
Kodeændringer er billige at lave og dyre at dokumentere. En enlinjes rettelse i en rate limiter tager måske fem minutter at skrive og shippe, men at forklare den præcist – hvad der ændrede sig, hvorfor, og hvad det betyder for alle, der kalder det endpoint – kræver reel, uafbrudt skrivetid, som ikke findes i et sprint, der allerede er fyldt med andre forpligtelser.
Hvert commit er et lille, stille beslutningspunkt. Nogen skal bemærke, at ændringen er vigtig nok til at dokumentere, huske den og derefter finde tid til det. Manuel dokumentation afhænger af, at alle tre ting sker konsekvent for hver ændring, der betyder noget. Det kræver kun, at én af dem glipper en gang imellem, og gælden begynder at hobe sig op.
Troen på, at ren kode burde være selvforklarende, hjælper ikke. Velnavngivne funktioner og klar logik forklarer, hvad koden gør, for en der allerede er flydende i kodebasen. Den forklarer ikke hvorfor, eller hvorfor netop dette hvad, hvordan man bruger det, eller hvordan det passer ind i det større system. Det er præcis den slags information, manuel dokumentation skal levere, og præcis den information, der bliver sprunget over, når tiden er knap.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
De 3 grundårsager til ufuldstændig udviklerdokumentation
Under den generelle klage over, at “vores dokumentation er dårlig”, ligger tre specifikke, løsbare mekanismer:
- Ejerskabet er diffust. Når dokumentation er “alles ansvar”, er det reelt ingens. Uden en bestemt person eller udløser, der er ansvarlig for at opdatere et bestemt dokument, ender det hos den, der tilfældigt opdager, at det er forkert – ofte en forvirret nyansat eller en frustreret kunde. Oveni det spreder denne tilgang inkonsistent formatering, sprog og skrivestil.
- Omkostningen er asymmetrisk. Det er hurtigere at skrive en ændring end at skrive en præcis forklaring af den ændring til en anden. Under ethvert deadline-pres taber den opgave, der konkurrerer direkte med at shippe.
- Der er ingen udløsermekanisme. De fleste teams knytter ikke en dokumentationsopdatering til en konkret hændelse som en merget pull request eller en release. Uden den udløser bliver dokumentationen kun håndteret reaktivt – efter en supporthenvendelse eller et mislykket onboardingforløb tvinger sagen frem – hvilket betyder, at rettelsen altid kommer, efter omkostningen er betalt.
Hvordan AI lukker kløften mellem kode og dokumentation
En AI-dokumentationsskribent adresserer disse tre årsager direkte, fordi den ændrer økonomien i stedet for at bede folk om at opføre sig anderledes under de samme begrænsninger.
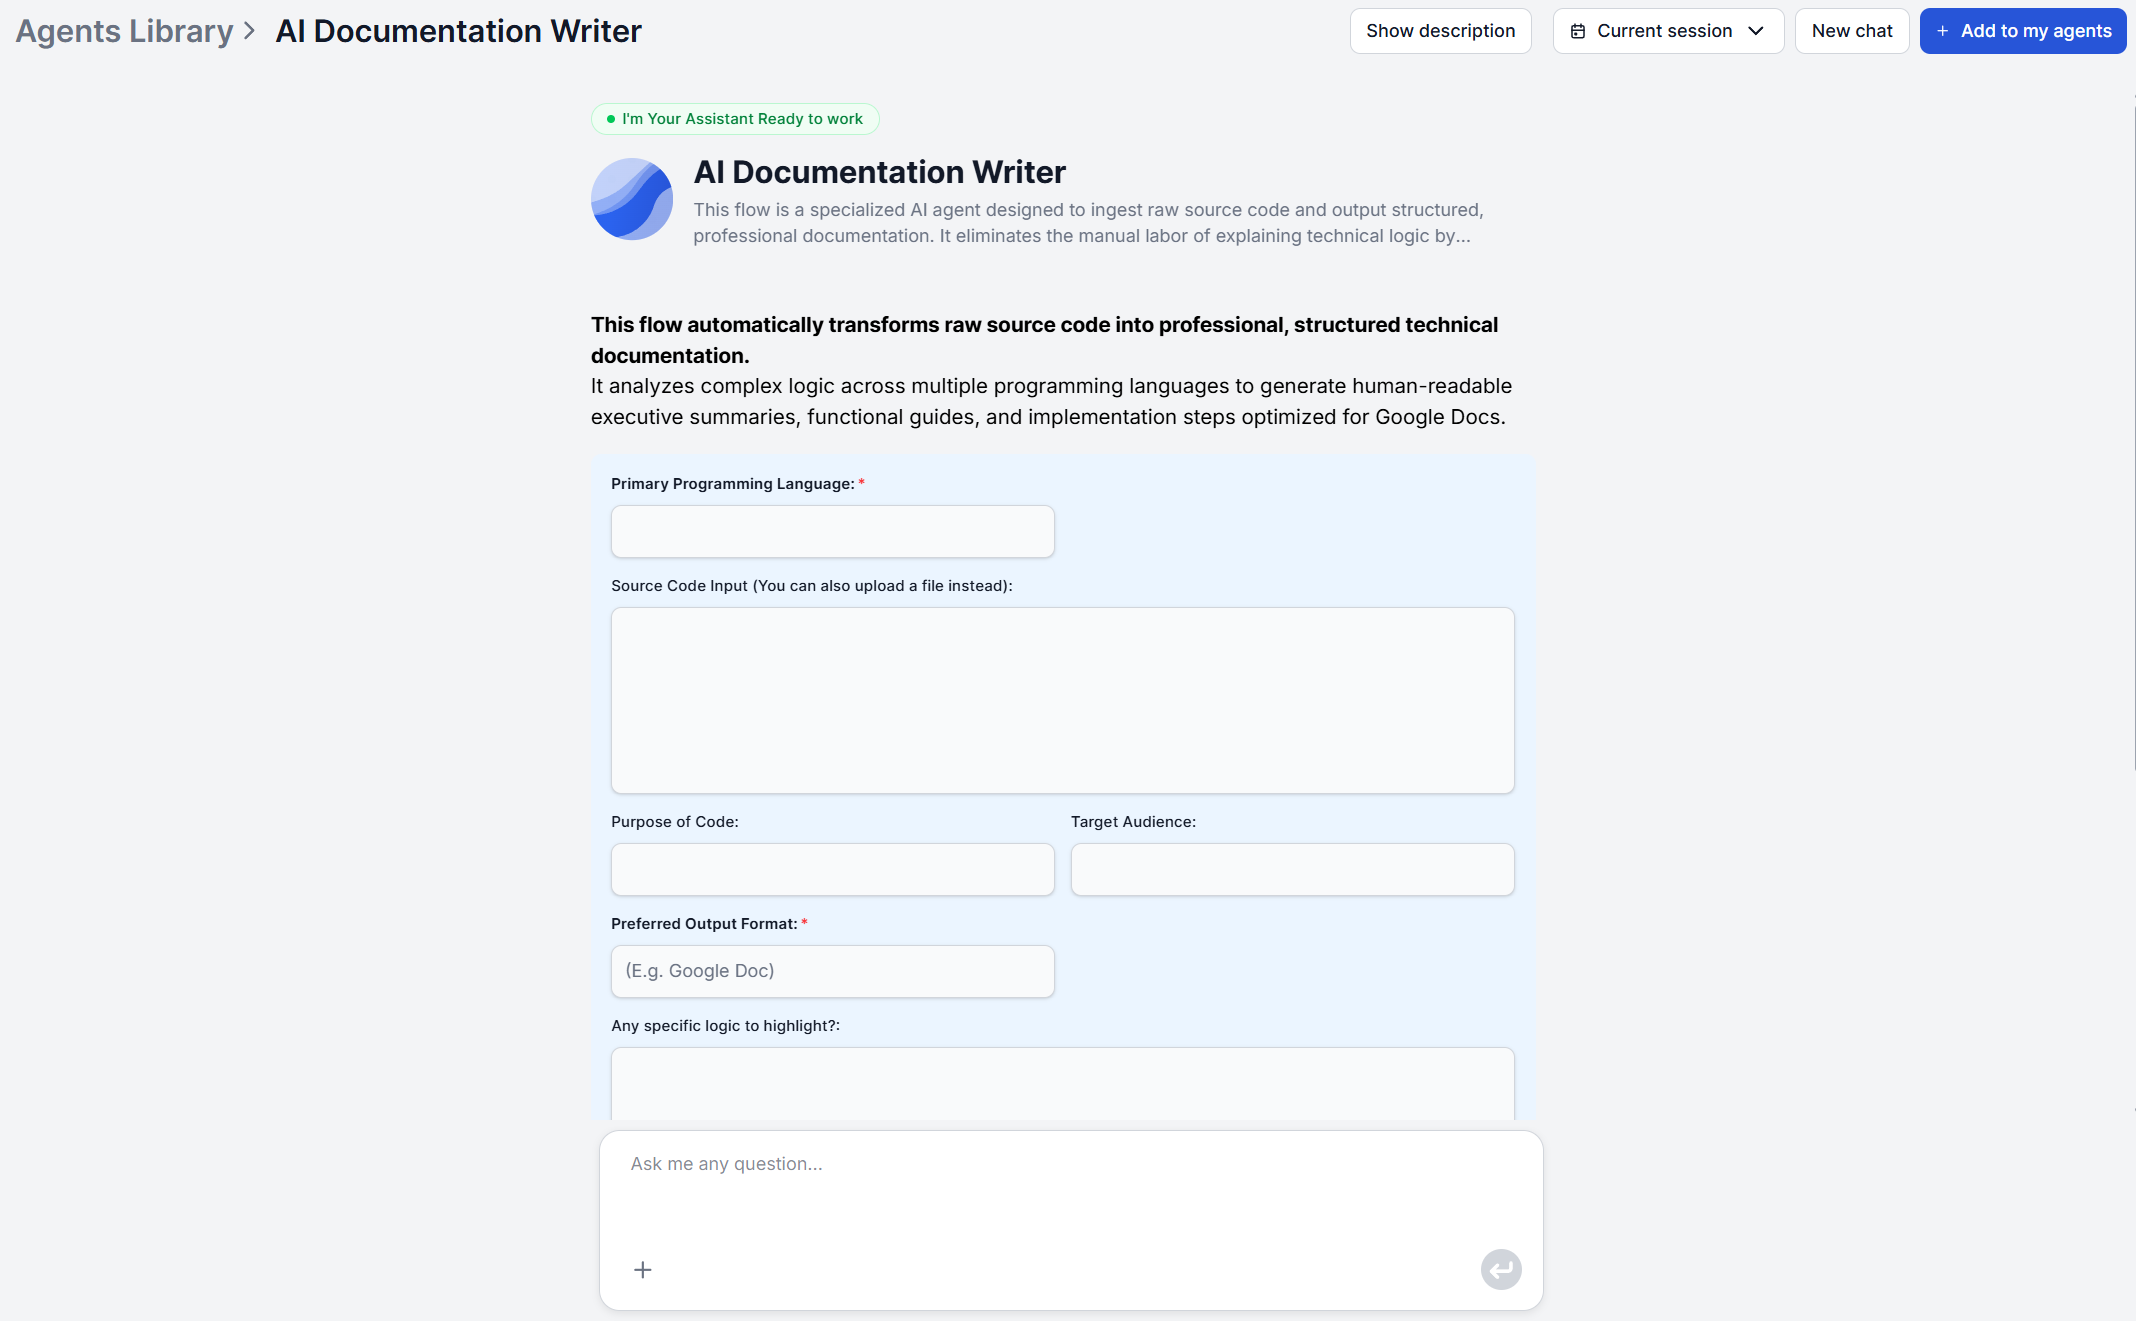
FlowHunts AI Documentation Writer arbejder i tre faser . Først analyserer den koden, derefter oversætter den logikken, og til sidst strukturerer den outputdokumentet. Du angiver kildekoden, det primære sprog, formålet, din målgruppe og eventuelle yderligere oplysninger, du finder relevante, eller som formularen beder om.
Det færdige genererede dokument dækker et ledelsesresumé, funktionelle kapaciteter, teknisk arkitektur, logikflow, nøglefunktioner og komponenter samt brugsanvisninger.
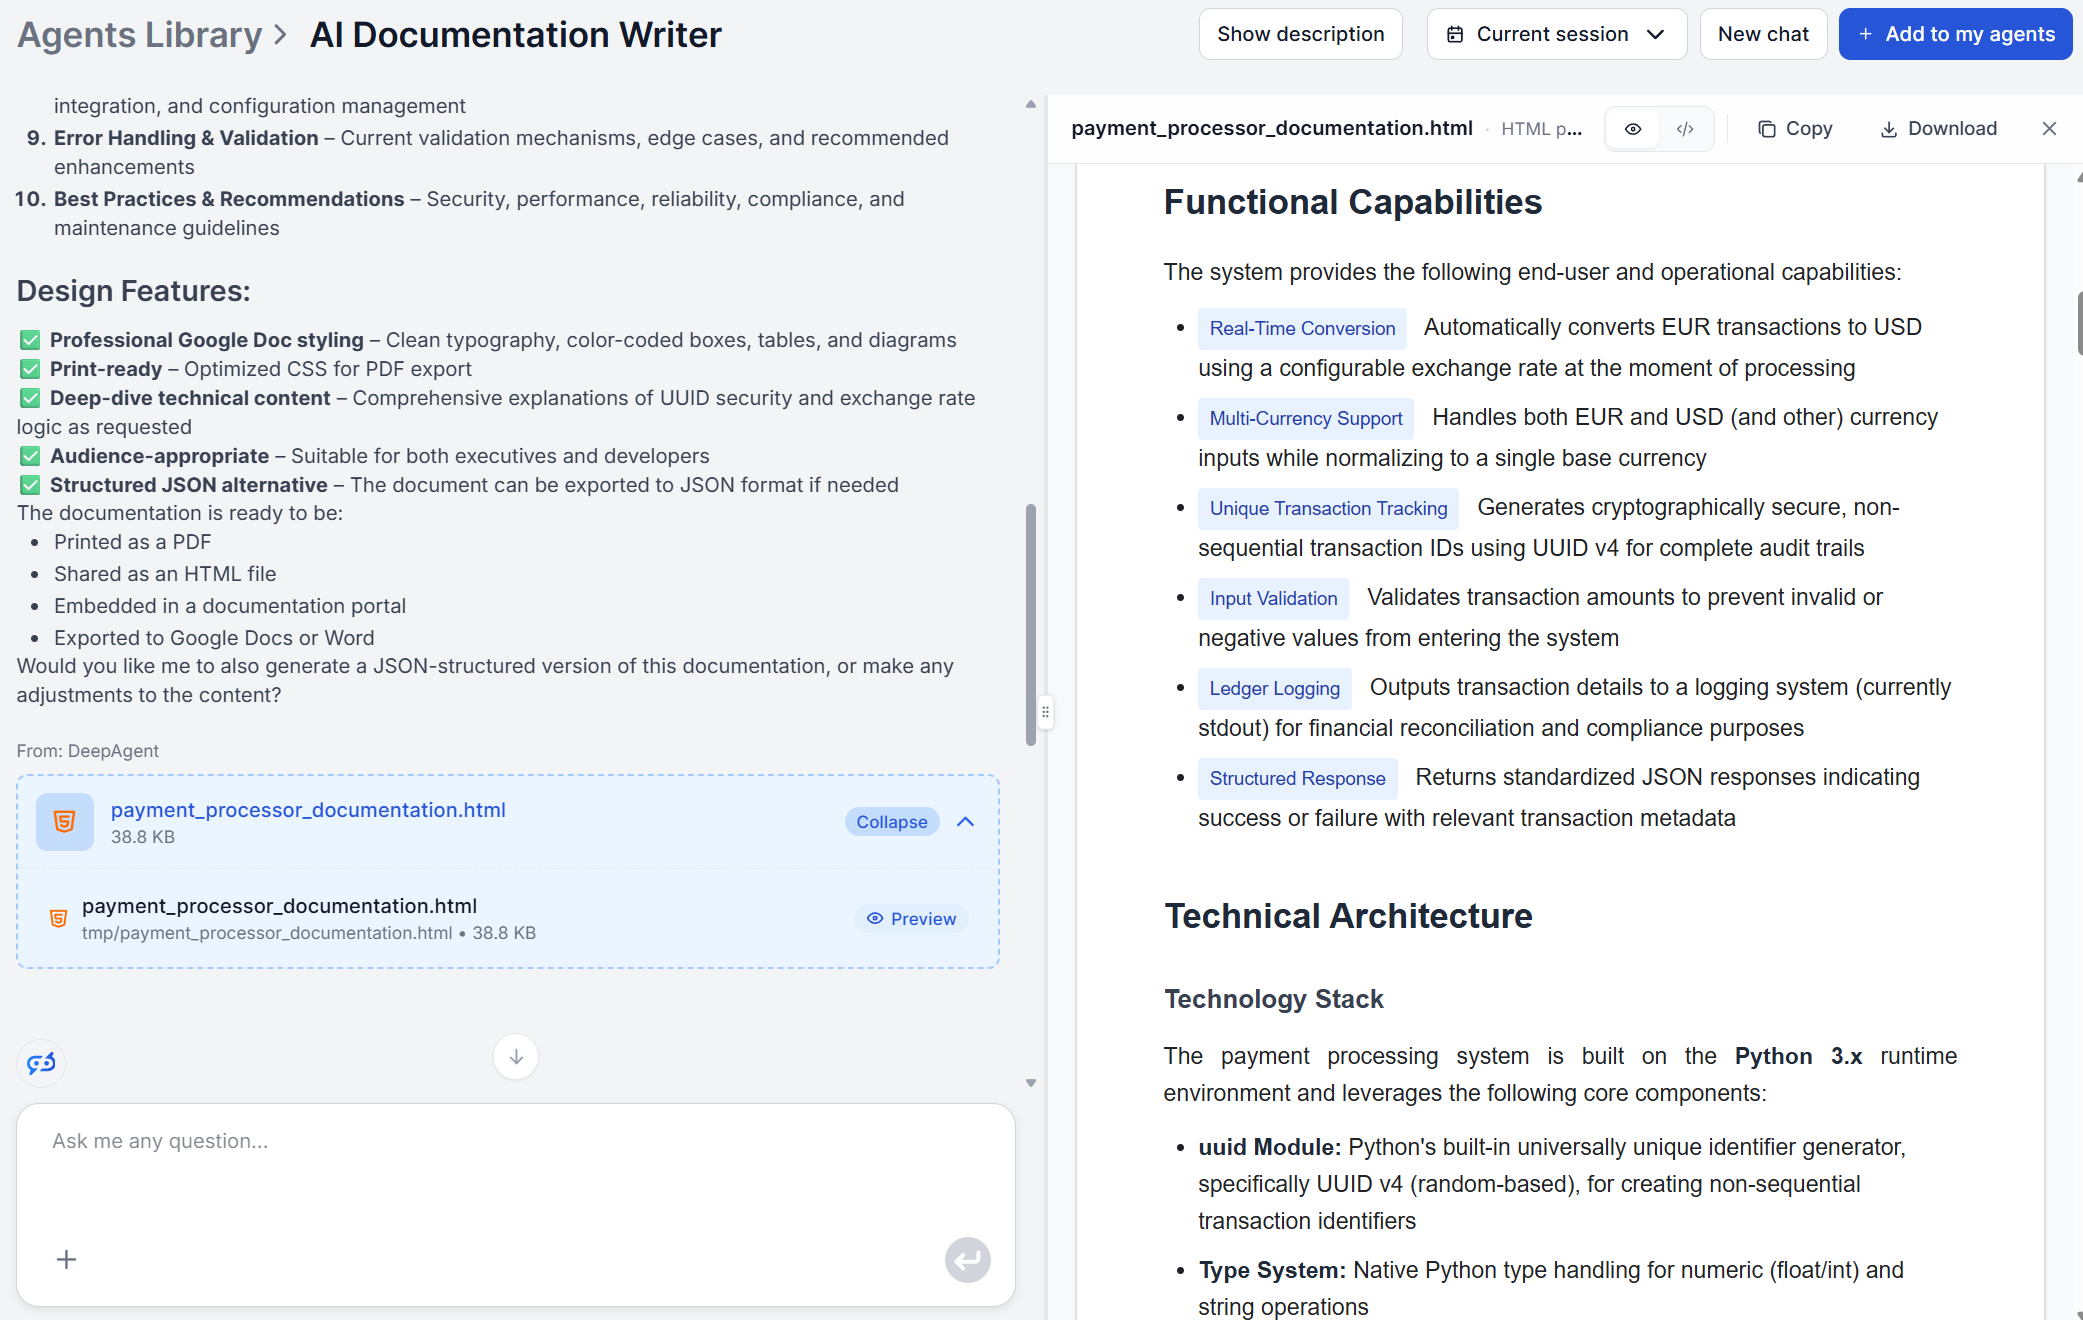
Den proces løser den asymmetriske omkostning direkte. Hvis det tager et par minutter i stedet for en halv dag med omhyggelig skrivning at regenerere præcis dokumentation ud fra den aktuelle kode, holder den op med at tabe prioriteringskampen mod at shippe kode.
Den svækker også ejerskabsproblemet, da en hurtig proces med lav indsats er realistisk at pålægge den, der merger ændringen, i stedet for at kræve, at en dedikeret skribent trækkes ind hver gang. At tage små, men tidskrævende opgaver fra skribenterne giver dem også mulighed for at bruge større omhu på det indhold, der betyder mest.
Udløsermekanismen skal stadig være bevidst. FlowHunt overvåger ikke selv dit repository, men fordi det er en workflow-automatiseringsplatform, kan flowet kobles til en webhook, der udløses, hver gang en pull request, som berører et dokumenteret modul, bliver merget.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Opbygning af et dokumentationssystem, der forbliver opdateret
Et dokumentationssystem, der overlever de første par måneder, kræver mere end et hurtigt genereringstrin. Et brugbart loop ser sådan ud:
Udløser. En merget pull request eller en release sender den relevante kildekode ind i dokumentationsskribenten med målgruppe og formål sat for netop den type dokument (en API-reference, en brugerguide, en intern SOP).
Indfang det, der ikke står i koden. Noget kontekst ender aldrig i kildekoden, for eksempel hvorfor et deployment-script fungerer, som det gør, hvilket ofte kun findes som én ingeniørs mundtlige forklaring. Det hjælper altid at føde denne information ind i værktøjet sammen med selve koden. Forklaringen tilføjer mere kontekst og dybde og sikrer, at der produceres mere menneskeligt og specifikt indhold.
Krydstjek ekstern kontekst, når det betyder noget. Tjek eventuelle branchestandarder, protokoller eller konventioner, der er værd at verificere mod eksterne kilder. Tjek også proprietære data, du giver AI’en, igen, da de kan være blevet forældede.
Gennemgå før publicering. En person, der kender systemet, bekræfter, at opsætningstrinene faktisk virker, tjekker at enhver ældre del, som AI’en ikke kunne udlede alene fra koden, er korrekt, og verificerer, at outputtet læses korrekt for den tilsigtede målgruppe.
Genudløs ved næste ændring. Du kan sætte regenerering op efter en plan eller via en brugerdefineret udløser. Du kan for eksempel lade loopet gentage sig ved næste merge, hvilket er den bedste måde at holde kløften mellem kode og dokumentation lille.
Hvordan god udviklerdokumentation egentlig ser ud
God dokumentation defineres ikke af længde eller polering, men af, hvorvidt den besvarer de spørgsmål, en læser faktisk har, i den rækkefølge, de ville stille dem. En brugbar struktur dækker:
- Hvad den gør — et kort resumé af formålet og omfanget, så læseren kan afgøre i ét afsnit, om de er det rigtige sted.
- Hvad den muliggør — de konkrete kapaciteter og funktioner, ikke bare en gentagelse af koden.
- Hvordan den er bygget — tilstrækkelig arkitekturkontekst (stack, komponenter, afhængigheder) til, at nogen kan ræsonnere om systemet, ikke bare bruge det.
- Hvordan den virker — logikflowet og nøgleoperationer forklaret som en proces frem for en liste af funktionsnavne.
- Hvordan man bruger den — opsætnings-, konfigurations- og brugsanvisninger skrevet til den faktiske læser, ikke til den, der skrev koden.
Det er heller ikke tilfældigt tæt på, hvad en kodeforankret genereringsproces naturligt producerer, da hvert afsnit svarer til et spørgsmål, en rigtig læser stiller, frem for et afsnit, en skribent følte sig forpligtet til at inkludere.
Fra dokumentationsgæld til dokumentationsaktiv
Dokumentationsgæld og dokumentation som aktiv er det samme underliggende materiale – kildekode og institutionel viden – på to forskellige niveauer af vedligeholdelsesomkostninger. I det øjeblik det bliver billigt nok at regenerere et dokument ved hver meningsfuld ændring, begynder den samme information, der før forfaldt til gæld, at vokse til noget, teamet kan regne med.
Begynd at skrive bedre dokumentation med AI og se, hvor meget af din nuværende dokumentationsgæld der reelt bare er et omkostningsproblem, der venter på en hurtigere proces.
For den fulde mekanik bag hvordan den underliggende genereringsproces fungerer, se hvordan man automatisk skriver teknisk dokumentation med AI , og for specifikke dokumentationstyper, som denne tilgang dækker godt, se fem dokumentationstyper AI skriver hurtigere .
