


Toute base de code possède un dossier de documentation qui semblait parfait la semaine de son lancement. Six mois plus tard, la moitié des pages décrivent une version du produit qui n’existe plus, et les fonctionnalités les plus récentes n’ont aucune documentation.
C’est un problème structurel et temporel, et comprendre pourquoi la documentation manuelle se dégrade selon un calendrier prévisible est la première étape pour réellement améliorer la documentation durablement, au lieu de relancer chaque année le même projet de réécriture. Voici pourquoi l’approche traditionnelle de la documentation développeur échoue par construction, et ce qui brise réellement le cycle.
Le problème de la dette documentaire : comment les équipes y arrivent
La dette documentaire fonctionne comme son cousin plus célèbre, la dette technique, sauf qu’elle est plus difficile à voir. Un raccourci dans le code finit par provoquer un bug que quelqu’un devra corriger. Une doc obsolète reste simplement là, tranquillement erronée, et personne ne le remarque avant qu’un nouvel arrivant la suive et casse quelque chose, ou qu’un ticket de support révèle que le guide d’installation décrit un flag déprécié depuis quatre mois.
La trajectoire est presque toujours la même. Au lancement, la documentation est complète parce que l’équipe est motivée et que le périmètre est restreint. Trois mois et cinq versions de fonctionnalités plus tard, deux de ces fonctionnalités ont été documentées, et les trois autres n’existent que dans la tête de ceux qui les ont construites. Au moment où quelqu’un audite la documentation, l’écart entre ce qui est écrit et ce qui est vrai est devenu assez grand pour que le corriger ressemble à un projet plutôt qu’à une habitude.
Ce n’est pas non plus un coût hypothétique. Les recherches de Stack Overflow montrent que la documentation consomme déjà environ 11 % des heures de travail des développeurs, et GetDX estime que les ingénieurs perdent 3 à 10 heures par semaine à chercher une information qui devrait déjà être écrite, des heures qui n’apparaissent sur aucune feuille de route mais qui disparaissent tout autant de la production réelle.
Pourquoi la documentation manuelle prend toujours du retard sur le développement
Les changements de code sont peu coûteux à faire et coûteux à documenter. Un correctif d’une ligne sur un rate limiter peut prendre cinq minutes à écrire et à livrer, mais l’expliquer avec exactitude, ce qui a changé, pourquoi, et ce que cela implique pour quiconque appelle ce endpoint, demande un temps d’écriture réel et ininterrompu qui n’existera pas dans un sprint déjà rempli d’autres engagements.
Chaque commit est un petit point de décision silencieux. Il faut que quelqu’un remarque que le changement mérite d’être documenté, s’en souvienne, puis trouve le temps de le faire. La documentation manuelle dépend de la réalisation systématique de ces trois conditions, pour chaque changement important. Il suffit qu’une seule défaille de temps en temps pour que la dette commence à s’accumuler.
La croyance selon laquelle du code propre devrait être auto-explicatif n’aide pas. Des fonctions bien nommées et une logique claire expliquent ce que fait le code à quelqu’un qui maîtrise déjà la base de code. Elles n’expliquent ni pourquoi, ni pourquoi ce « quoi », ni comment l’utiliser, ni comment il s’insère dans le système global. C’est exactement le type d’information que la documentation manuelle est censée fournir et exactement l’information qui est omise quand le temps manque.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Les 3 causes profondes de docs développeur incomplètes
Sous la plainte générale « notre doc est mauvaise » se cachent trois mécanismes précis et corrigibles :
- La responsabilité est diffuse. Quand la documentation est « la responsabilité de tout le monde », elle n’est en réalité celle de personne. Sans une personne ou un déclencheur précis responsable de la mise à jour d’un document précis, cela retombe sur celui qui remarque par hasard qu’il est erroné, souvent un nouvel arrivant perdu ou un client frustré. En plus de cela, cette approche propage un formatage, une langue et des styles d’écriture incohérents.
- Le coût est asymétrique. Écrire un changement est plus rapide qu’écrire une explication exacte de ce changement pour quelqu’un d’autre. Sous n’importe quelle pression de délai, la tâche qui entre directement en concurrence avec la livraison perd.
- Il n’y a aucun mécanisme de déclenchement. La plupart des équipes ne lient pas la mise à jour de la documentation à un événement concret comme une pull request fusionnée ou une publication de version. Sans ce déclencheur, la documentation n’est traitée que de façon réactive, après qu’un ticket de support ou un échec d’onboarding ait forcé la question, ce qui signifie que le correctif arrive toujours après que le coût a déjà été payé.
Comment l’IA comble l’écart entre le code et la documentation
Un rédacteur de documentation IA s’attaque directement à ces trois causes, parce qu’il modifie l’économie de la tâche au lieu de demander aux gens de se comporter différemment sous les mêmes contraintes.
L’AI Documentation Writer de FlowHunt fonctionne en trois étapes . Il analyse d’abord le code, puis traduit la logique, et enfin structure le document de sortie. Vous fournissez le code source, le langage principal, l’objectif, votre public cible et toute information supplémentaire que vous jugez utile ou que le formulaire demande.
Le document final généré couvre un résumé exécutif, les capacités fonctionnelles, l’architecture technique, le flux logique, les fonctions et composants clés, ainsi que les instructions d’utilisation.
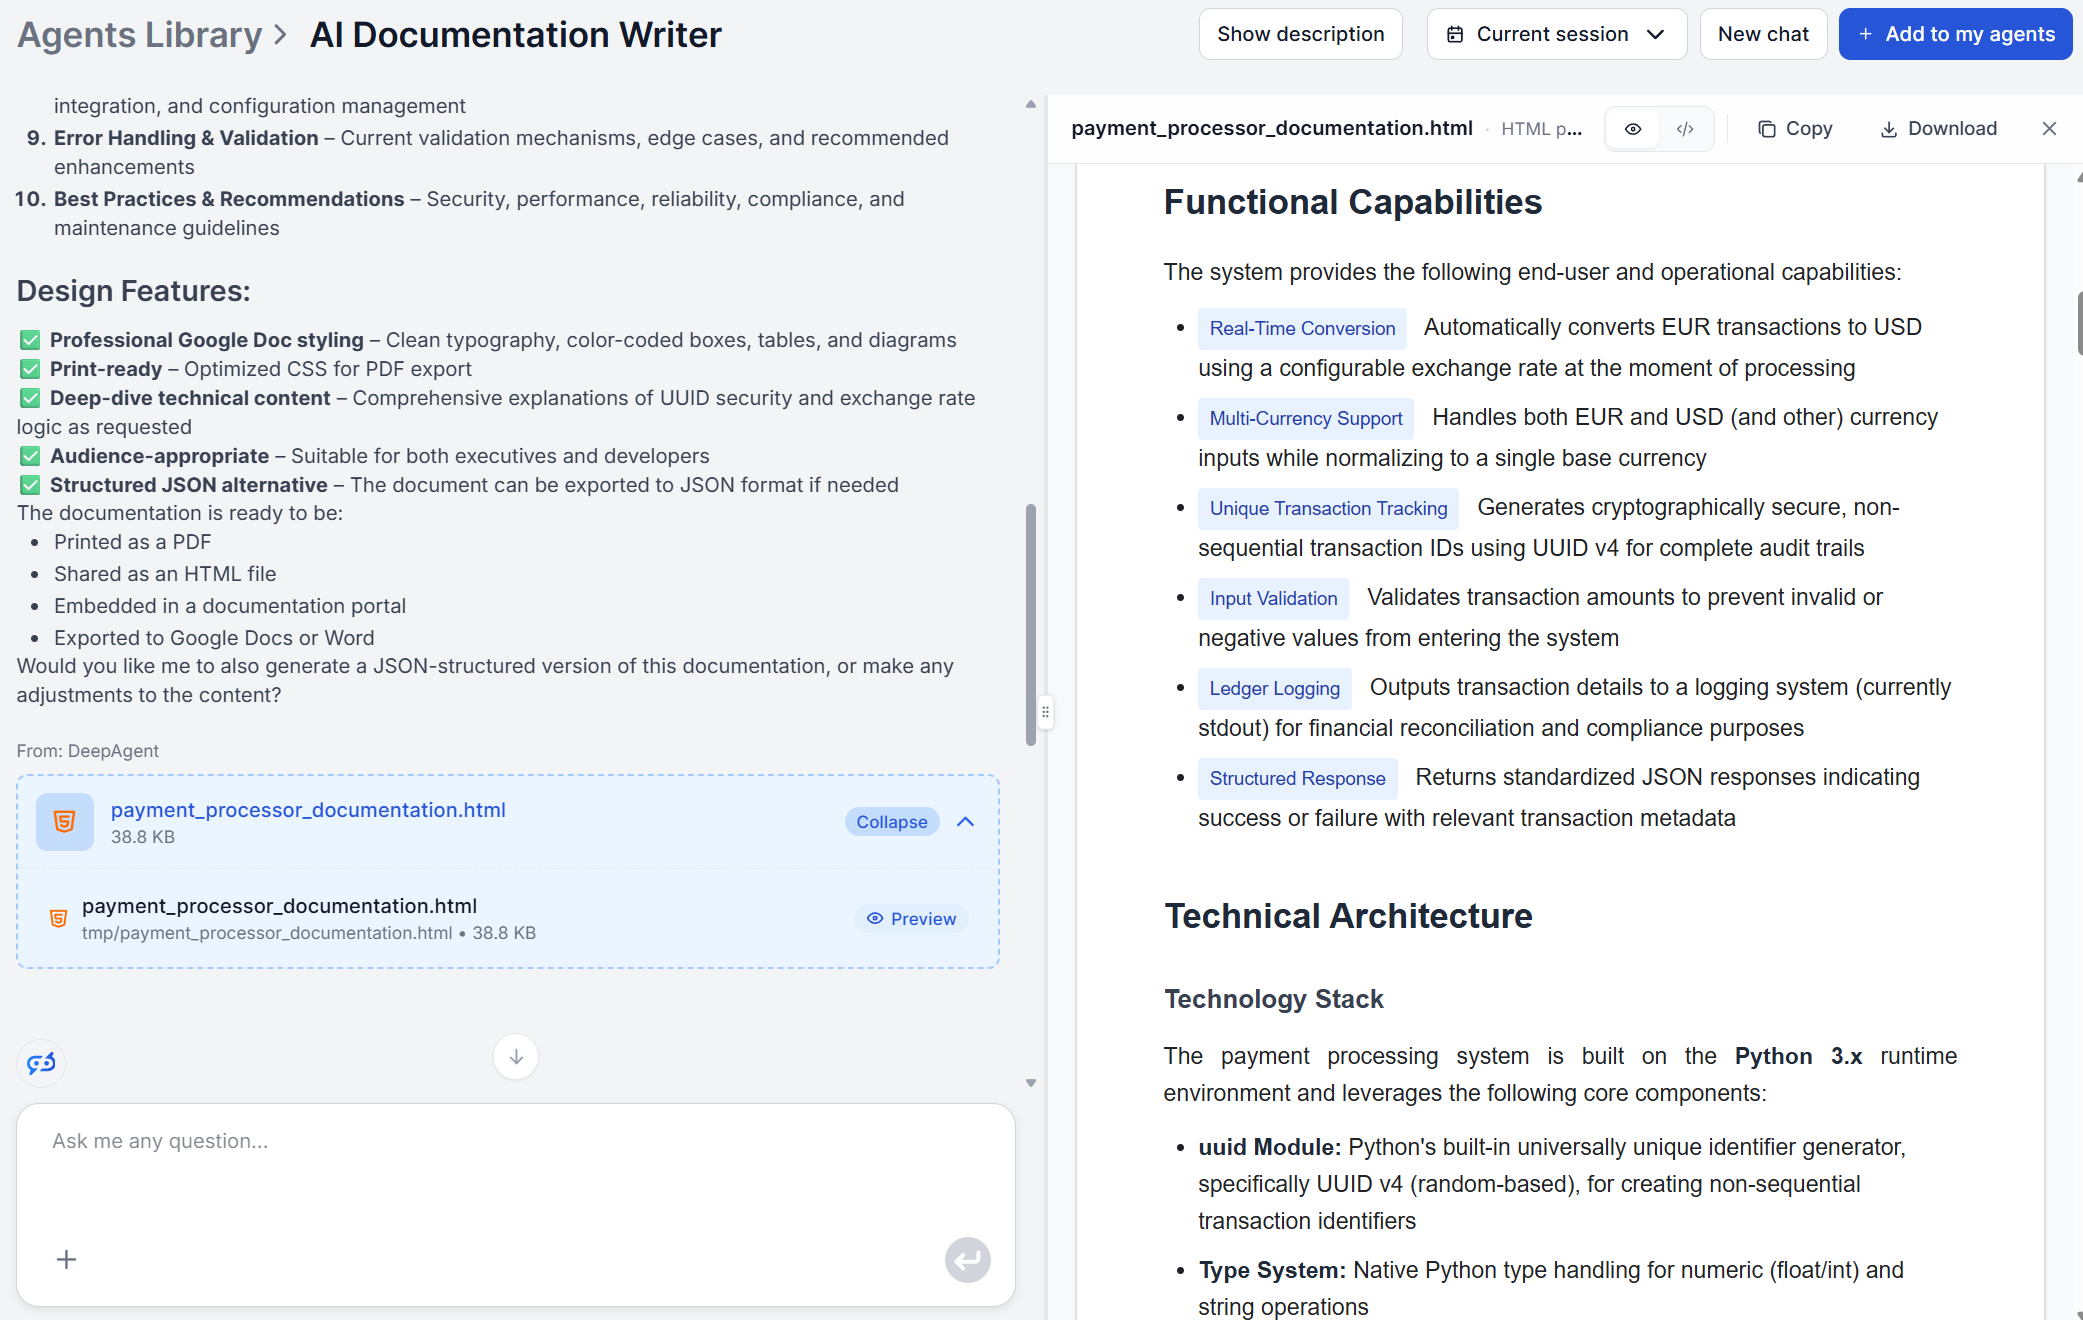
Ce processus corrige directement l’asymétrie des coûts. Si régénérer une documentation exacte à partir du code actuel prend quelques minutes au lieu d’une demi-journée d’écriture soignée, elle cesse de perdre l’arbitrage de priorité face à la livraison de code.
Cela affaiblit aussi le problème de la responsabilité, puisqu’un processus rapide et peu coûteux est réaliste à confier à celui qui fusionne le changement, plutôt que d’exiger l’intervention d’un rédacteur dédié à chaque fois. Retirer aux rédacteurs des tâches petites mais chronophages leur permet aussi d’accorder davantage de soin aux contenus à fort enjeu.
Le mécanisme de déclenchement doit cependant rester délibéré. FlowHunt ne surveille pas votre dépôt de lui-même, mais comme c’est une plateforme d’automatisation de workflows, le flow peut être connecté à un webhook qui se déclenche chaque fois qu’une pull request touchant un module documenté est fusionnée.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Construire un système de documentation qui reste à jour
Un système de documentation qui survit au-delà des premiers mois a besoin de plus qu’une étape de génération rapide. Une boucle viable ressemble à ceci :
Déclencheur. Une pull request fusionnée ou la publication d’une version envoie le code source pertinent au rédacteur de documentation, avec le public et l’objectif définis pour ce type précis de document (une référence d’API, un guide utilisateur, un SOP interne).
Capturer ce qui n’est pas dans le code. Certains contextes n’arrivent jamais dans le code source, par exemple pourquoi un script de déploiement fonctionne de telle manière, ce qui n’existe généralement que sous forme d’explication orale d’un ingénieur. Il est toujours utile d’injecter cette information dans l’outil en plus du code lui-même. L’explication ajoute du contexte et de la profondeur, ce qui garantit un contenu plus humain et plus spécifique.
Recouper le contexte externe quand c’est important. Vérifiez les normes, protocoles ou conventions du secteur qui méritent d’être confrontés à des sources externes. Revérifiez aussi les données propriétaires que vous fournissez à l’IA, car elles peuvent être devenues obsolètes.
Relire avant de publier. Une personne qui connaît le système confirme que les étapes d’installation fonctionnent réellement, vérifie que tout élément hérité que l’IA n’a pas pu déduire du seul code est exact, et s’assure que le résultat se lit correctement pour le public visé.
Redéclencher au changement suivant. Vous pouvez configurer une régénération selon un calendrier ou via un déclencheur personnalisé. Par exemple, vous pouvez faire répéter la boucle à la fusion suivante, ce qui est la meilleure façon de maintenir un écart faible entre le code et la documentation.
À quoi ressemble réellement une bonne documentation développeur
Une bonne documentation ne se définit pas par sa longueur ou son poli, mais par sa capacité à répondre aux questions que le lecteur se pose réellement, dans l’ordre où il les poserait. Une structure utile couvre :
- Ce que ça fait — un court résumé de l’objectif et du périmètre, pour qu’un lecteur sache en un paragraphe s’il est au bon endroit.
- Ce que ça permet — les capacités et fonctionnalités concrètes, pas seulement une reformulation du code.
- Comment c’est construit — assez de contexte d’architecture (stack, composants, dépendances) pour que quelqu’un puisse raisonner sur le système, et pas seulement l’utiliser.
- Comment ça fonctionne — le flux logique et les opérations clés, expliqués comme un processus plutôt qu’une liste de noms de fonctions.
- Comment l’utiliser — les instructions d’installation, de configuration et d’usage écrites pour le véritable lecteur, pas pour celui qui a écrit le code.
C’est aussi, non par hasard, proche de ce que produit naturellement un processus de génération ancré dans le code, puisque chaque section correspond à une question qu’un vrai lecteur se pose plutôt qu’à une section qu’un rédacteur s’est senti obligé d’inclure.
De la dette documentaire à l’actif documentaire
La dette documentaire et la documentation comme actif sont la même matière première, du code source et du savoir institutionnel, à deux niveaux de coût de maintenance différents. Dès l’instant où régénérer un document devient assez peu coûteux pour être fait à chaque changement significatif, la même information qui se dégradait en dette commence à se capitaliser en quelque chose sur quoi l’équipe peut s’appuyer.
Commencez à écrire une meilleure documentation avec l’IA et voyez quelle part de votre dette documentaire actuelle n’est en réalité qu’un problème de coût en attente d’un processus plus rapide.
Pour tous les détails du fonctionnement du processus de génération sous-jacent, consultez comment écrire automatiquement de la documentation technique avec l’IA , et pour les types de documentation spécifiques que cette approche couvre bien, consultez cinq types de documentation que l’IA rédige plus vite .
