


Dokumentation manuell zu schreiben bedeutet, den Code oder den Prozess selbst zu lesen, zu entscheiden, was wichtig ist, und es dann in der Freizeit aufzuschreiben, die nach dem Shipping übrig bleibt.
KI für technische Schreib-Anwendungsfälle entfernt den Zwischenschritt. Statt aus dem Gedächtnis zu beschreiben, was ein System tut, richten Sie die KI auf die tatsächliche Quelle, und sie erzeugt die Erklärung direkt aus der Logik. Alles, was Sie noch tun müssen, ist zu prüfen, ob alles zusammenpasst.
Aber nicht jede Dokumentationsart profitiert gleichermaßen. Manche sind fast reine Code-zu-Erklärung-Übersetzungen, bei denen KI einen klaren Geschwindigkeitsvorteil hat. Andere brauchen mehr menschliche Rahmung um den KI-generierten Kern. Hier sind fünf konkrete Dokumentationsarten, bei denen FlowHunts KI-Dokumentationsautor manuelles Schreiben konstant übertrifft.
Eine Schritt-für-Schritt-Erklärung des Prozesses selbst finden Sie unter wie man technische Dokumentation automatisch mit KI schreibt .
Warum dieses Problem überhaupt existiert, lesen Sie unter warum Entwicklerdokumentation immer unvollständig ist .
Anwendungsfall 1: API-Referenzdokumentation
API-Referenzen sind das, was einem Best-Case-Szenario für einen KI-Generator für API-Dokumentation am nächsten kommt, denn die Quelle der Wahrheit (die Endpoint-Handler, die SDK-Methoden, die Request- und Response-Strukturen) existiert bereits im Code. Es gibt nichts, wozu man einen Entwickler befragen müsste, was nicht schon in den Funktionssignaturen steht.
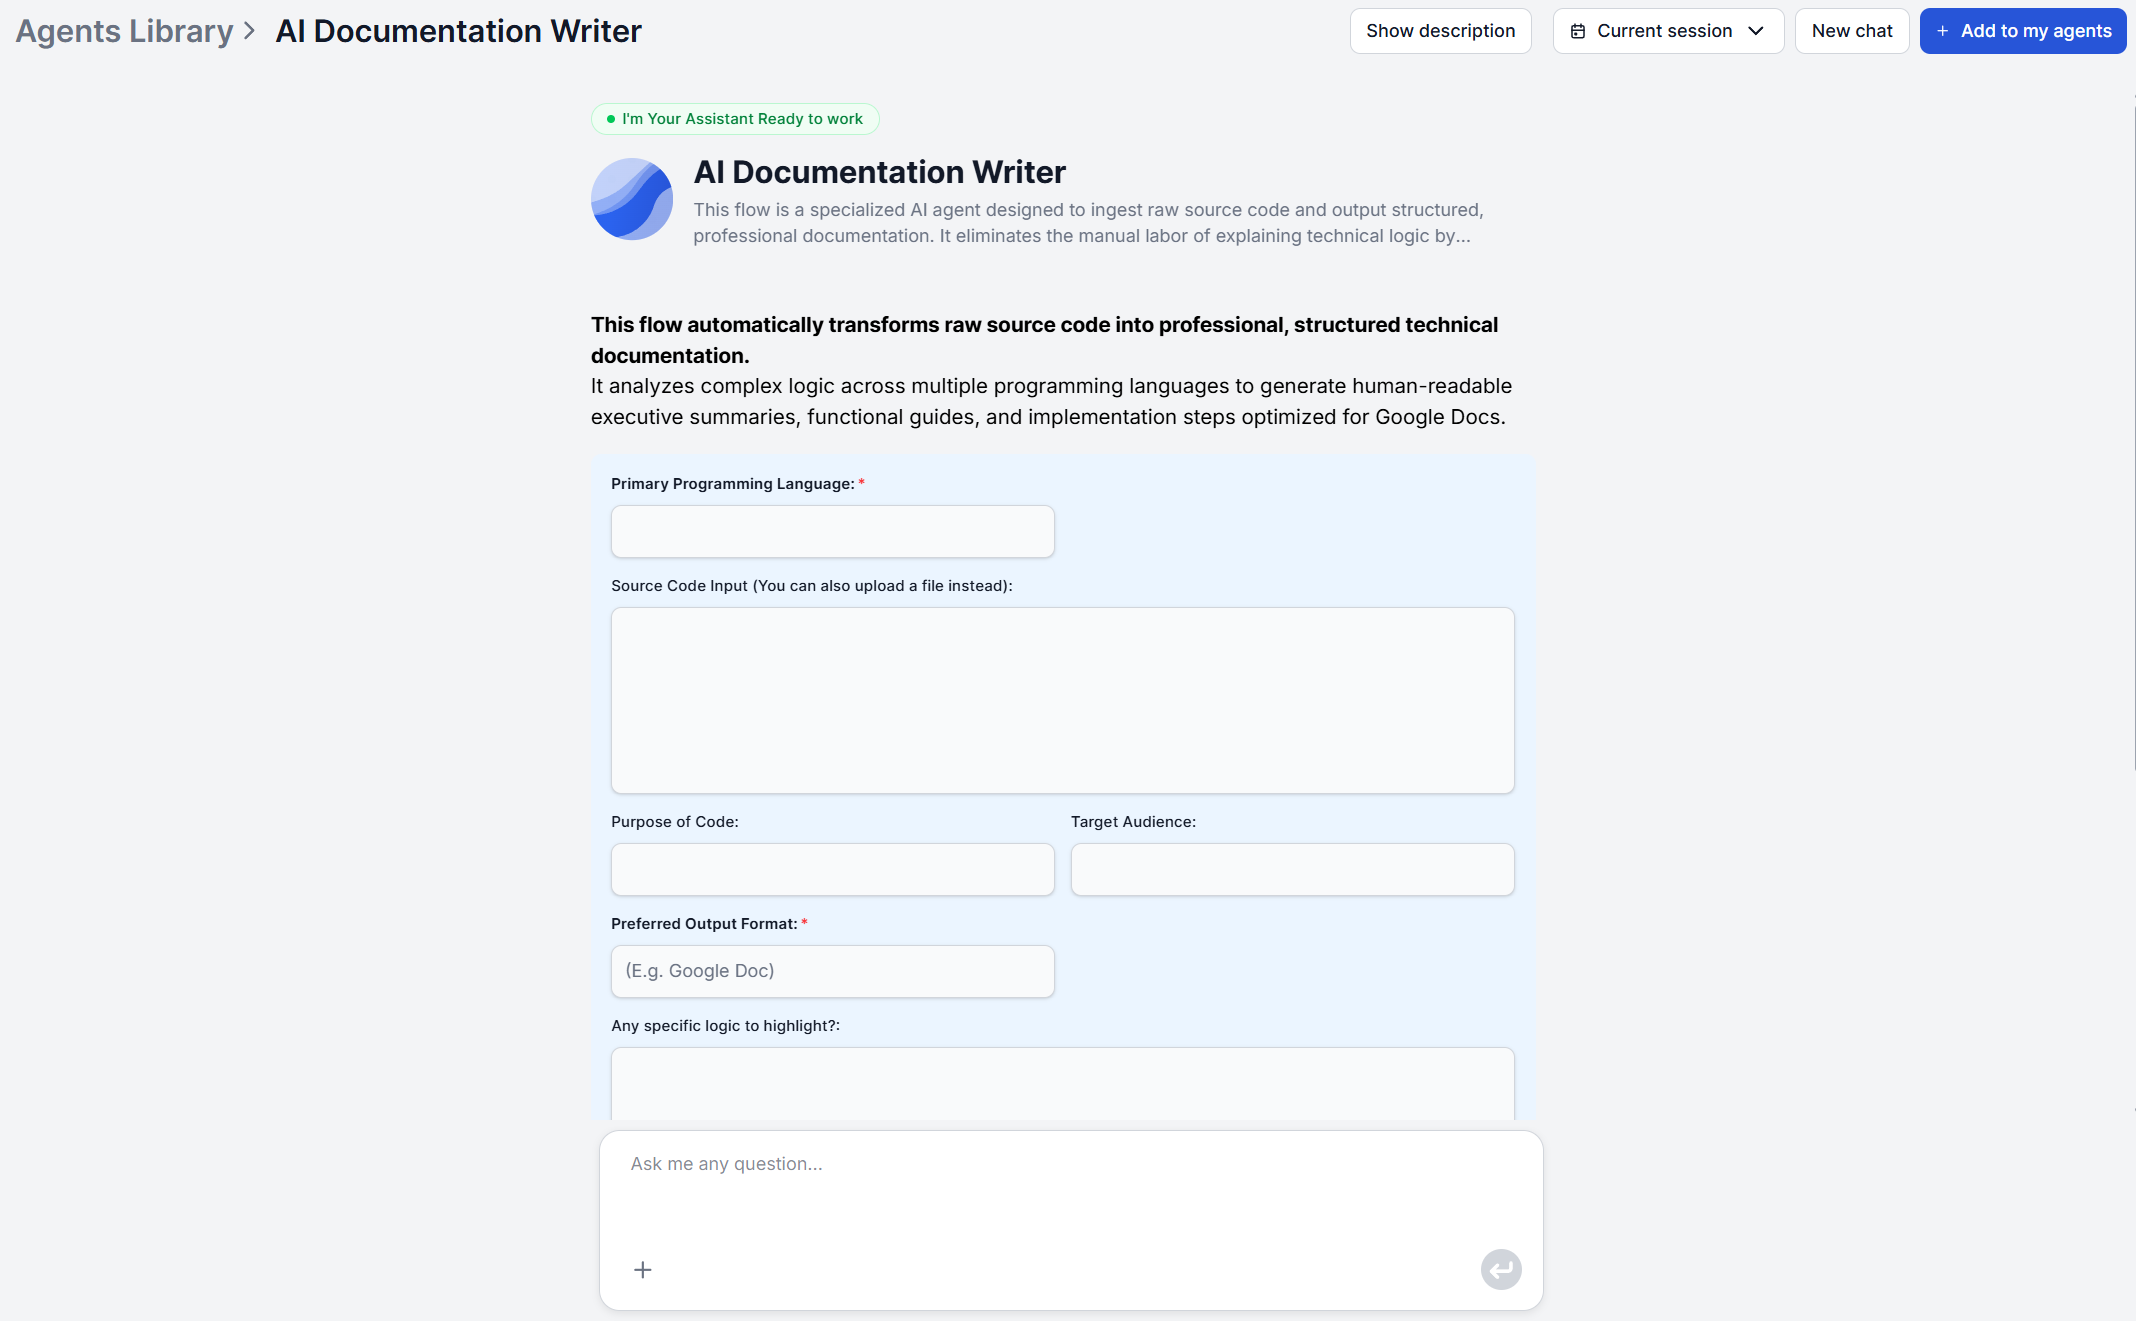
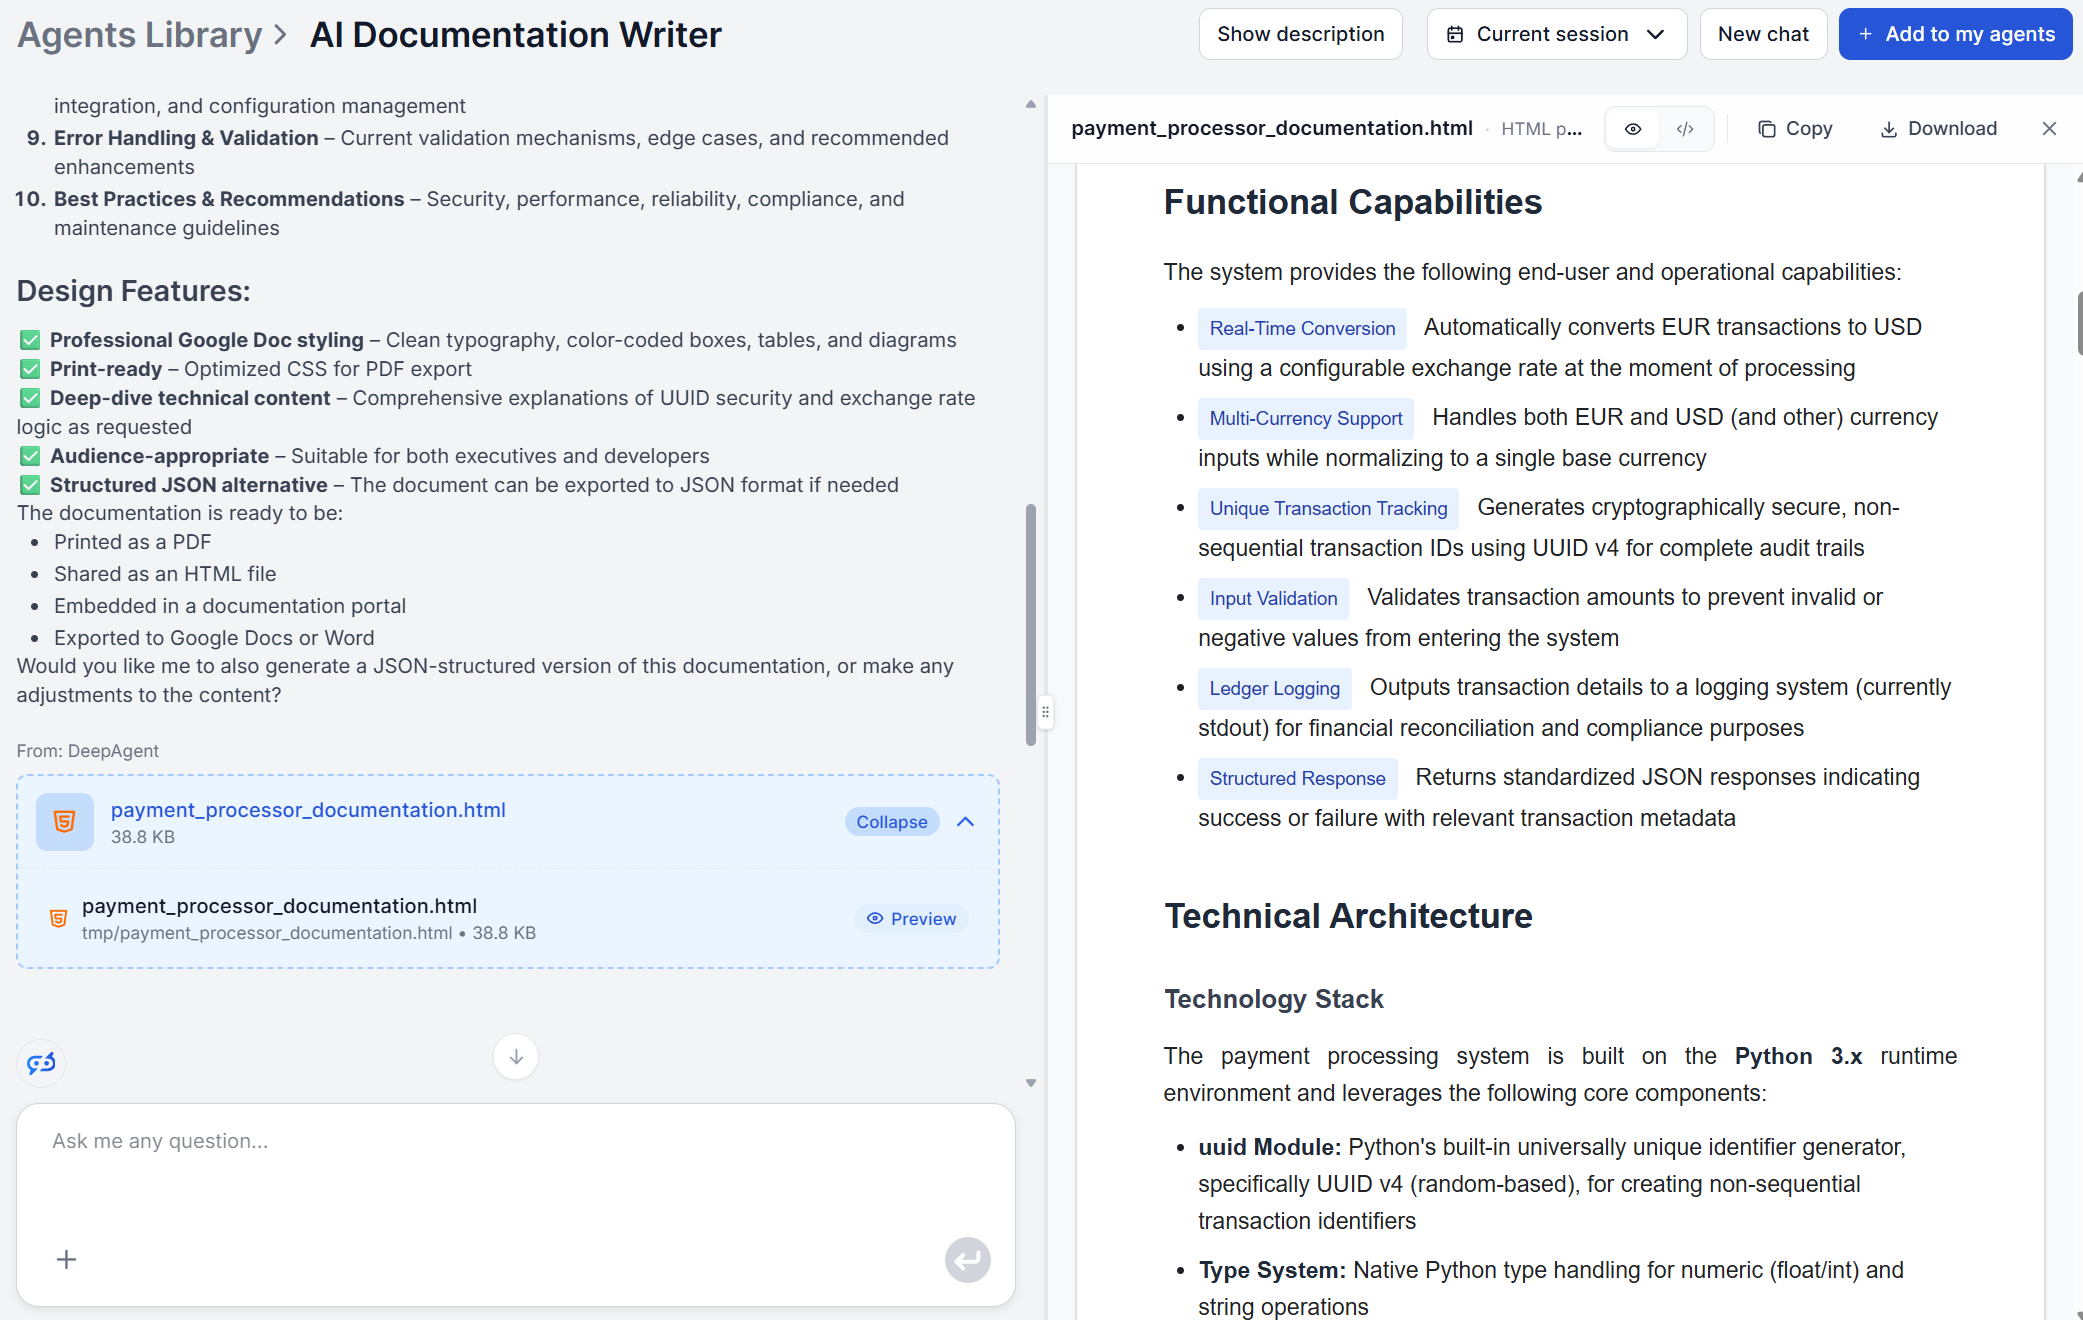
Richten Sie den KI-Dokumentationsautor auf Ihren API-Code oder fügen Sie ihn einfach in den Chat ein, stellen Sie die Zielgruppe auf „Entwickler“ oder „API-Nutzer“ ein und verwenden Sie das Eingabefeld „specific logic to highlight“, um alles leicht Übersehbare zu markieren, das die gebotene Sorgfalt erhalten sollte. Der Abschnitt „Schlüsselfunktionen und Komponenten“ der Ausgabe wird zu einer funktionierenden Referenz, und der Abschnitt zur technischen Architektur behandelt, wie die Teile zusammenpassen.
Der Geschwindigkeitsvorteil summiert sich mit der Zeit. API-Oberflächen ändern sich mit fast jedem Release, ein Parameter kommt hinzu, ein Endpoint wird veraltet, und manuelle Dokumentation bleibt genau bei diesen kleinen, häufigen Änderungen zurück.
Eine Referenz für zwanzig Endpunkte von Hand zu schreiben, ist selbst für einen Entwickler, der die Codebasis gut kennt, eine Aufgabe über mehrere Tage. Die Neugenerierung aus dem aktuellen Code dauert nur wenige Minuten, egal wie oft sich die API seit der letzten Version geändert hat und egal, ob es zwanzig oder zweihundert Endpunkte sind.
Anwendungsfall 2: Produkt-Release-Notes
Release Notes müssen beantworten, was sich geändert hat und warum es wichtig ist. Das entspricht eng zwei Abschnitten, die der Dokumentationsautor bereits erzeugt: der Zusammenfassung für die Geschäftsleitung und der Liste der funktionalen Fähigkeiten.
Setzen Sie den Zweck auf „Release Notes für dieses Update“, die Zielgruppe auf „Kunden“ oder „Endnutzer“ und geben Sie den Code für das jeweilige Feature oder den Fix ein. Die Stufe der Übersetzung in einfache Sprache übernimmt die Arbeit, einen Diff in eine Beschreibung zu verwandeln, die ein nicht-technischer Kunde tatsächlich verstehen kann, ohne dass ein Autor den Ingenieur befragen muss, der es gebaut hat.
Ein leichter Redaktionsdurchgang danach lohnt sich trotzdem. Release Notes brauchen meist eine konsistente Stimme und eine bestimmte Reihenfolge (erst Breaking Changes, dann neue Features, dann Fixes), und obwohl die KI-Ausgabe Ihnen für jeden Punkt korrektes Rohmaterial liefert, ist das Anordnen und Priorisieren für ein kundenorientiertes Changelog eine Ermessensentscheidung, die ein Mensch treffen sollte.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Anwendungsfall 3: Nutzer-Onboarding-Guides
Produktdokumentation mit KI verdient ihren Einsatz bei Onboarding-Guides, die eigentlich nur Beschreibungen realer Konfigurationsschritte, verfügbarer Befehle oder Setup-Anforderungen sind, die bereits im Code stehen. Ein CLI-Tool, ein SDK oder eine interne Anwendung sind alles gute Kandidaten.
Lassen Sie denselben Quellcode durch den Dokumentationsautor laufen, stellen Sie die Zielgruppe aber auf „neue Nutzer“ oder „nicht-technische Stakeholder“ ein. Die Stufe der Logikübersetzung ersetzt Entwicklerterminologie durch einfache Sprache mit natürlichem Fluss, und der Abschnitt zu Implementierungs- und Nutzungshinweisen wird zu den Onboarding-Schritten selbst, die Setup, Konfiguration und erste Nutzung abdecken.
Der Kompromiss, den Sie vorab kennen sollten: Dieser Ansatz dokumentiert, was das Produkt tut und wie man es konfiguriert, nicht warum ein Feature aus Produktmarketing-Sicht existiert. Für Onboarding-Inhalte, die eher erzählerisch als anleitend sind, behandeln Sie die KI-Ausgabe als das akkurate technische Rückgrat und ergänzen Sie Rahmung darum, statt eine fertige, markenkonforme Willkommenssequenz zu erwarten.
Das ist am wichtigsten bei Entwicklertools, wo die erste Stunde eines neuen Nutzers meist mit Installation, Authentifizierung und dem Ausführen eines ersten erfolgreichen Befehls verbracht wird. Diesen Abschnitt direkt aus dem tatsächlichen Setup-Code zu generieren, statt aus der Erinnerung eines Entwicklers daran, wie die Installation funktionieren soll, fängt die kleinen Inkonsistenzen ab (ein umbenanntes Flag, eine verschobene Konfigurationsoption), die Onboarding-Guides innerhalb weniger Releases still und leise falsch machen.
Anwendungsfall 4: Interne SOP- und Prozessdokumentation
Automatisierung interner Dokumente ist hier am wichtigsten, weil interne Prozessdokumentation am schnellsten verfällt. Sie existiert meist als institutionelles Gedächtnis. Ein Senior-Engineer erklärt ein Deployment-Skript oder eine Onboarding-Automatisierung laut, und niemand schreibt es auf, bevor diese Person das Team wechselt oder das Unternehmen verlässt.
Wenn diese Erklärung in einem aufgezeichneten Meeting stattgefunden hat, lassen Sie sie zuerst durch den KI-Generator für Meeting-Berichte laufen, um den Kontext als strukturiertes Protokoll festzuhalten, bevor er verloren geht. Führen Sie dann das eigentliche Skript zusammen mit dem Automatisierungscode in den Dokumentationsautor ein, mit der Zielgruppe neue Engineering-Einstellungen, um das Referenzdokument zu erstellen, das den Weggang der Person übersteht.
Diese Kombination löst zwei verschiedene Probleme gleichzeitig. Der Meeting-Bericht erfasst den informellen Kontext und die Begründung, die nicht im Code stehen (warum der Prozess so funktioniert), während der Dokumentationsautor die akkuraten technischen Details dessen erfasst, was der Code tatsächlich tut.
Zusammen erzeugen diese beiden Agenten die Art von Onboarding-Referenz, der ein neuer Mitarbeiter tatsächlich folgen kann, ohne einen Senior-Engineer in ein weiteres Meeting zu ziehen, um dasselbe Skript ein zweites Mal zu erklären.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Anwendungsfall 5: Wissensdatenbank-Artikel
Kundenorientierte Wissensdatenbank-Artikel brauchen eine akkurate Erklärung, wie sich ein Feature tatsächlich verhält, und eine Formulierung, die dazu passt, wie Kunden bereits über das Problem sprechen. Den ersten Teil übernimmt der Dokumentationsautor direkt: Füttern Sie ihn mit dem Code hinter dem Feature, stellen Sie die Zielgruppe auf „Kunden“ oder „Support-Team“ ein, und die Abschnitte zu funktionalen Fähigkeiten und Nutzungshinweisen werden zum Rückgrat des Artikels.
Der letzte Punkt ist der Teil, der am ehesten übersprungen wird, und genau er entscheidet, ob der Artikel tatsächlich brauchbar ist. Ein KB-Artikel wird von jemandem gelesen, der mitten in einem Problem steckt, nicht von jemandem, der recherchiert, und die Ausgabe des Dokumentationsautors mit sechs Abschnitten ist auf Vollständigkeit ausgelegt, nicht auf Kürze. Alles davon in einen Support-Artikel zu kopieren, begräbt den einen Satz, den ein frustrierter Kunde braucht, unter einer Architekturerklärung, nach der niemand gefragt hat.
Beginnen Sie vor der Veröffentlichung mit einer Antwort in ein oder zwei Sätzen, behalten Sie die Abschnitte zu funktionalen Fähigkeiten und Nutzungshinweisen und lassen Sie technische Architektur sowie Schlüsselfunktionen und Komponenten weg, es sei denn, Ihr Support-Team braucht wirklich Implementierungsdetails.
So pflegen Sie ein lebendiges Dokumentationssystem mit KI
Über alle fünf Anwendungsfälle hinweg ändert sich der zugrunde liegende Prozess nie. Codeanalyse, Logikübersetzung und Dokumentstrukturierung. Was sich ändert, sind nur die Zielgruppe, der Zweck und die spezifische Logik, die Sie für jeden Durchlauf angeben. Das sollte man bewusst behandeln, statt die Eingabe jedes Mal neu zu erfinden.
Es lohnt sich, pro Dokumentationsart eine kurze, gespeicherte Eingabevorlage zu pflegen: eine für API-Referenzen (Zielgruppe: Entwickler), eine für Release Notes (Zielgruppe: Kunden), eine für Onboarding-Guides (Zielgruppe: neue Nutzer), eine für interne SOPs (Zielgruppe: neue Mitarbeiter) und eine für Wissensdatenbank-Artikel (Zielgruppe: Support-Team). Dieselbe Formulierung jedes Mal wiederzuverwenden, hält den Ton über Dutzende generierte Dokumente hinweg konsistent, obwohl jedes einzeln erzeugt wird.
Für Teams mit mehr als einem Produkt: Teilen Sie jedes Produkt in einen eigenen FlowHunt-Workspace auf, verbinden Sie die relevanten Tools und bauen Sie eine Wissensdatenbank, die speziell auf dieses Produkt zugeschnitten ist. Den Kontext jedes Produkts getrennt zu halten, erzeugt bei jedem Durchlauf fokussiertere Ausgaben und verhindert, dass Terminologie oder Konventionen eines Produkts in die Dokumentation eines anderen sickern. Und weil die Neugenerierung schnell ist, binden Sie sie an einen echten Auslöser – ein Release, einen gemergten Pull Request, der ein dokumentiertes Modul berührt – statt an einen geplanten Dokumentations-Sprint, der mit allem anderen auf der Roadmap konkurriert und meist verliert.
Testen Sie den KI-Dokumentationsautor mit der 7-tägigen kostenlosen Testversion (5 Credits inklusive), bevor Sie sich für einen bezahlten Plan entscheiden, und sehen Sie, welcher dieser fünf Anwendungsfälle Ihrem Team zuerst die meiste Zeit spart.
