


Ogni codebase ha una cartella di documentazione che sembrava perfetta la settimana del lancio. Sei mesi dopo, metà delle pagine descrivono una versione del prodotto che non esiste più, e le funzionalità più recenti non hanno alcuna documentazione.
È una questione strutturale e di tempo, e capire perché la documentazione manuale degrada secondo un calendario prevedibile è il primo passo per migliorare davvero la documentazione in modo definitivo, invece di ripetere ogni anno lo stesso progetto di riscrittura. Ecco perché l’approccio tradizionale alla documentazione per sviluppatori fallisce per come è progettato, e cosa rompe davvero il ciclo.
Il problema del debito di documentazione: come ci arrivano i team
Il debito di documentazione funziona come il suo cugino più famoso, il debito tecnico, solo che è più difficile da vedere. Una scorciatoia nel codice prima o poi causa un bug che qualcuno deve correggere. Un documento obsoleto se ne sta lì tranquillo a essere sbagliato, e nessuno se ne accorge finché un nuovo assunto non lo segue e rompe qualcosa, o finché un ticket di assistenza non rivela che la guida di configurazione descrive un flag deprecato da quattro mesi.
L’arco è quasi sempre lo stesso. Al lancio, la documentazione è accurata perché il team è motivato e la superficie è piccola. Tre mesi e cinque release di funzionalità dopo, due di quelle funzionalità sono state documentate, e le altre tre esistono solo nella testa di chi le ha costruite. Quando qualcuno fa un audit dei documenti, il divario tra ciò che è scritto e ciò che è vero è cresciuto abbastanza da far sembrare la correzione un progetto invece che un’abitudine.
Non è nemmeno un costo ipotetico. La ricerca di Stack Overflow ha rilevato che la documentazione consuma già circa l'11% delle ore di lavoro degli sviluppatori, e GetDX stima che gli ingegneri perdano 3-10 ore a settimana a cercare informazioni che dovrebbero già essere scritte, ore che non compaiono in nessuna roadmap ma spariscono comunque dall’output reale.
Perché la documentazione manuale resta sempre indietro rispetto allo sviluppo
Le modifiche al codice sono economiche da fare e costose da documentare. Una correzione di una riga a un rate limiter può richiedere cinque minuti per essere scritta e rilasciata, ma spiegarla con precisione, cosa è cambiato, perché e cosa significa per chiunque chiami quell’endpoint, richiede tempo di scrittura reale e senza interruzioni che non esisterà in uno sprint già pieno di altri impegni.
Ogni commit è un piccolo, silenzioso punto decisionale. Qualcuno deve accorgersi che il cambiamento è abbastanza importante da documentarlo, ricordarlo, e poi trovare il tempo per farlo. La documentazione manuale dipende dal fatto che tutte e tre queste cose accadano con costanza, per ogni cambiamento che conta. Basta che una sola fallisca ogni tanto, e il debito inizia ad accumularsi.
La convinzione che il codice pulito debba essere autoesplicativo non aiuta. Funzioni ben nominate e logica chiara spiegano cosa fa il codice a chi è già fluente nel codebase. Non spiegano perché, né perché questo cosa, come usarlo, o come si inserisce nel sistema più ampio. È esattamente il tipo di informazione che la documentazione manuale dovrebbe fornire ed esattamente l’informazione che viene saltata quando il tempo è poco.

Pronto a far crescere il tuo business?
Inizia oggi la tua prova gratuita e vedi i risultati in pochi giorni.
Le 3 cause profonde di una documentazione per sviluppatori incompleta
Dietro la lamentela generica “la nostra documentazione è scarsa” ci sono tre meccanismi specifici e risolvibili:
- La proprietà è diffusa. Quando la documentazione è “responsabilità di tutti”, di fatto non è di nessuno. Senza una persona specifica o un trigger responsabile dell’aggiornamento di uno specifico documento, la responsabilità ricade su chiunque si accorga che è sbagliato, che spesso è un nuovo assunto confuso o un cliente frustrato. In più, questo approccio propaga formattazione, linguaggio e stili di scrittura incoerenti.
- Il costo è asimmetrico. Scrivere una modifica è più veloce che scrivere una spiegazione accurata di quella modifica per qualcun altro. Sotto qualsiasi pressione di scadenza, il compito che compete direttamente con il rilascio perde.
- Non c’è un meccanismo di attivazione. La maggior parte dei team non lega l’aggiornamento della documentazione a un evento concreto come una pull request unita o una release. Senza quel trigger, la documentazione viene affrontata solo in modo reattivo, dopo che un ticket di assistenza o un fallimento nell’onboarding ha forzato la questione, il che significa che la correzione arriva sempre dopo che il costo è già stato pagato.
Come l’IA colma il divario tra codice e documentazione
Un AI documentation writer affronta direttamente queste tre cause, perché cambia l’economia invece di chiedere alle persone di comportarsi diversamente con gli stessi vincoli.
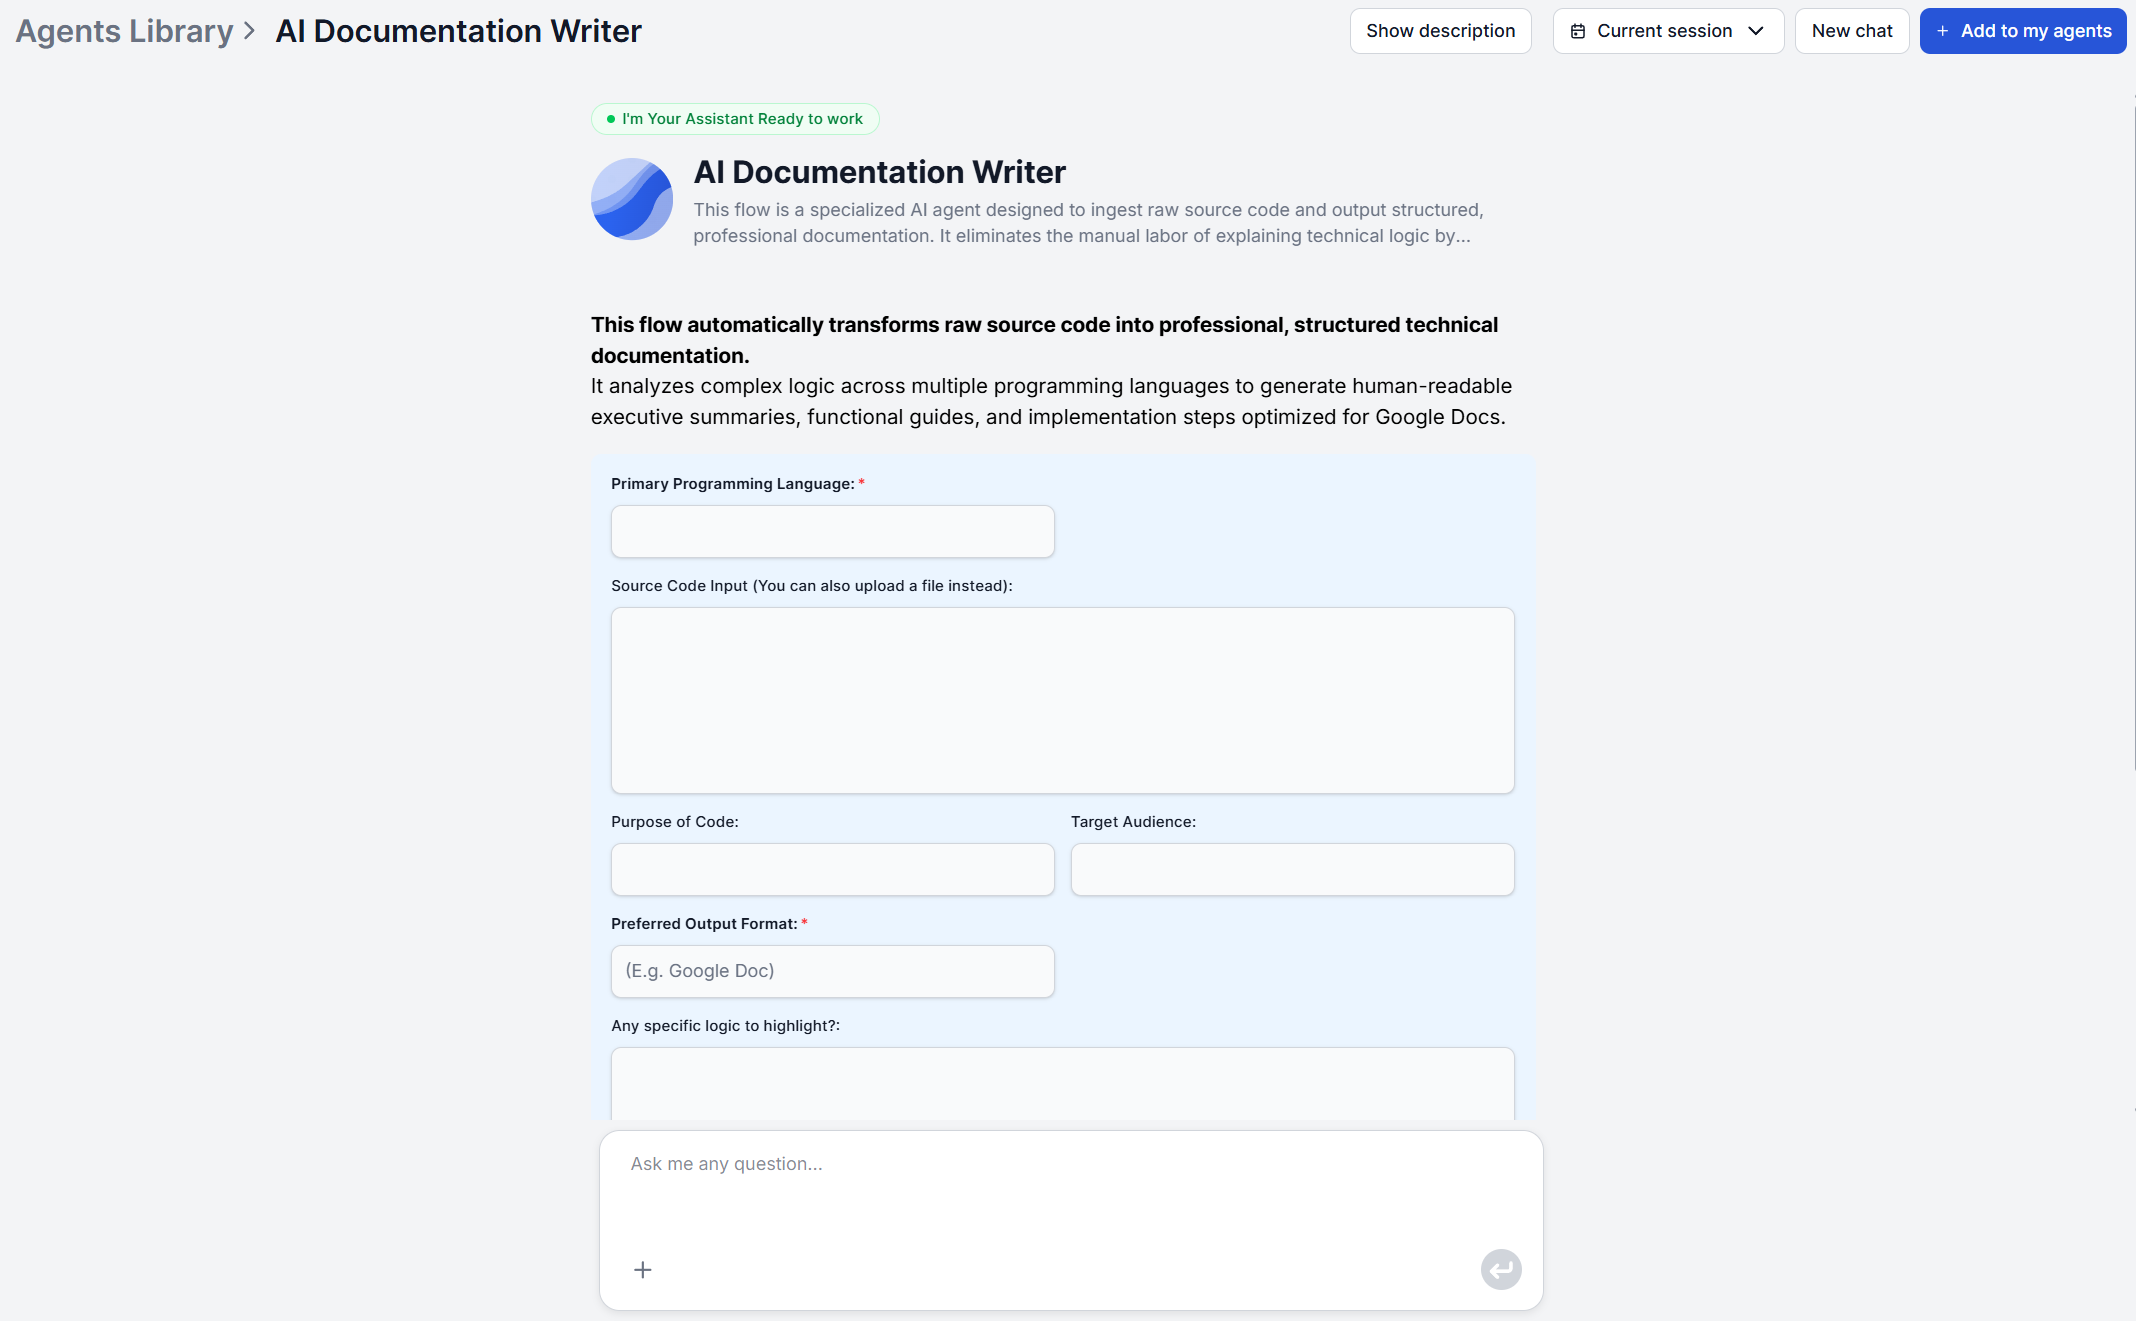
L’AI Documentation Writer di FlowHunt funziona in tre fasi . Prima analizza il codice, poi traduce la logica e infine struttura il documento di output. Fornisci il codice sorgente, il linguaggio principale, lo scopo, il pubblico di destinazione e qualsiasi informazione aggiuntiva che ritieni opportuna o che il modulo richiede.
Il documento finale generato copre un riepilogo esecutivo, le capacità funzionali, l’architettura tecnica, il flusso logico, le funzioni e i componenti chiave e le istruzioni d’uso.
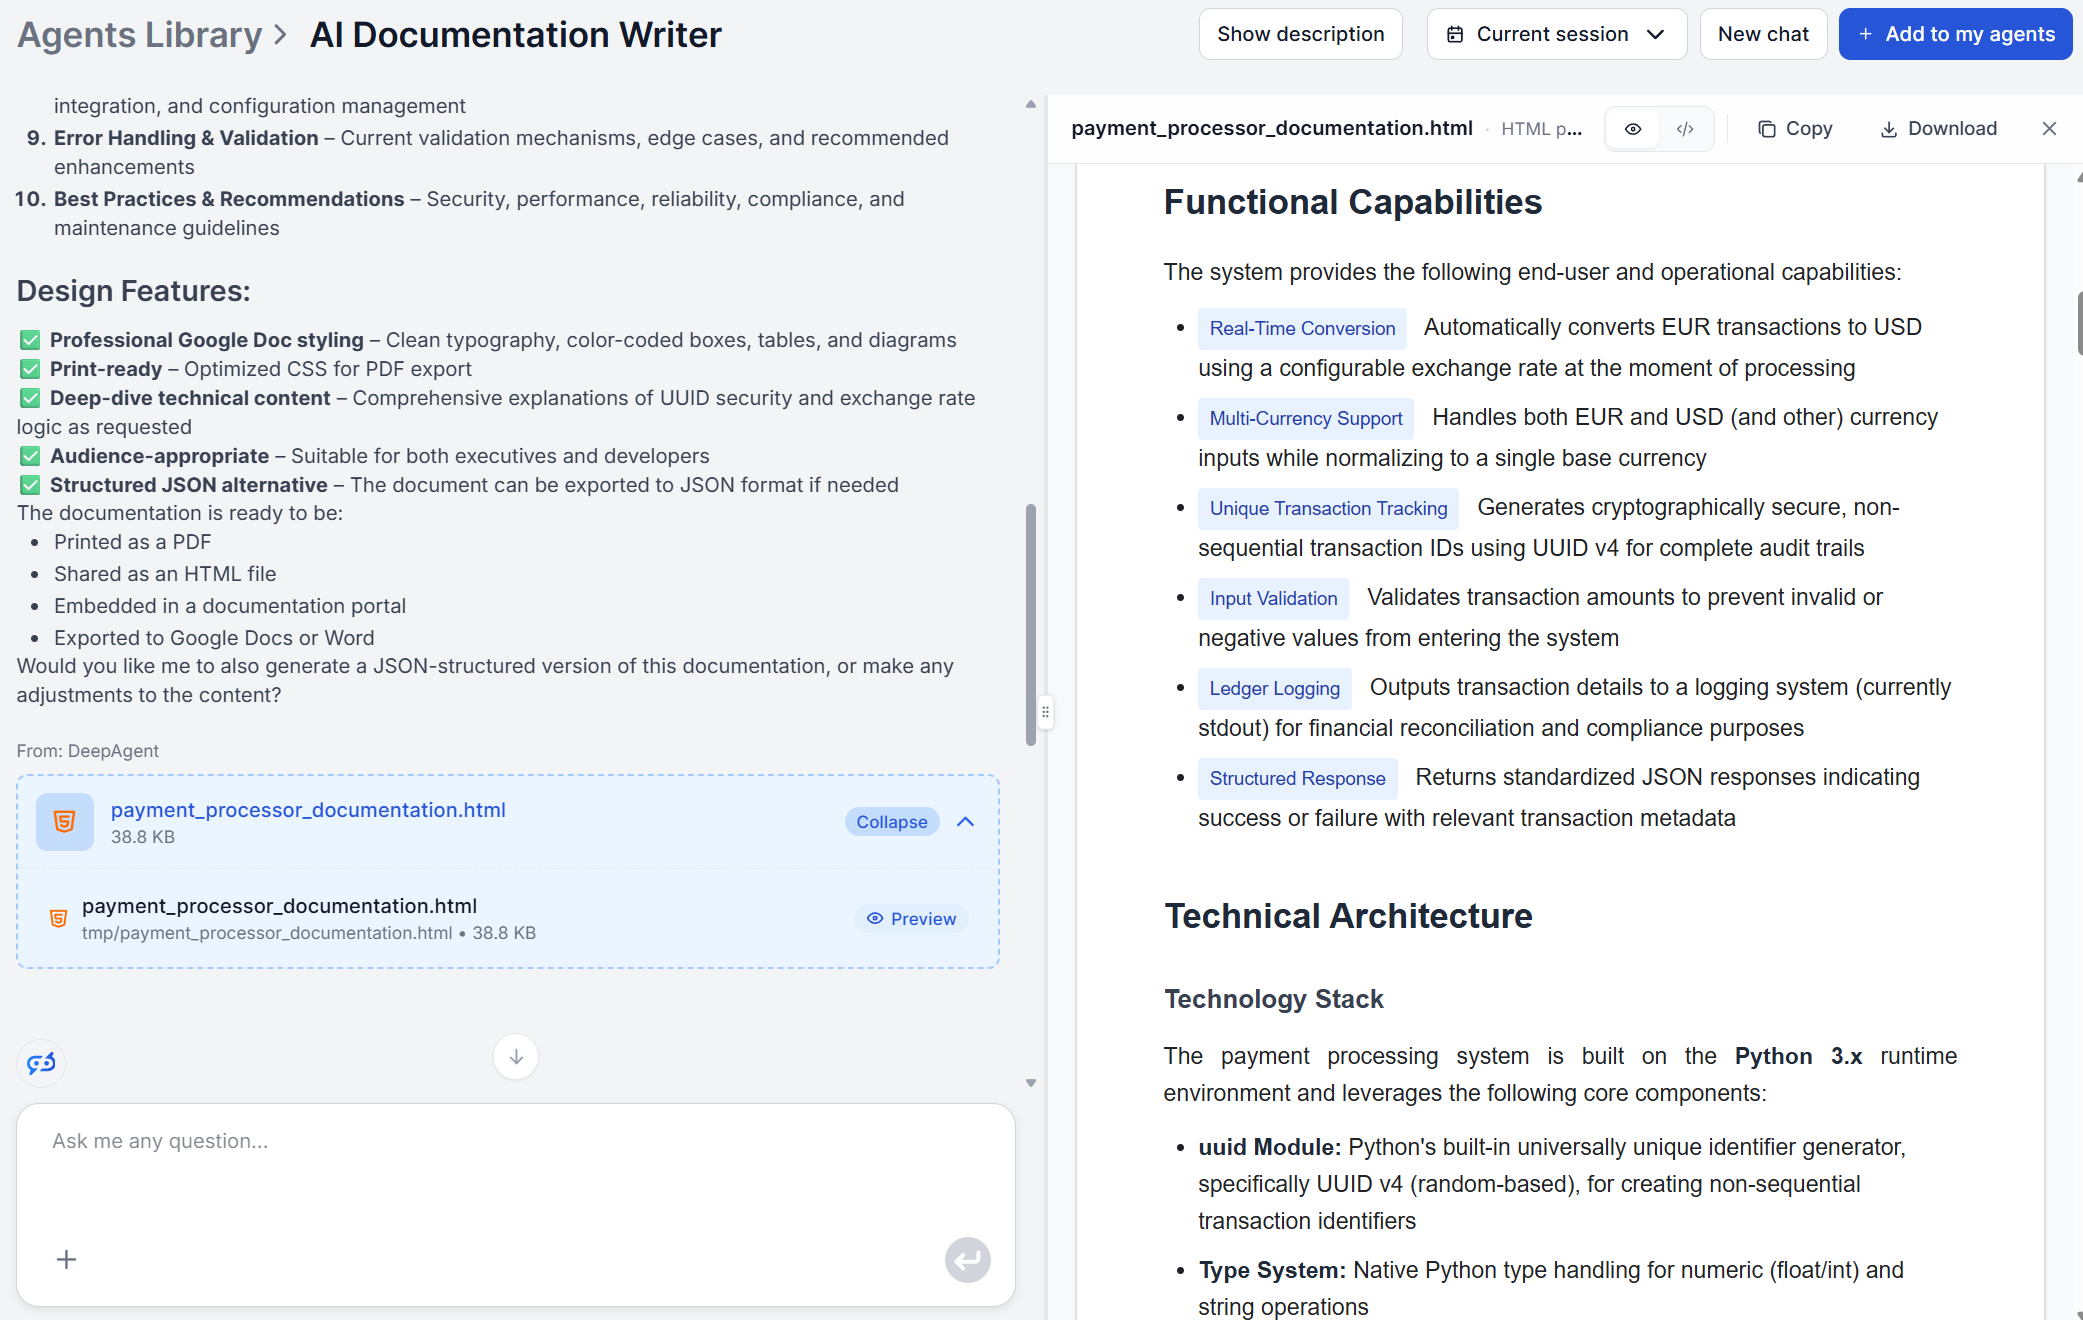
Quel processo risolve direttamente l’asimmetria dei costi. Se rigenerare una documentazione accurata dal codice attuale richiede pochi minuti invece di mezza giornata di scrittura attenta, smette di perdere la lotta di priorità contro il rilascio del codice.
Indebolisce anche il problema della proprietà, dato che un processo rapido e a basso sforzo è realistico da assegnare a chiunque unisca la modifica, invece di richiedere che un writer dedicato venga coinvolto ogni volta. Togliere ai writer compiti piccoli ma dispendiosi in termini di tempo permette loro anche di dedicare maggiore cura ai contenuti ad alto valore.
Il meccanismo di attivazione deve comunque essere deliberato. FlowHunt non osserva il tuo repository da solo, ma poiché è una piattaforma di automazione dei workflow, il flow può essere collegato a un webhook che si attiva ogni volta che viene unita una pull request che tocca un modulo documentato.
Iscriviti alla nostra newsletter
Ricevi gratuitamente gli ultimi consigli, tendenze e offerte.
Costruire un sistema di documentazione che resta aggiornato
Un sistema di documentazione che sopravvive oltre i primi mesi ha bisogno di più di una fase di generazione rapida. Un ciclo praticabile è questo:
Attivazione. Una pull request unita o il taglio di una release invia il codice sorgente rilevante al documentation writer, con pubblico e scopo impostati per quel tipo specifico di documento (un riferimento API, una guida utente, una SOP interna).
Cattura ciò che non è nel codice. Alcuni contesti non arrivano mai nel codice sorgente, come il motivo per cui uno script di deployment funziona in un certo modo, che di solito esiste solo come spiegazione orale di un ingegnere. Aiuta sempre fornire queste informazioni allo strumento insieme al codice stesso. La spiegazione aggiunge più contesto e profondità, garantendo che venga prodotto un contenuto più umano e specifico.
Verifica incrociata del contesto esterno quando conta. Controlla qualsiasi standard di settore, protocollo o convenzione che valga la pena verificare rispetto a fonti esterne. Ricontrolla anche i dati proprietari che stai dando all’IA, perché potrebbero essere diventati obsoleti.
Revisione prima della pubblicazione. Una persona che conosce il sistema conferma che i passaggi di configurazione funzionino davvero, verifica che qualsiasi componente legacy che l’IA non ha potuto dedurre dal solo codice sia accurato e controlla che l’output si legga correttamente per il pubblico previsto.
Riattiva al cambiamento successivo. Puoi impostare la rigenerazione secondo una pianificazione o tramite un trigger personalizzato. Per esempio, puoi far ripetere il ciclo alla successiva unione, che è il modo migliore per mantenere piccolo il divario tra codice e documentazione.
Come appare davvero una buona documentazione per sviluppatori
La buona documentazione non è definita dalla lunghezza o dalla rifinitura, è definita dal fatto che risponda alle domande che un lettore ha davvero, nell’ordine in cui le porrebbe. Una struttura utile copre:
- Cosa fa — un breve riassunto dello scopo e dell’ambito, così un lettore può capire in un paragrafo se è nel posto giusto.
- Cosa abilita — le capacità e le funzionalità concrete, non solo una ripetizione del codice.
- Come è costruito — abbastanza contesto architetturale (stack, componenti, dipendenze) perché qualcuno possa ragionare sul sistema, non solo usarlo.
- Come funziona — il flusso logico e le operazioni chiave, spiegati come un processo invece che come un elenco di nomi di funzioni.
- Come usarlo — istruzioni di configurazione, impostazione e utilizzo scritte per chi è il lettore reale, non per chi ha scritto il codice.
Questo, non a caso, è anche vicino a ciò che produce naturalmente un processo di generazione basato sul codice, dato che ogni sezione corrisponde a una domanda che un lettore reale pone, invece che a una sezione che un writer si è sentito obbligato a includere.
Dal debito di documentazione all’asset di documentazione
Il debito di documentazione e la documentazione come asset sono lo stesso materiale di fondo, codice sorgente e conoscenza istituzionale, a due diversi livelli di costo di manutenzione. Nel momento in cui rigenerare un documento diventa abbastanza economico da farlo a ogni cambiamento significativo, le stesse informazioni che prima si degradavano in debito iniziano a comporsi in qualcosa su cui il team può contare.
Inizia a scrivere documentazione migliore con l’IA e scopri quanto del tuo attuale debito di documentazione è in realtà solo un problema di costi in attesa di un processo più veloce.
Per la meccanica completa di come funziona il processo di generazione sottostante, vedi come scrivere documentazione tecnica automaticamente con l’IA , e per i tipi specifici di documentazione che questo approccio copre bene, vedi cinque tipi di documentazione che l’IA scrive più velocemente .
