


El equipo de soporte medio dedica una parte desproporcionada de su semana a responder el mismo puñado de preguntas. En una encuesta a responsables de atención al cliente de Norteamérica realizada por DigitalGenius y Canam Research , el 80% afirmó que el 20% o más de los tickets de su equipo son repetitivos, aunque fáciles de resolver. Cada hora que un agente dedica a “cómo restablezco mi contraseña” es una hora que no dedica al problema complejo que realmente necesitaba el criterio de una persona. Aquí te explicamos cómo reducir el volumen de tickets de soporte con IA eliminando esa capa repetitiva y qué significa para tu equipo.
El problema de la composición de los tickets: a dónde va realmente el tiempo de soporte
La mayoría de los equipos de soporte no tienen tanto un problema de visibilidad como un problema de atención. Los tickets que menos criterio requieren para resolverse, como los restablecimientos de contraseña, “dónde está mi pedido”, preguntas básicas de facturación o diferencias entre planes, llegan con el mismo volumen, o superior, que los complejos. Cada uno sigue costando un cambio de contexto completo: leer el ticket, reconocer la rutina, extraer la misma respuesta de la memoria o de un artículo de ayuda y responder.
Esa cifra del 80% de responsables y el 20% de tickets de la encuesta de DigitalGenius/Canam es un suelo, no un techo. Muchos equipos informan de que la proporción de repetitivos es bastante mayor. El problema se agrava porque es invisible en la mayoría de los paneles de tickets.
Las 20 preguntas que consumen el 80% de la capacidad de soporte
En la mayoría de las colas de soporte de SaaS y comercio electrónico, un pequeño conjunto de categorías concentra el grueso de la capa “repetitiva”:
- Restablecimientos de contraseña y problemas de acceso a la cuenta
- Estado de los pedidos y plazos de envío
- Preguntas de facturación y diferencias de plan o de precios
- Preguntas sobre políticas de devoluciones y reembolsos
- Preguntas del tipo “cómo hago X” ya cubiertas en el centro de ayuda
- Pasos básicos de solución de problemas que están documentados pero que los clientes no encontraron
Todas estas categorías solo necesitan que la información correcta se entregue rápido y de forma consistente, sin más reflexión ni una decisión humana. Eso es exactamente lo que un chatbot anclado al conocimiento hace bien. Ofrece las respuestas simples, aburridas y claras de forma consistente y a escala, sin invertir la misma cantidad de tiempo y esfuerzo en cambiar de contexto, buscar o redactar una respuesta como lo haría una persona.

¿Listo para hacer crecer tu negocio?
Comienza tu prueba gratuita hoy y ve resultados en días.
Cómo gestionan los chatbots con IA la capa repetitiva
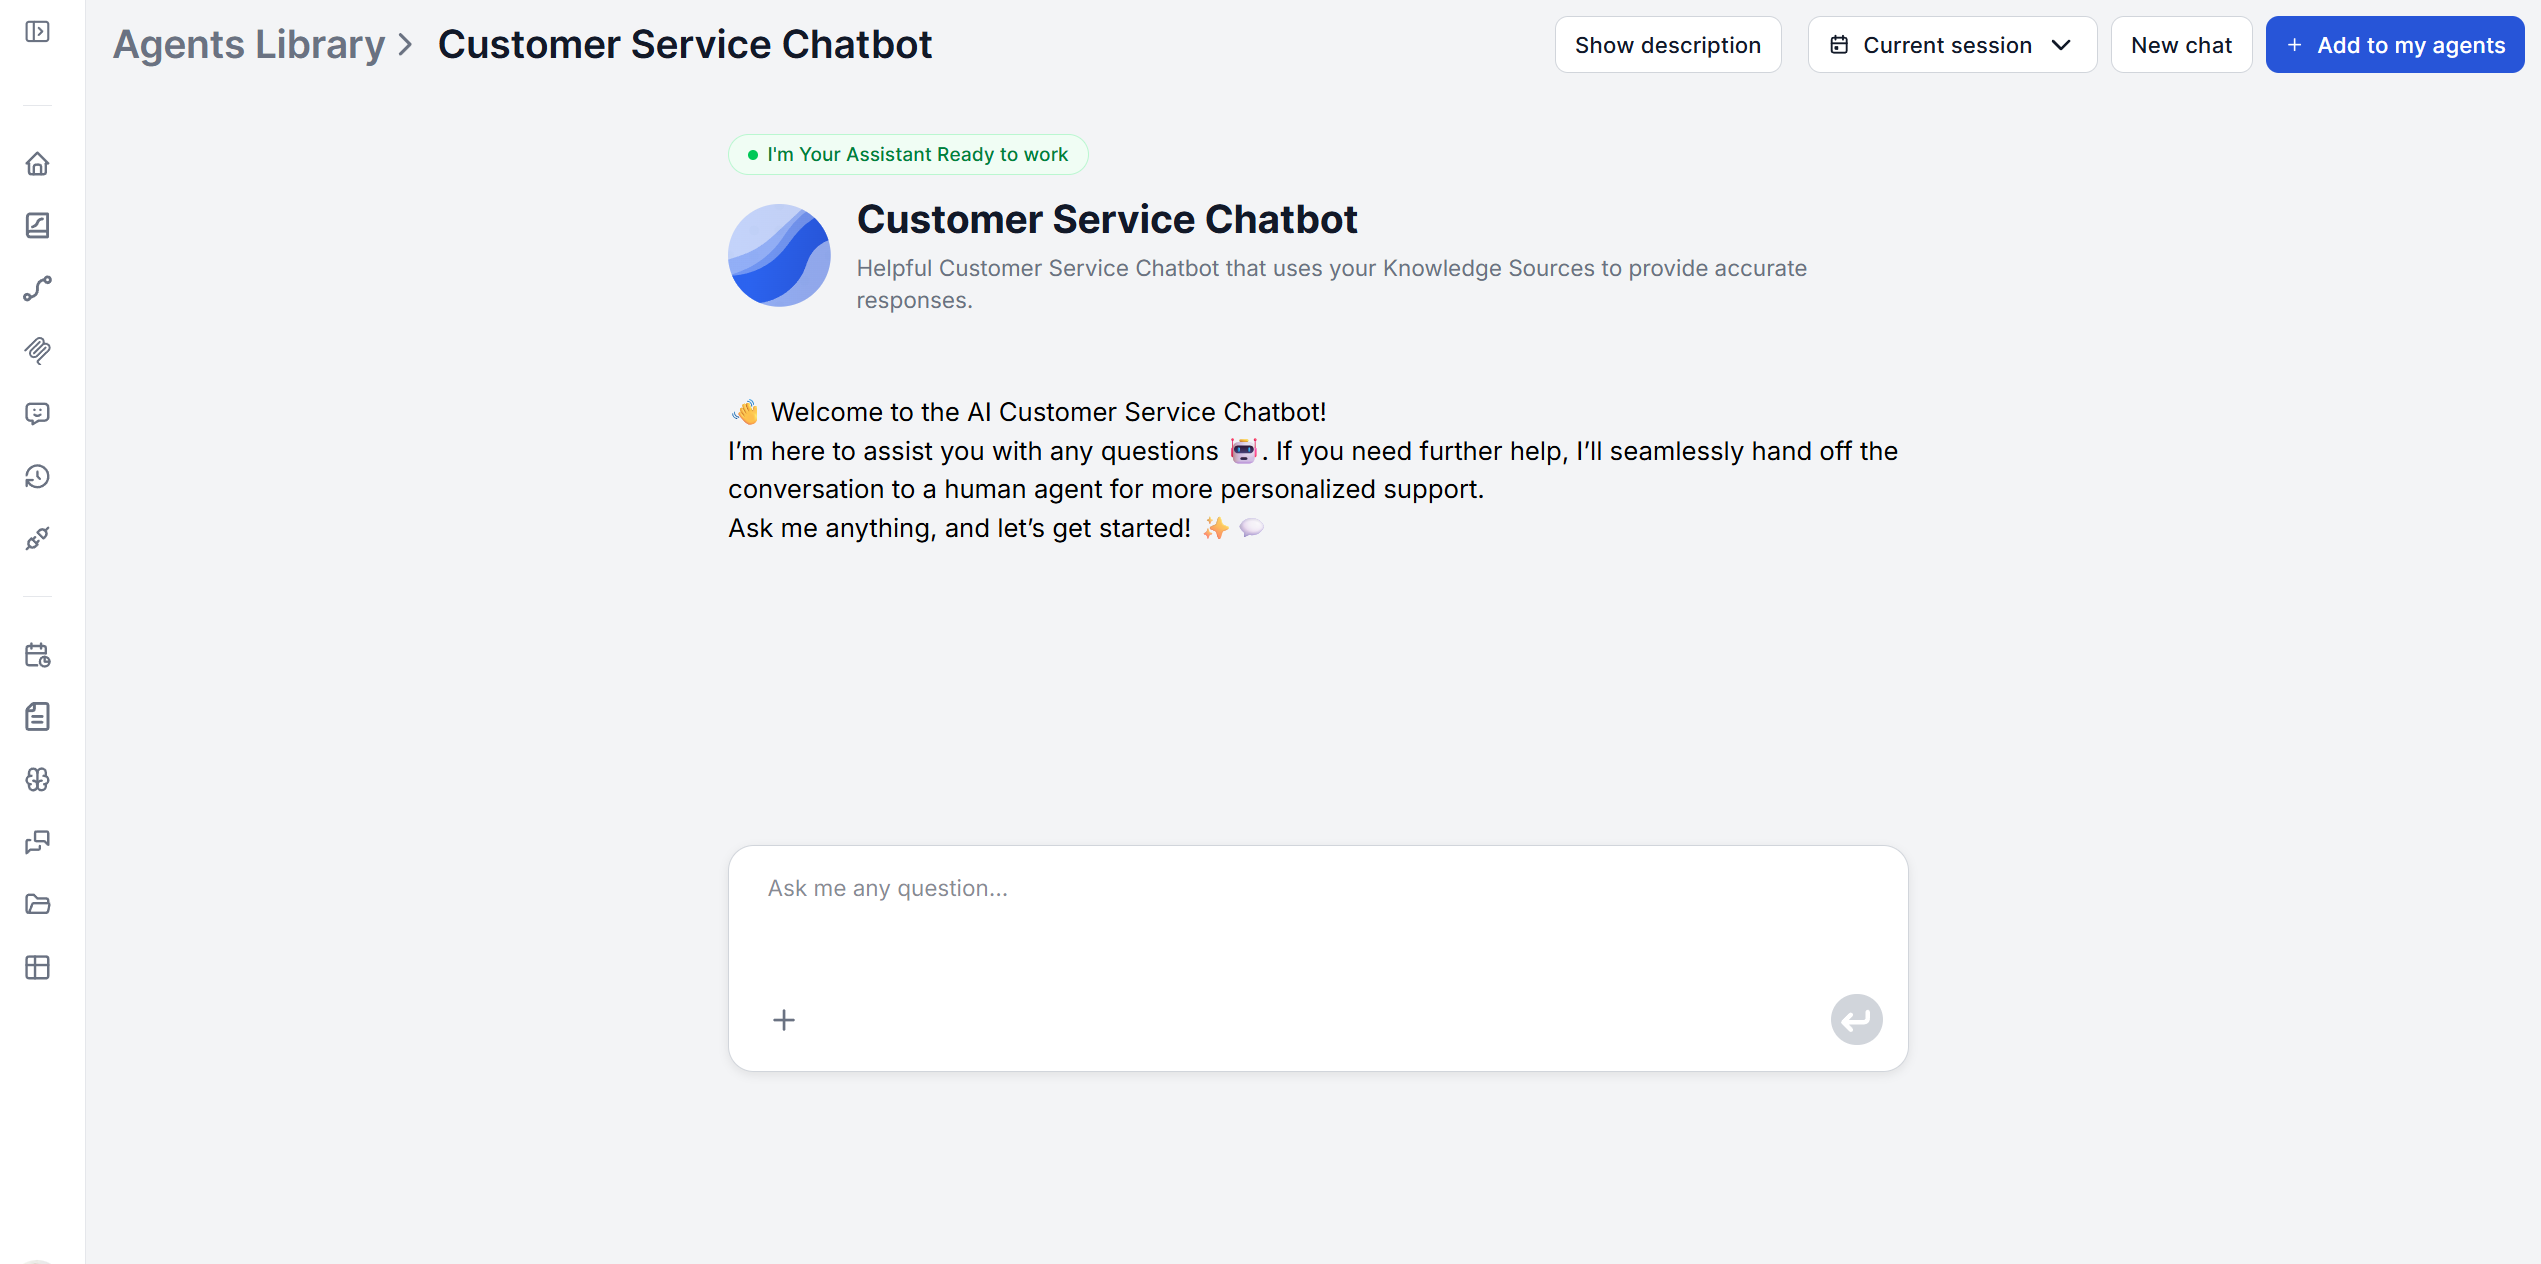
Un chatbot basado en una base de conocimiento sigue el mismo bucle en cada conversación. Recibe la pregunta del cliente en lenguaje natural, busca la respuesta relevante en tu documentación conectada, conserva el historial completo de la conversación para entender los seguimientos en su contexto y responde con una respuesta anclada en tu contenido. Cuando una pregunta queda fuera de lo que cubre la base de conocimiento, escala a una persona en lugar de adivinar.
Ese bucle es precisamente la capa repetitiva descrita antes. Configurarlo implica conectar tus FAQ existentes, tu documentación, así como tu sitio web y fuentes externas en línea, y configurar el prompt que controla el comportamiento . Sin árboles de decisión que programar a mano y sin respuestas separadas que mantener fuera de tu documentación existente.
Qué ocurre con la calidad del soporte cuando la IA asume la carga de nivel 1
Depende realmente de sobre qué se mida la “calidad”. Para la propia capa repetitiva, la calidad tiende a mejorar, ya que el chatbot da la misma respuesta precisa cada vez en lugar de una ligeramente distinta según qué agente recogiera el ticket o lo cansado que estuviera en el ticket número 40 del día.
Para los tickets que siguen gestionando personas , la calidad también tiene margen de mejora, precisamente porque hay menos compitiendo por la misma atención. También hay un ángulo de retención que conviene tomar en serio. Los datos de rotación en centros de contacto publicados por Insignia Resources sitúan la rotación anual en el 40-45%, con entre 10.000 y 20.000 dólares aproximadamente para sustituir a un solo agente. El trabajo repetitivo y monótono con tickets es un factor bien documentado de esa rotación. Nada de esto requiere recortar plantilla. La investigación de IBM de 2025 en 412 empresas concluyó específicamente que el ahorro de costes de la IA en el soporte de nivel 1 procedía del volumen de tickets desviados, no de reducir el número de agentes.
Únete a nuestro boletín
Obtén los últimos consejos, tendencias y ofertas gratis.
Calcular el ROI de la automatización del soporte
Los datos de Gartner de 2025 sitúan el coste de un ticket resuelto por IA en aproximadamente 0,50 a 1,05 dólares, teniendo en cuenta la infraestructura y las licencias. La estimación de Forrester de 2025 para un ticket gestionado por una persona asciende a 8-12 dólares una vez incluidos el salario del agente, los beneficios sociales, la formación y los gastos generales. Esto supone una diferencia de coste de 12x a 24x por ticket en el extremo de las preguntas repetitivas, que no requieren contacto humano ni criterio complejo.
La investigación de McKinsey de 2025 sobre los equipos del cuartil superior concluyó que alcanzaron reducciones de costes del 53%, todo reducido a disciplina operativa. Actualizaciones semanales de la base de conocimiento, enrutar la IA para encargarse del desvío en lugar de exigirle una resolución totalmente autónoma de todo, y un responsable interno dedicado al rendimiento de la IA.
En el lado del precio, una herramienta de tarifa plana elimina otra variable del cálculo por completo. El plan Pro de FlowHunt cuesta una tarifa fija de 120 €/mes independientemente de cuántos de esos tickets repetitivos se desvíen, en lugar de una tarifa por resolución que escala con el volumen.
Implementación: desplegar en pasos pequeños y comprobables
Pasar de nada a un chatbot desplegado no requiere un lanzamiento de varios meses, pero tampoco es un proceso de “conéctalo y vete dos días”. Divídelo en pasos pequeños y prueba después de cada uno que cambie lo que el bot puede hacer realmente, no solo una vez al final.
1. Conecta primero tu contenido con más tráfico . Empieza con programaciones de rastreo de tus principales FAQ y de los artículos de ayuda más vistos en lugar de subir toda tu biblioteca de documentación de una vez. Aquí es donde se concentra la capa repetitiva, y te da algo contra lo que probar casi de inmediato.
2. Haz una primera ronda de pruebas enseguida. Hazle al bot un puñado de preguntas reales del historial en cuanto esté ese primer lote de contenido, antes de configurar nada más. Esto confirma que la recuperación funciona de verdad antes de construir más encima.
3. Configura el prompt, la persona y el mensaje de bienvenida. Ajusta el tono para que coincida con cómo habla realmente tu equipo a los clientes. Acertar con el mensaje de bienvenida importa más de lo que parece: es la primera señal para el cliente de que habla con algo que realmente conoce el producto.
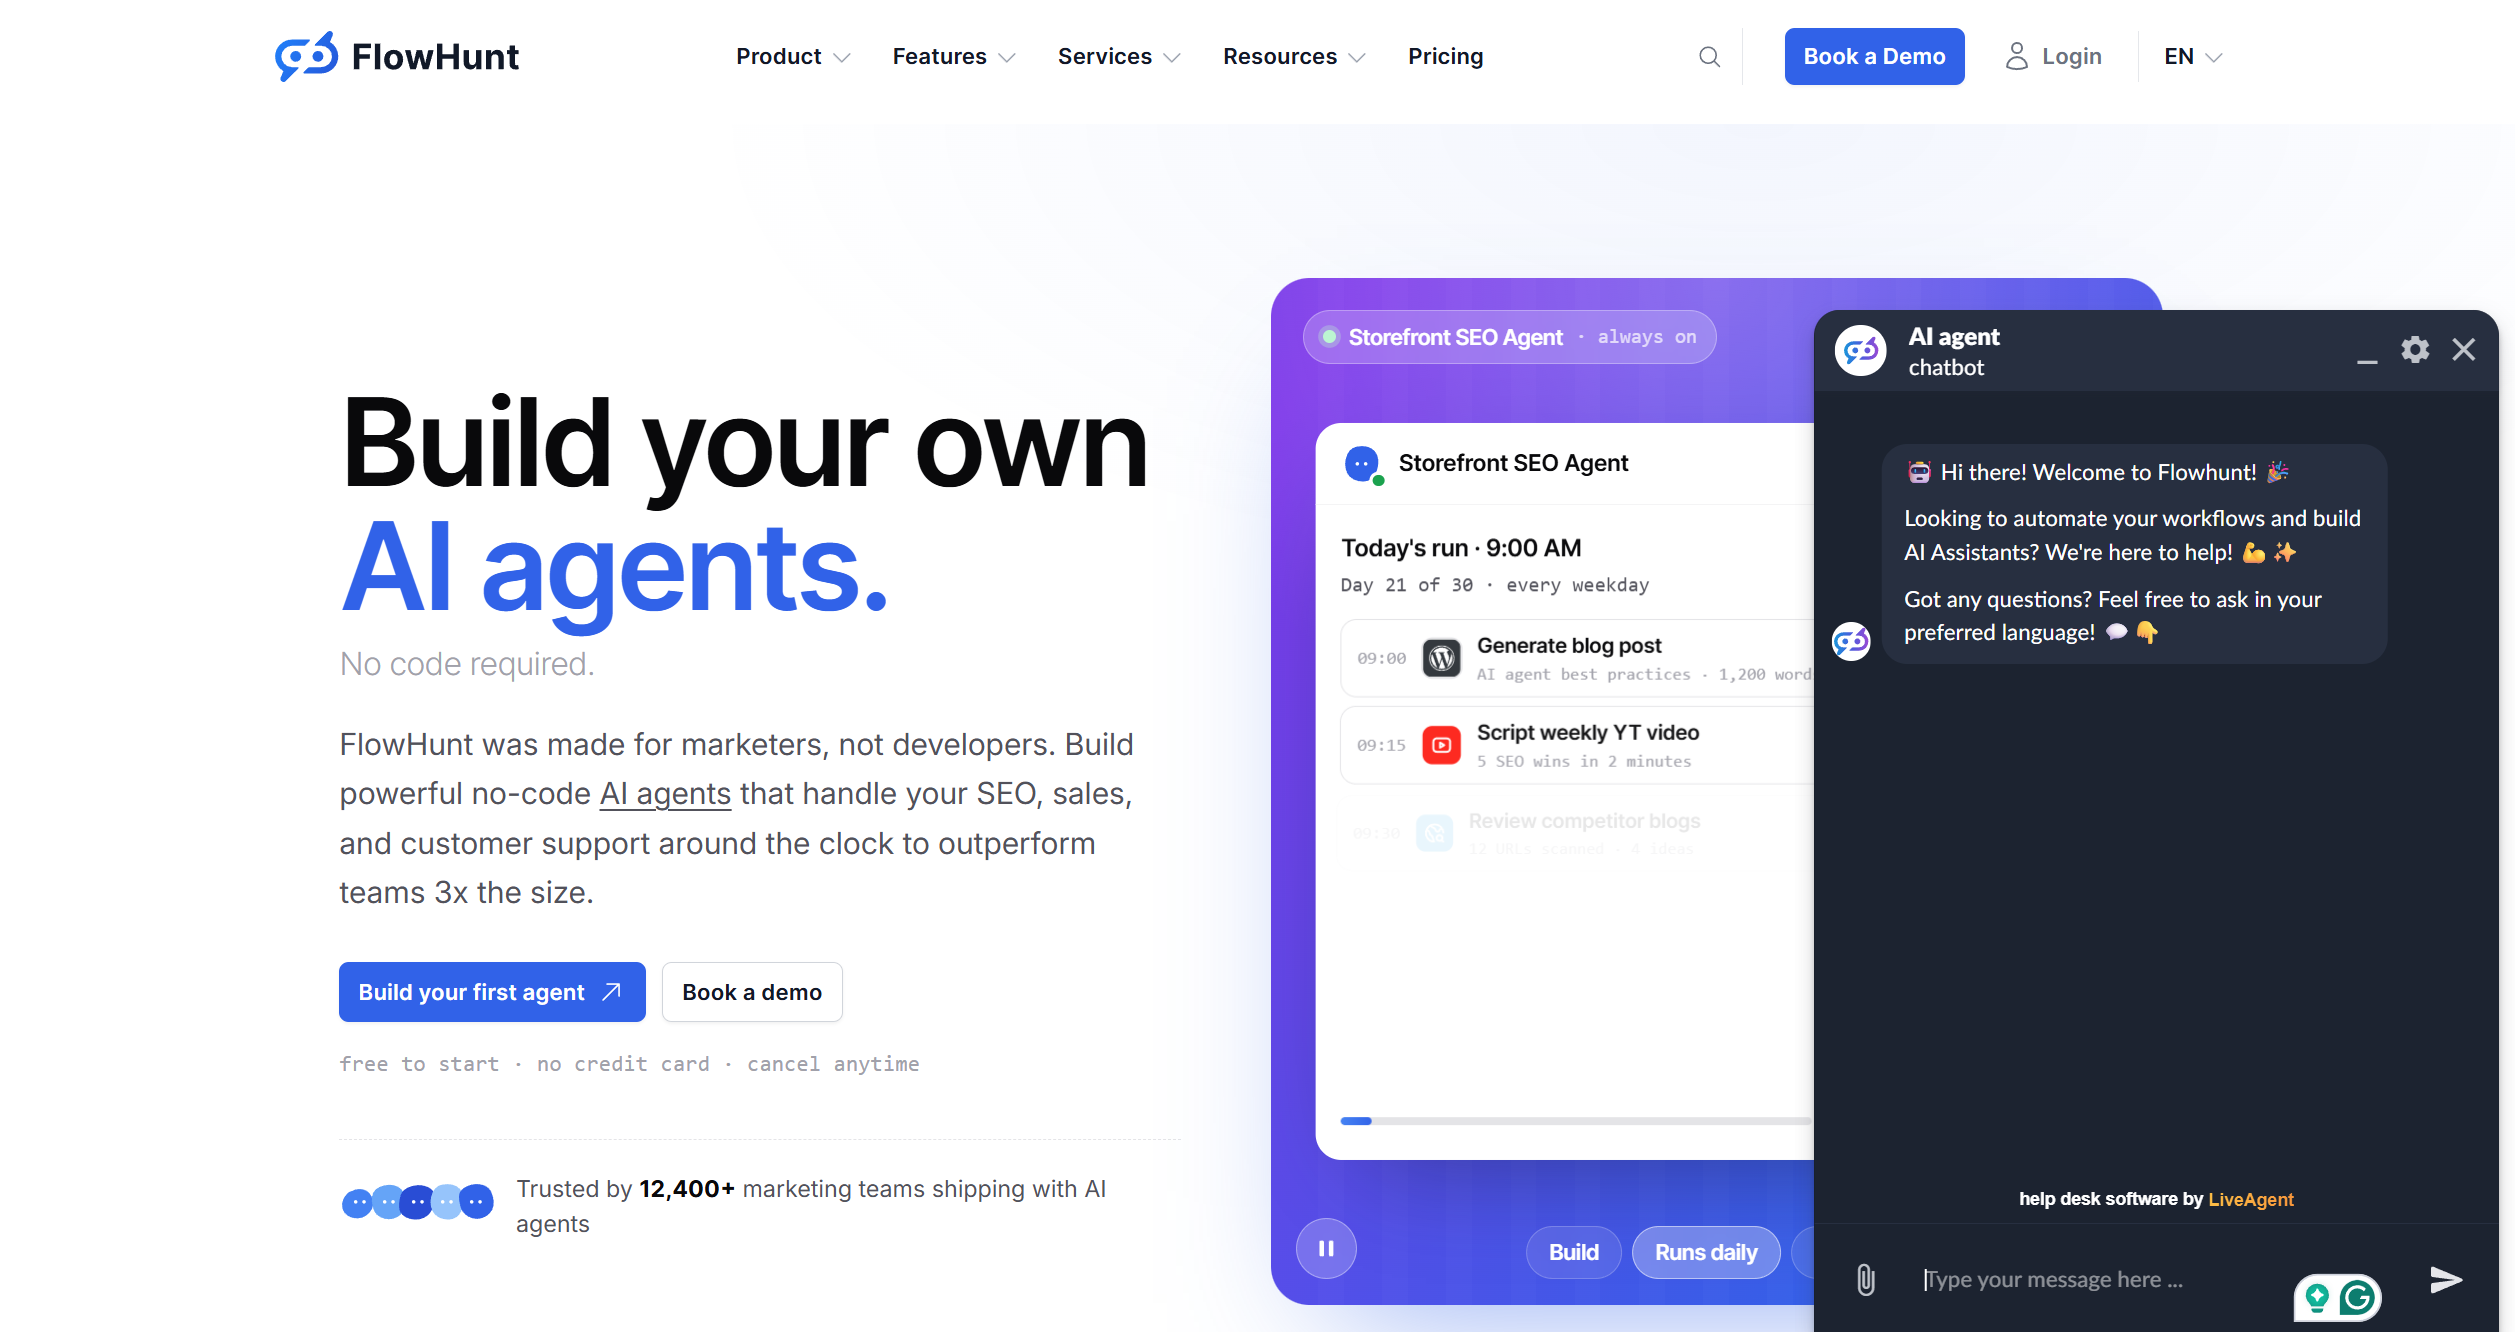
4. Configura el traspaso a humanos y el fallback. Este es el paso que tienta saltarse y el más caro de saltarse. Decide dónde debe aterrizar una conversación escalada y luego conéctalo: la integración con LiveAgent de FlowHunt transfiere automáticamente una conversación a un agente humano cuando la IA detecta una pregunta sin respuesta o un sentimiento negativo, y el mismo patrón se extiende a Intercom , Slack o cualquier otra herramienta que use tu equipo a través de la biblioteca de integraciones . Si aún no estás listo para configurar un traspaso en vivo, compartir un correo de soporte o un enlace a tickets directamente en el chat es un punto de partida legítimo: solo trátalo como un marcador de posición que hay que mejorar, no como el plan permanente.
5. Prueba la ruta de escalado específicamente. Pregunta algo que sepas que no está cubierto y confirma que el traspaso se dispara de verdad y aterriza donde esperas. Es una prueba distinta a la del paso 2: saber que el bot responde bien no te dice nada sobre qué ocurre cuando no puede.
6. Conecta fuentes adicionales. Una vez probada la capa de FAQ principal y funcionando el escalado, amplía con documentación secundaria, guías de producto, páginas de políticas o un rastreo basado en Schedules para contenido que se actualiza por sí solo. Vuelve a probar después de cada adición significativa en lugar de cargar todo de golpe.
7. Despliega y luego monitoriza lo que se escala. Ponlo en marcha en tu sitio web o portal de soporte. Lo que se escale después es un mapa directo de lo que aún le falta a tu base de conocimiento: trátalo como una lista de tareas priorizada, no solo como un registro.
Para una visión más amplia del panorama de construir frente a comprar más allá de este flujo de trabajo concreto, consulta crear chatbots de IA personalizados para equipos de soporte . Lanzar la primera versión tampoco pone fin al proceso: los equipos que alcanzan los resultados del cuartil superior de McKinsey tratan la base de conocimiento como algo que actualizan semanalmente, no como algo que configuran una vez y dejan en paz.
Conclusión
La capa repetitiva de los tickets de soporte no es un problema de personal, es un problema de enrutamiento. Las mismas 20 preguntas no necesitan un equipo más grande que las responda más rápido; necesitan dejar de llegar a una persona en primer lugar. Un chatbot anclado al conocimiento, desplegado en pasos pequeños y probados en lugar de un gran lanzamiento único, hace exactamente eso: absorbe el volumen repetitivo, escala con honestidad a un canal real cuando no puede ayudar y se vuelve más preciso cada vez que añades algo a lo que está conectado. Ya mires los números por coste por ticket, por rotación de agentes o por las horas que libera para los tickets que realmente necesitan el criterio de una persona, apuntan en la misma dirección.
Despliega tu chatbot de atención al cliente y descubre cuánto de tu capa repetitiva puede quitarte de encima, empezando hoy mismo.
