


O echipă de suport obișnuită petrece o proporție disproporționat de mare din săptămână răspunzând la aceleași câteva întrebări. Într-un sondaj realizat de DigitalGenius și Canam Research în rândul liderilor din serviciul clienți din America de Nord , 80% au declarat că 20% sau mai mult din tichetele echipei lor sunt repetitive, dar ușor de rezolvat. Fiecare oră pe care un agent o petrece cu „cum îmi resetez parola” este o oră nepetrecută pe problema complexă care chiar avea nevoie de judecata unui om. Iată cum să reduceți volumul de tichete de suport cu AI eliminând acel nivel repetitiv și ce înseamnă asta pentru echipa dvs.
Problema compoziției tichetelor: unde se duce de fapt timpul de suport
Majoritatea echipelor de suport nu au atât o problemă de vizibilitate, cât una de atenție. Tichetele care necesită cel mai puțină judecată pentru a fi rezolvate, cum ar fi resetările de parolă, „unde este comanda mea”, întrebări de bază despre facturare, diferențele dintre planuri, ajung în același volum, sau chiar mai mare, ca cele complexe. Fiecare dintre ele costă totuși o schimbare completă de context: citirea tichetului, recunoașterea rutinei, scoaterea aceluiași răspuns din memorie sau dintr-un articol de ajutor și formularea răspunsului.
Acea cifră de 80% dintre lideri și 20% dintre tichete din sondajul DigitalGenius/Canam este un minim, nu un maxim. Multe echipe raportează că ponderea celor repetitive este considerabil mai mare. Problema se amplifică pentru că este invizibilă în majoritatea dashboardurilor de tichete.
Cele 20 de întrebări care consumă 80% din capacitatea de suport
În majoritatea cozilor de suport din SaaS și e-commerce, un set mic de categorii acoperă cea mai mare parte a nivelului „repetitiv”:
- Resetări de parolă și probleme de acces la cont
- Starea comenzii și termenele de livrare
- Întrebări despre facturare și diferențele de plan sau de preț
- Întrebări despre politica de returnare și rambursare
- Întrebări de tipul „cum fac X”, deja acoperite în centrul de ajutor
- Pași de depanare de bază care sunt documentați, dar pe care clienții nu i-au găsit
Toate aceste categorii au nevoie doar de informația corectă, livrată rapid și consecvent, fără o gândire mai profundă sau o decizie luată de un om. Exact la asta se descurcă bine un chatbot bazat pe cunoștințe. Oferă răspunsuri simple, plictisitoare și clare, consecvent și la scară, fără a investi același timp și efort în schimbarea contextului, căutare sau redactarea unui răspuns, așa cum ar face un om.

Pregătit să îți dezvolți afacerea?
Începe perioada de probă gratuită astăzi și vezi rezultate în câteva zile.
Cum gestionează chatboturile AI nivelul repetitiv
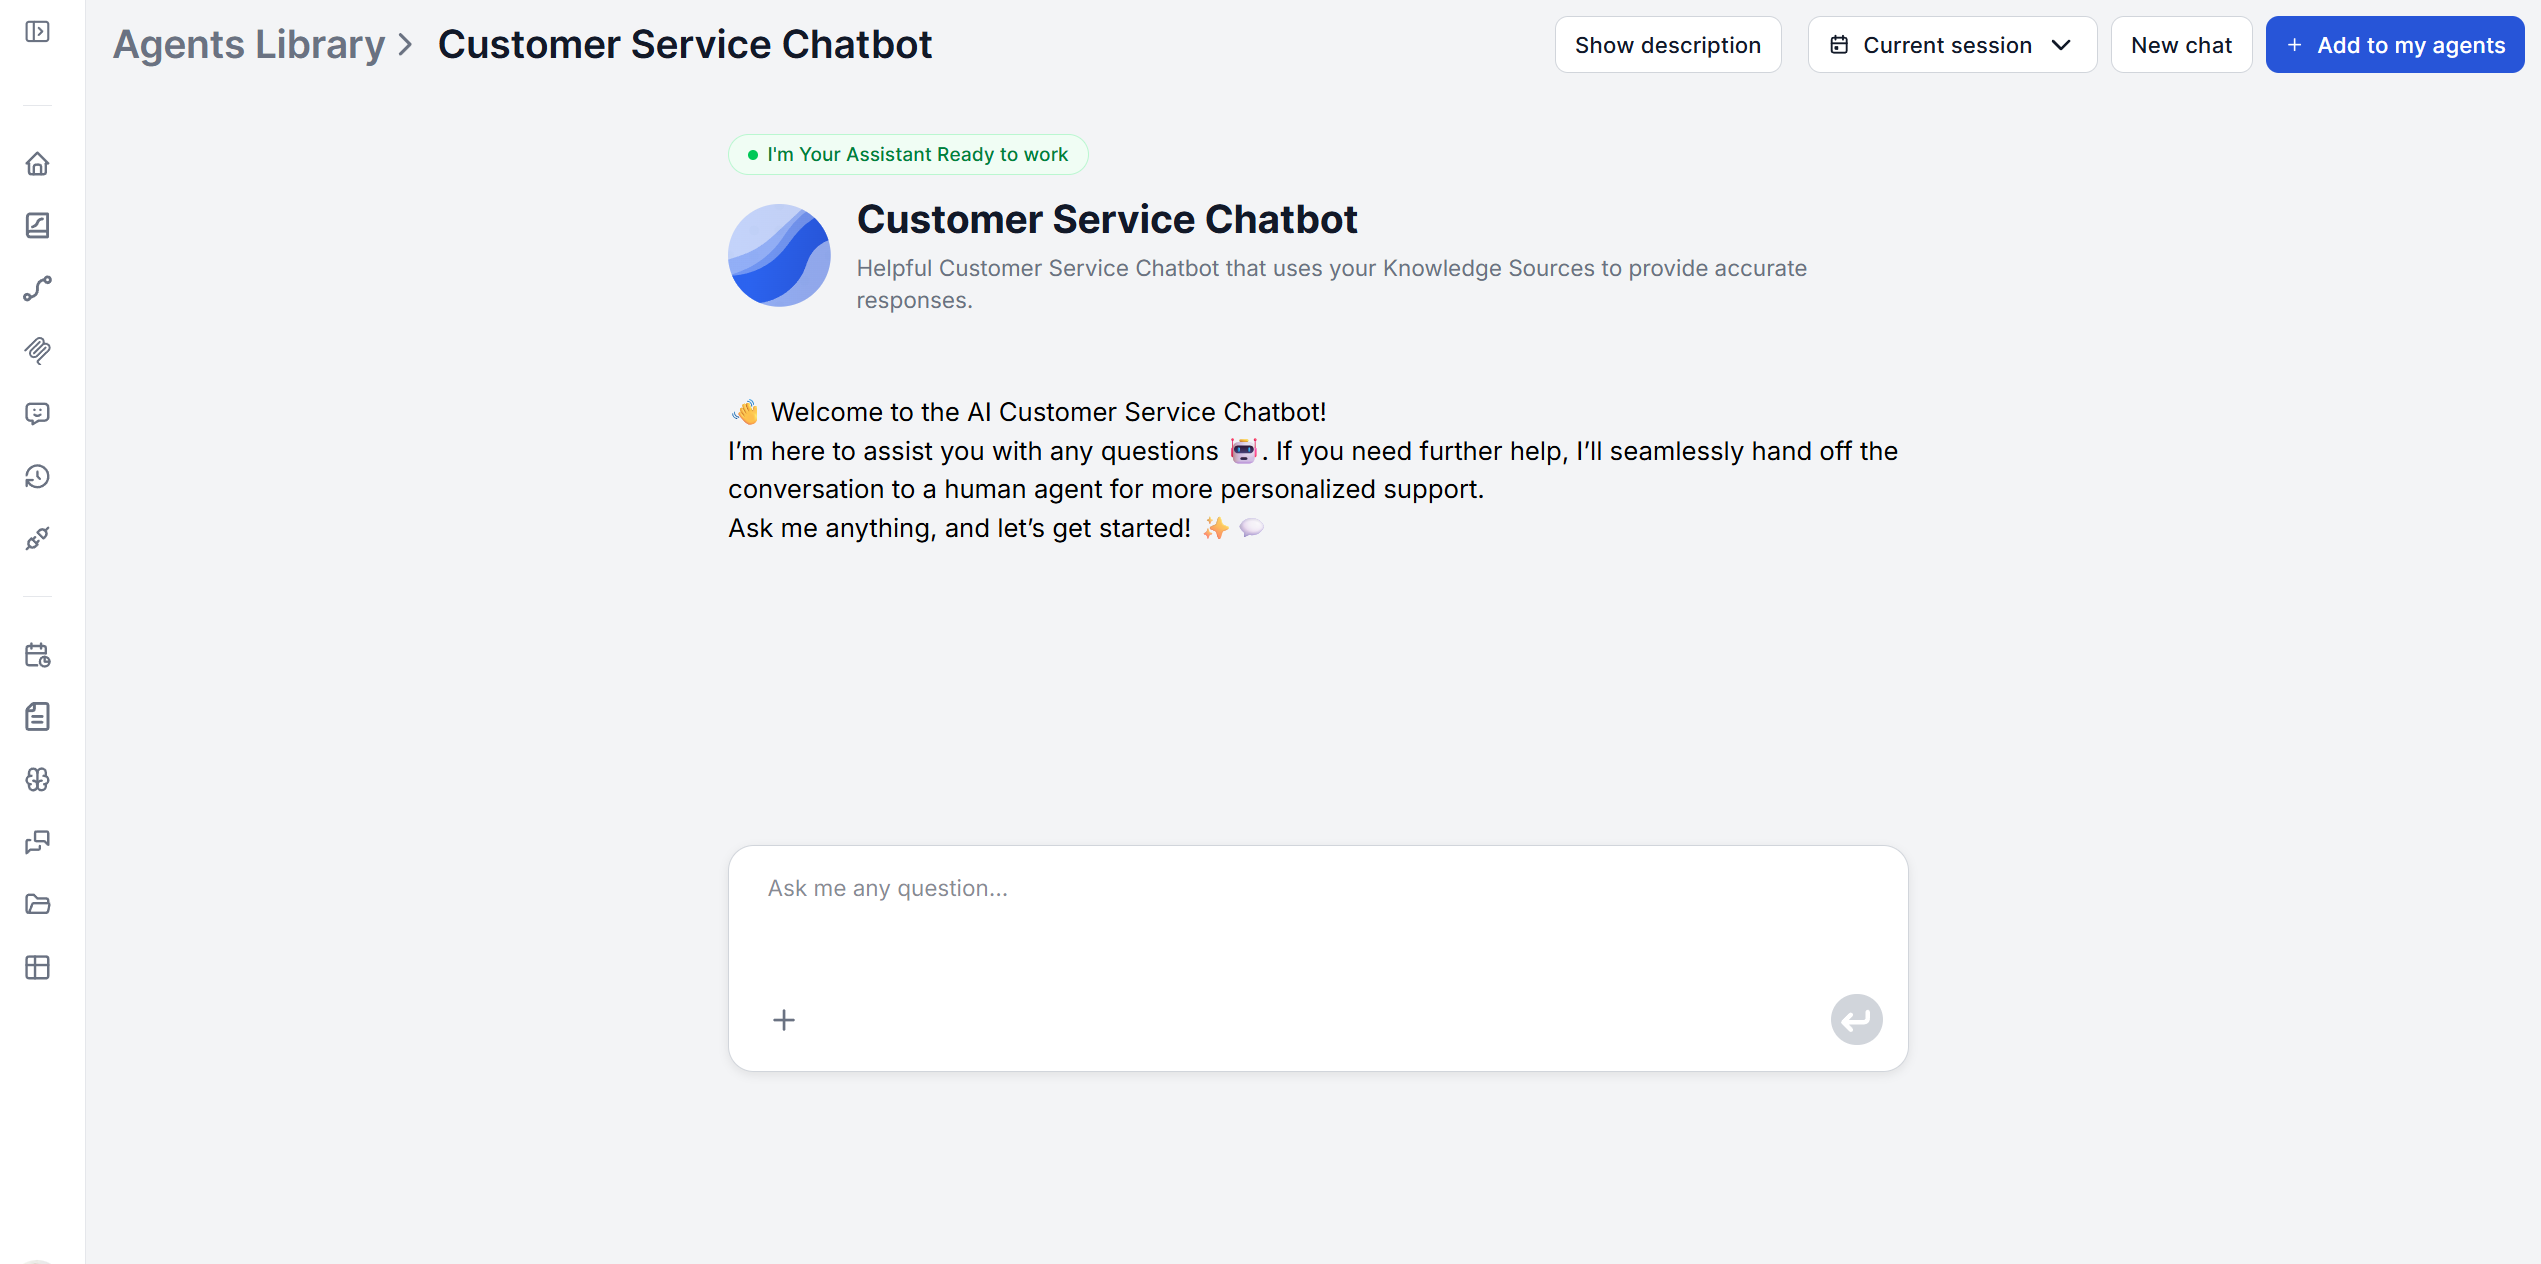
Un chatbot bazat pe o bază de cunoștințe urmează aceeași buclă în fiecare conversație. Primește întrebarea clientului în limbaj natural, caută răspunsul relevant în documentația dvs. conectată, păstrează întregul istoric al conversației, astfel încât întrebările ulterioare să fie înțelese în context, și răspunde cu un răspuns fundamentat pe conținutul dvs. Când o întrebare iese din aria acoperită de baza de cunoștințe, escaladează către un om în loc să ghicească.
Această buclă este exact nivelul repetitiv descris mai sus. Configurarea ei înseamnă să conectați întrebările frecvente și documentația existentă, precum și site-ul dvs. și sursele online externe, și să configurați promptul care controlează comportamentul . Fără arbore de decizie de scris manual și fără un răspuns separat de întreținut în afara documentației dvs. existente.
Ce se întâmplă cu calitatea suportului când AI preia încărcarea de nivel 1
Depinde într-adevăr de ceea ce se măsoară prin „calitate”. Pentru nivelul repetitiv în sine, calitatea tinde să se îmbunătățească, deoarece chatbotul oferă de fiecare dată același răspuns corect, în loc de unul ușor diferit, în funcție de agentul care a preluat tichetul sau de cât de obosit era la al 40-lea tichet al zilei.
Pentru tichetele care rămân gestionate de oameni , există și acolo loc de îmbunătățire, tocmai pentru că sunt mai puține care concurează pentru aceeași atenție. Există și un aspect legat de retenție care merită luat în serios. Datele privind fluctuația în centrele de contact raportate de Insignia Resources indică o fluctuație anuală de 40-45%, cu aproximativ 10.000-20.000 de dolari pentru înlocuirea unui singur agent. Munca repetitivă și monotonă pe tichete este un factor bine documentat al acestei fluctuații. Nimic din toate acestea nu necesită reducerea personalului. Cercetarea IBM din 2025 pe 412 companii a constatat în mod specific că economiile de costuri generate de AI în suportul de nivel 1 au venit din volumul de tichete deviate, nu din reducerea numărului de agenți.
Abonează-te la newsletter-ul nostru
Primește cele mai recente sfaturi, tendințe și oferte gratuit.
Calcularea ROI-ului automatizării suportului
Datele Gartner din 2025 estimează costul unui tichet rezolvat de AI la aproximativ 0,50-1,05 dolari, incluzând infrastructura și licențele. Estimarea Forrester din 2025 pentru un tichet gestionat de un om ajunge la 8-12 dolari, incluzând salariul agentului, beneficiile, trainingul și costurile generale. Aceasta este o diferență de cost de 12x până la 24x pe tichet, la capătul spectrului reprezentat de întrebările repetitive, care nu necesită contact uman sau judecată complexă.
Cercetarea McKinsey din 2025 privind performerii din quartila superioară a constatat că aceștia au ajuns la reduceri de costuri de 53%, totul reducându-se la disciplină operațională. Actualizări săptămânale ale bazei de cunoștințe, direcționarea AI către devierea tichetelor în loc de a cere rezolvare complet autonomă pentru tot și un responsabil intern dedicat performanței AI-ului.
Pe partea de prețuri, un instrument cu tarif fix elimină complet încă o variabilă din calcul. Planul Pro al FlowHunt costă o sumă fixă de 120 €/lună, indiferent câte dintre acele tichete repetitive sunt deviate, în loc de o taxă pe rezolvare care crește odată cu volumul.
Implementare: lansarea în pași mici, testabili
Trecerea de la zero la un chatbot implementat nu necesită o lansare de mai multe luni, dar nu este nici un proces de tipul „conectează-l și pleacă două zile”. Împărțiți-l în pași mici și testați după fiecare pas care schimbă efectiv ceea ce poate face botul — nu doar o dată, la final.
1. Conectați mai întâi conținutul cu cel mai mare trafic . Începeți cu programări de crawling pentru întrebările frecvente principale și articolele de ajutor cele mai vizualizate, în loc să încărcați dintr-o dată întreaga bibliotecă de documentație. Aici se concentrează nivelul repetitiv și astfel aveți ceva de testat aproape imediat.
2. Rulați imediat o primă rundă de testare. Adresați botului câteva întrebări istorice reale, imediat ce primul set de conținut este încărcat, înainte de a configura orice altceva. Astfel confirmați că recuperarea informațiilor funcționează efectiv, înainte de a construi mai mult peste ea.
3. Configurați promptul, persona și mesajul de întâmpinare. Stabiliți tonul care să corespundă modului în care echipa dvs. vorbește efectiv cu clienții. A formula corect mesajul de întâmpinare contează mai mult decât pare — este primul semnal pentru client că vorbește cu ceva care chiar cunoaște produsul.
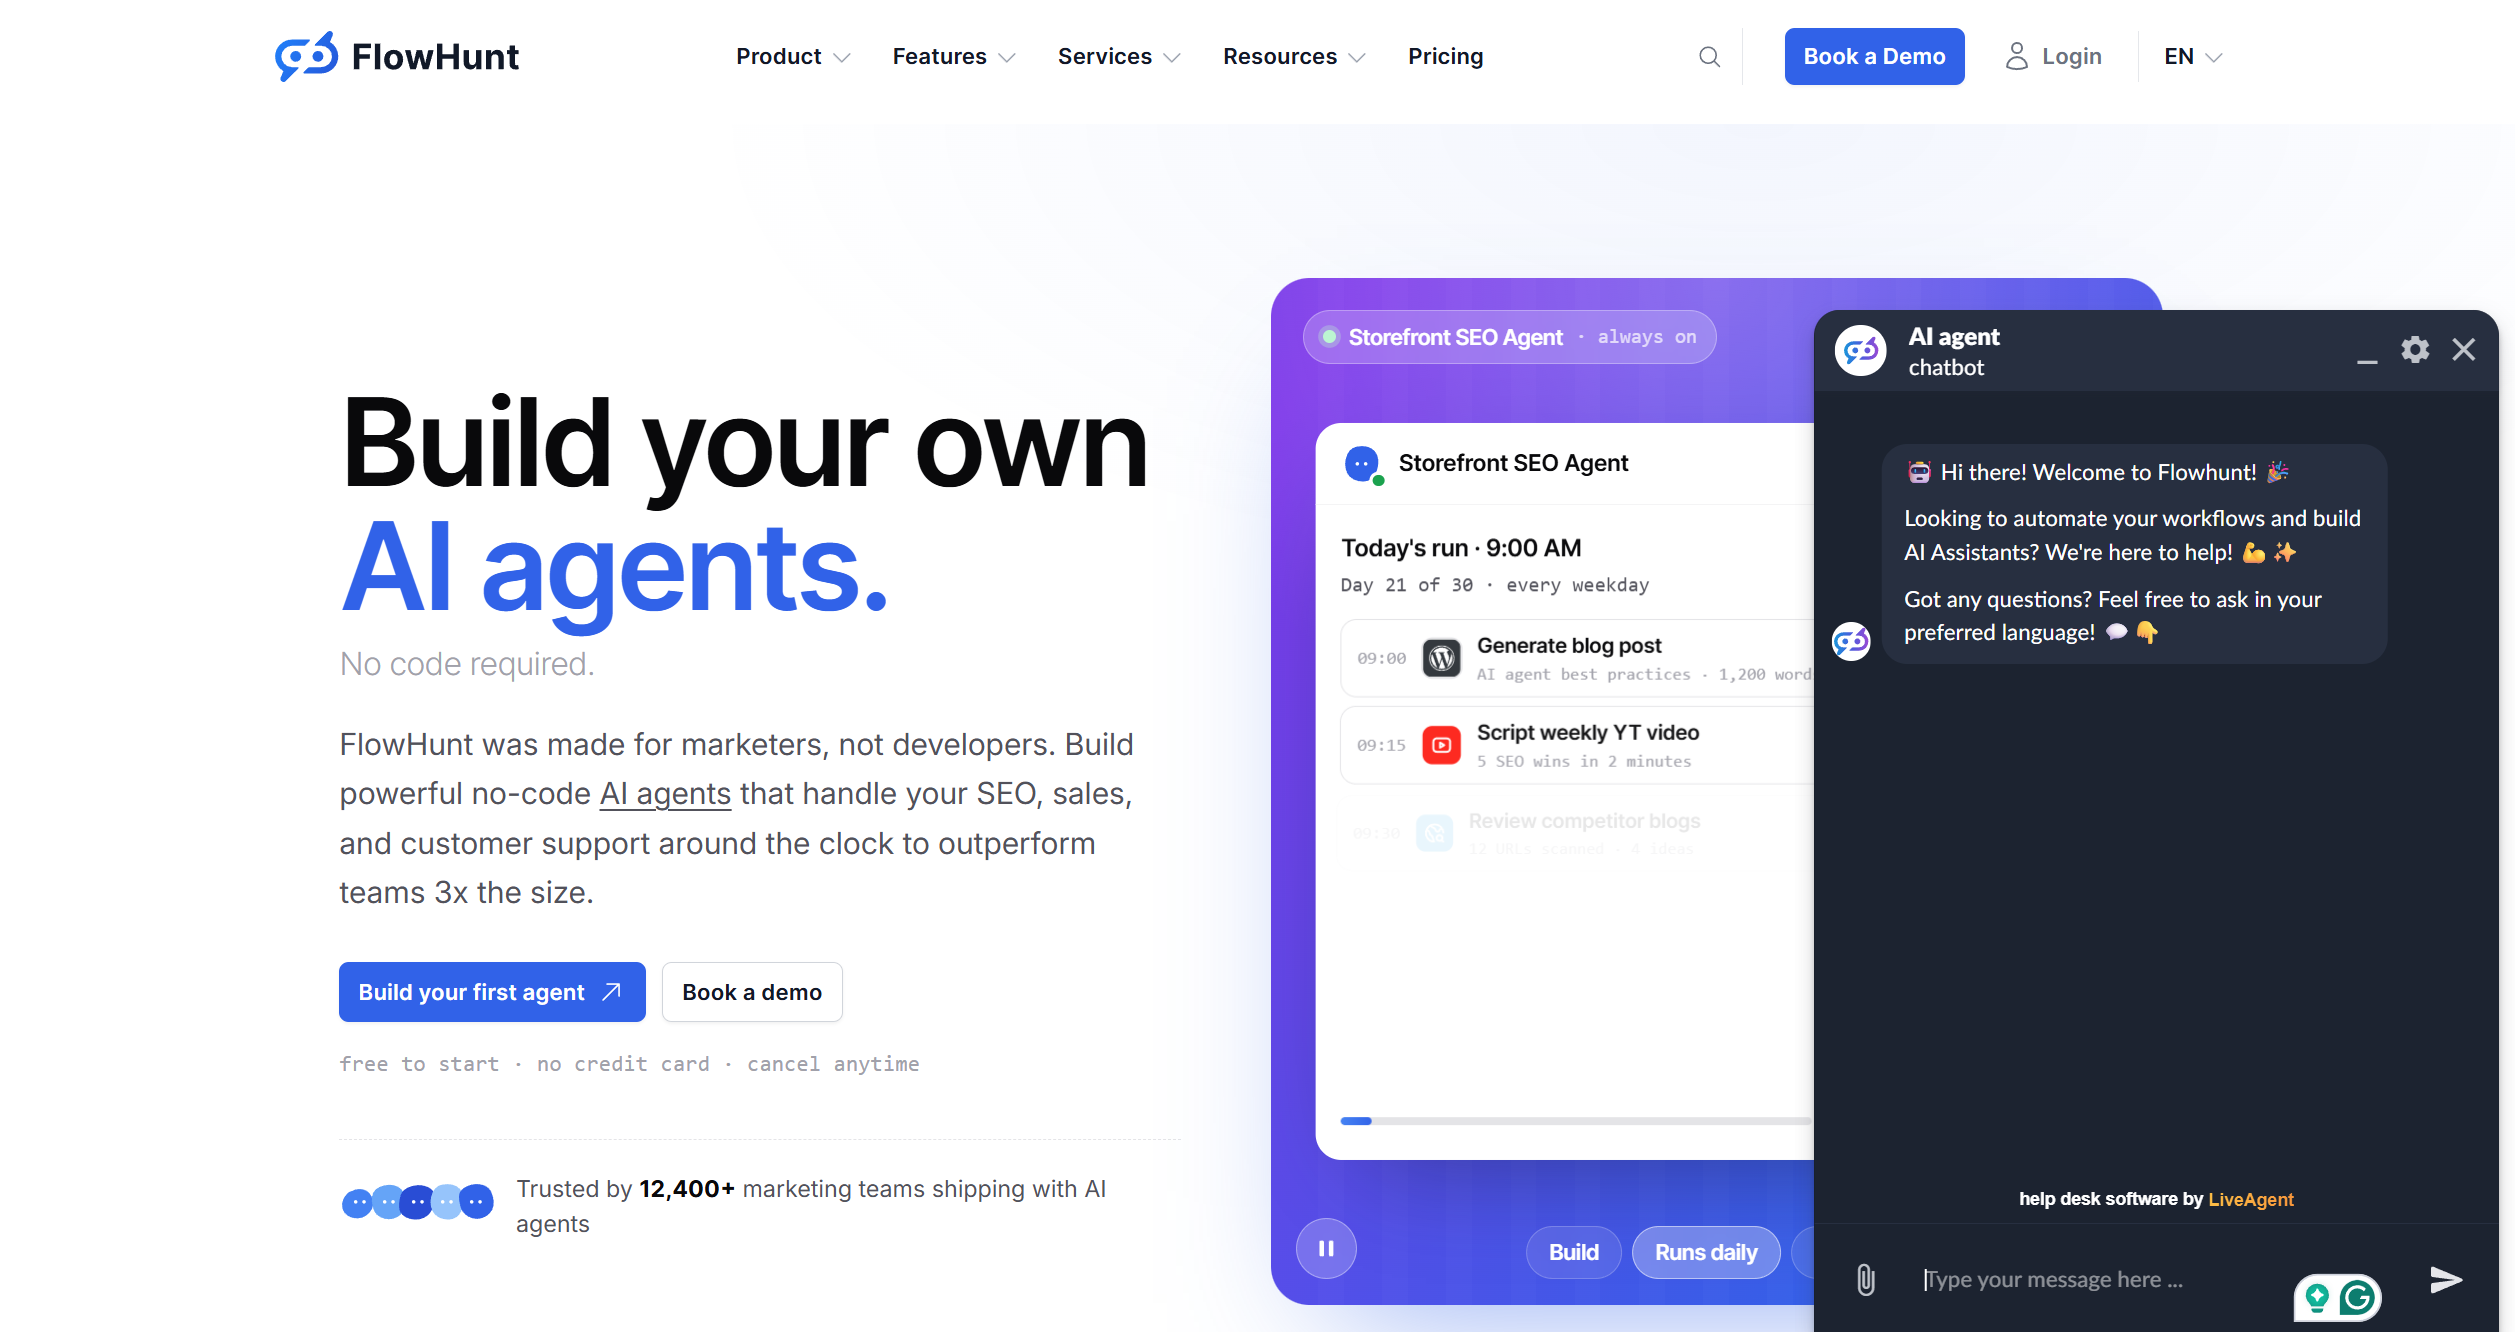
4. Configurați transferul către un om și comportamentul de rezervă. Acesta este pasul pe care e tentant să îl săriți și cel mai scump de sărit. Decideți unde trebuie să ajungă o conversație escaladată, apoi conectați-o: integrarea LiveAgent a FlowHunt transferă automat o conversație către un agent uman atunci când AI-ul detectează o întrebare fără răspuns sau un sentiment negativ, iar același model se extinde la Intercom , Slack sau orice altceva folosește echipa dvs., prin biblioteca de integrări . Dacă nu sunteți încă pregătiți să conectați un transfer live, partajarea unui e-mail de suport sau a unui link către tichete direct în chat este un punct de plecare legitim — tratați-l însă doar ca pe un substitut temporar care urmează să fie îmbunătățit, nu ca pe planul permanent.
5. Testați în mod specific calea de escaladare. Adresați o întrebare despre care știți că nu este acoperită și confirmați că transferul se declanșează efectiv și ajunge acolo unde vă așteptați. Este un test diferit de cel de la pasul 2 — faptul că botul răspunde corect nu vă spune nimic despre ce se întâmplă când nu poate răspunde.
6. Conectați surse suplimentare. După ce nivelul principal de întrebări frecvente este testat și escaladarea funcționează, extindeți cu documentație secundară, ghiduri de produs, pagini de politici sau un crawl bazat pe Schedules pentru conținutul care se actualizează singur. Retestați după fiecare adăugare semnificativă, în loc să încărcați totul în bloc dintr-o dată.
7. Implementați, apoi monitorizați ce se escaladează. Lansat pe site-ul dvs. sau în portalul de suport. Ce se escaladează după aceea este o hartă directă a ceea ce încă lipsește din baza dvs. de cunoștințe — tratați-o ca pe o listă de priorități, nu doar ca pe un jurnal.
Pentru o perspectivă mai largă asupra opțiunilor de tip „construiește sau cumpără”, dincolo de acest singur flux de lucru, vedeți construirea de chatboturi AI personalizate pentru echipele de suport . Nici lansarea primei versiuni nu încheie procesul — echipele care ajung la rezultatele din quartila superioară McKinsey tratează baza de cunoștințe ca pe ceva ce actualizează săptămânal, nu ca pe ceva configurat o dată și lăsat de izbeliște.
Concluzie
Nivelul repetitiv al tichetelor de suport nu este o problemă de personal, ci una de rutare. Aceleași 20 de întrebări nu au nevoie de o echipă mai mare care să răspundă mai repede; ele trebuie să înceteze să mai ajungă la un om. Un chatbot fundamentat pe cunoștințe, lansat în pași mici și testați, în loc de o singură implementare amplă, face exact asta: absoarbe volumul repetitiv, escaladează onest către un canal real atunci când nu poate ajuta și devine mai precis de fiecare dată când adăugați ceva la ceea ce este conectat. Indiferent dacă priviți matematica prin costul pe tichet, fluctuația agenților sau orele eliberate pentru tichetele care chiar au nevoie de judecata unui om, concluzia indică aceeași direcție.
Implementați-vă chatbotul pentru serviciul clienți și aflați cât din nivelul dvs. repetitiv poate prelua de pe agenda echipei, începând chiar de astăzi.
