


Het gemiddelde supportteam besteedt een buitenproportioneel deel van zijn week aan het beantwoorden van hetzelfde handjevol vragen. In een onderzoek onder Noord-Amerikaanse klantenservicemanagers van DigitalGenius en Canam Research zei 80% dat 20% of meer van de tickets van hun team repetitief is, maar wel makkelijk op te lossen. Elk uur dat een agent besteedt aan “hoe stel ik mijn wachtwoord opnieuw in”, is een uur dat niet wordt besteed aan het complexe probleem dat echt het oordeel van een mens vereiste. Zo kun je het aantal supporttickets verlagen met AI door die repetitieve laag te elimineren, en wat dat voor je team betekent.
Het probleem van de ticketopbouw: waar de supporttijd echt naartoe gaat
De meeste supportteams hebben niet zozeer een zichtbaarheidsprobleem als wel een aandachtprobleem. De tickets die het minste beoordelingsvermogen vergen, zoals wachtwoordresets, “waar is mijn bestelling”, eenvoudige factureringsvragen en verschillen tussen abonnementen, komen in hetzelfde volume binnen als de complexe, of zelfs meer. Elk ticket kost nog steeds een volledige contextswitch: het ticket lezen, de routine herkennen, hetzelfde antwoord uit het geheugen of een helpartikel halen en antwoorden.
Dat cijfer van 80% van de managers en 20% van de tickets uit het DigitalGenius/Canam-onderzoek is een ondergrens, geen plafond. Veel teams melden dat het repetitieve aandeel aanzienlijk hoger ligt. Het probleem versterkt zichzelf doordat het in de meeste ticketdashboards onzichtbaar is.
De 20 vragen die 80% van de supportcapaciteit opslokken
In de meeste supportwachtrijen van SaaS- en e-commercebedrijven zorgt een kleine set categorieën voor het grootste deel van de “repetitieve” laag:
- Wachtwoordresets en problemen met accounttoegang
- Bestelstatus en verzendtermijnen
- Factureringsvragen en verschillen in abonnementen of prijzen
- Vragen over retour- en terugbetalingsbeleid
- “Hoe doe ik X”-vragen die al in het helpcentrum staan
- Eenvoudige troubleshootingstappen die gedocumenteerd zijn, maar die klanten niet hebben gevonden
Al deze categorieën vragen alleen om de juiste informatie, snel en consistent geleverd, zonder dieper nadenken of een menselijke beoordeling. Dat is precies waar een op kennis gebaseerde chatbot goed in is. Hij levert de simpele, saaie en duidelijke antwoorden consistent en op schaal, zonder dezelfde tijd en moeite te steken in contextswitching, zoeken of het opstellen van een antwoord als een mens zou doen.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
Hoe AI-chatbots de repetitieve laag afhandelen
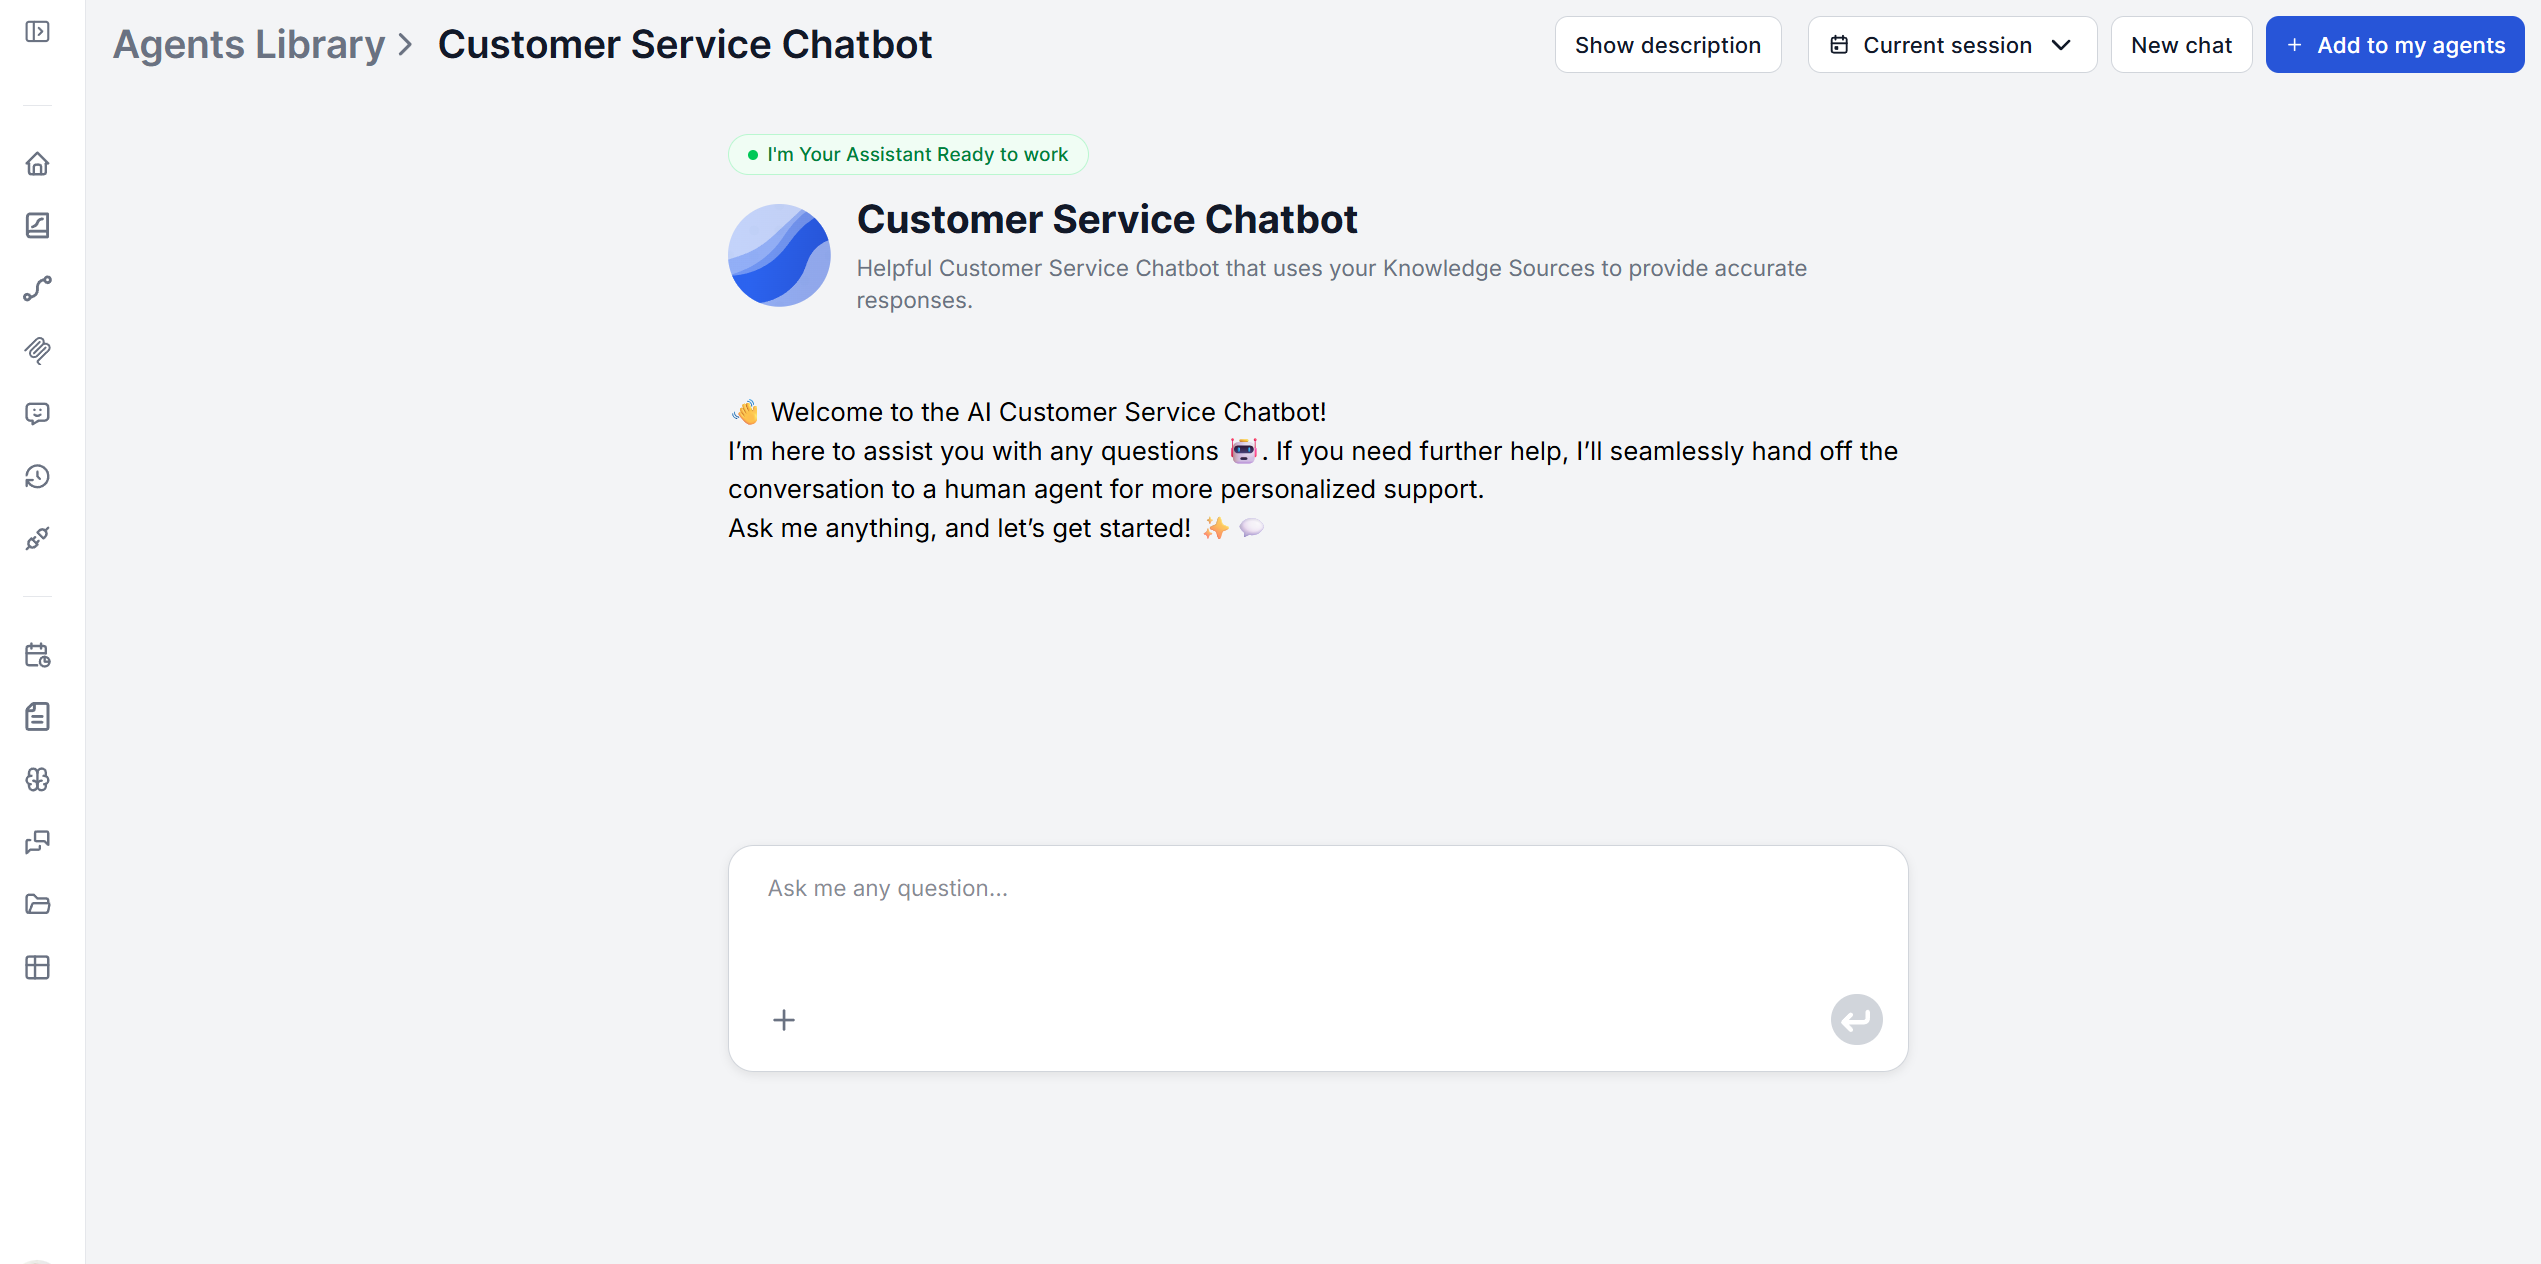
Een knowledgebase-chatbot doorloopt bij elk gesprek dezelfde cyclus. Hij ontvangt de vraag van de klant in natuurlijke taal, doorzoekt je gekoppelde documentatie naar het relevante antwoord, houdt de volledige gespreksgeschiedenis bij zodat vervolgvragen in context worden begrepen, en antwoordt met een antwoord dat is gebaseerd op jouw content. Als een vraag buiten de knowledgebase valt, escaleert hij naar een mens in plaats van te gokken.
Die cyclus is precies de hierboven beschreven repetitieve laag. Het opzetten ervan betekent het koppelen van je bestaande FAQ’s en documentatie, en ook je website en externe online bronnen, en het configureren van de prompt die het gedrag aanstuurt . Geen beslissingsboom die je handmatig moet scripten, en geen apart antwoord dat je buiten je bestaande documentatie moet onderhouden.
Wat gebeurt er met de supportkwaliteit als AI de tier-1-last overneemt
Dat hangt ervan af waaraan “kwaliteit” wordt afgemeten. Voor de repetitieve laag zelf neemt de kwaliteit meestal toe, omdat de chatbot elke keer hetzelfde nauwkeurige antwoord geeft in plaats van een iets ander antwoord, afhankelijk van welke agent het ticket oppakte of hoe moe die was bij het veertigste ticket van de dag.
Voor de tickets die door mensen worden behandeld is er ook ruimte voor verbetering, juist omdat er minder van zijn die om dezelfde aandacht strijden. Er is ook het retentieaspect dat serieus genomen moet worden. Gegevens over verloop in contactcenters van Insignia Resources stellen het jaarlijkse verloop op 40-45%, waarbij het ongeveer $10.000-$20.000 kost om één agent te vervangen. Repetitief, eentonig ticketwerk is een goed gedocumenteerde oorzaak van dat verloop. Niets hiervan vereist het terugbrengen van het aantal medewerkers. Het onderzoek van IBM uit 2025 onder 412 ondernemingen vond specifiek dat de kostenbesparingen van AI in tier-1-support voortkwamen uit afgevangen ticketvolume, niet uit het verminderen van het aantal agenten.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
De ROI van supportautomatisering berekenen
Gegevens van Gartner uit 2025 stellen de kosten van een door AI opgelost ticket op ongeveer $0,50 tot $1,05, inclusief infrastructuur en licenties. De schatting van Forrester uit 2025 voor een door een mens behandeld ticket ligt op $8 tot $12, zodra salaris, secundaire arbeidsvoorwaarden, training en overheadkosten van de agent zijn meegerekend. Dat is een kostenverschil van 12x tot 24x per ticket aan de kant van de repetitieve vragen, die geen menselijk contact of complexe beoordeling vereisen.
Het onderzoek van McKinsey uit 2025 naar de best presterende teams vond dat zij 53% kostenreductie bereikten, wat allemaal neerkomt op operationele discipline. Wekelijkse updates van de knowledgebase, AI inzetten voor het afvangen van vragen in plaats van volledige autonome oplossing van alles te eisen, en een toegewijde interne eigenaar voor de prestaties van de AI.
Aan de prijskant haalt een tool met een vast tarief nog een variabele volledig uit de berekening. Het Pro-abonnement van FlowHunt kost een vast bedrag van €120 per maand, ongeacht hoeveel van die repetitieve tickets worden afgevangen, in plaats van een vergoeding per oplossing die meeschaalt met het volume.
Implementatie: uitrollen in kleine, testbare stappen
Van niets naar een uitgerolde chatbot gaan vereist geen traject van meerdere maanden, maar het is ook geen proces van “koppel het en loop twee dagen weg”. Splits het op in kleine stappen en test na elke stap die verandert wat de bot daadwerkelijk kan — niet alleen één keer helemaal aan het eind.
1. Koppel eerst je drukst bezochte content . Begin met crawlschema’s voor je belangrijkste FAQ’s en best bekeken helpartikelen, in plaats van je hele documentatiebibliotheek in één keer te uploaden. Hier concentreert de repetitieve laag zich, en het geeft je bijna direct iets om tegen te testen.
2. Voer direct een eerste testronde uit. Stel de bot een handvol echte vragen uit het verleden zodra die eerste batch content erin staat, voordat je iets anders configureert. Dit bevestigt dat het ophalen van informatie echt werkt voordat je er meer bovenop bouwt.
3. Configureer de prompt, persona en welkomstboodschap. Stem de toon af op hoe je team echt met klanten praat. De welkomstboodschap goed krijgen is belangrijker dan het lijkt — het is het eerste signaal voor een klant dat hij met iets praat dat het product echt kent.
4. Configureer menselijke overdracht en fallback. Dit is de stap die je geneigd bent over te slaan, en de duurste stap om over te slaan. Bepaal waar een geëscaleerd gesprek terecht moet komen en richt het dan in: de LiveAgent-integratie van FlowHunt draagt een gesprek automatisch over aan een menselijke agent wanneer de AI een onbeantwoorde vraag of negatief sentiment detecteert, en hetzelfde patroon geldt voor Intercom , Slack , of wat je team verder ook gebruikt via de integratiebibliotheek . Als je nog niet klaar bent om een live overdracht in te richten, is het delen van een support-e-mailadres of ticketlink direct in de chat een legitiem startpunt — behandel het alleen als een tijdelijke oplossing om te upgraden, niet als het definitieve plan.
5. Test specifiek het escalatiepad. Stel iets wat je weet dat niet gedekt is en bevestig dat de overdracht daadwerkelijk wordt geactiveerd en terechtkomt waar je verwacht. Dit is een andere test dan stap 2 — weten dat de bot correct antwoordt, zegt niets over wat er gebeurt als hij dat niet kan.
6. Koppel extra bronnen. Zodra de kern-FAQ-laag is getest en escalatie werkt, breid je uit met secundaire documentatie, producthandleidingen, beleidspagina’s of een op Schedules gebaseerde crawl voor content die zichzelf bijwerkt. Test opnieuw na elke betekenisvolle toevoeging in plaats van alles in één keer te bulkloaden.
7. Rol uit en monitor wat er wordt geëscaleerd. Ga live op je website of supportportaal. Wat daarna wordt geëscaleerd, is een directe kaart van wat er nog ontbreekt in je knowledgebase — behandel het als een geprioriteerde takenlijst, niet alleen als een logboek.
Voor een bredere blik op het bouwen-versus-kopen-landschap buiten deze ene workflow, zie het bouwen van aangepaste AI-chatbots voor supportteams . Het uitbrengen van de eerste versie beëindigt het proces ook niet — de teams die de top-quartile-resultaten van McKinsey behalen, behandelen de knowledgebase als iets dat ze wekelijks bijwerken, niet als iets dat ze één keer opzetten en daarna met rust laten.
Conclusie
De repetitieve laag supporttickets is geen personeelsprobleem, het is een routeringsprobleem. Dezelfde 20 vragen hebben geen groter team nodig dat ze sneller beantwoordt; ze moeten überhaupt niet meer bij een mens terechtkomen. Een op kennis gebaseerde chatbot, uitgerold in kleine, geteste stappen in plaats van één grote uitrol, doet precies dat: hij absorbeert het repetitieve volume, escaleert eerlijk naar een echt kanaal wanneer hij niet kan helpen, en wordt nauwkeuriger telkens als je toevoegt waarop hij is aangesloten. Of je de rekensom nu bekijkt via kosten per ticket, verloop onder agenten of de uren die het vrijmaakt voor de tickets die echt menselijk oordeel nodig hebben, het wijst dezelfde kant op.
Zet je Customer Service Chatbot in en ontdek hoeveel van je repetitieve laag hij vanaf vandaag van je bord kan halen.
