


En kundservicechattbot är bara så bra som kunskapen den tränats på. Skruvar du på en generisk bot på din webbplats får du generiska svar, och tro oss – kunderna märker det direkt. En ofta citerad undersökning visade att så många som 70 % av användarna har svurit åt en chattbot av ren frustration, och en separat studie beställd av Forrester visade att 30 % av konsumenterna som har en dålig chattbot-upplevelse tar sin affär någon annanstans, avbryter köpet eller berättar för andra om det.
Att bygga en chattbot utifrån din befintliga dokumentation, dina vanliga frågor, hjälpartiklar och produktguider är lösningen här, och det kan ta bara några minuter med rätt AI-byggare för kundservicechattbottar . Här är hur du ansluter din kunskapsbas och driftsätter en supportchattbot på en bråkdel av tiden.
Från regelbaserade botar till kunskapsbaserade chattbottar
Kundservicechattbottar har gått igenom tre distinkta generationer, och det mesta av den frustration kunderna rapporterar går tillbaka till vilken generation ett företag fortfarande sitter fast i.
Generation ett: regelbaserade botar. De allra tidigaste chattbottarna byggdes på beslutsträd, där kunden väljer från en meny av förskrivna alternativ, eller där boten mönstermatchar en handfull förväntade formuleringar. I samma stund som en fråga formuleras annorlunda eller hamnar utanför manuset skulle boten antingen loopa, skjuta fel eller dela ut ett generiskt icke-svar. Dessa botar förstår inte språk så mycket som de matchar det mot ett fast manus, så allt utanför manuset är en återvändsgränd per design.
Generation två: generiska AI-chattbottar. Att byta ut beslutsträdet mot en allmän LLM löser språkproblemet. Boten kan nu tolka en udda formulerad fråga och svara flytande, men det löser inte kunskapsproblemet. En generisk AI-chattbot vet fortfarande ingenting om verksamheten den representerar. Värre: en LLM utan förankring svarar ofta med självförtroende ändå och producerar ett flytande, trovärdigt klingande svar som helt enkelt är fel. Den främsta källan till frustration här är gapet mellan vad kunden behöver och vad boten faktiskt vet.
Generation tre: kunskapsbaserade chattbottar och chattbottar med realtidsinternet. En kunskapsbaserad chattbot löser båda problemen samtidigt. I stället för att skriva manus för varje möjlig samtalsväg, eller förlita dig på vad en LLM råkade lära sig under träningen, ansluter du dokumentationen du redan underhåller, och eventuellt realtidsinternet, och boten söker i det innehållet live, vid varje fråga. Varje svar speglar dina faktiska policyer och erbjudanden i stället för en förskriven meny eller en generisk, oförankrad gissning.
Du kan se samma underliggande tillvägagångssätt i praktiken i FlowHunts ChatGPT med intern kunskap -demo, som besvarar frågor live med hjälp av FlowHunts egen interna dokumentation. Samma mekanism som en kundvänd supportbot körs på, bara riktad mot ditt innehåll i stället.
Steg för steg: Bygg din första supportchattbot
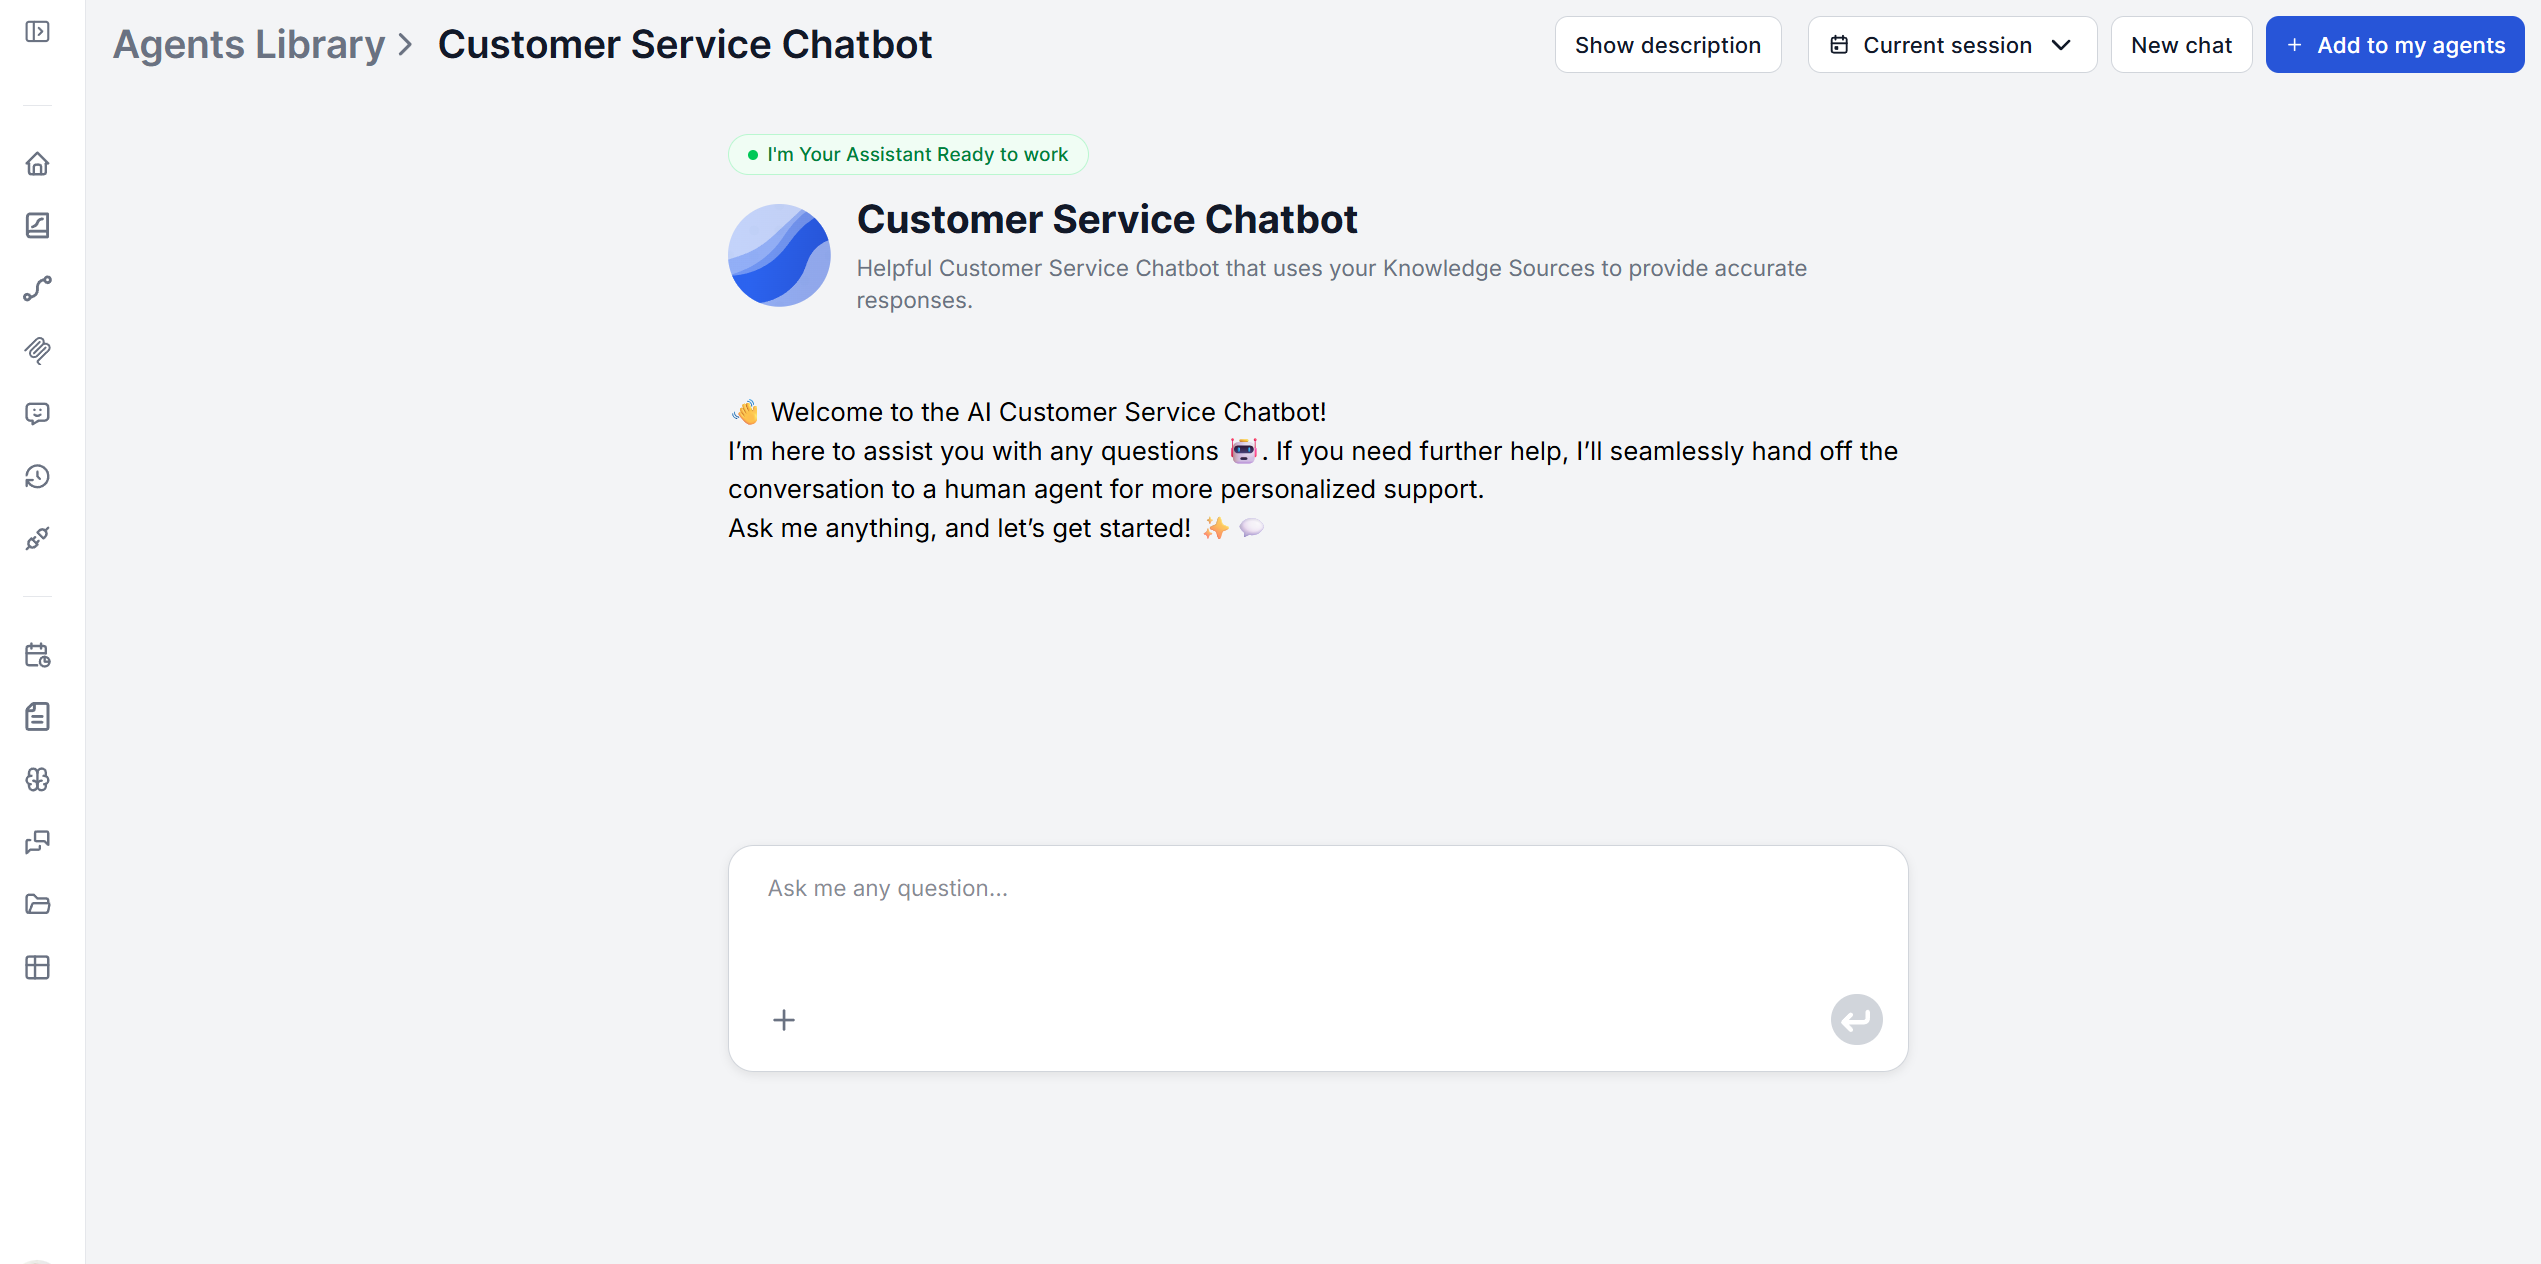
Att bygga en kunskapsbasförankrad supportchattbot handlar om sex steg.
1. Ställ in schemalagda genomsökningar. FlowHunts funktion Scheman låter dig genomsöka och åter-genomsöka ditt publika innehåll automatiskt, så att boten hålls uppdaterad utan manuella återuppladdningar. Rikta ett schema mot din webbplats (domängensökning), din publika dokumentation (sitemap-genomsökning), din prissida eller en annan ofta ändrad sida (genomsökning av enskild URL), eller till och med externa källor som du vill att boten ska hämta från. Ställ in frekvensen – dagligen, veckovis, månadsvis eller årligen – baserat på hur ofta innehållet faktiskt ändras.
2. Ladda upp dina dokument. I FlowHunts funktion Dokument , gå till Dokument, klicka på Lägg till dokument och välj antingen Ladda upp från fil eller Ladda upp från URL. Det här är vägen för proprietär och icke-offentlig kunskap – interna policyer, produktspecifikationer eller supportmanualer som du inte vill (eller kan) publicera offentligt men ändå vill att chattboten ska kunna använda. Indexering tar ett par sekunder per dokument.
3. Lägg eventuellt till realtidsinternet. Att ansluta en sökretriever i realtid, som Google Search eller DuckDuckGo Search, låter boten hämta in livedata för frågor som ditt indexerade innehåll inte täcker. Till skillnad från dina dokument och schemalagda genomsökningar är detta innehåll inte något du har granskat, så det är mycket svårare att kontrollera vad boten till slut citerar eller upprepar för en kund.
4. Konfigurera välkomstmeddelandet och prompten. När en chattsession öppnas hälsar boten besökaren med ett välkomstmeddelande och väntar sedan på deras fråga. Prompten bakom den konversationen är en mall du styr direkt. Den definierar botens persona, ton och vad som händer när en fråga faller utanför kunskapsbasen (mer om det nedan).
5. Testa med riktiga frågor. Innan något går live, kör det genom faktiska tidigare supportfrågor, inte bara de du förväntar dig (se testavsnittet nedan).
6. Driftsätt den. När du är nöjd med svaren, driftsätt chattboten på din webbplats, din supportportal eller vilken plattform som helst som accepterar en inbäddningsbar chattwidget – ingen separat infrastruktur att sätta upp.
För en bredare jämförelse av olika sätt att bygga chattbottar, se bygga anpassade AI-chattbottar för supportteam .

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Vad du bör inkludera i din kunskapsbas för bästa resultat
Chattbottens dokumentkunskapskälla accepterar PDF-, DOCX-, Markdown- och TXT-filer, samt HTML-sidor och YouTube-videor som läggs till via URL. Andra filtyper kan fortfarande laddas upp; de markeras troligen som ett okänt format men kan fortfarande vara användbara.
Några saker gör en betydande skillnad för svarskvaliteten:
- Organisera med kategorier. Gruppera dokument efter ämne (fakturering, onboarding, felsökning) så att hämtningen drar fram den mest relevanta delen i stället för att söka i en platt, odifferentierad hög.
- Prioritera ditt mest trafikerade innehåll först. Vanliga frågor och de mest besökta supportartiklarna ger störst avkastning i träffsäkerhet för minst arbete.
- Håll det uppdaterat. En kunskapsbaserad chattbot är bara så korrekt som dokumenten bakom den. Se vår guide om hur du håller din kunskapsbas uppdaterad för sätt att automatisera den uppdateringen i stället för att göra det manuellt varje gång något ändras.
Ett välskrivet välkomstmeddelande spelar också större roll än det verkar. Det är kundens första signal om att de pratar med något som faktiskt känner till produkten, inte ett generiskt manus. För exempel och mönster, se välutformade välkomstmeddelanden för chattbottar .
Så testar du din chattbot innan den går live
Testa med de frågor kunderna faktiskt ställer. Ta ett urval av riktiga historiska ärenden eller FAQ-inlämningar och kör dem genom boten före lansering.
Passa samtidigt på att verifiera att varje dokument indexerades korrekt i stället för att anta att det fungerade. Du kan granska detta direkt genom att öppna ett dokuments detaljvy och kontrollera dess innehållsträd, vilket visar exakt vad systemet extraherade från filen. Ett dokument som tyst misslyckades med att indexeras korrekt kommer att producera självsäkert felaktiga svar, vilket är värre än inget svar alls.
Testa slutligen felvägen medvetet. Fråga något du vet inte täcks av kunskapsbasen och bekräfta att boten eskalerar elegant i stället för att gissa.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Eskaleringsdesign: När boten lämnar över till en människa
En kunskapsbaserad chattbot bör aldrig bluffa. Prompten bakom FlowHunts kundservicechattbot får uttryckligen instruktionen att om den inte vet svaret ska den erbjuda överlämning till mänsklig support i stället för att hitta på ett svar.
Designa detta medvetet i stället för att lämna det som en eftertanke:
- Bestäm vad “utanför räckvidd” betyder för din kunskapsbas och se till att prompten speglar det.
- Peka fallbacken mot en riktig, övervakad kanal – en supportmejl, ett ärendeformulär eller en livechattkö – inte en återvändsgränd. FlowHunt ansluter också direkt till helpdesk-programvara som du kanske redan kör din eskaleringskö genom, som LiveAgent , via sitt integrationsbibliotek , så att överlämningen kan landa i ett verktyg ditt team redan bevakar i stället för en ny inkorg som ingen kollar.
- Granska konversationer där eskalering utlöstes. De är en direkt signal om luckor i din dokumentation.
Mät framgång för chattboten: Rätt mätvärden
När den är live är varje konversation en datapunkt. Med tanke på hur snabbt en enda dålig chattbot-interaktion kan få en kund att lämna dig eller klaga offentligt, lönar det sig att behandla dessa mätvärden som ett tidigt varningssystem:
- Andel lösta ärenden vs. eskaleringar — hur ofta boten svarar fullständigt kontra lämnar över till en människa. En stigande eskaleringsfrekvens inom ett specifikt ämne betyder oftast en lucka i dokumentationen, inte ett botfel.
- Upprepade frågor och förvirringsmönster — återkommande frågor som boten hanterar dåligt pekar direkt på innehåll som behöver skrivas om eller utökas.
- Kundnöjdhet i bot-hanterade konversationer, spårat separat från konversationer med mänskliga agenter så att du inte blandar ihop de två.
Slutsats
Generiska chattbottar frustrerar kunder eftersom de svarar utifrån ett manus eller en allmän modell i stället för ditt faktiska innehåll. Att ansluta din befintliga kunskapsbas löser det vid källan. Boten svarar utifrån din dokumentation, eskalerar ärligt när den inte vet något, och blir mer korrekt varje gång du uppdaterar det den är ansluten till. De team som får ut mest av en kunskapsbaserad chattbot behandlar testning, granskning av eskaleringar och kunskapsuppdateringar som en pågående vana, inte som en checklista för lansering.
Redo att sätta din egen dokumentation i arbete? Prova kundservicechattboten och förvandla din befintliga kunskapsbas till en supportbot som dina kunder faktiskt kan lita på.
