Lär dig bästa praxis för att kombinera TDD med AI-kodningsagenter som Windsurf och Claude 3.5 Sonnet för att automatisera och effektivisera din mjukvaruutvecklingspipeline.
AI
Test Driven Development
TDD
AI Agents
AutomationWindsurf
Claude 3.5 Sonnet
I grunden kretsar TDD kring en cyklisk process som kallas Red-Green-Refactor. Cykeln börjar med fasen “Red”, där en utvecklare skriver ett automatiserat testfall som definierar en önskad funktion eller ett beteende. Detta test är avsiktligt skrivet för att misslyckas initialt eftersom motsvarande kod ännu inte existerar. Detta inledande misslyckande är avgörande eftersom det säkerställer att testet faktiskt testar den avsedda funktionaliteten och kan fånga fel när koden implementeras.
Den efterföljande “Green”-fasen innebär att skriva minsta möjliga kod som krävs för att få det tidigare misslyckade testet att klara sig. Denna princip uppmuntrar utvecklare att fokusera på det omedelbara krav som testet definierar, hålla kodbasen ren och undvika överkonstruktion.
Slutligen fokuserar fasen “Refactor” på att förbättra struktur, läsbarhet och underhållbarhet för både testkoden och produktionskoden, samtidigt som alla befintliga tester fortsätter att klara sig. Refaktorisering säkerställer att kodbasen förblir hälsosam och anpassningsbar för framtida förändringar utan att introducera regressioner, där den befintliga testsuiten fungerar som ett skyddsnät under denna fas.
Hur automatiserar du din TDD-pipeline fullt ut?
Det finns många faktorer som påverkar prestandan hos AI-agenter vid kodning. Från LLM-modellen till hur du strukturerar din kod och din utvecklingspipeline. Vi har upptäckt att TDD är effektivt med Windsurf och Claude 3.5 sonnet. Följande är en exempeluppgift som implementeras med TDD.
Vad behöver du?
Innan vi börjar koda behöver vi följande:
Tillräckligt med tester
Se till att du redan har tester enligt TDD, och att de täcker det mesta av omfattningen av ditt problem som du anser är logisk och hjälpsam för AI-agenten. Du behöver inte ändra eller anpassa något för AI-agentens skull. Om dina tester och deras namngivningskonvention bygger på en standard är det ännu bättre. Som första steg kommer AI-agenten att se dessa tester för att börja implementera.
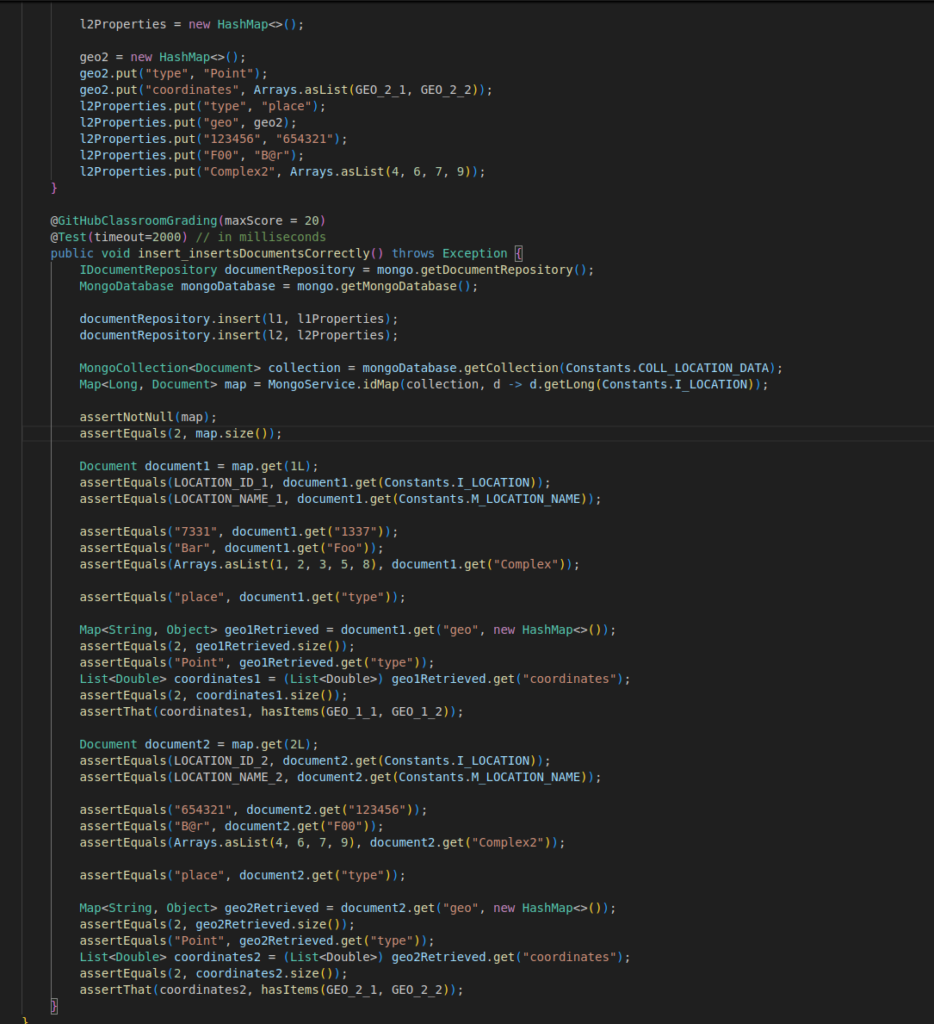
Här är ett exempel på ett test jag har som testar om ett dokument har blivit korrekt infogat i MongoDB:
Gränssnitt
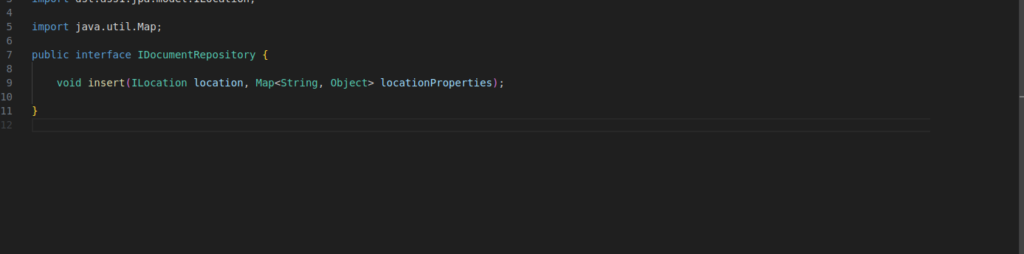
Ett gränssnitt i Java (eller något annat programmeringsspråk) är en struktur som definierar hur klasserna ska se ut och vilka metoder de ska implementera. För att guida AI-agenten ännu mer kan det vara hjälpsamt att skapa ett gränssnitt för din repository för att infoga dokument:
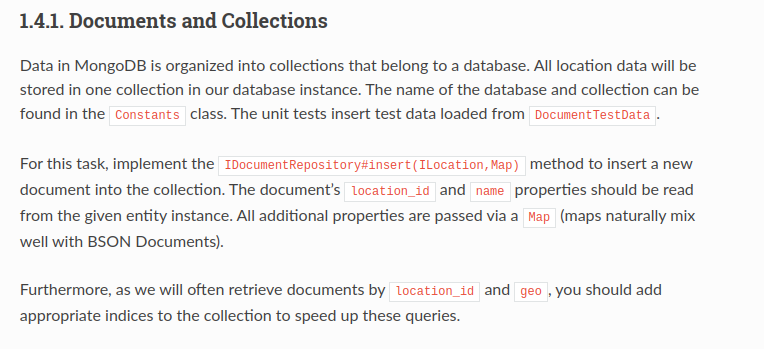
Specifik arbetsbeskrivning
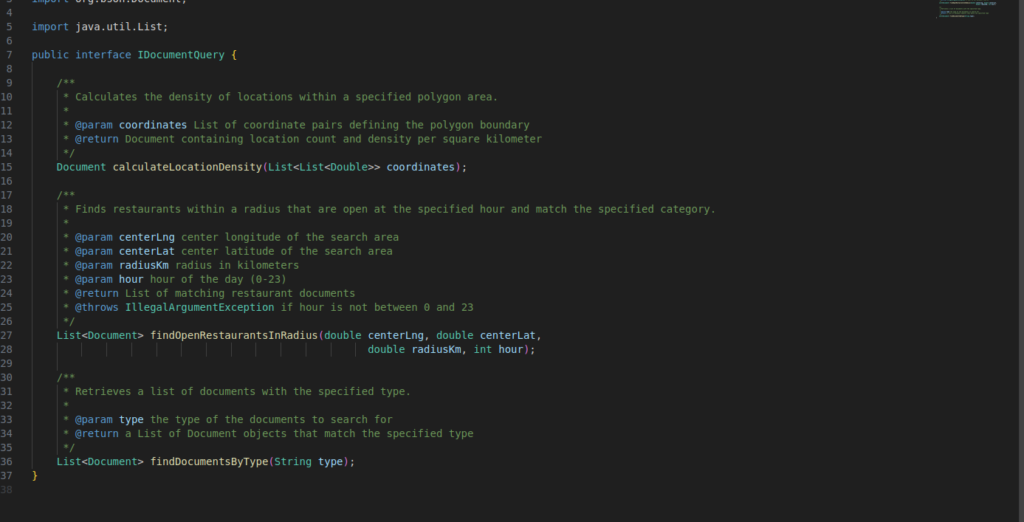
Slutligen behöver vi en specifik arbetsbeskrivning. Vanligtvis kan du använda JIRA eller GitHub-ärenden där du definierar uppgiften. Här är vår:
Starta Vibe Coding
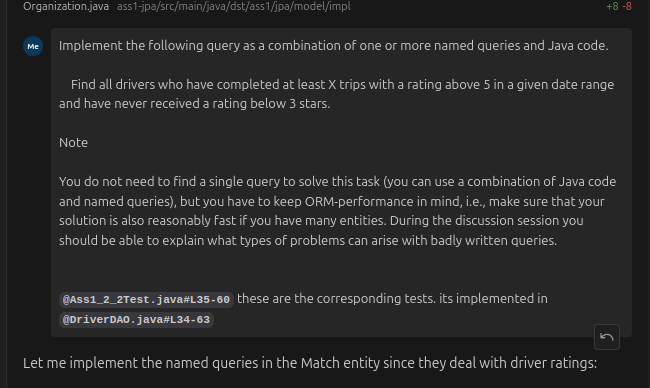
Vibe coding innebär att du beskriver vad du behöver på vanlig engelska (eller till och med röstkommandon), och AI genererar koden åt dig i realtid. Vi går in mer på Vibe Coding i denna blogg. Här är prompten jag använde i Windsurf för att slutföra uppgiften åt mig:
Implementera följande fråga som en kombination av en eller flera namngivna frågor och Java-kod.
Hitta alla förare som har slutfört minst X resor med ett betyg över 5 under ett givet datumintervall och som aldrig har fått ett betyg under 3 stjärnor.
Notera: Du behöver inte hitta en enda fråga för att lösa denna uppgift (du kan använda en kombination av Java-kod och namngivna frågor), men du måste ha ORM-prestanda i åtanke, dvs säkerställ att din lösning också är rimligt snabb om du har många entiteter. Under diskussionssessionen ska du kunna förklara vilka typer av problem som kan uppstå med dåligt skrivna frågor.
@Ass1_2_2Test.java#L35-60 detta är motsvarande tester. Det är implementerat i @DriverDAO.java#L34-63
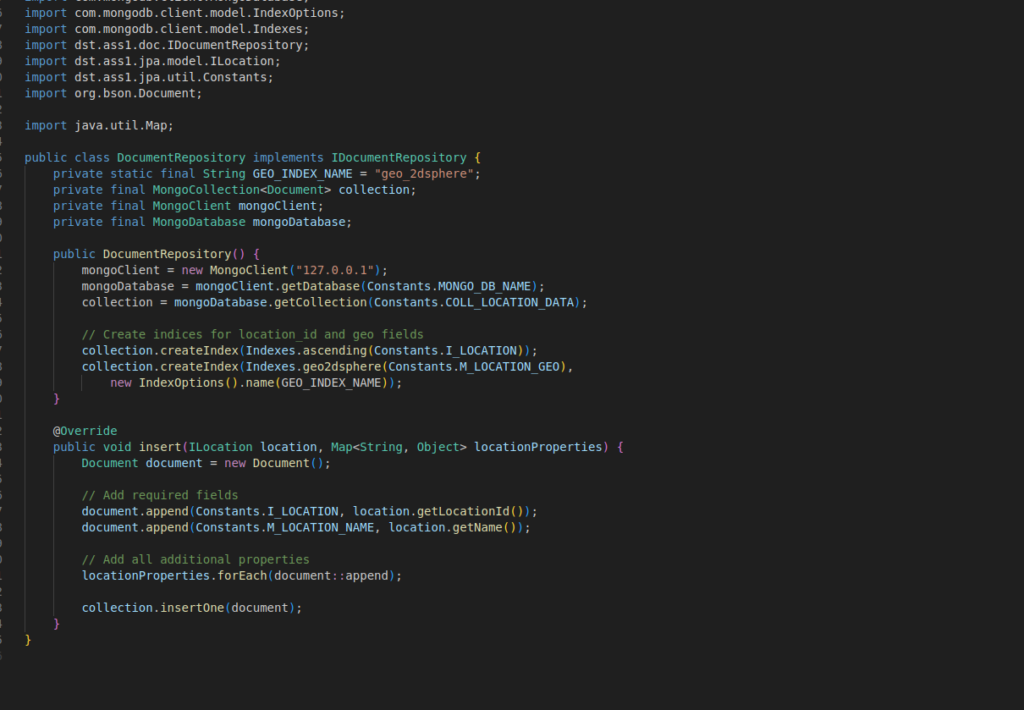
Att nämna filerna är den viktigaste aspekten när du kör vibe coding. Nu är det bara att luta sig tillbaka och se AI-agenten göra sitt. Den implementerade klassen, körde testerna och itererade för att få testerna att gå igenom:
Vanliga frågor
Testdriven utveckling (TDD) är en mjukvaruutvecklingsmetod där automatiserade tester skrivs innan själva koden. Processen följer en Red-Green-Refactor-cykel: skriva ett misslyckat test (Red), implementera kod för att klara testet (Green), och sedan refaktorisera koden samtidigt som alla tester fortsätter att klara sig.
AI-agenter som Windsurf, särskilt när de kombineras med modeller som Claude 3.5 Sonnet, kan automatisera kodgenerering, köra tester och genomföra iterativa förbättringar, vilket gör TDD-processen snabbare och mer effektiv.
För att automatisera TDD med AI-agenter behöver du en heltäckande uppsättning tester, tydligt definierade gränssnitt och specifika arbetsbeskrivningar. Standardiserad testnamngivning och tydlig dokumentation hjälper AI-agenten att ge optimala resultat.
Vibe Coding är ett AI-drivet arbetssätt där utvecklare beskriver krav på vanlig engelska (eller med röst), och AI genererar kod i realtid, itererar tills alla tester klarar sig och lösningen uppfyller kraven.
Yasha är en skicklig mjukvaruutvecklare som specialiserar sig på Python, Java och maskininlärning. Yasha skriver tekniska artiklar om AI, prompt engineering och utveckling av chattbotar.
Yasha Boroumand
CTO, FlowHunt
Boost din utveckling med AI-agenter
Upptäck hur FlowHunts AI-flödesingenjörer och kodningsagenter kan automatisera din utvecklingsprocess för maximal effektivitet och innovation.
Claude Sonnet 4.5 och Anthropics färdplan för AI-agenter: Förändrar produktutveckling och utvecklararbetsflöden
Utforska Claude Sonnet 4.5:s banbrytande funktioner, Anthropics vision för AI-agenter och hur det nya Claude Agent SDK omformar framtiden för mjukvaruutveckling...
Vad en kontextmotor faktiskt ger dig: Vi körde 22 AI-kodgranskare på fem olika sätt
Samma pull request, samma prompt, samma modell — bara kontextinladdningen skilde sig. En kontextmotorsammanfattning plus en policyfilläsning slog dokumentläsnin...
Terminal-Bench: Utvärdering av AI-agenter på verkliga terminaluppgifter
Upptäck hur Terminal-Bench revolutionerar utvärderingen av AI-agenter genom att testa språkmodeller på verkliga terminaluppgifter, från kodning till systemautom...
18 min läsning
AI
Benchmarking
+3
Cookie-samtycke Vi använder cookies för att förbättra din surfupplevelse och analysera vår trafik. See our privacy policy.