


Manuell eiendomsresearch — å sjekke flere annonsesider, kopiere data inn i regneark og sammenligne priser — tar timer. En AI-skraper for eiendomsdata gjør det manuelle og repeterende automatisk, og overlater bare vurderingen og skjønnet til deg. Her er hvordan du henter ut strukturerte eiendomsdata i stor skala, og hva du kan bruke dem til.
Hvorfor manuell eiendomsresearch er en tidssluke
Eiendomsresearch er i bunn og grunn et dataproblem. En enkelt annonse forteller deg prisen, størrelsen og noen få egenskaper. For å forstå om annonsen faktisk er god verdi, trenger du kontekst. Du trenger å vite hvordan medianprisen ser ut for tilsvarende eiendommer i samme område. Er prisene på vei opp eller ned? Hvilke nabolag er i fremvekst?
Å svare på disse spørsmålene manuelt betyr å åpne flere annonseplattformer, filtrere på kriteriene du bryr deg om, registrere hvert resultat, normalisere dataene slik at prisene er sammenlignbare på tvers av kilder, filtrere bort duplikater og utdaterte annonser, og deretter gjøre selve sammenligningsarbeidet.
For ett enkelt marked bruker den prosessen lett en hel arbeidsdag, og i det øyeblikket du må sammenligne to områder, eller følge det samme markedet over ulike tidsperioder, multipliseres innsatsen. I tillegg skalerer ikke manuell research, og den holder seg ikke oppdatert.
Et AI-verktøy for eiendomsskraping automatiserer hele prosessen. Det samler inn, renser og analyserer i én gjennomkjøring. Resultatet er en strukturert rapport med innsikt i stedet for et rotete regneark fullt av rådata.
Hvordan AI-basert eiendomsskraping fungerer
Begrepet “skraping” i sammenheng med AI-verktøy for eiendom dekker mer enn bare å hente data fra annonsesider. En AI-innsamler av eiendomsdata kjører en full datapipeline:
Datainnsamling — verktøyet spør pålitelige nettplattformer og API-er og samler annonser på tvers av målmarkedet eller regionen du angir. Det håndterer dekning fra flere kilder samtidig.
Datarensing og normalisering — rå annonsedata er inkonsistente på tvers av plattformer. Priser kommer i ulike formater, eiendomstyper merkes forskjellig, og noen felt mangler eller er duplisert. AI-en standardiserer disse før analysen, slik at hver eiendom i datasettet er sammenlignbar på samme grunnlag.
Mønstergjenkjenning og analyse — det rensede datasettet analyseres for prisfordelinger, tilgjengelighetstrender og korrelasjoner mellom eiendomsegenskaper (størrelse, beliggenhet, fasiliteter) og pris.
Rapportgenerering — funnene settes sammen til en strukturert rapport med oversikt over datasettet, nøkkeltall, trendanalyse og innsikt i mønstre.
I motsetning til en rå eksport fra et enkelt verktøy for eiendomsskraping, produserer en AI for uthenting av eiendomsdata analyse sammen med dataene. Pristrender, avvik, underprisede områder og markedsmønstre løftes frem automatisk i stedet for å overlates til deg å regne ut fra rå eksporter.

Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Hvilke data kan hentes ut fra annonser
En arbeidsflyt for automatisering av eiendomsdata henter ut og strukturerer flere typer data fra eiendomsannonser:
Prisdata: gjennomsnitts- og medianpriser i datasettet, prisfordeling etter eiendomstype, pris per kvadratmeter og avviksdeteksjon.
Eiendomsegenskaper: eiendomstype (bolig, leilighet, enebolig, næring), størrelse, antall soverom og bad, sentrale fasiliteter.
Beliggenhetsmønstre: prisforskjeller mellom by og forstad, prisvariasjon etter nabolag eller område, nye nabolag der prisene stiger raskere enn markedet rundt, og områder som fremstår som underpriset sammenlignet med tilsvarende steder.
Markedsdynamikk: annonsevolum, mønstre for liggetid og sesongmessige markedsskifter som påvirker både tilgjengelighet og prising.
Korrelasjoner: hvilke eiendomsegenskaper som har sterkest sammenheng med pris i et gitt marked. Dette er nyttig for å vurdere om en bestemt annonse er riktig priset i forhold til de faktiske egenskapene.
Hvor dypt det hentes ut data på, avhenger av hva som er tilgjengelig i kildedataene. Markeder med høy annonseaktivitet og detaljerte eiendomsbeskrivelser gir rikere analyser enn tynne markeder.
Steg for steg: din første datauthenting for eiendom
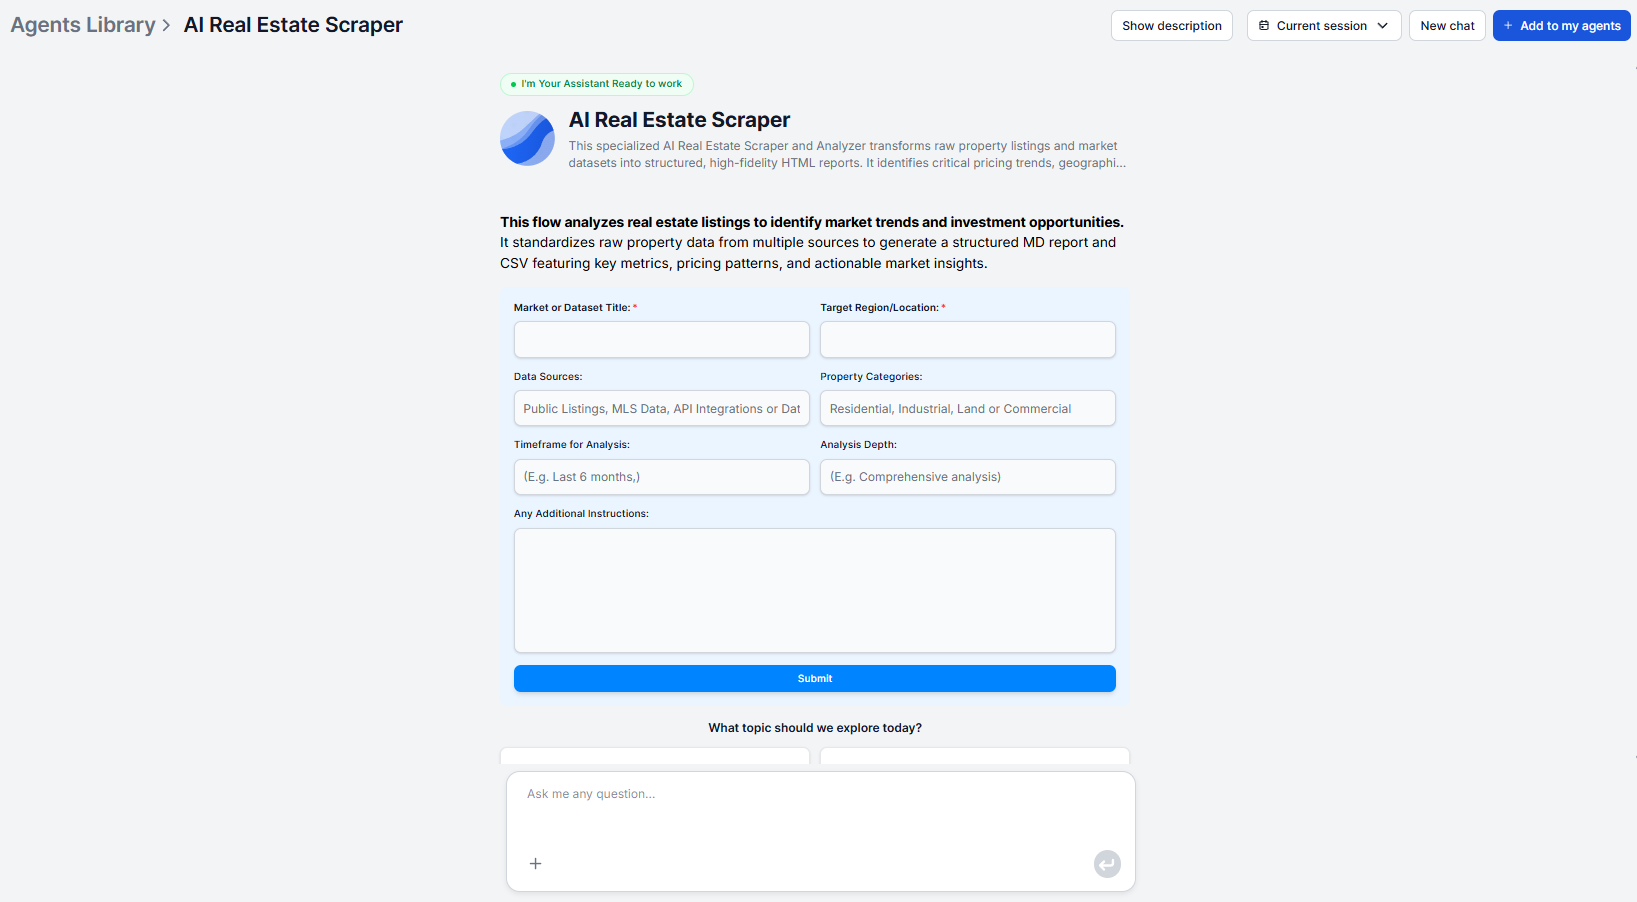
AI-skraperen for eiendom er laget for å være enkel. Du trenger ikke konfigurere datakilder, skrive skraperegler eller sette opp en renseprosess, fordi arbeidsflyten håndterer alt dette. Om du vil, kan du angi kildene du foretrekker eller legge til ditt eget datasett.
Steg 1: Angi målmarkedet ditt
Skriv inn en beskrivelse av målmarkedet eller regionen. “Boligeiendommer i Austin, TX” eller “leiligheter i sentrale Berlin” er nok som utgangspunkt. Hvis du vil ha mer fokuserte resultater, kan du være mer spesifikk og be om et bestemt nabolag, prisintervall eller eiendomstype. Du kan også legge inn dine egne datasett eller strukturerte filer som skal inngå sammen med data hentet fra nettbaserte kilder.
Steg 2: Datainnsamlingen kjører automatisk
Verktøyet spør pålitelige nettplattformer og API-er og samler annonser som samsvarer med omfanget du har angitt, fra flere kilder samtidig. Du trenger ikke kjøre separate søk på ulike annonsesider og avstemme resultatene manuelt.
Steg 3: Dataene renses og normaliseres
Før noen analyse skjer, standardiseres de innsamlede annonsene. Prisformater normaliseres, eiendomstyper mappes til konsistente kategorier, og data om kvadratmeter og fasiliteter tilpasses. Ufullstendige, dupliserte eller upålitelige oppføringer filtreres bort.
Steg 4: Mønstergjenkjenning og generering av innsikt
Det strukturerte datasettet analyseres for prismønstre, tilgjengelighetstrender og korrelasjoner mellom eiendomsegenskaper og pris. Verktøyet identifiserer både makromønstre (overordnet markedsprising, fordeling etter eiendomstype) og signaler på mikronivå (nabolag med ny prismomentum, underprisede eiendommer, avvik).
Steg 5: Gå gjennom den strukturerte rapporten
Resultatet er en strukturert rapport som dekker:
- En oversikt over datasettet med omfang og kildesammendrag
- Nøkkeltall, som gjennomsnittspriser, medianstørrelser og fordeling av eiendomstyper
- Trendanalyse av prismønstre, sesongvariasjoner og dynamikk mellom by og forstad
- Innsikt i mønstre om avvik, underprisede områder, korrelasjoner og potensielle investeringssignaler
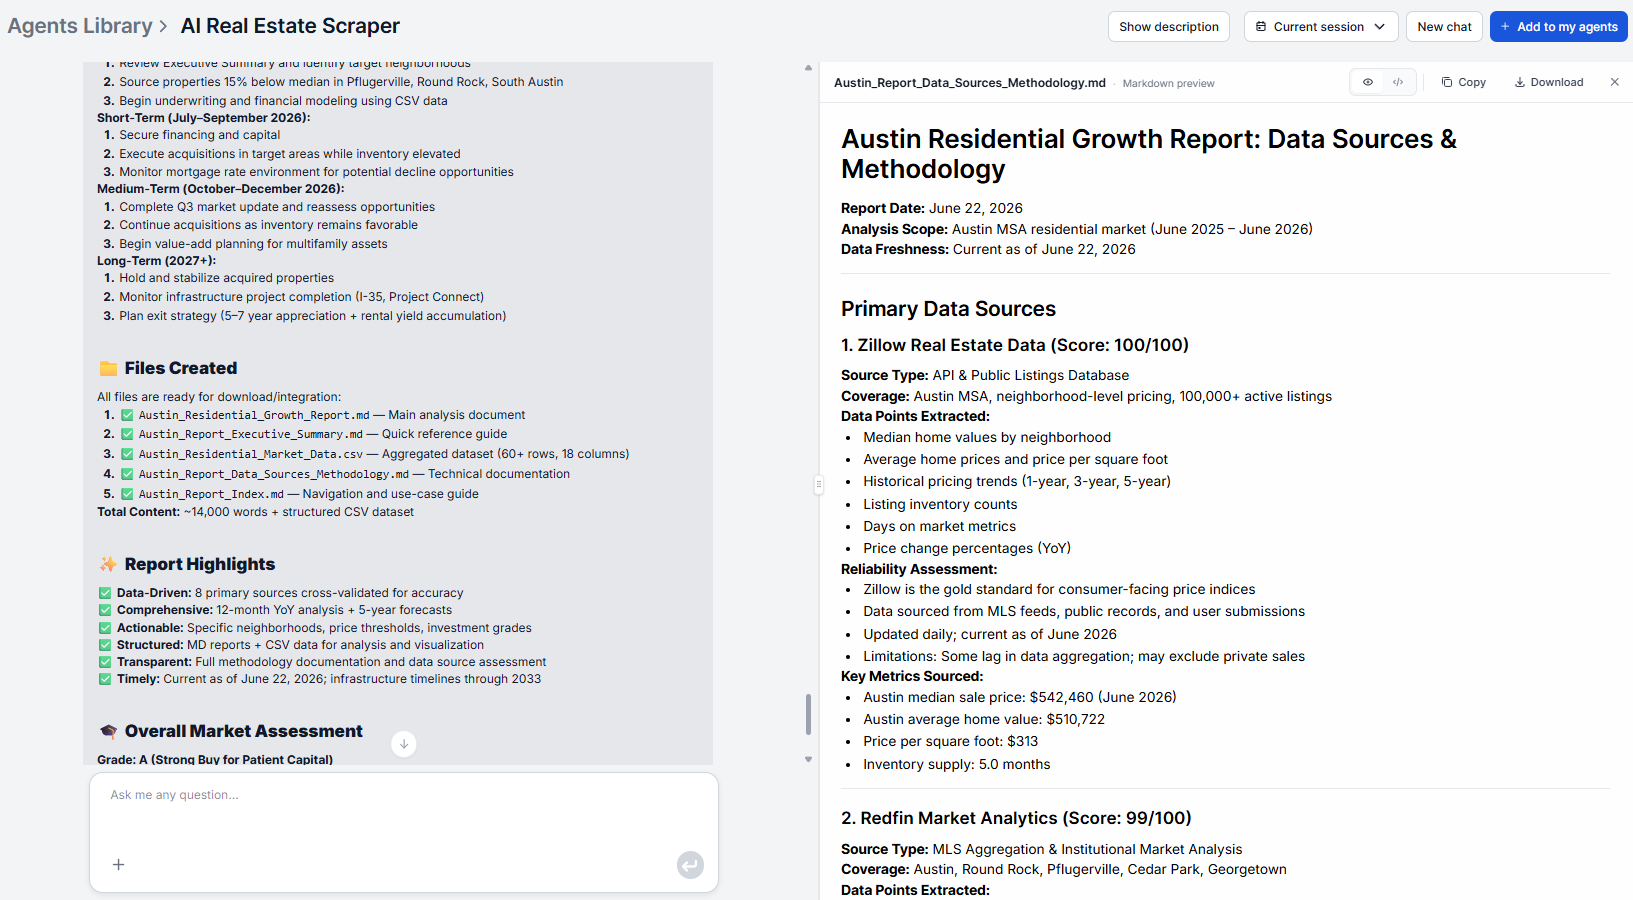
Verktøyet kan settes opp til å levere resultater direkte inn i et CMS, en investorportal, et dashbord eller et analysesystem. Alt du trenger å gjøre er å koble til verktøyet ditt og sørge for at utdataformatet støttes.
For en full gjennomgang av grensesnittet og profftips for å få mest mulig nøyaktige resultater, se veiledningen for AI-skraperen for eiendom .
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Brukstilfelle: analyse av markedspriser etter område
En av de mest umiddelbare anvendelsene av en AI for uthenting av eiendomsdata er prisanalyse innenfor et avgrenset geografisk område. I stedet for å ta et utvalg av noen få annonser for å anslå hvor prisene ligger, får du et statistisk fundert bilde av hele markedet.
En investor som vurderer to nabolag i samme by, vil forstå om pristillegget i det ene området er berettiget, eller om det er mulig å få tilsvarende verdi til lavere kostnad. Å kjøre skraperen på begge områder gir en side-om-side-sammenligning av disse egenskapene.
Trendanalysedelen tilfører tidskontekst. Et nabolag med lavere medianpris, men sterk oppadgående trend, kan representere en mer verdifull mulighet enn et med høy nåværende median, men flat utvikling. Dette er mønstrene manuelle analytikere har en tendens til å overse, fordi de krever analyse av et tilstrekkelig stort utvalg.
Brukstilfelle: finne muligheter utenfor markedet
Ikke alle muligheter kommer fra en annonse som allerede er riktig priset. Avviks- og underprisdeteksjonen som er innebygd i en AI-skraper for eiendomsannonser, løfter frem eiendommer og nabolag der dataene tyder på et prisgap sammenlignet med tilsvarende områder.
Deteksjon av underprisede områder fungerer ved å sammenligne et nabolags egenskapsprofil med den faktiske prisingen relativt til sammenlignbare områder. Når prisingen er lavere enn egenskapsprofilen skulle tilsi, registreres det som en potensiell mulighet.
Dette er automatisering av eiendomsdata anvendt på et analysenivå som er upraktisk å gjøre manuelt. Å identifisere disse signalene krever sammenligning av mønstre på tvers av store sett med annonser samtidig, ikke bare gjennomgang av noen få sider med resultater.
For team som arbeider på organisasjonsnivå og vurderer eiendomsselskaper, utviklere eller PropTech-plattformer i et målmarked, gir en kombinasjon av denne eiendomsnivå-innsikten og verktøyet for selskapsanalyse et fyldigere bilde av både markedet og de sentrale aktørene som opererer i det.
Hvordan strukturere og analysere de uthentede dataene
Rapporten er strukturert for umiddelbar bruk, men hvordan du tar den i bruk, avhenger av arbeidsflyten din.
For investeringsbeslutninger: delen med nøkkeltall, altså prisfordelinger, medianstørrelser og oppdeling etter eiendomstype, gir det statistiske grunnlaget. Innsikt i mønstre tilfører det kvalitative laget, som hvilke områder som flagges som underprisede, hvilke korrelasjoner som er sterke nok til å påvirke oppkjøpskriterier, og mer.
For kundevendte markedsrapporter: utdataene kan settes opp til å gå direkte inn i et CMS eller en investorportal.
For løpende markedsovervåking: å kjøre verktøyet etter en definert frekvens og sammenligne utdata over tid bygger et langsgående bilde av markedsdynamikken. Pristrender blir synlige over lengre tidshorisonter, og nye nabolag kan følges fra tidlige signaler.
For integrering i bredere research: analysen på eiendomsnivå er ett lag i en full due diligence- eller investeringsresearch-prosess. Kombinert med konkurrentanalyse innen eiendom og innsikt på markedsnivå dekker det hele bildet, fra enkeltannonser til konkurransebildet.
Den underliggende flyten kan også endres. Hvis du trenger å fokusere på bestemte eiendomstyper, justere hvilke nøkkeltall som løftes frem, koble til verktøyene dine eller endre utdatastrukturen så den passer rapporteringsformatet ditt, kan arbeidsflyten tilpasses uten å bygges opp på nytt fra bunnen av.
For å se hvordan ulike profesjonelle (meglere, investorer, utviklere) bruker disse resultatene i hverdagen, se 5 måter eiendomsprofesjonelle bruker AI-basert dataskraping .
