


Ten samouczek generatora dokumentacji FlowHunt przeprowadzi Cię przez proces generowania pierwszego ustrukturyzowanego dokumentu technicznego na podstawie prawdziwego kodu źródłowego, od początku do końca. AI Documentation Writer przyjmuje Twój kod oraz kilka danych kontekstowych i zwraca kompletny dokument obejmujący architekturę, przepływ logiki i instrukcje użycia — bez konieczności ręcznego pisania pierwszego szkicu. Oto dokładny proces, krok po kroku.
Krok 1: Przygotuj kod źródłowy i kontekst
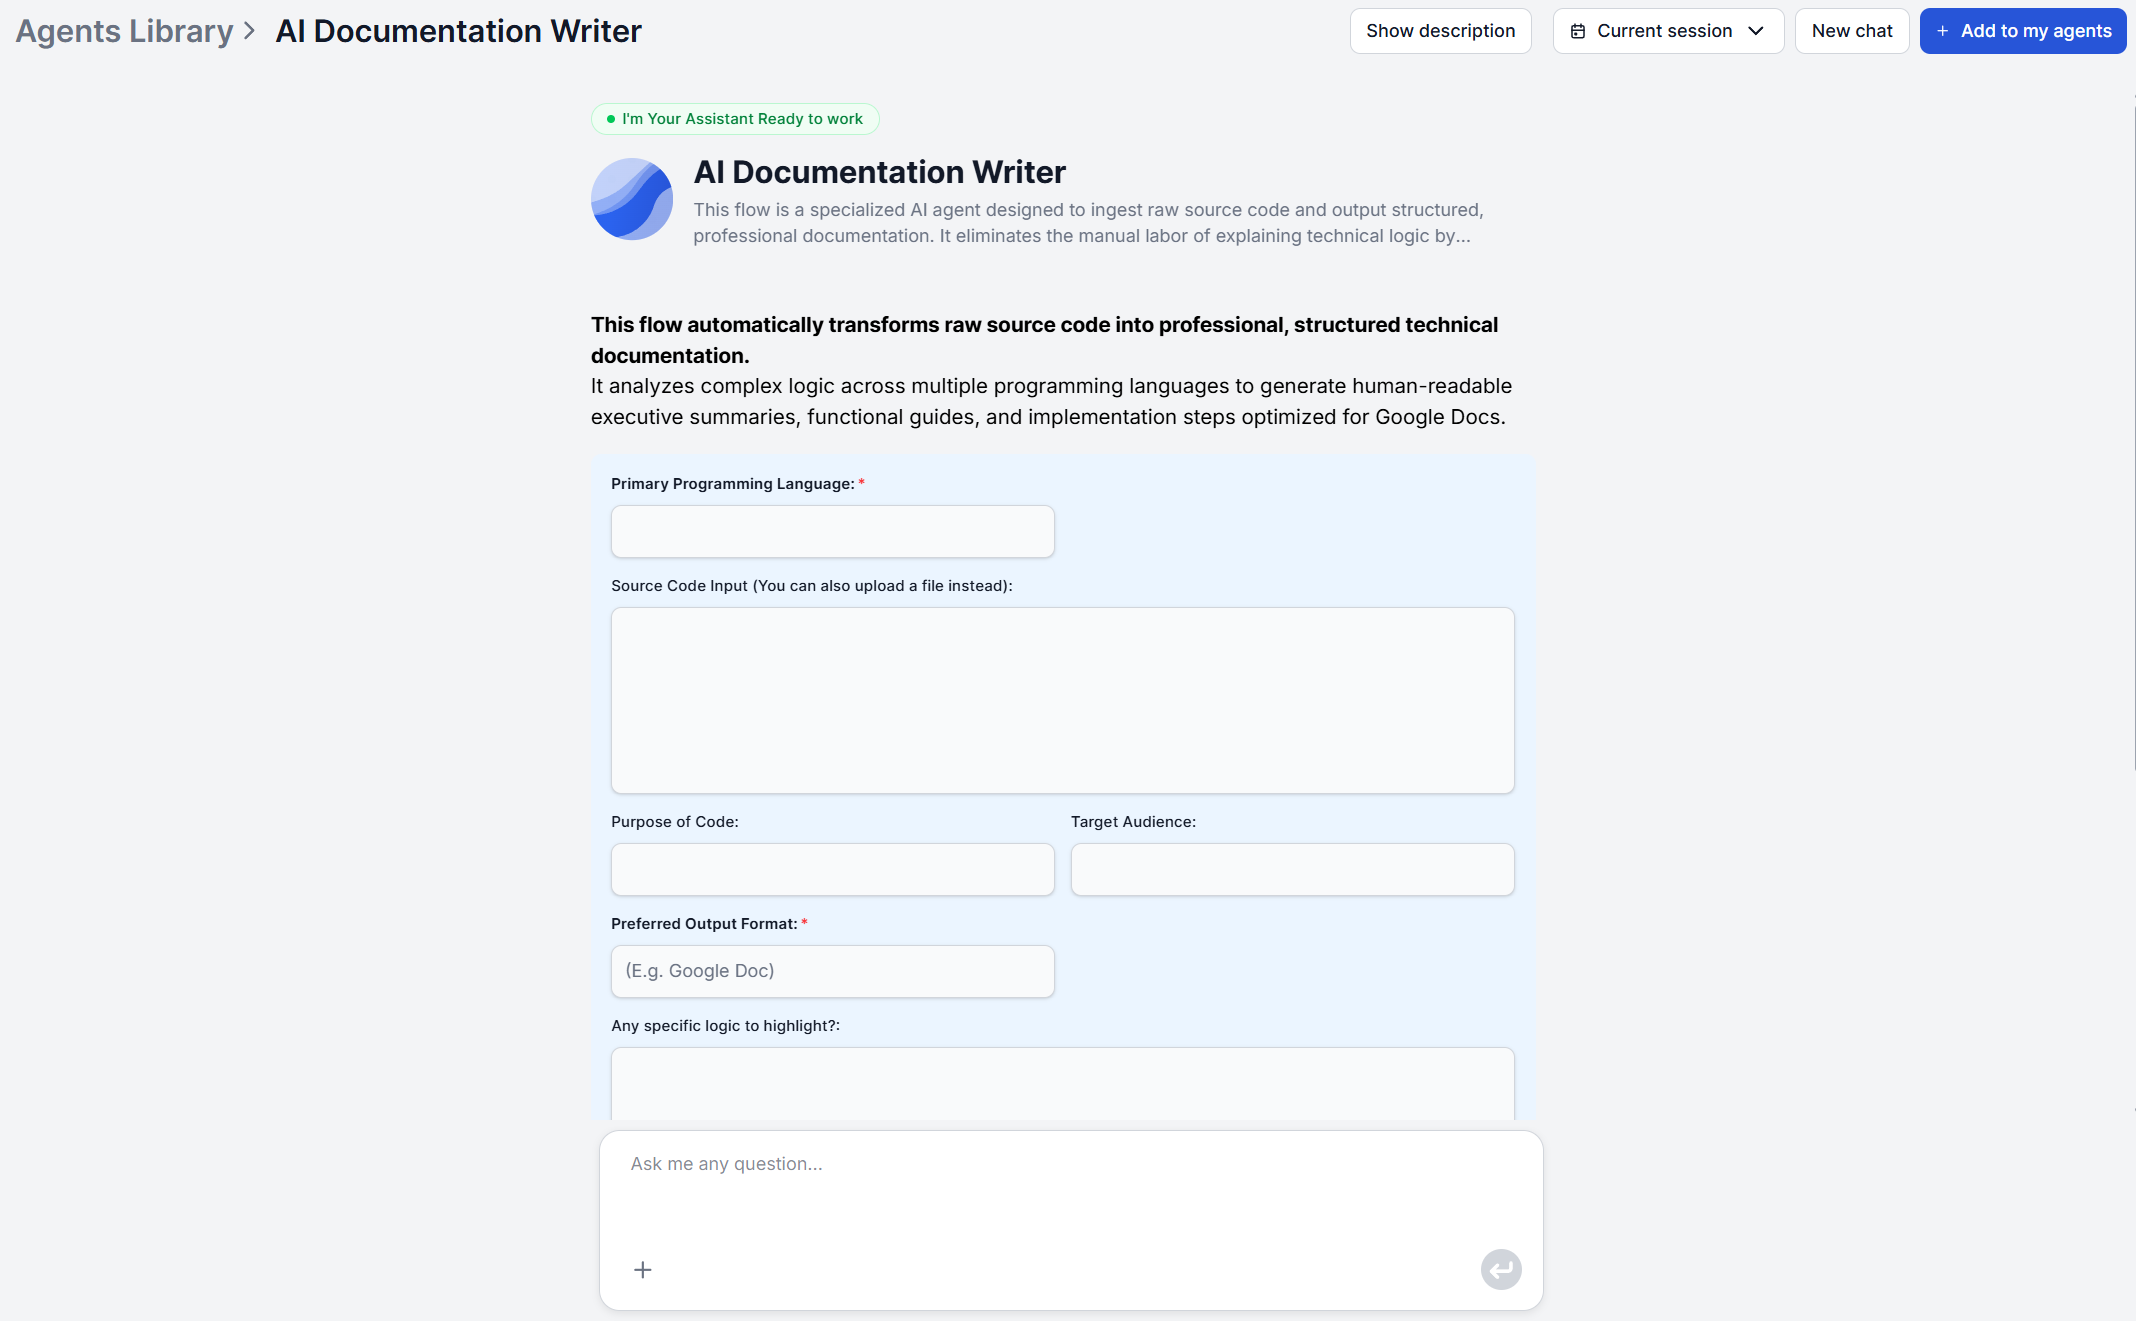
Wyszukaj AI Documentation Writer w swojej Bibliotece agentów i dodaj go do swoich agentów. Weź swój kod źródłowy i albo wklej go bezpośrednio do czatu, albo prześlij jako plik. To jedyne dane wejściowe, których narzędzie naprawdę potrzebuje do pracy. Analizuje kod, a nie opis napisany w jego miejsce.
Chcesz wypróbować narzędzie za darmo, zanim się zdecydujesz? Wystarczy, że przejdziesz przez ten link
Obok kodu warto też podać główny język programowania, cel kodu (zdanie prostym językiem o tym, co robi i po co istnieje), grupę docelową oraz preferowany format wyjściowy.
Pełny plik jest idealny, ale nie jest wymagany. Fragment kodu lub niekompletna baza kodu również się sprawdzą, ponieważ narzędzie wnioskuje najbardziej prawdopodobny zamiar z tego, co mu dostarczysz, zamiast zatrzymywać się na brakującym kontekście.
Ma to znaczenie dla tego, jak określisz zakres pierwszego uruchomienia. Jeśli dokumentujesz małe narzędzie, wklej całość. Jeśli pracujesz z większym serwisem, wybierz plik lub moduł reprezentujący tę część, którą faktycznie chcesz udokumentować, zamiast wrzucać całe repozytorium naraz.
Krok 2: Ustaw cel i format wyjściowy
Wprowadź cel kodu i preferowany format wyjściowy razem z kodem źródłowym. Nie ma osobnego menu wyboru „typu dokumentu” — każde uruchomienie tworzy tę samą kompletną strukturę. Streszczenie dla zarządu, możliwości funkcjonalne, architektura techniczna, przepływ logiki i proces, kluczowe funkcje i komponenty oraz instrukcje wdrożenia i użycia.
To, co się zmienia między uruchomieniami, to sposób wypełnienia tych sześciu sekcji. Cel taki jak „wewnętrzny skrypt wdrożeniowy dla pipeline’u wydawniczego” w przeciwieństwie do „publiczna metoda SDK dla zewnętrznych programistów” kieruje etap analizy dokumentu ku szczegółom istotnym dla tego przypadku użycia.

Gotowy na rozwój swojej firmy?
Rozpocznij bezpłatny okres próbny już dziś i zobacz rezultaty w ciągu kilku dni.
Krok 3: Ustaw grupę docelową (ton i głębokość)
Określ, dla kogo jest dokument. Dla programistów, klientów czy osób nietechnicznych? Możesz też być bardziej konkretny, na przykład „młodsi inżynierowie dopiero poznający tę bazę kodu” lub „personel wsparcia bez doświadczenia w programowaniu”.
To pojedyncze dane wejściowe napędzają etap tłumaczenia logiki, który zamienia operacje techniczne na wyjaśnienia prostym językiem, dopasowane do wskazanych odbiorców. Ten sam kod źródłowy daje zauważalnie inny dokument w zależności tylko od tego pola, więc warto być precyzyjnym, a nie wpisywać domyślnie „programiści” z przyzwyczajenia.
Jeśli istnieje konkretny fragment logiki, którego narzędzie nie powinno pominąć — przepływ uwierzytelniania, mechanizm ograniczania liczby żądań, przypadek brzegowy łatwy do przeoczenia przy pierwszym czytaniu — wymień go również tutaj. Zostanie włączony do analizy, zamiast zostać pozostawiony przypadkowi.
Krok 4: Wygeneruj i przejrzyj dokument
Gdy kod i kontekst są wprowadzone, generowanie przebiega w trzech etapach. Analiza kodu interpretuje funkcjonalność, tłumaczenie logiki zamienia ją na prosty język dla wskazanych odbiorców, a strukturyzacja dokumentu porządkuje wszystko w hierarchię wyjaśniającą, dlaczego i jak kod działa.
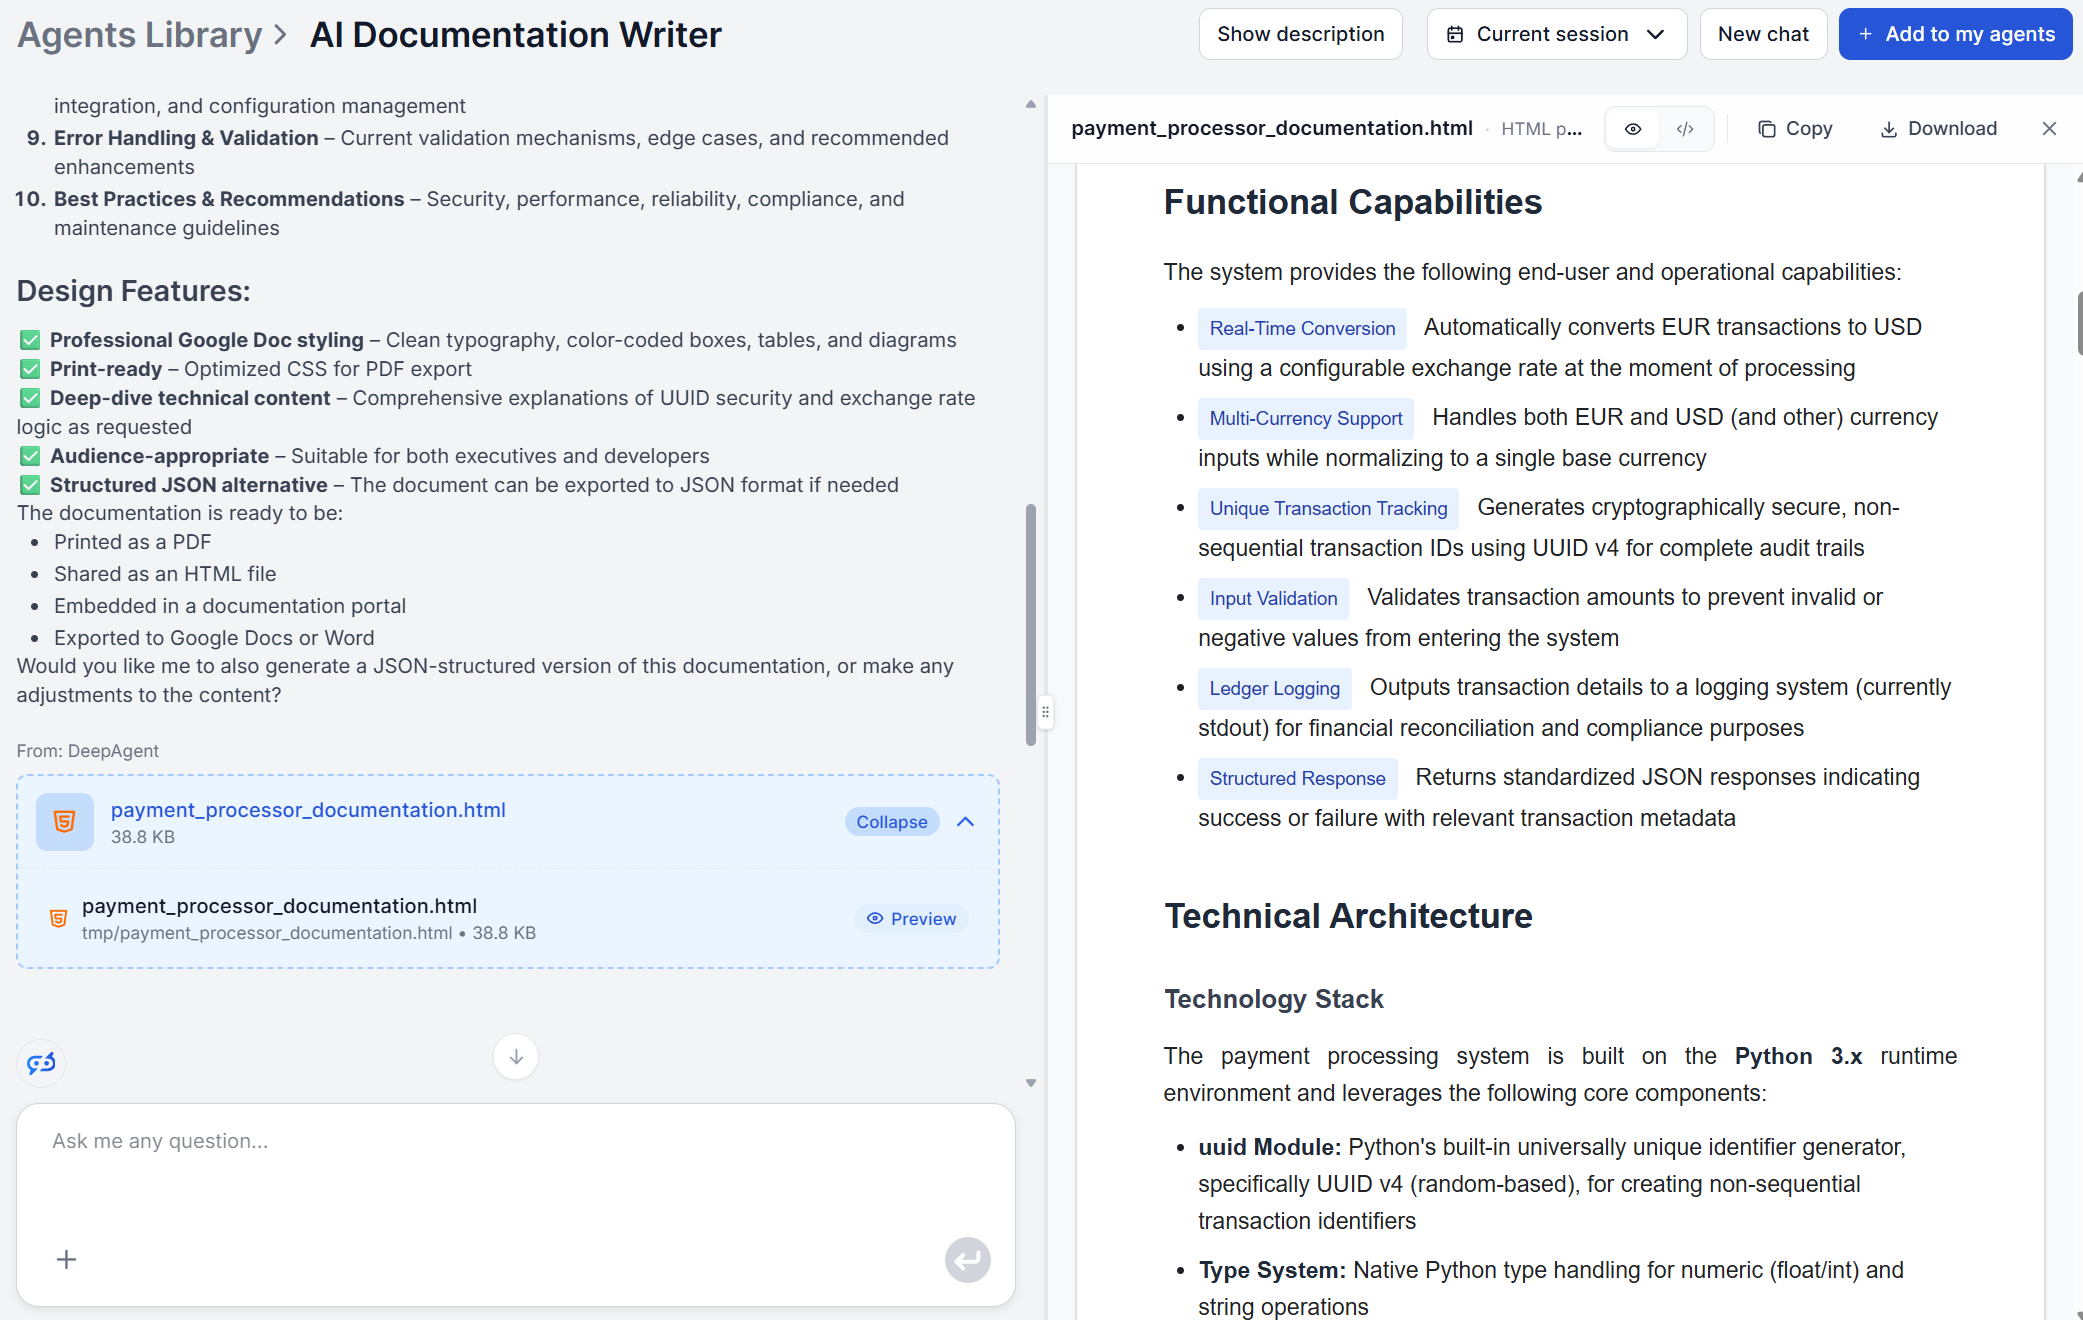
Przeczytaj wynik, zanim uznasz go za ostateczny. Potwierdź, że kroki konfiguracji i ustawień faktycznie działają w realnym środowisku, sprawdź, czy starszy element systemu, którego narzędzie nie mogło wywnioskować z samego kodu, jest opisany trafnie, i zweryfikuj, czy kalibracja odbiorców wypadła tak, jak zamierzałeś.
Sekcje streszczenia dla zarządu i możliwości funkcjonalnych to najszybsza kontrola poprawności, ponieważ są krótkie i łatwo je porównać z tym, co już wiesz. Sekcje architektury technicznej i przepływu logiki zasługują na wolniejsze czytanie, bo właśnie tam niekompletne dane wejściowe najczęściej prowadzą do prawdopodobnie brzmiącego, ale nieco błędnego wniosku.
Dołącz do naszego newslettera
Otrzymuj najnowsze wskazówki, trendy i oferty za darmo.
Krok 5: Udoskonalaj za pomocą konkretnej logiki i przykładów
Jeśli pierwsze przejście pominęło coś kluczowego, łatwiej po prostu ponownie uruchomić generowanie z ostrzejszym wejściem „konkretna logika do wyróżnienia”, wskazującym dokładnie to, co zostało pominięte.
Surowy kod źródłowy jest domyślnie wyłączony z wyniku, ponieważ narzędzie skupia się na wyjaśnianiu, co kod robi, a nie na jego powtarzaniu, ale możesz wyraźnie poprosić o jego uwzględnienie, jeśli Twój przypadek użycia tego wymaga.
Jedno realne ograniczenie warte poznania z góry to fakt, że wynik domyślnie nie zawiera zrzutów ekranu ani diagramów. Możesz dostosować flow agenta, aby uwzględnić narzędzie Photomatic i skonfigurować je do generowania obrazów i diagramów na podstawie tekstu. Jeśli dokumentowana funkcjonalność jest publicznie dostępna, możesz użyć narzędzia Screenshot, aby uzyskać rzeczywisty zrzut ekranu.
Krok 6: Eksportuj i opublikuj
Wynik jest dostarczany w czacie jako załącznik zawierający wybrany przez Ciebie format strukturalny. Jest gotowy do wczytania do systemów dokumentacji, portali dla programistów lub materiałów dla klientów bez ręcznego przeformatowywania.
Aby przenieść go do rzeczywistego workflow, FlowHunt łączy się przez serwery MCP, zamiast wymagać kopiowania i wklejania. Hostowany serwer GitHub MCP może pobrać kod źródłowy prosto z repozytorium na początku procesu, a połączenie z Notion lub hostowanym serwerem Confluence MCP może wypchnąć gotowy dokument do istniejącej wiki Twojego zespołu po jego wygenerowaniu.
Wskazówki eksperta: dane wejściowe, które dają najlepsze wyniki
Bądź konkretny w polu celu. „Obsługuje uwierzytelnianie użytkowników” daje narzędziu znacznie mniej niż „Weryfikuje dane logowania wobec bazy użytkowników i wydaje token sesji, wywoływane przy każdej próbie logowania”.
Dopasuj brzmienie grupy docelowej do rzeczywistego czytelnika. Niejasne dane o odbiorcach dają ogólnie techniczny dokument. Pudło może uczynić go nieużytecznym dla docelowych odbiorców. Zbyt techniczny wynik przestraszy użytkowników końcowych, a programiści uznają poradniki dla użytkowników za zbyt powierzchowne. Nie bój się być konkretny, na przykład „agenci wsparcia rozwiązujący problemy z logowaniem”, a nie tylko „nietechniczni”.
Zaznacz, czego brakuje w niekompletnej bazie kodu. Jeśli wklejasz tylko jeden plik z większego systemu, powiedz o tym w polu celu. Narzędzie nadal wnioskuje zamiar z niekompletnych danych wejściowych, ale ostrzeżenie o tym, co jest poza zakresem, powstrzymuje je przed zgadywaniem kontekstu, którego nie ma.
Podsumowanie
Długo po tym, jak wszyscy zaczęli generować niechlujne artykuły o ogólnych tematach, dokumentacja techniczna pozostawała zadaniem wyłącznie ludzkim. Wynikało to z konieczności dostarczenia AI danych własnościowych i zapewnienia, że rozumie je wystarczająco dobrze, by tworzyć wartościowy wynik. Teraz i to należy do przeszłości. Potrzebujesz zaledwie dziesięciu minut, aby przejść od danych wejściowych do przejrzanego pierwszego szkicu.
Wygeneruj swój pierwszy dokument za darmo i zobacz, ile z tego pierwszego szkicu przetrwa edycję. Pełny mechanizm stojący za tym, dlaczego ten proces działa tak, jak działa, znajdziesz w jak automatycznie pisać dokumentację techniczną z AI , a jeśli chodzi o uchwycenie kontekstu, który żyje całkowicie poza kodem, generator raportów ze spotkań AI zamienia nagrany przegląd w ustrukturyzowane notatki, które możesz podać do następnego uruchomienia.
Więcej typów dokumentacji, które ten sam proces dobrze obsługuje, znajdziesz w pięć typów dokumentacji, które AI pisze szybciej .
Poznaj więcej workflow w akademii .