


Ce tutoriel sur le rédacteur de documentation FlowHunt vous guide pas à pas dans la génération de votre premier document technique structuré à partir de code source réel, du début à la fin. Le Rédacteur de documentation IA prend votre code ainsi que quelques entrées contextuelles et renvoie un document complet couvrant l’architecture, le flux logique et les instructions d’utilisation, sans que vous ayez à écrire la première version à la main. Voici le processus exact, étape par étape.
Étape 1 : préparez votre code source et votre contexte
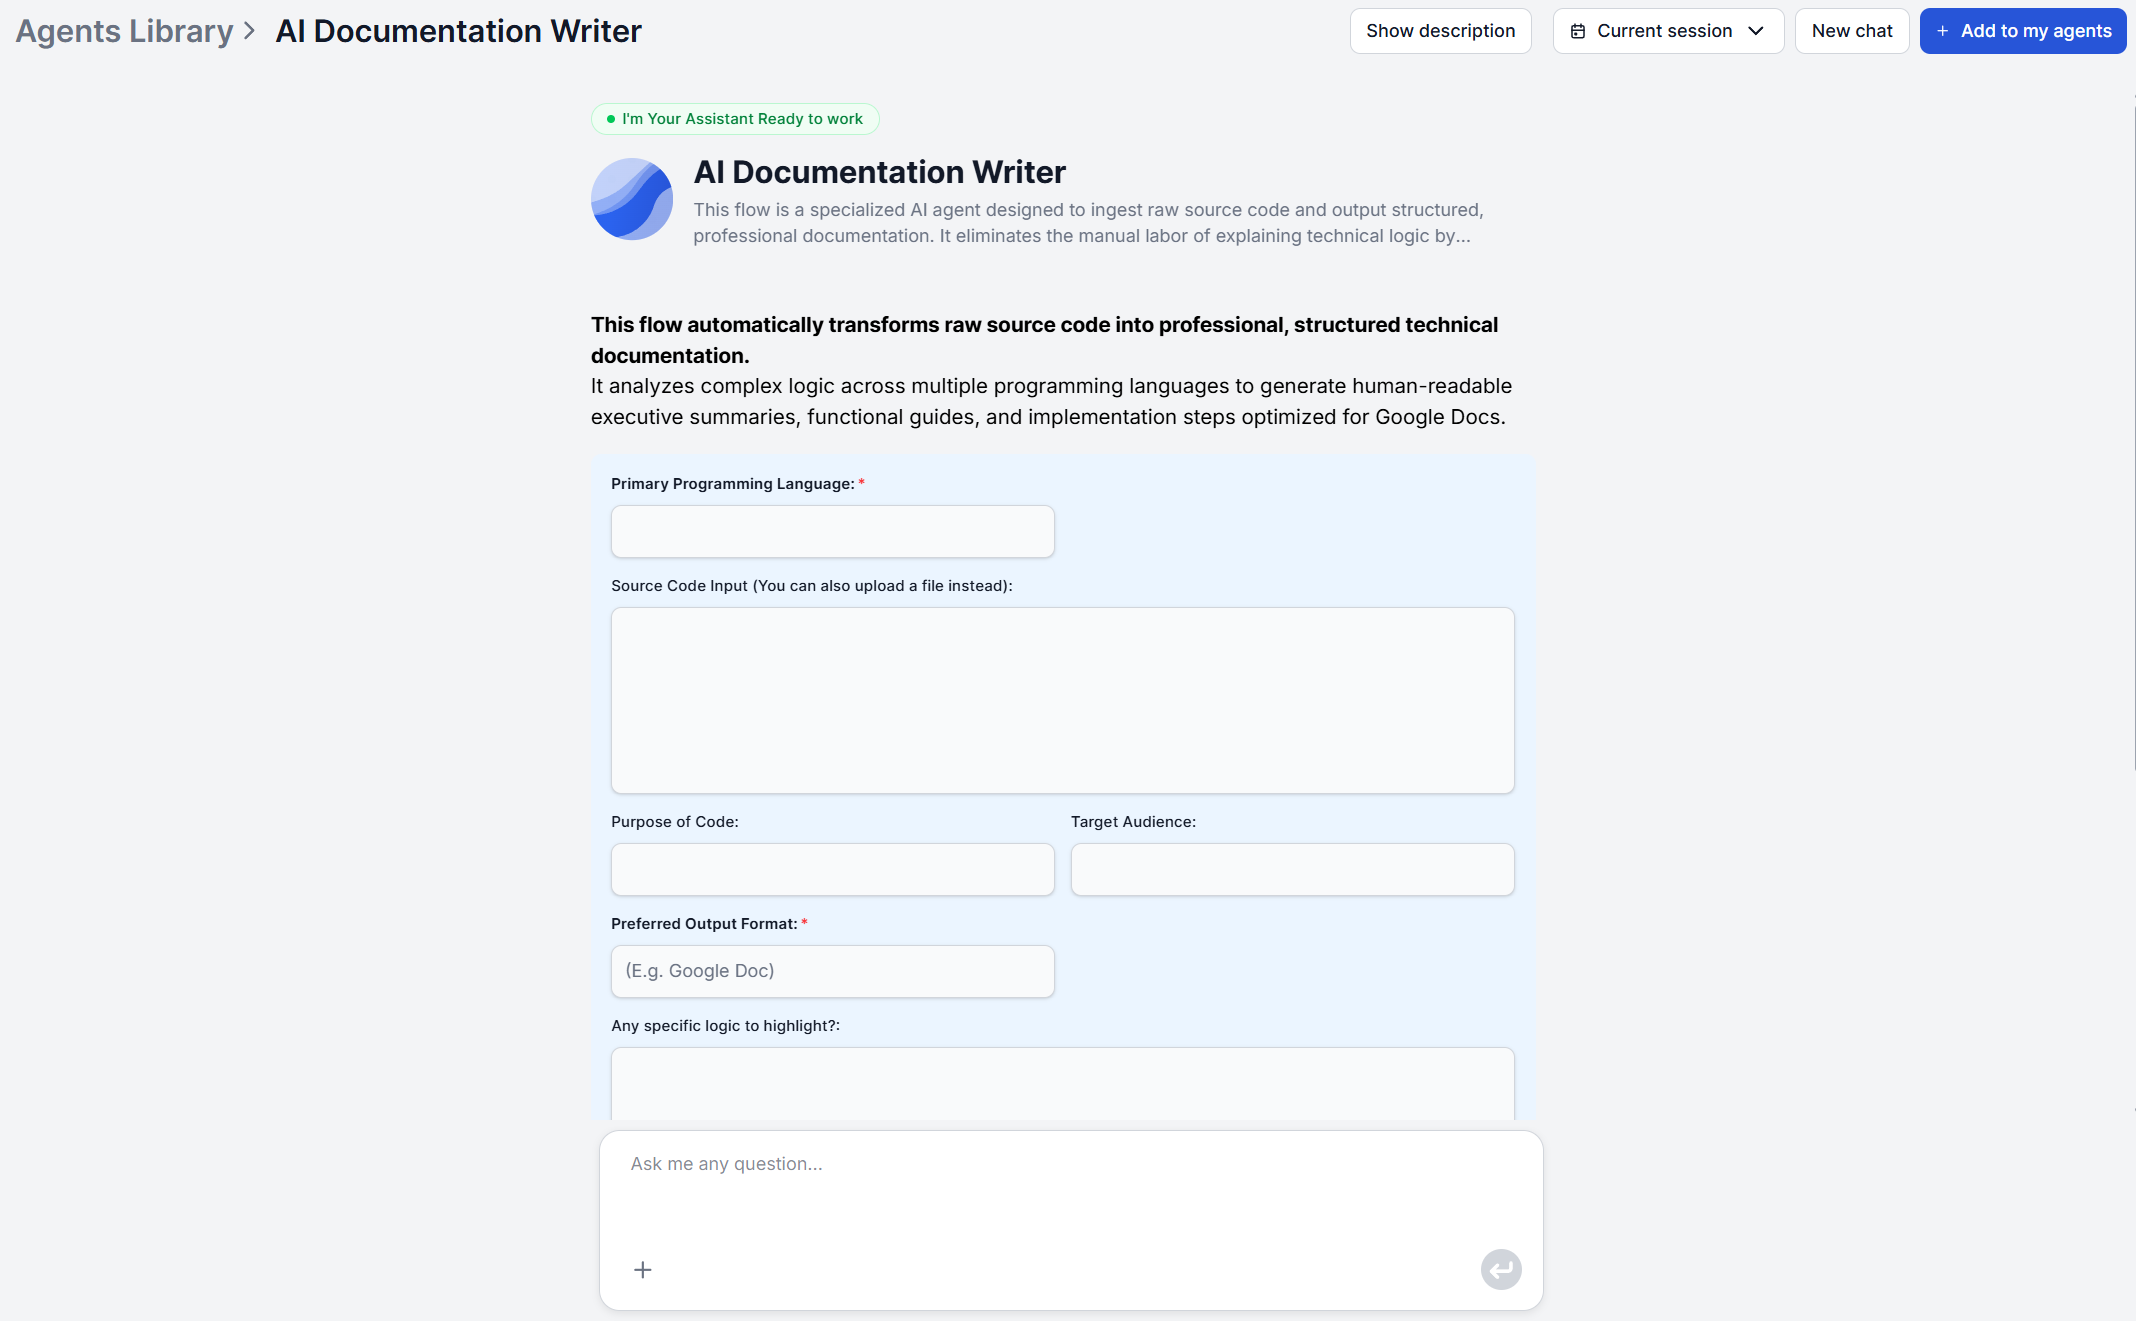
Recherchez le Rédacteur de documentation IA dans votre bibliothèque d’agents et ajoutez-le à vos agents. Prenez votre code source et collez-le directement dans le chat ou importez-le sous forme de fichier. C’est la seule entrée dont l’outil a réellement besoin pour fonctionner. Il analyse le code, pas une description écrite à sa place.
Vous souhaitez essayer l’outil gratuitement avant de vous engager ? Suivez simplement ce lien
En plus du code, vous devriez idéalement renseigner également le langage de programmation principal, l’objectif du code (une phrase en langage clair sur ce qu’il fait et pourquoi il existe), votre public cible et votre format de sortie préféré.
Un fichier complet est idéal, mais ce n’est pas obligatoire. Un extrait partiel ou une base de code incomplète fonctionnent aussi, puisque l’outil déduit l’intention la plus probable à partir de ce que vous fournissez plutôt que de se bloquer sur un contexte manquant.
Cela compte pour la façon dont vous délimitez votre première exécution. Si vous documentez un petit utilitaire, collez-le en entier. Si vous travaillez sur un service plus volumineux, choisissez le fichier ou le module qui représente l’élément que vous devez réellement documenter, plutôt que de déverser un dépôt entier d’un seul coup.
Étape 2 : définissez votre objectif et votre format de sortie
Saisissez l’objectif du code et votre format de sortie préféré en même temps que votre source. Il n’y a pas de menu distinct de « type de document » à choisir : chaque exécution produit la même structure complète. Un résumé exécutif, les capacités fonctionnelles, l’architecture technique, le flux logique et le processus, les fonctions et composants clés, ainsi que les instructions d’implémentation et d’utilisation.
Ce qui change d’une exécution à l’autre, c’est la manière dont ces six sections sont remplies. Un objectif comme « script de déploiement interne pour le pipeline de release » plutôt que « méthode publique du SDK pour des développeurs tiers » oriente l’étape d’analyse du document vers les détails qui comptent pour ce cas d’usage.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Étape 3 : définissez votre public cible (ton et profondeur)
Précisez à qui le document est destiné. Est-il destiné à des développeurs, à des clients ou à des parties prenantes non techniques ? Vous pouvez aussi être plus précis, par exemple « ingénieurs juniors qui découvrent cette base de code » ou « personnel de support sans bagage technique ».
Cette seule entrée pilote l’étape de traduction logique, qui convertit les opérations techniques en explications en langage clair, calibrées pour la personne que vous avez désignée. Le même code source produit un document sensiblement différent selon ce seul champ, il vaut donc la peine d’être précis plutôt que de choisir « développeurs » par habitude.
Si un élément de logique précis ne doit pas être passé sous silence par l’outil — un flux d’authentification, un mécanisme de limitation de débit, un cas limite facile à manquer à la première lecture —, nommez-le ici aussi. Il sera intégré à l’analyse plutôt que laissé au hasard.
Étape 4 : générez et relisez le document
Une fois votre code et votre contexte en place, la génération passe par trois étapes. L’analyse du code interprète la fonctionnalité, la traduction logique la convertit en langage clair pour le public que vous avez précisé, et la structuration du document organise le tout en une hiérarchie qui explique pourquoi et comment le code fonctionne.
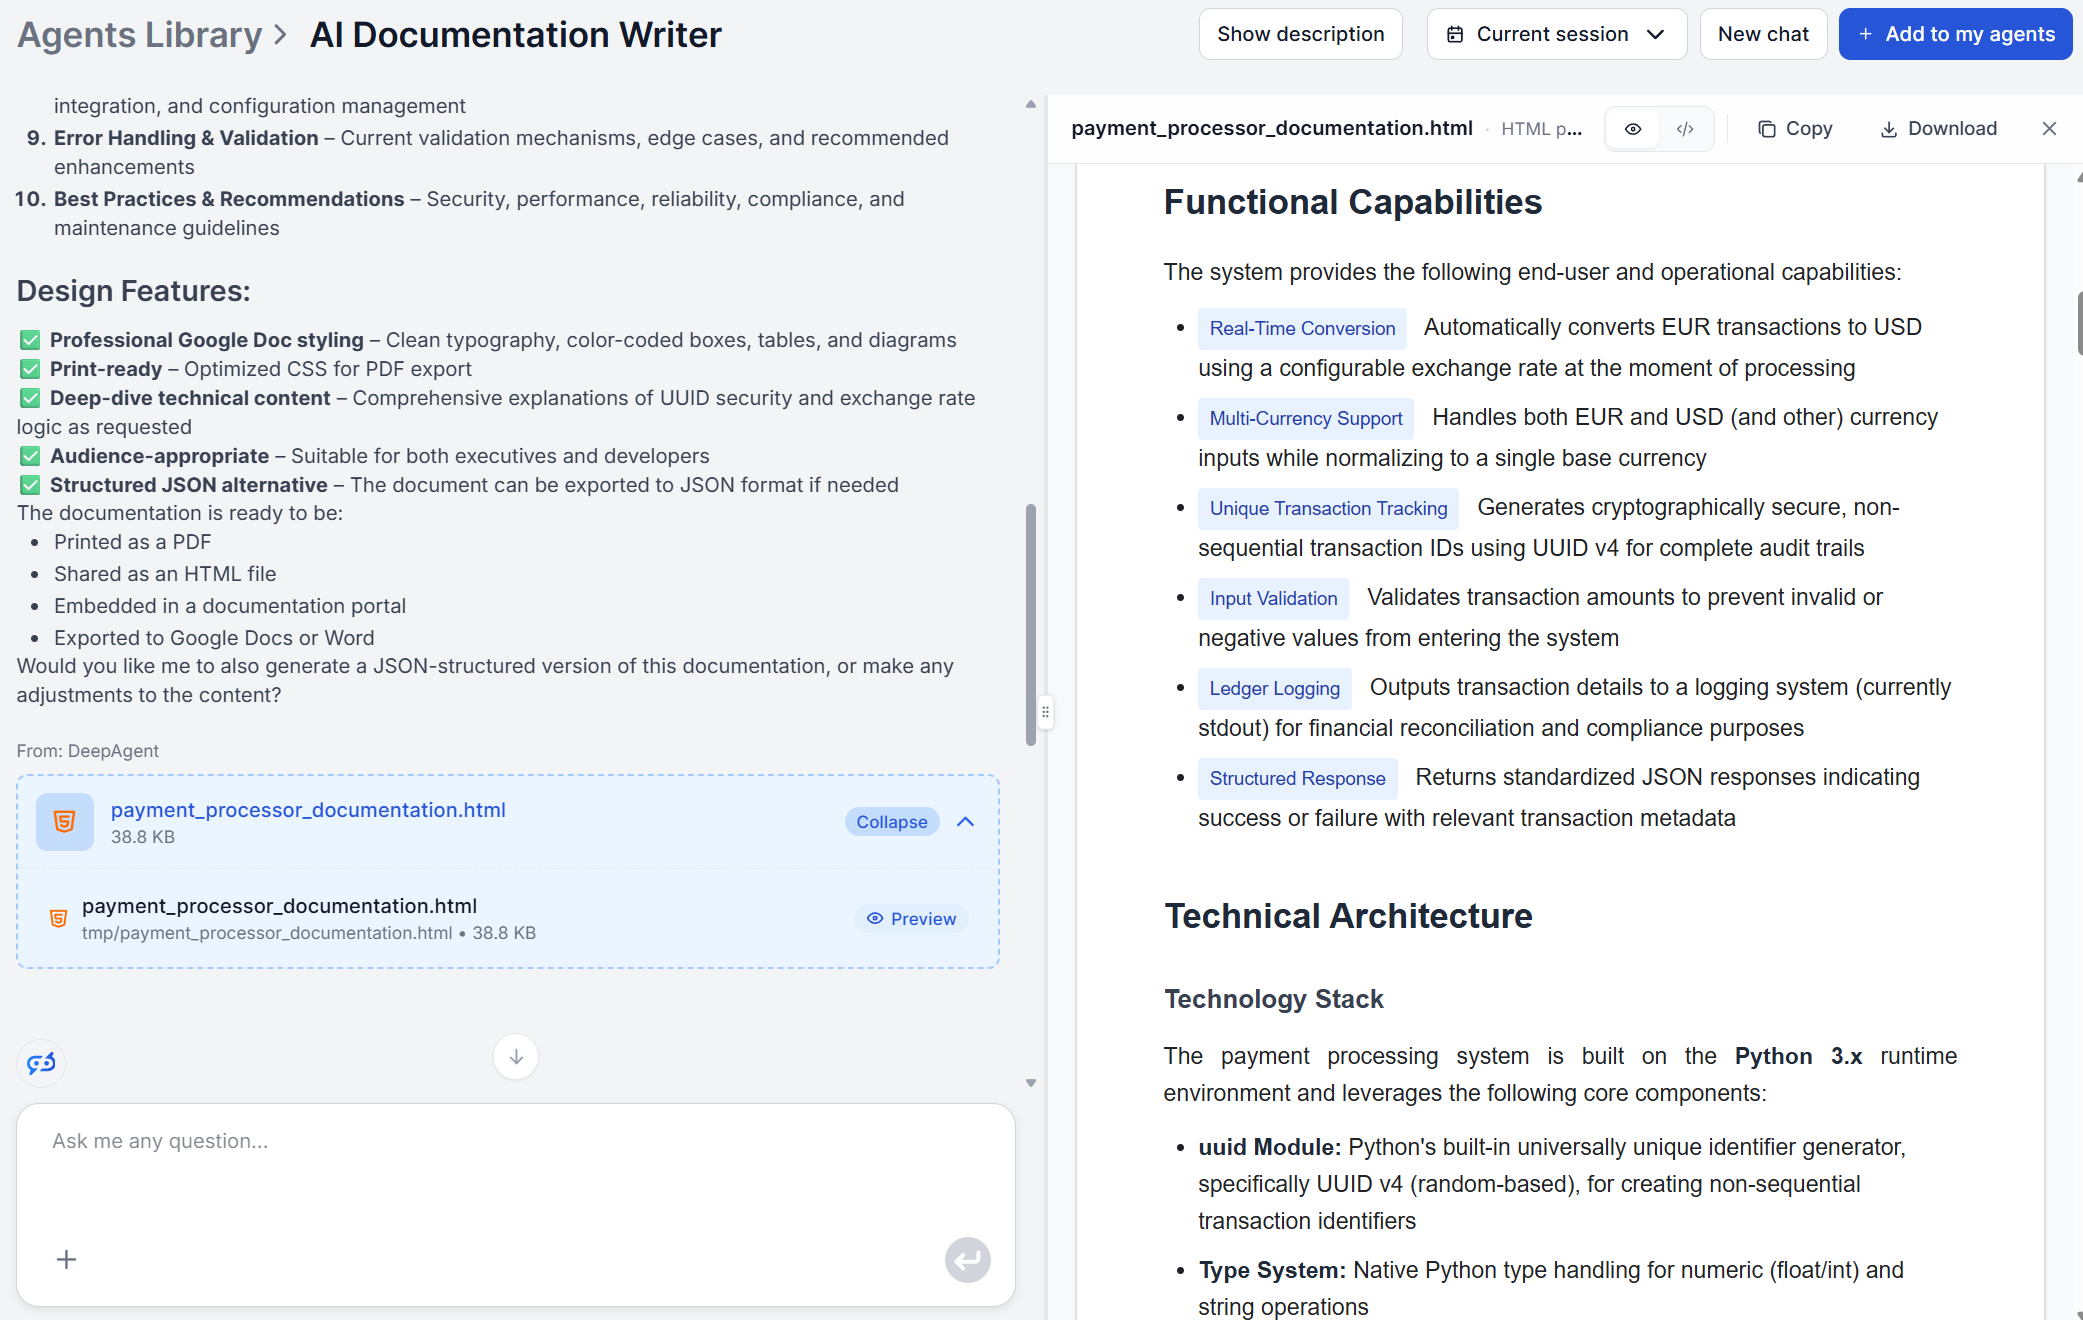
Parcourez le résultat avant de le considérer comme définitif. Vérifiez que les étapes d’installation et de configuration fonctionnent réellement dans un environnement réel, assurez-vous qu’un élément hérité du système que l’outil ne pouvait pas déduire du seul code est décrit avec exactitude, et contrôlez que le calibrage du public correspond à ce que vous vouliez.
Les sections « résumé exécutif » et « capacités fonctionnelles » constituent le contrôle de cohérence le plus rapide, car elles sont courtes et faciles à comparer à ce que vous savez déjà. Les sections « architecture technique » et « flux logique » méritent une lecture plus lente, car c’est là qu’une entrée incomplète a le plus de chances de produire une inférence plausible mais légèrement erronée.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Étape 5 : affinez avec une logique spécifique et des exemples
Si la première passe oublie quelque chose de crucial, il est plus simple de relancer la génération avec une entrée « logique spécifique à mettre en avant » plus précise, nommant exactement ce qui a été manqué.
Le code source brut est exclu de la sortie par défaut, puisque l’outil se concentre sur l’explication de ce que fait le code plutôt que sur sa reproduction, mais vous pouvez explicitement demander son inclusion si votre cas d’usage l’exige.
Une limitation réelle qu’il vaut la peine de connaître d’emblée : la sortie n’inclut pas de captures d’écran ni de schémas par défaut. Vous pouvez ajuster le flux de l’agent pour inclure l’outil Photomatic et le configurer pour générer des images et des schémas à partir du texte. Si la fonctionnalité documentée est accessible publiquement, vous pouvez utiliser l’outil de capture d’écran pour obtenir une véritable capture d’écran.
Étape 6 : exportez et publiez
La sortie est livrée dans le chat sous forme de pièce jointe contenant le format structuré de votre choix. Elle est prête à être ingérée dans des systèmes de documentation, des portails développeurs ou des livrables clients, sans reformatage manuel.
Pour l’intégrer à votre workflow réel, FlowHunt se connecte via des serveurs MCP plutôt que d’exiger du copier-coller. Un serveur MCP GitHub hébergé peut extraire le code source directement d’un dépôt au début du processus, et une connexion Notion ou serveur MCP Confluence hébergé peut pousser le document terminé dans le wiki existant de votre équipe une fois qu’il est généré.
Astuces de pro : les entrées qui produisent les meilleurs résultats
Soyez précis dans le champ de l’objectif. « Gère l’authentification des utilisateurs » donne beaucoup moins de matière à l’outil que « Valide les identifiants de connexion par rapport à la base de données utilisateurs et émet un jeton de session, appelé à chaque tentative de connexion. »
Faites correspondre la formulation du public au lecteur réel. Des entrées de public vagues produisent un document génériquement technique. Passer à côté peut le rendre inutilisable pour le public visé. Une sortie trop technique effraiera les utilisateurs finaux, tandis que les développeurs trouveront les guides utilisateurs trop superficiels. N’ayez pas peur d’être précis, par exemple « agents de support qui dépannent les problèmes de connexion », et pas seulement « non technique ».
Signalez ce qui manque dans une base de code partielle. Si vous ne collez qu’un seul fichier d’un système plus vaste, dites-le dans le champ de l’objectif. L’outil déduit quand même l’intention à partir d’une entrée incomplète, mais un avertissement sur ce qui est hors périmètre l’empêche de deviner un contexte qu’il n’a pas.
Conclusion
Longtemps après que tout le monde a commencé à générer des articles bâclés sur des thèmes généraux, la documentation technique est restée une affaire strictement humaine. C’était entièrement dû à la nécessité de fournir à l’IA des données propriétaires et de s’assurer qu’elle peut les comprendre suffisamment bien pour produire une sortie qui vaut la peine. Aujourd’hui, cela aussi appartient au passé. Il vous suffit de dix minutes pour passer de l’entrée à une première version relue.
Générez votre premier document gratuitement et voyez quelle part de cette première version survit à la relecture. Pour comprendre toute la mécanique qui explique pourquoi ce processus fonctionne ainsi, consultez comment rédiger automatiquement de la documentation technique avec l’IA , et pour capturer un contexte qui vit entièrement en dehors du code, le générateur de compte rendu de réunion IA transforme une démonstration enregistrée en notes structurées que vous pouvez injecter dans votre prochaine exécution.
Pour découvrir d’autres types de documentation que ce même processus couvre bien, consultez cinq types de documentation que l’IA rédige plus vite .
Explorez davantage de workflows dans l’académie .