


Denne FlowHunt-dokumentationsskribent-tutorial guider dig gennem genereringen af dit første strukturerede tekniske dokument ud fra rigtig kildekode, fra start til slut. AI-dokumentationsskribenten tager din kode plus et par kontekstuelle input og returnerer et komplet dokument, der dækker arkitektur, logisk flow og brugsanvisninger, uden at du behøver at skrive det første udkast i hånden. Her er den præcise proces, trin for trin.
Trin 1: Forbered din kildekode og kontekst
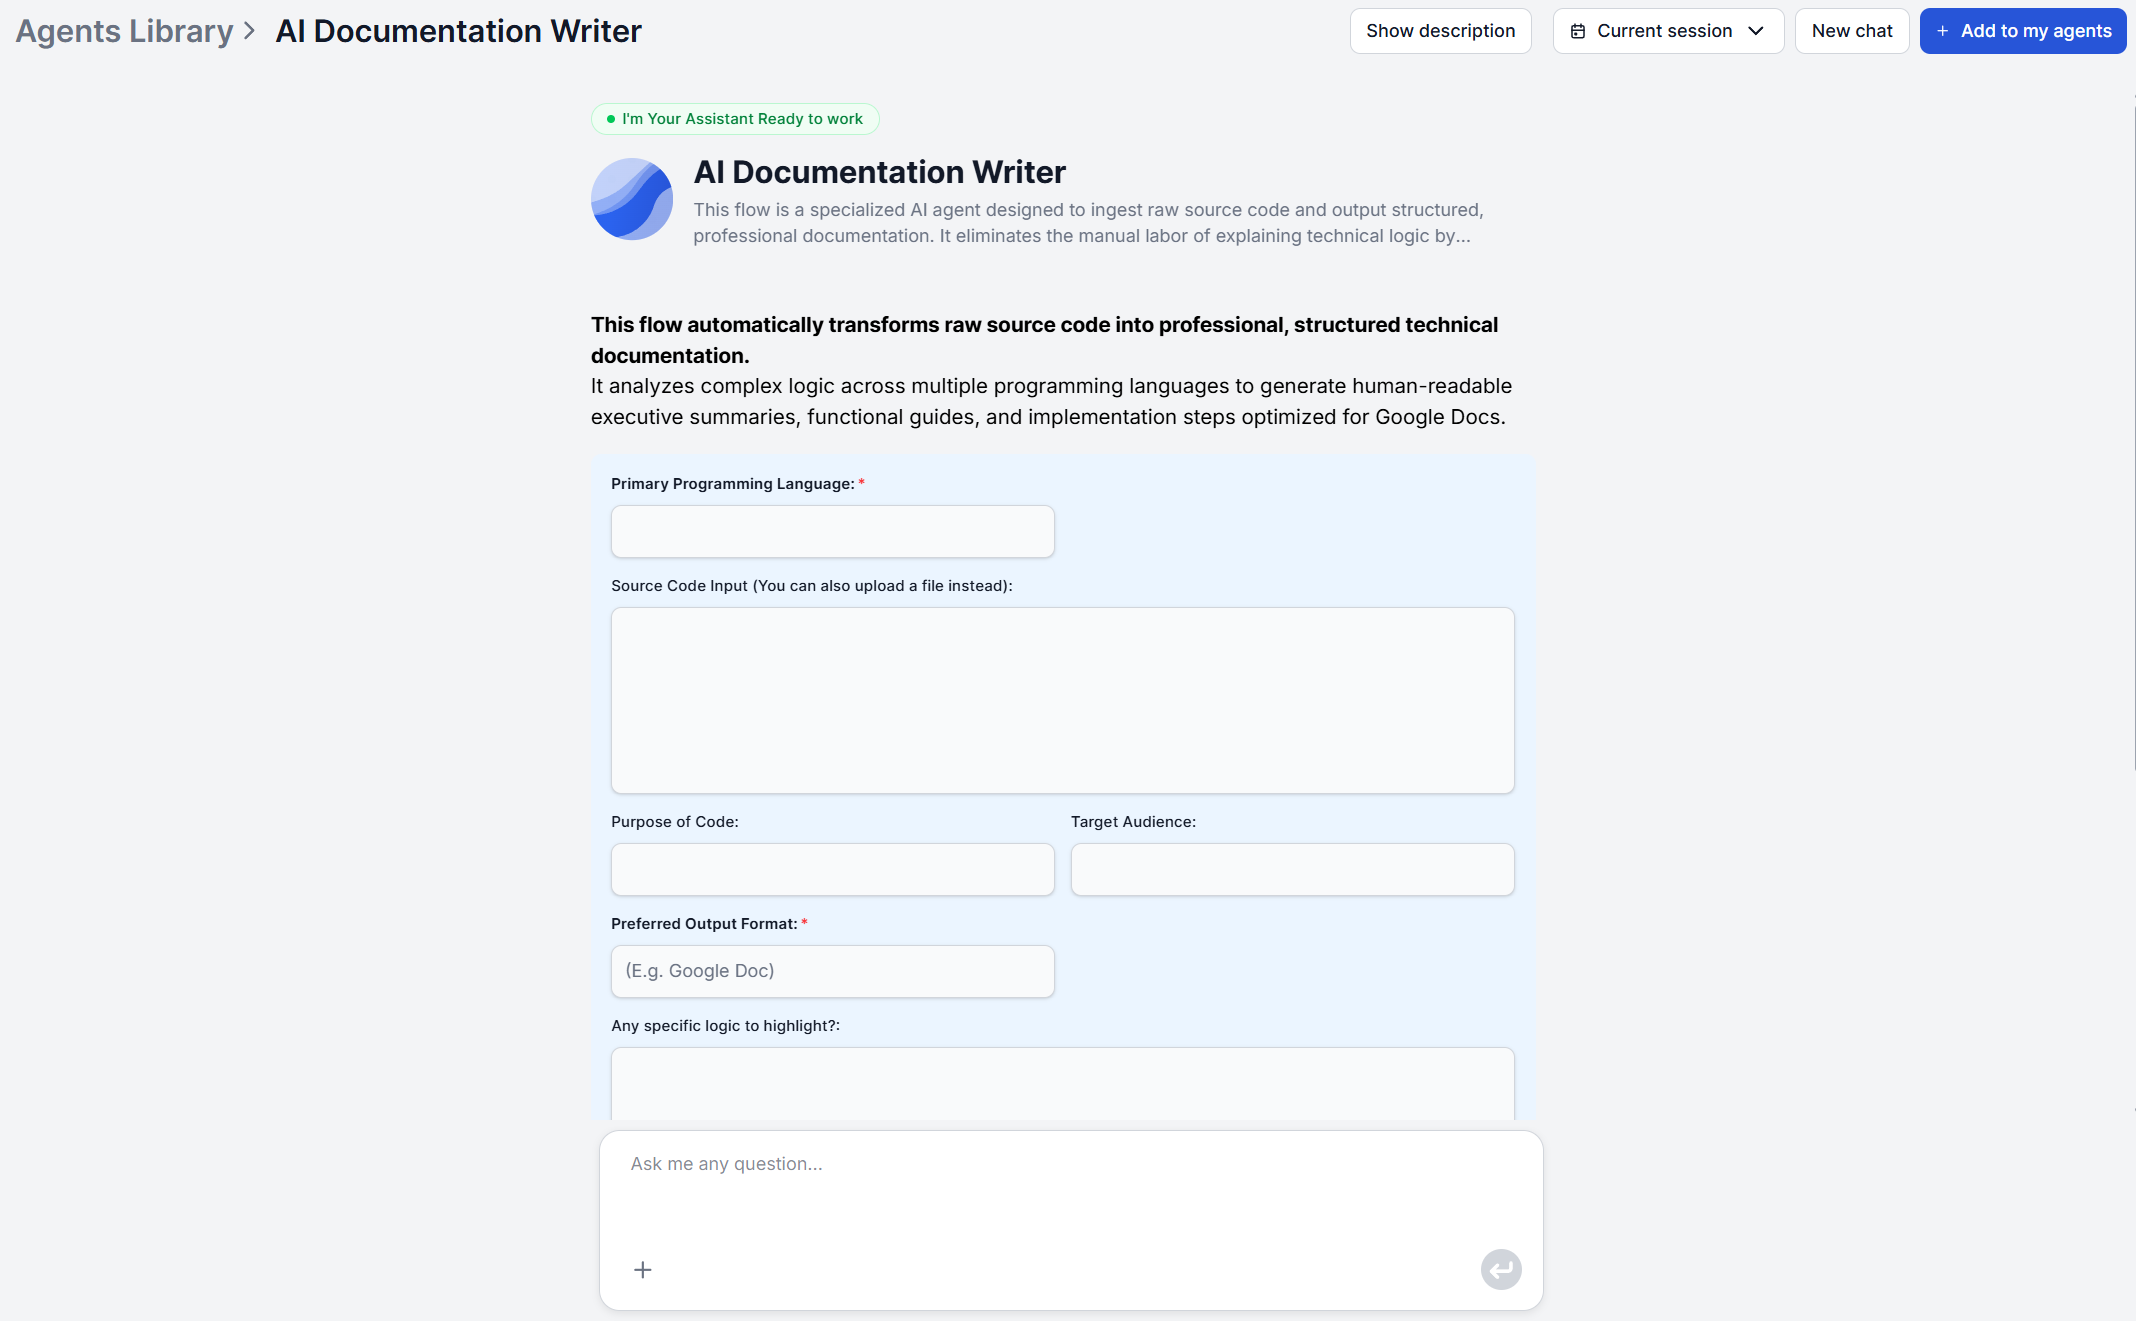
Søg efter AI Documentation Writer i dit agentbibliotek, og føj den til dine agenter. Tag din kildekode, og indsæt den enten direkte i chatten eller upload den som en fil. Dette er det ene input, værktøjet faktisk har brug for at arbejde ud fra. Det analyserer koden, ikke en beskrivelse skrevet i stedet for den.
Vil du prøve værktøjet gratis, før du forpligter dig? Følg blot dette link
Ud over koden bør du ideelt set også indtaste det primære programmeringssprog, kodens formål (en sætning i almindeligt sprog om, hvad den gør, og hvorfor den findes), din målgruppe og dit foretrukne outputformat.
En hel fil er ideelt, men ikke påkrævet. Et delvist uddrag eller en ufuldstændig kodebase virker begge, da værktøjet udleder den mest sandsynlige hensigt ud fra det, du giver det, i stedet for at gå i stå over manglende kontekst.
Dette er vigtigt for, hvordan du afgrænser din første kørsel. Hvis du dokumenterer et lille hjælpeværktøj, så indsæt det hele. Hvis du arbejder ud fra en større tjeneste, så vælg den fil eller det modul, der repræsenterer den del, du faktisk har brug for at få dokumenteret, i stedet for at dumpe et helt repository ind på én gang.
Trin 2: Angiv dit formål og outputformat
Indtast kodens formål og dit foretrukne outputformat sammen med din kildekode. Der er ingen separat “dokumenttype”-menu at vælge fra; hver kørsel producerer den samme komplette struktur. Et ledelsesresumé, funktionelle kapaciteter, teknisk arkitektur, logisk flow og proces, nøglefunktioner og komponenter samt implementerings- og brugsanvisninger.
Det, der ændrer sig mellem kørsler, er, hvordan disse seks sektioner udfyldes. Et formål som “internt deploymentscript til release-pipelinen” versus “offentlig SDK-metode til tredjepartsudviklere” styrer dokumentanalysens fase mod de detaljer, der betyder noget for det pågældende anvendelsestilfælde.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Trin 3: Angiv din målgruppe (tone og dybde)
Angiv, hvem dokumentet er til. Er det til udviklere, kunder eller ikke-tekniske interessenter? Du kan også være mere specifik, såsom “juniorudviklere, der er nye i denne kodebase” eller “supportpersonale uden kodningsbaggrund.”
Dette ene input driver logikoversættelsesfasen, som omdanner tekniske operationer til forklaringer i almindeligt sprog kalibreret til den person, du navngav. Den samme kildekode giver et mærkbart anderledes dokument alene afhængigt af dette felt, så det er værd at være præcis i stedet for at falde tilbage til “udviklere” af vane.
Hvis der er et specifikt stykke logik, du ikke vil have, at værktøjet springer let hen over – et autentificeringsflow, en rate-limiting-mekanisme, et edge case, der er let at overse ved første læsning – så navngiv det her også. Det bliver flettet ind i analysen i stedet for at blive overladt til tilfældet.
Trin 4: Generér og gennemgå dokumentet
Når din kode og kontekst er på plads, kører genereringen gennem tre faser. Kodeanalysen fortolker funktionaliteten, logikoversættelsen omdanner det til almindeligt sprog for din angivne målgruppe, og dokumentstruktureringen organiserer alt i et hierarki, der forklarer hvorfor og hvordan koden virker.
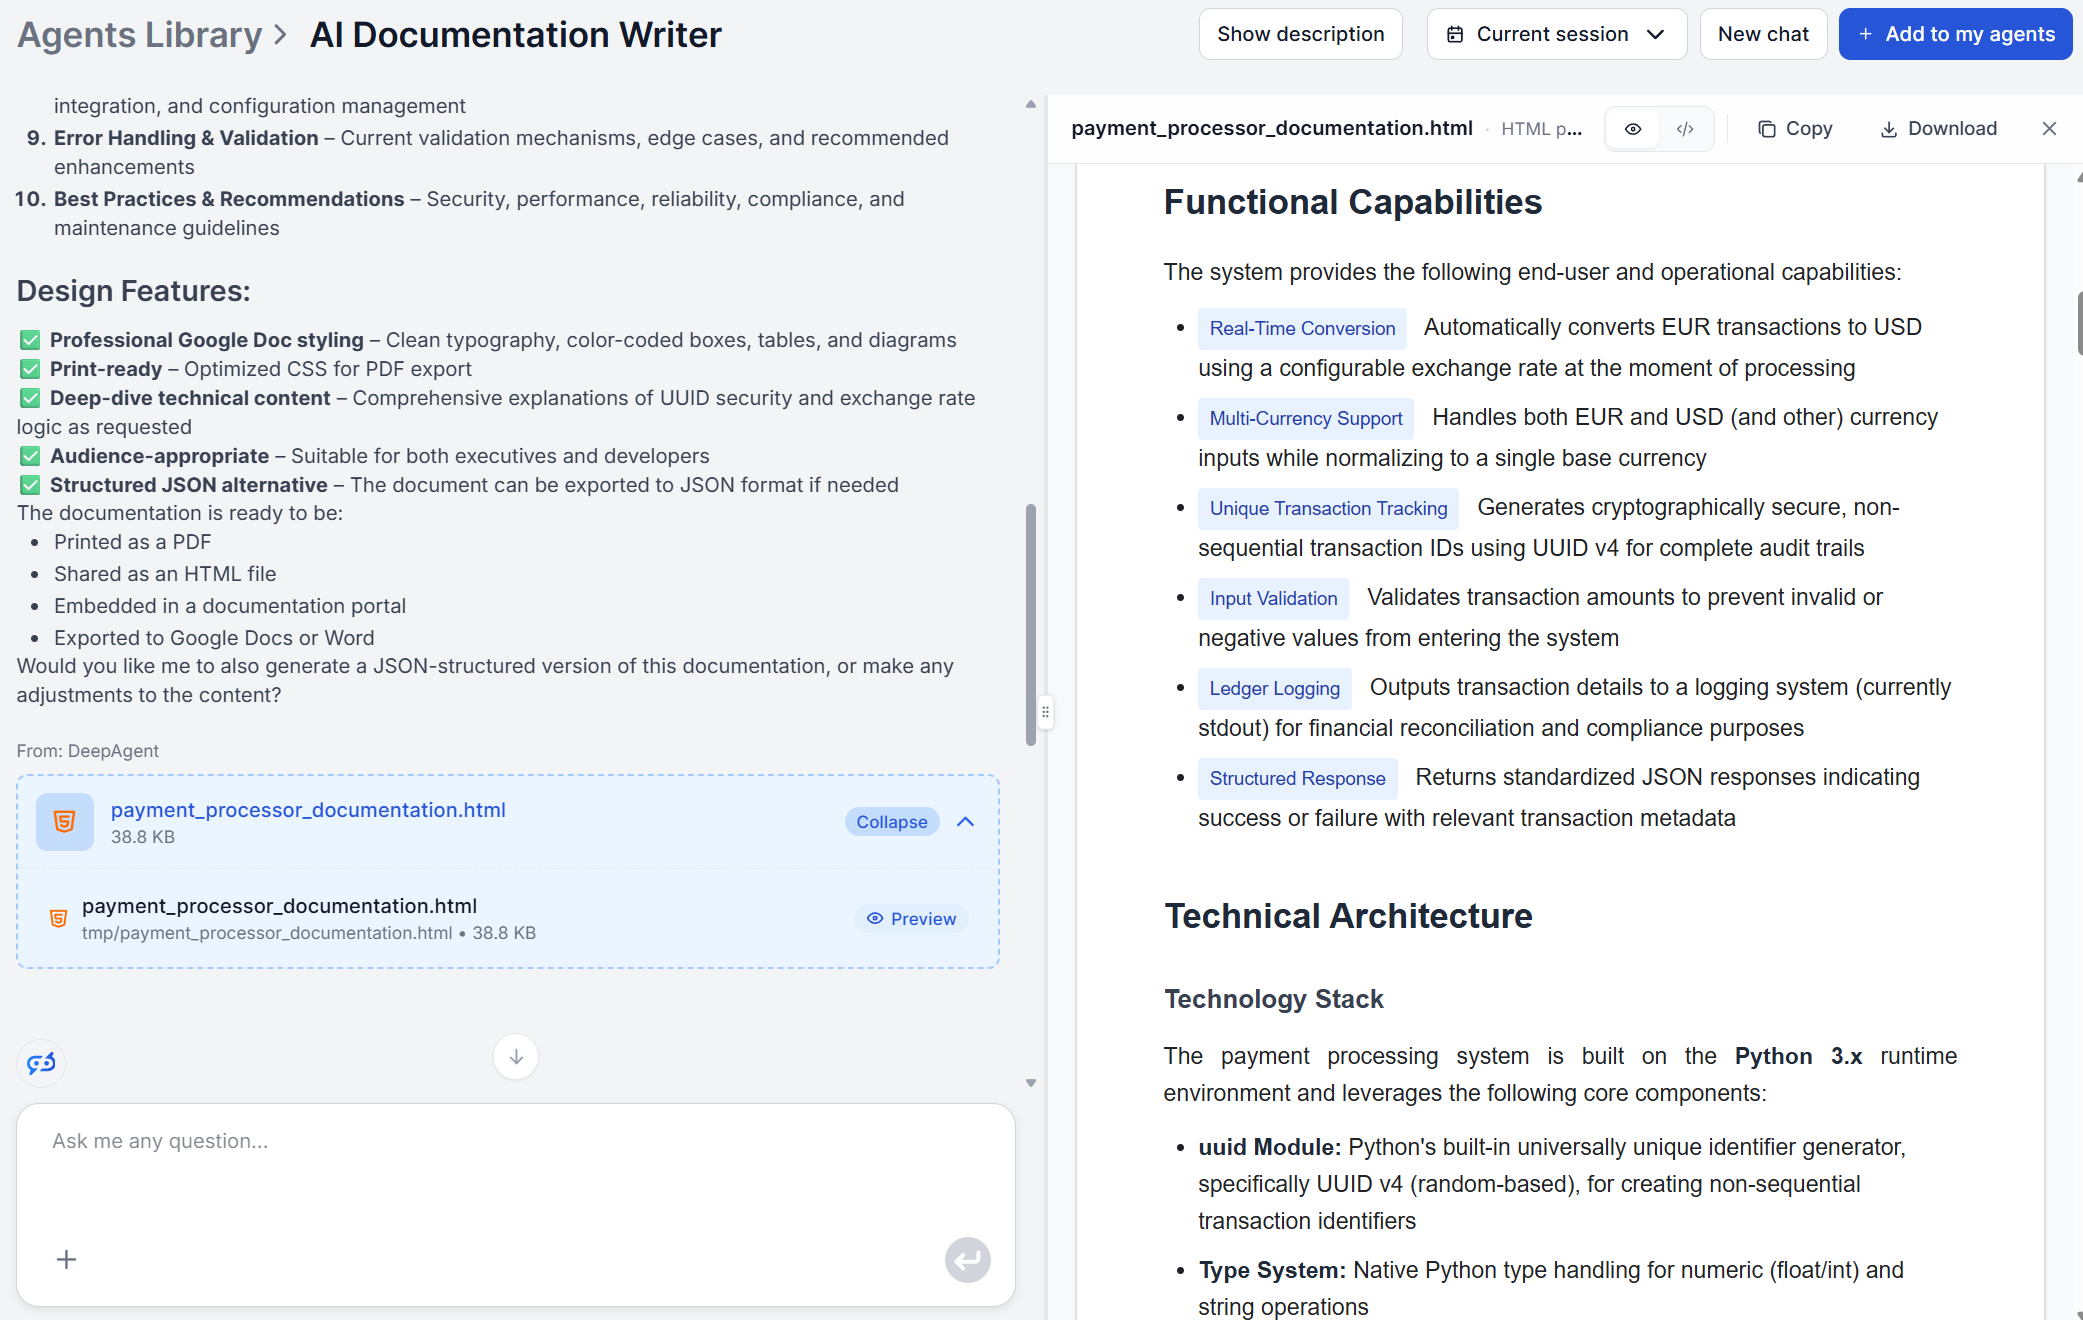
Læs resultatet igennem, før du behandler det som endeligt. Bekræft, at opsætnings- og konfigurationstrinnene faktisk virker i et rigtigt miljø, tjek at en ældre del af systemet, som værktøjet ikke kunne udlede alene fra koden, er beskrevet korrekt, og verificér, at målgruppekalibreringen landede, som du havde tænkt.
Sektionerne med ledelsesresumé og funktionelle kapaciteter er det hurtigste sanity-tjek, da de er korte og nemme at sammenligne med det, du allerede ved. Sektionerne om teknisk arkitektur og logisk flow fortjener en langsommere læsning, da det er her, et ufuldstændigt input mest sandsynligt giver en plausibel klingende, men let forkert slutning.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Trin 5: Forfin med specifik logik og eksempler
Hvis den første gennemkørsel misser noget afgørende, er det nemmere blot at køre genereringen igen med et skarpere input til “specifik logik, der skal fremhæves”, hvor du navngiver præcis, hvad der blev overset.
Rå kildekode udelades som standard fra outputtet, da værktøjet fokuserer på at forklare, hvad koden gør, i stedet for at reproducere den, men du kan udtrykkeligt anmode om at få den inkluderet, hvis dit anvendelsestilfælde kræver det.
En reel begrænsning, der er værd at kende på forhånd, er, at outputtet som standard ikke indeholder skærmbilleder eller diagrammer. Du kan justere agentflowet til at inkludere Photomatic-værktøjet og sætte det op til at generere billeder og diagrammer baseret på teksten. Hvis den dokumenterede funktionalitet er offentligt tilgængelig, kan du bruge Screenshot-værktøjet til at få et rigtigt skærmbillede.
Trin 6: Eksportér og publicér
Outputtet leveres i chatten som en vedhæftning med det strukturerede format, du har valgt. Det er klar til indlæsning i dokumentationssystemer, udviklerportaler eller kundleverancer uden manuel omformatering.
For at flytte det ind i dit faktiske workflow forbinder FlowHunt gennem MCP-servere i stedet for at kræve copy-paste. En hostet GitHub MCP-server kan hente kildekoden direkte fra et repository i starten af processen, og en Notion - eller hostet Confluence MCP-server -forbindelse kan skubbe det færdige dokument ind i dit teams eksisterende wiki, når det er genereret.
Pro-tips: Input, der giver det bedste output
Vær specifik i formålsfeltet. “Håndterer brugerautentificering” giver værktøjet langt mindre at arbejde med end “Validerer loginoplysninger mod brugerdatabasen og udsteder et sessionstoken, kaldt ved hvert loginforsøg.”
Tilpas målgruppeformuleringen til den rigtige læser. Vage målgruppeinput giver et generisk teknisk dokument. At ramme ved siden af kan gøre det ubrugeligt for målgruppen. Overdrevent teknisk output vil skræmme slutbrugere, mens udviklere vil finde brugerguides for overfladiske. Vær ikke bange for at være specifik, for eksempel “supportagenter, der fejlfinder loginproblemer”, ikke bare “ikke-teknisk”.
Markér, hvad der mangler fra en delvis kodebase. Hvis du kun indsætter én fil fra et større system, så sig det i formålsfeltet. Værktøjet udleder stadig hensigten fra ufuldstændigt input, men en heads-up om, hvad der er uden for scope, forhindrer det i at gætte på kontekst, det ikke har.
Konklusion
Længe efter at alle var begyndt at generere sjuskede artikler om generelle temaer, forblev teknisk dokumentation en strengt menneskelig affære. Det skyldtes alt sammen behovet for at give AI proprietære data og sikre, at den kan forstå dem nogenlunde godt nok til at producere output, der er værd at bruge. Nu er også det fortid. Alt du behøver, er ti minutter til at gå fra input til et gennemgået første udkast.
Generér dit første dokument gratis og se, hvor meget af det første udkast der overlever redigering. For de fulde mekanismer bag, hvorfor denne proces virker, som den gør, se hvordan man skriver teknisk dokumentation automatisk med AI , og for at fange kontekst, der lever helt uden for koden, omdanner AI-mødereferat-generatoren en optaget gennemgang til strukturerede noter, du kan føde ind i din næste kørsel.
For flere dokumentationstyper, som denne samme proces dækker godt, se fem dokumentationstyper, AI skriver hurtigere .
Udforsk flere workflows i akademiet .