


Den här FlowHunt-handledningen för dokumentationsförfattaren guidar dig genom att generera ditt första strukturerade tekniska dokument från riktig källkod, från början till slut. AI Documentation Writer tar din kod plus några kontextuella indata och returnerar ett komplett dokument som täcker arkitektur, logikflöde och användningsinstruktioner, utan att du behöver skriva det första utkastet för hand. Här är den exakta processen, steg för steg.
Steg 1: Förbered din källkod och kontext
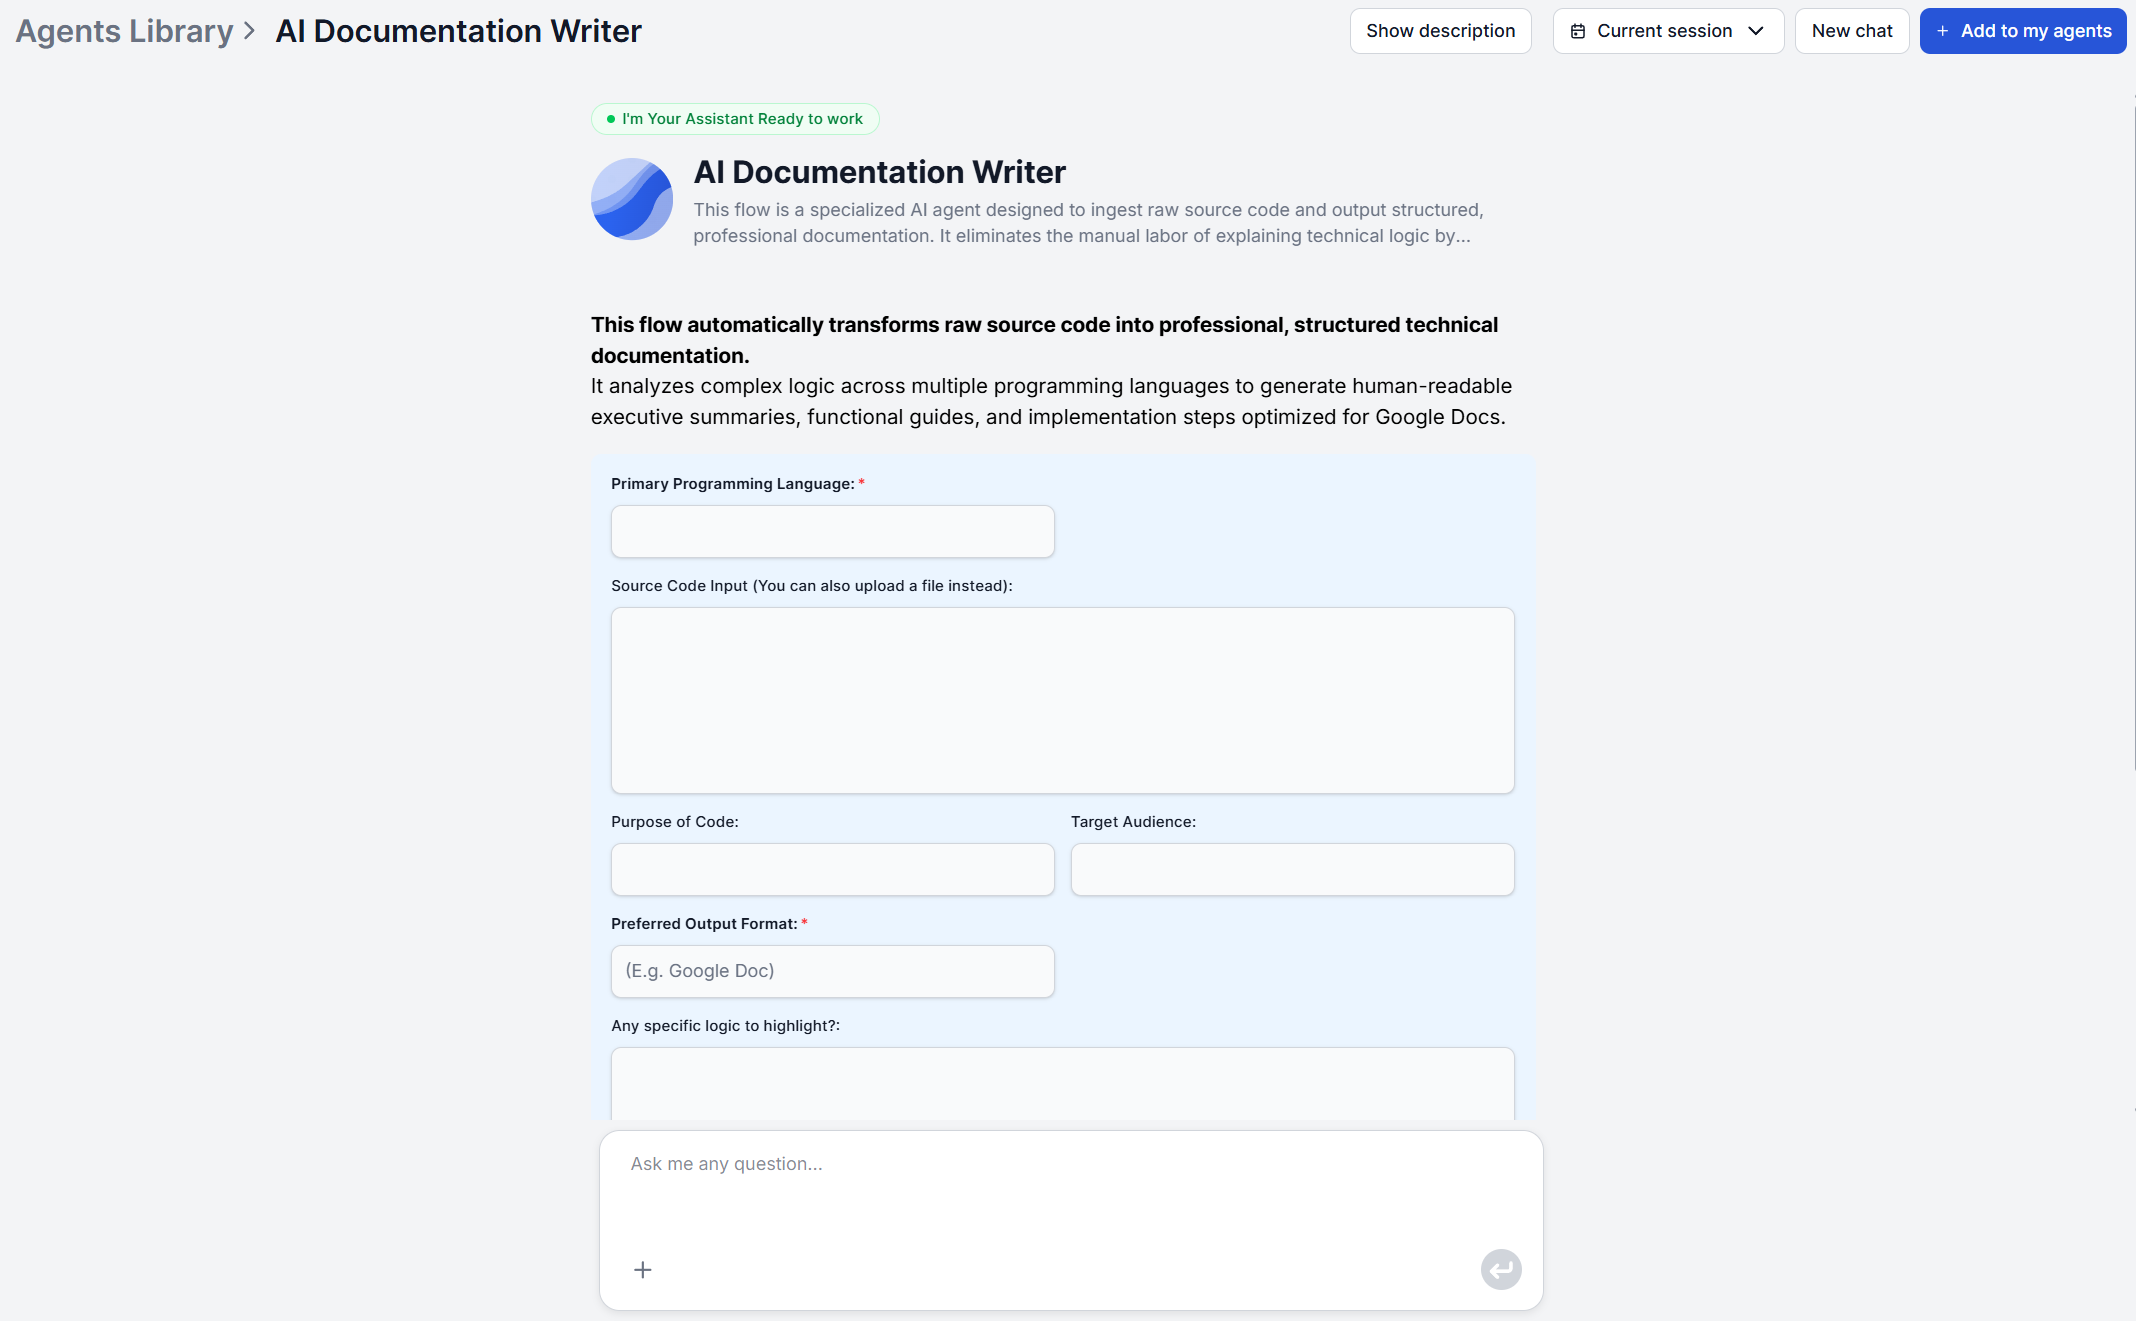
Sök efter AI Documentation Writer i ditt agentbibliotek och lägg till den bland dina agenter. Ta din källkod och antingen klistra in den direkt i chatten eller ladda upp den som en fil. Detta är det enda indata verktyget faktiskt behöver för att arbeta. Det analyserar koden, inte en beskrivning skriven i stället för den.
Vill du prova verktyget gratis innan du bestämmer dig? Följ bara den här länken
Utöver koden bör du helst också ange det primära programmeringsspråket, kodens syfte (en mening på vardagligt språk om vad den gör och varför den finns), din målgrupp och ditt önskade utdataformat.
En komplett fil är idealiskt, men inte ett krav. Ett partiellt kodavsnitt eller en ofullständig kodbas fungerar också, eftersom verktyget sluter sig till den mest sannolika avsikten utifrån det du tillhandahåller i stället för att fastna på saknad kontext.
Detta är viktigt för hur du avgränsar din första körning. Om du dokumenterar ett litet verktyg, klistra in hela. Om du arbetar med en större tjänst, välj den fil eller modul som representerar den del du faktiskt behöver dokumenterad, i stället för att dumpa ett helt arkiv på en gång.
Steg 2: Ange syfte och utdataformat
Ange kodens syfte och ditt önskade utdataformat tillsammans med din källkod. Det finns ingen separat meny för “dokumenttyp” att välja från, varje körning producerar samma kompletta struktur. En sammanfattning för ledningen, funktionella förmågor, teknisk arkitektur, logikflöde och process, centrala funktioner och komponenter samt implementerings- och användningsinstruktioner.
Det som förändras mellan körningar är hur dessa sex avsnitt fylls i. Ett syfte som “internt distributionsskript för release-pipelinen” kontra “publik SDK-metod för tredjepartsutvecklare” styr dokumentanalysfasen mot de detaljer som spelar roll för det användningsfallet.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Steg 3: Ange din målgrupp (ton och djup)
Ange vem dokumentet är till för. Är det för utvecklare, kunder eller icke-tekniska intressenter? Du kan också vara mer specifik, som “junioringenjörer som är nya i den här kodbasen” eller “supportpersonal utan programmeringsbakgrund.”
Detta enda indata styr logiköversättningsfasen, som omvandlar tekniska operationer till förklaringar på vardagligt språk anpassade till den du namngav. Samma källkod ger ett märkbart annorlunda dokument beroende enbart på detta fält, så det är värt att vara precis i stället för att av vana falla tillbaka på “utvecklare”.
Om det finns en specifik logik som du inte vill att verktyget ska förbise, ett autentiseringsflöde, en mekanism för hastighetsbegränsning, ett kantfall som är lätt att missa vid en första läsning, namnge det här också. Det vävs in i analysen i stället för att lämnas åt slumpen.
Steg 4: Generera och granska dokumentet
När din kod och kontext är på plats körs genereringen i tre faser. Kodanalysen tolkar funktionaliteten, logiköversättningen omvandlar det till vardagligt språk för din angivna målgrupp, och dokumentstruktureringen organiserar allt i en hierarki som förklarar varför och hur koden fungerar.
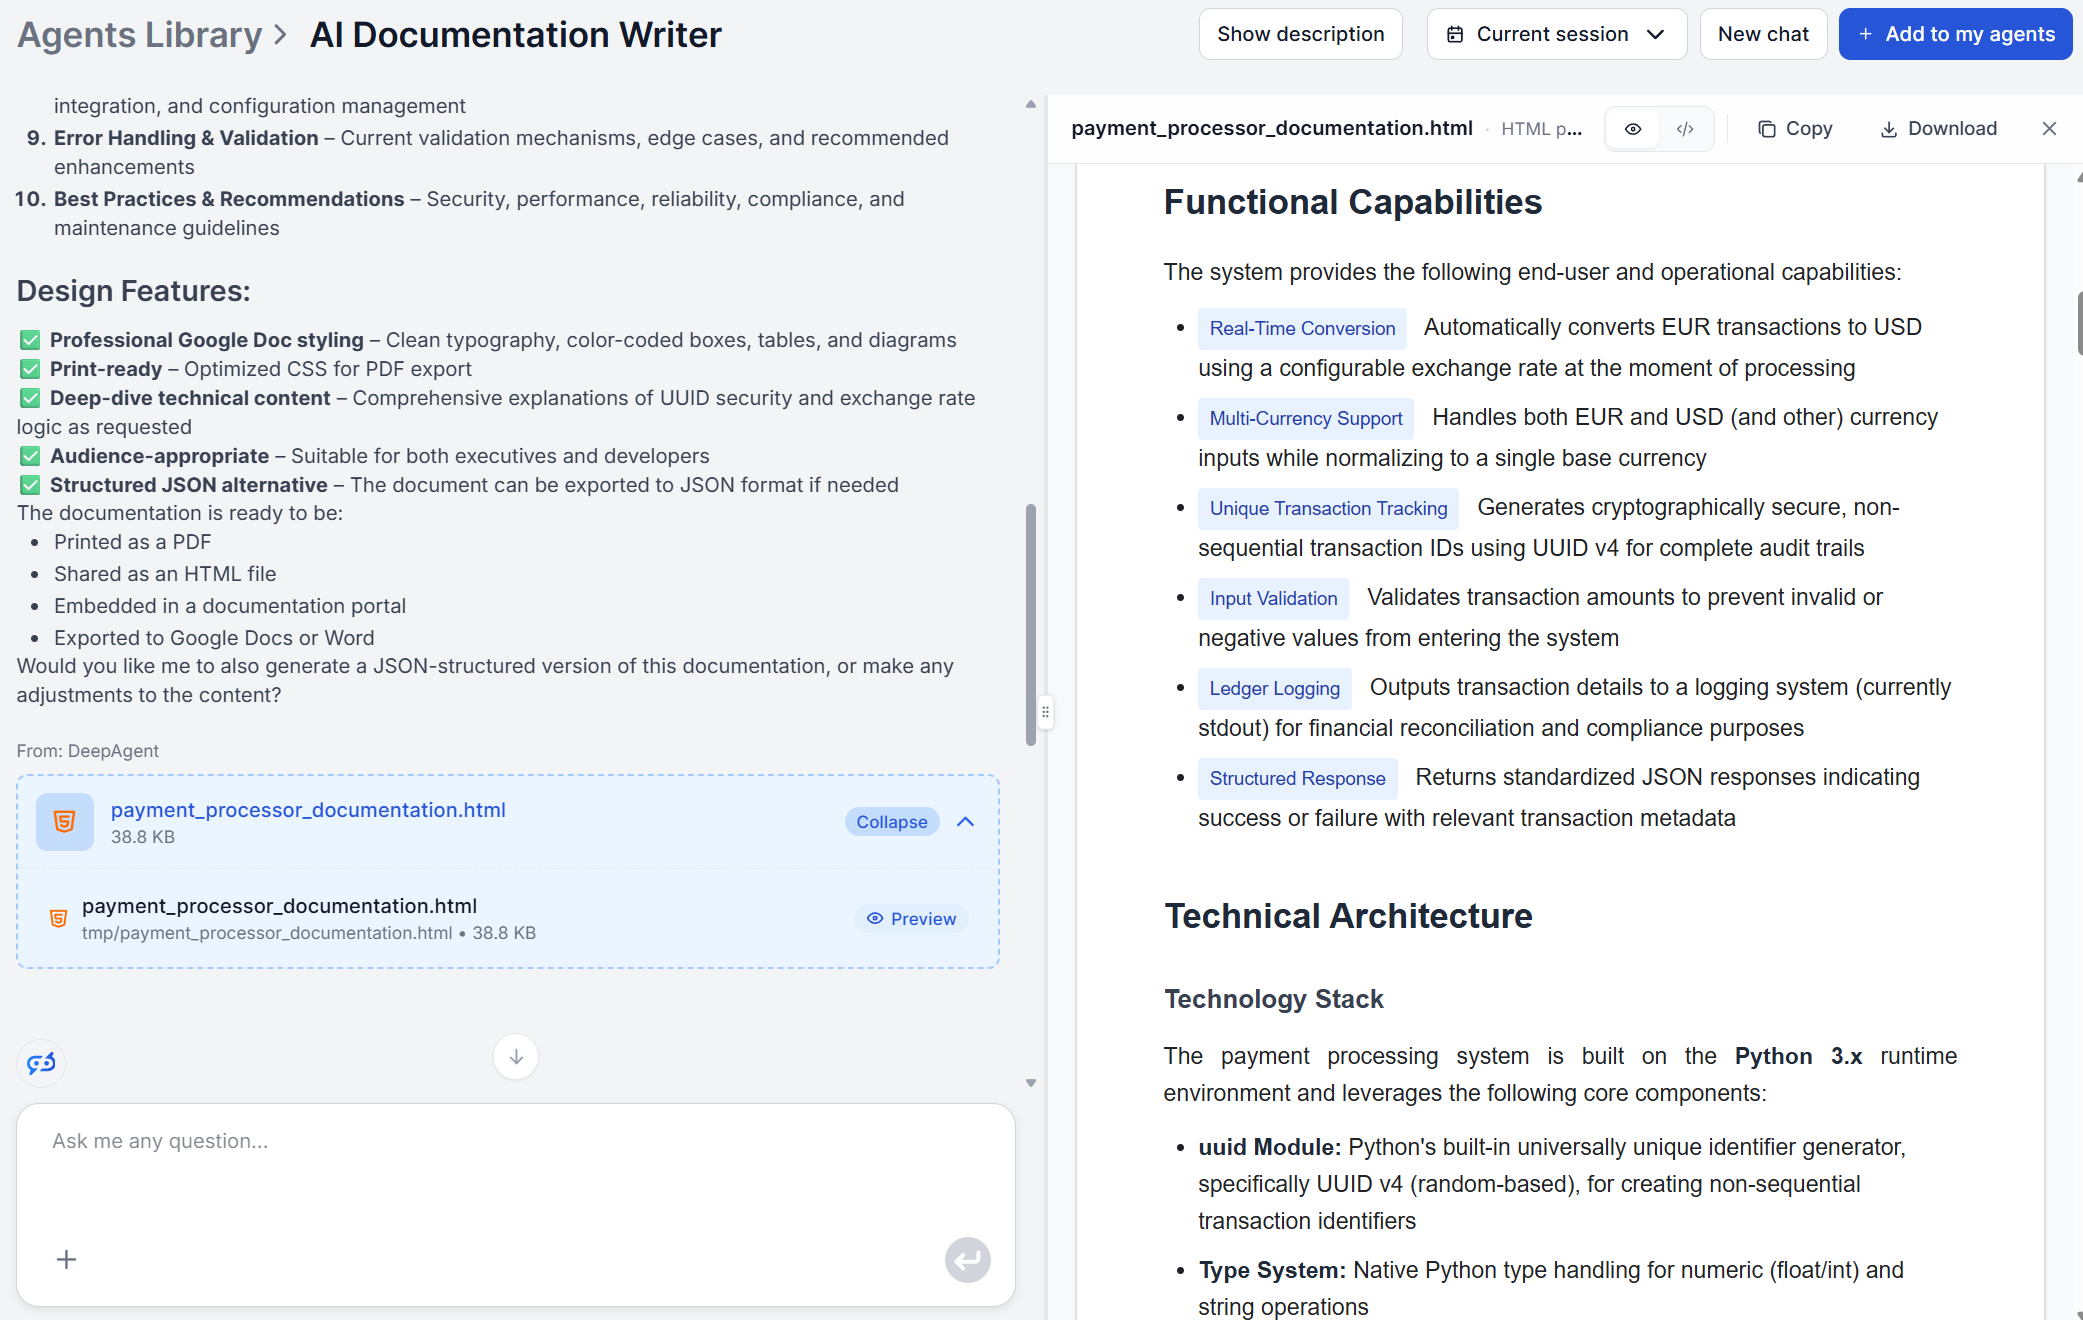
Läs igenom resultatet innan du betraktar det som färdigt. Bekräfta att stegen för installation och konfiguration faktiskt fungerar i en verklig miljö, kontrollera att en äldre del av systemet som verktyget inte kunde sluta sig till enbart från koden beskrivs korrekt, och verifiera att målgruppsanpassningen blev som du avsåg.
Avsnitten med sammanfattning för ledningen och funktionella förmågor är den snabbaste rimlighetskontrollen, eftersom de är korta och lätta att jämföra med det du redan vet. Avsnitten om teknisk arkitektur och logikflöde förtjänar en långsammare läsning, eftersom det är där ett ofullständigt indata med störst sannolikhet ger en rimligt låtande men något felaktig slutsats.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Steg 5: Förfina med specifik logik och exempel
Om den första körningen missar något viktigt är det enklare att helt enkelt köra genereringen igen med ett skarpare indata för “specifik logik att lyfta fram” som namnger exakt vad som missades.
Rå källkod utesluts från utdata som standard, eftersom verktyget fokuserar på att förklara vad koden gör snarare än att återge den, men du kan uttryckligen begära att den inkluderas om ditt användningsfall kräver det.
En verklig begränsning som är värd att känna till i förväg är att utdata inte innehåller skärmbilder eller diagram som standard. Du kan justera agentflödet för att inkludera Photomatic-verktyget och ställa in det för att generera bilder och diagram baserat på texten. Om den dokumenterade funktionaliteten är offentligt tillgänglig kan du använda skärmbildsverktyget för att få en faktisk skärmbild.
Steg 6: Exportera och publicera
Utdatan levereras i chatten som en bilaga som innehåller det strukturerade format du valt. Den är redo att matas in i dokumentationssystem, utvecklarportaler eller kundleverabler utan manuell omformatering.
För att flytta den till ditt faktiska arbetsflöde ansluter FlowHunt via MCP-servrar i stället för att kräva kopiera-klistra in. En hostad GitHub MCP-server kan hämta källkoden direkt från ett arkiv i början av processen, och en anslutning till Notion eller en hostad Confluence MCP-server kan skicka in det färdiga dokumentet till teamets befintliga wiki när det har genererats.
Proffstips: indata som ger bäst utdata
Var specifik i syftesfältet. “Hanterar användarautentisering” ger verktyget mycket mindre att arbeta med än “Validerar inloggningsuppgifter mot användardatabasen och utfärdar en sessionstoken, anropas vid varje inloggningsförsök.”
Matcha målgruppsformuleringen mot den verkliga läsaren. Vaga målgruppsindata ger ett generiskt tekniskt dokument. Att missa målet kan göra det oanvändbart för målgruppen. Alltför tekniskt utdata skrämmer slutanvändare, medan utvecklare tycker att användarguider är för ytliga. Var inte rädd för att vara specifik, till exempel “supportagenter som felsöker inloggningsproblem”, inte bara “icke-teknisk”.
Flagga vad som saknas i en partiell kodbas. Om du bara klistrar in en fil från ett större system, säg det i syftesfältet. Verktyget sluter sig fortfarande till avsikten från ofullständiga indata, men en varning om vad som ligger utanför omfattningen hindrar det från att gissa om kontext det inte har.
Slutsats
Långt efter att alla hade börjat generera slarviga artiklar om allmänna teman förblev teknisk dokumentation en strikt mänsklig angelägenhet. Allt berodde på behovet av att ge AI egen data och se till att den förstår tillräckligt väl för att producera utdata som är värd besväret. Nu är även det ett minne blott. Allt du behöver är tio minuter för att gå från indata till ett granskat första utkast.
Generera ditt första dokument gratis och se hur mycket av det första utkastet som överlever redigeringen. För de fullständiga mekanismerna bakom varför den här processen fungerar som den gör, se hur du skriver teknisk dokumentation automatiskt med AI , och för att fånga kontext som lever helt utanför koden omvandlar AI-mötesrapportgeneratorn en inspelad genomgång till strukturerade anteckningar som du kan mata in i din nästa körning.
För fler dokumenttyper som samma process täcker väl, se fem dokumenttyper som AI skriver snabbare .
Utforska fler arbetsflöden i akademin .