


理解与预防AI聊天机器人中的幻觉
什么是AI中的幻觉,为什么会出现幻觉,以及你如何避免它们?学习如何通过实用且以人为本的策略,让你的AI聊天机器人答案更准确。...
1 分钟阅读
Theory
Intermediate
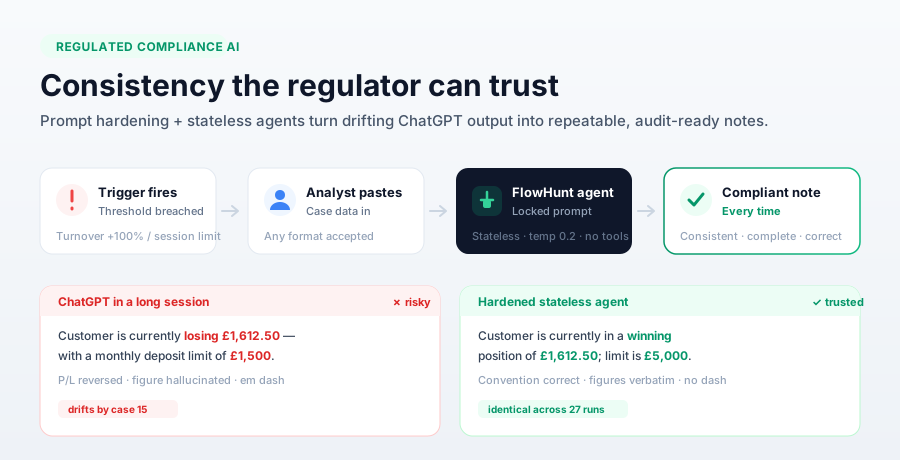
ChatGPT 在受监管的合规笔记中会出现漂移、虚构数字并打破既定文风。以下是让某英国负责任博彩工作流达到可审计标准的提示词强化与无状态代理方法——涵盖 9 个模型、27 次运行的模型测试。
一支英国负责任博彩(RG)团队带着一个问题找到我们,这个问题任何自动化受监管工作的人都会感同身受。他们使用 ChatGPT 将自动化合规触发事件转化为正式的分析师笔记。当客户触发某个阈值时——例如 30 天内营业额增长超过 100%,或某次游戏时段超出限制——分析师会将相关数据复制到 ChatGPT 中,模型按照预先上传的提示词,为该客户的合规档案起草一份笔记。
这份笔记不是一封草稿邮件,而是一份可供英国博彩委员会(UK Gambling Commission)审查的法律文件。使用一段时间后,ChatGPT 开始虚构数字、遗漏关键信息、插入破坏既定文风的破折号(em dash),并在下午悄悄偏离规则。在一份受监管的档案上,这些问题每一项都构成合规风险。
他们提出的问题很简单:我们究竟能否从语言模型那里获得受监管工作所要求的一致性? 答案是肯定的——但不是靠在聊天窗口里微调提示词的措辞就能实现的。这需要架构上的改变,加上一次严谨的重写。本文将以这个 RG 工作流为实例,逐步讲解具体方法,以便你将其应用到任何要求相同输入必须每次都产生可信输出的受监管流程中。
在修复问题之前,先准确地为失效模式命名会很有帮助。在这个 RG 工作流中,我们复现了五种明显不同的输出失效方式,严重程度从危急到仅仅令人恼火不等。
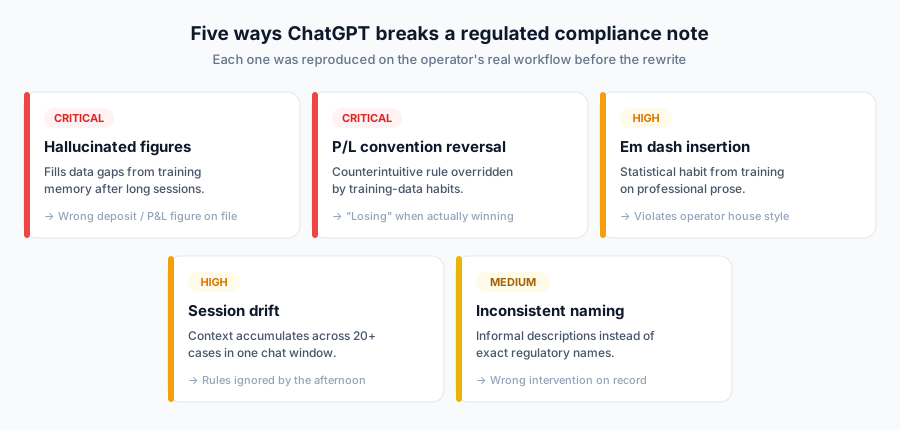
两种危急级问题是最危险的一对。虚构数字会在受监管档案上写入错误的存款或盈亏数字——模型用训练记忆填补空白,而不是承认数据缺失。惯例颠倒则更为隐蔽:该运营商使用一种反转的盈亏惯例,正数表示客户处于亏损状态。这与直觉相反,因此模型会退回到它在训练中学到的标准惯例,把实际盈利的客户写成正在亏损。
高严重性问题——违反文风规范的破折号,以及一天当中后段规则被忽视的会话漂移——不会在档案上留下错误数字,但会侵蚀对输出的信任并造成返工。中等严重性问题,即使用非正式的干预措施名称而非确切的监管术语,会悄无声息地破坏合规记录。
这五种失效中有四种共享同一个根本原因。在单个 ChatGPT 会话中,你审核的每一个案例都会被追加到上下文窗口中。审核第一个案例时,模型看到的是提示词加一个案例。到第十五个案例时,它看到的是提示词加上此前十四次交流留下的统计残留。提示词的规则仍然存在,但它们要与不断增长的上下文堆积竞争,对它们的关注度也随之衰减。
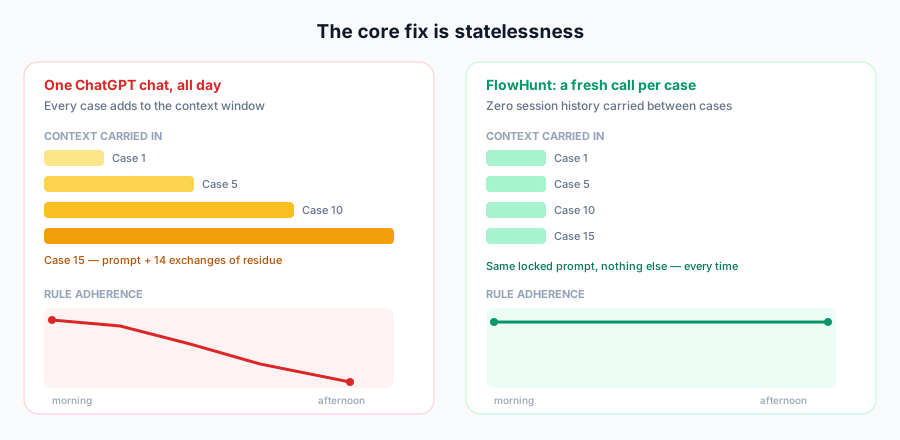
这就是为什么同一个提示词在早上 9 点能产生完美的笔记,到下午 4 点却出现瑕疵。架构上的解决方案是无状态性:每个案例都必须是一次完全全新、独立的调用,只能看到锁定的提示词和当前案例。没有任何内容会延续下去。以这种方式配置的 AI 代理 能让第五十个案例获得与第一个案例相同的提示词关注度。
无状态性是必要条件,但并非充分条件。它能阻止漂移,但如果提示词本身写得不好,它也会在每次调用中忠实地复现这个糟糕的提示词。因此提示词本身也必须被强化。
语言模型并不会对提示词的每一行给予相同的权重。注意力大致呈 U 形分布——在开头和结尾最强,在中间最弱。原始的 RG 提示词恰恰与此背道而驰。其中最重要的规则——反转的盈亏惯例——位于提示词中段,且只陈述了一次。破折号禁令是最后一行,也只陈述了一次。
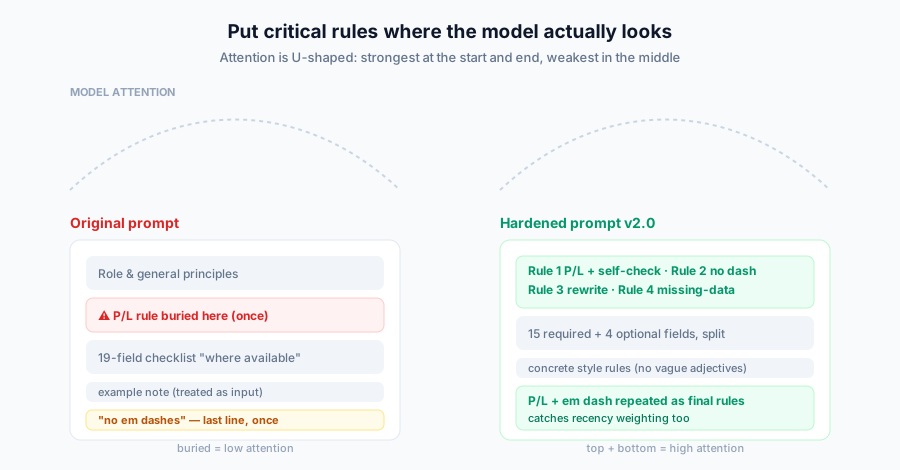
重写工作把关键规则移到模型真正会关注的位置,并重新打磨了 系统提示词 中薄弱的部分。以下是具体改动及其原因。
| 原始版本 | 强化后的 v2.0 | 重要性所在 |
|---|---|---|
| 盈亏规则埋在提示词中段,只陈述一次 | 规则 1 置于最顶部,附带自检步骤,并在文风部分再次重复 | 首因权重——最重要的规则必须放在最前面 |
| 破折号禁令位于最末尾,只陈述一次 | 规则 2 置于顶部,并作为最后一条规则在结尾重复 | 同时利用首因和近因权重 |
| 没有针对不完整输入的指示 | 规则 4——缺失数据协议,附带确切的响应格式 | 消除幻觉并建立可审计的记录轨迹 |
| 没有针对输入格式的指示 | 规则 3——接受任意格式,始终从头重写 | 阻止模型只是轻微改写粘贴进来的笔记 |
| 19 个必填字段,权重相同 | 15 个必填 + 4 个可选字段,清晰区分 | 可选字段缺失时静默省略;必填字段缺失时阻止生成 |
| “专业。自然。不要机械化。” | 具体规则:连接性语言、句长变化、禁用结构 | 模糊的形容词不会被遵循;具体规则才会被遵循 |
| 包含示例笔记 | 完全移除示例 | 模型会把示例当作需要响应的输入 |
这里最大的一条教训是:模糊的形容词不是指令。 让模型表现得“自然”,反而助长了破坏文风的破折号和修辞性花腔。用具体、可测试的规则取而代之,才是让文风保持一致的关键。
幻觉常被视为模型的缺陷。但在结构化工作中,它通常是提示词的缺陷:提示词从未告诉模型在字段缺失时该怎么办,于是它做了统计上最可能的事——生成一个看似合理的值。
解决办法是建立缺失数据协议。将字段划分为必填和可选两类。可选字段在缺失时静默省略。必填字段则相反——如果缺失一个,模型必须停止,并以确切的格式请求补充,而不是生成笔记。这一条规则就把一次隐蔽的幻觉,转化为一次可见、可审计的数据请求。这就是"档案上出现错误数字"与"因输入不完整而从未生成笔记"之间的区别。

免费获取最新提示、趋势和优惠。
有了强化后的提示词,代理本身也必须被锁定,以免任何环节重新引入不确定性。整个流程刻意保持极简——只有三个节点,别无其他。
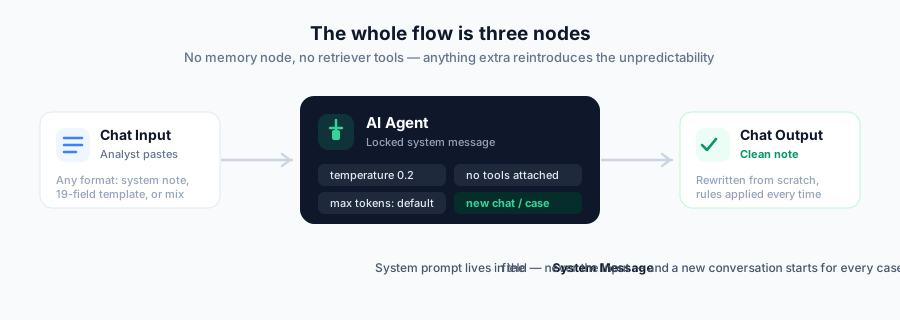
真正重要的配置选择包括:
上述每一项修复都会被一个坏习惯所抵消:重复使用同一个聊天。分析师团队最重要的操作规则是:每一个案例都要开启一个新对话。 绝不要在同一个窗口中继续审核其他案例。正是这条规则消除了会话漂移——绝大多数原始失效的根本原因——而且遵循它不需要付出任何成本。
如果你的团队正在与聊天窗口中不断漂移的提示词较劲,解决办法是让强化后的提示词运行在无状态代理之上。FlowHunt 让你能够锁定提示词、固定模型与温度,并为每个案例执行一次干净的调用。让我们帮你实现这一切。
方法的好坏取决于证据。我们针对强化后的提示词测试了九个模型,使用同一个真实案例(一次带有既往会话时长历史的博彩强度触发事件),每个模型运行三次——共计 27 次运行——并依据 16 项合规标准对每次运行进行评分。
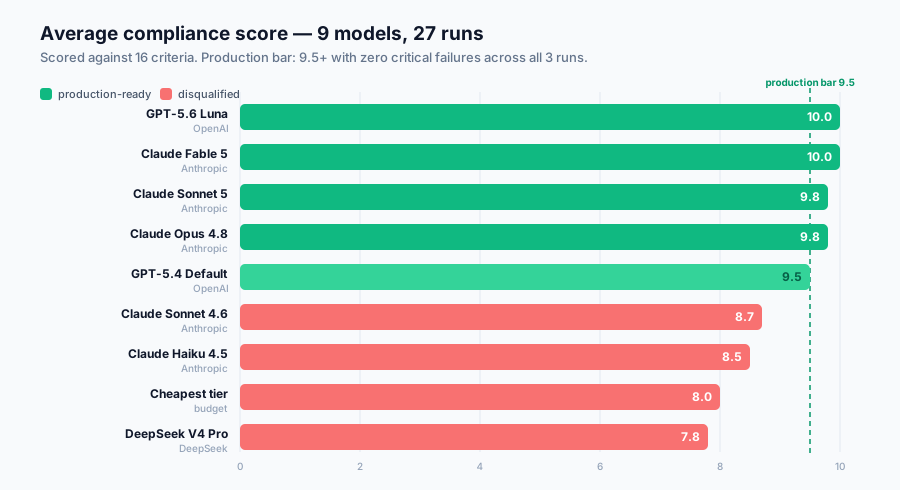
在全部 27 次运行中,没有任何一个达到可投产标准的模型出现虚构数字、颠倒盈亏惯例、使用破折号或截断输出的情况。强化后的提示词在合格的模型上消除了每一种原始失效模式。剩余的差异体现在分析深度和一致性上,而非正确性。
| 模型 | 供应商 | 平均得分 | 可投产 | 备注 |
|---|---|---|---|---|
| GPT-5.6 Luna | OpenAI | 10 / 10 | 是 | 三次运行全部完美;一致性最高 |
| Claude Fable 5 | Anthropic | 10 / 10 | 是 | 结果段落推理最充分;单篇最佳笔记 |
| Claude Sonnet 5 | Anthropic | 9.8 / 10 | 是 | 任何一次运行都没有出现幻觉;Claude 系列中综合表现最佳 |
| Claude Opus 4.8 | Anthropic | 9.8 / 10 | 是 | 分析最深入;成本较高 |
| GPT-5.4 Default | OpenAI | 9.5 / 10 | 是 | 出现一次命名失误;最佳经济型选择 |
| Claude Sonnet 4.6 | Anthropic | 8.7 / 10 | 否 | 在 2/3 的运行中将触发阈值与存款限额混淆 |
| Claude Haiku 4.5 | Anthropic | 8.5 / 10 | 否 | 一致性尚可,但结果论证薄弱 |
| 最便宜档位 | 经济型 | 8.0 / 10 | 否 | 仅在 1/3 的运行中给出确切的干预措施名称 |
| DeepSeek V4 Pro | DeepSeek | 7.8 / 10 | 否 | 第一次运行出现输出截断;结果不稳定 |
这些不合格结果很有启发性。Claude Sonnet 4.6 写出的文笔很优美,却把触发阈值与存款限额混淆——这是受监管档案上一个事实性错误的数字,无论文笔多好,这都足以使其失去资格。DeepSeek 在多次运行之间的波动(6 分、8.5 分、9 分)才是真正的问题所在:在受监管工作中,依赖运气才能获得的质量根本算不上质量。
人们很容易想要在价格上做优化,但数字本身就否定了这种做法。即便是最昂贵的可投产模型 Claude Opus 4.8,每篇笔记的成本也大约只有六美分。对于每天审核 50 个案例的团队而言,每月成本不到 90 美元。而一次因笔记错误导致的监管处罚,其成本将远远超过清单上任何模型一整年的费用。对于受监管的合规工作,要选择你能负担得起的最可靠模型,而不是最便宜的那个。
全部 27 次运行中最佳的一篇笔记来自 Claude Fable 5。请注意它做到了什么:它以正确的惯例陈述头寸,逐字引用数字,使用确切的干预措施名称,而且——最关键的是——解释了为什么升级处置会是不成比例的,而不是简单地陈述一个结论。
The customer is currently in a winning position of £1,612.50 with an account balance of £8,962.50, which represents an improvement on the winning position of £1,275.00 recorded at the previous review… Session duration was reviewed under Session Duration Level 1 on 19/07 and again on 20/07… Given that those decisions were made within the last few days, insufficient time has elapsed to assess their effectiveness, and repeating or escalating on the same behaviour at this stage would be disproportionate… In this context, No Further Action Required is the proportionate outcome.
这正是受监管工作所要求的标准:有据可依、比例适当,并且在当天第一个案例和第五十个案例上质量完全一致。
这个 RG 笔记生成器是一个具体案例,但该方法可以推广到任何要求语言模型对受监管或高风险数据产生可信、可重复输出的流程:
做到这五点,你就能把一个到下午就会产生幻觉的模型,转变为一个每次都能产生可审计输出的模型。受监管工作所要求的一致性是可以实现的——这是一个架构与提示词工程的问题,而这两者都是可以解决的。
阿尔西亚是 FlowHunt 的一名 AI 工作流程工程师。拥有计算机科学背景并热衷于人工智能,他专注于创建高效的工作流程,将 AI 工具整合到日常任务中,从而提升生产力和创造力。

把一个不断漂移的 ChatGPT 提示词,转变为每次都能生成可审计笔记的锁定式无状态代理。我们将帮助您强化提示词并选择合适的模型。
什么是AI中的幻觉,为什么会出现幻觉,以及你如何避免它们?学习如何通过实用且以人为本的策略,让你的AI聊天机器人答案更准确。...
了解AI聊天机器人如何通过提示工程、对抗性输入和上下文混淆被欺骗。掌握2025年聊天机器人漏洞与局限性。
了解Mira Murati的Thinking Machines Lab如何解决大语言模型中的不确定性问题,实现AI输出的可复现性,并彻底改变我们信任与审计AI系统的方式。...
Cookie 同意
我们使用 cookie 来增强您的浏览体验并分析我们的流量。 See our privacy policy.