


AI 챗봇을 속이는 방법: 취약점과 프롬프트 엔지니어링 기법 이해하기
AI 챗봇이 프롬프트 엔지니어링, 적대적 입력, 맥락 혼란을 통해 어떻게 속일 수 있는지 알아보세요. 2025년 챗봇의 취약점과 한계를 이해합니다....
6 분 읽기
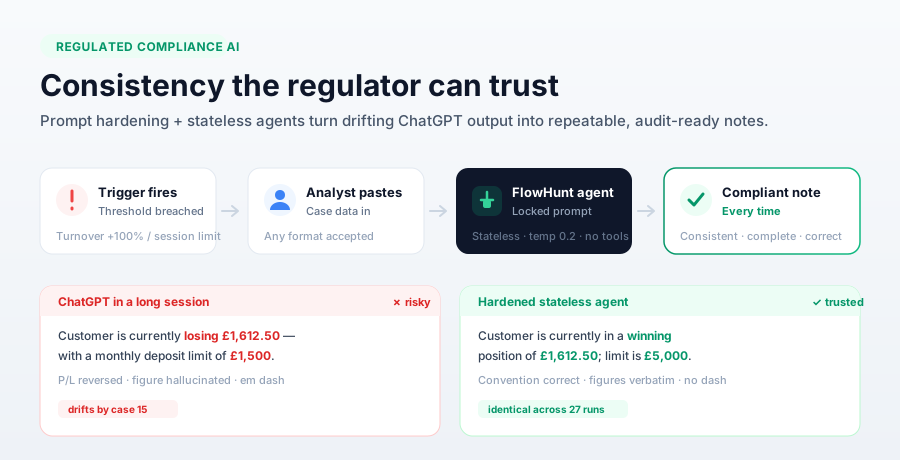
ChatGPT는 규제 준수 노트 작성 중 드리프트를 일으키고 수치를 환각하며 하우스 스타일을 깨뜨립니다. 9개 모델, 27회 실행에 걸친 모델 테스트를 통해 영국 책임 있는 도박(Responsible Gambling) 워크플로우를 감사 대응 가능한 수준으로 만든 프롬프트 하드닝 및 무상태 에이전트 방법을 소개합니다.
한 영국 책임 있는 도박(Responsible Gambling, RG) 팀이 규제 업무를 자동화하는 누구나 공감할 만한 문제를 안고 저희를 찾아왔습니다. 이 팀은 자동화된 준수 트리거를 공식 분석가 노트로 전환하는 데 ChatGPT를 사용하고 있었습니다. 고객이 임계값을 위반하면 — 30일 이내 회전율이 100% 이상 증가하거나, 세션이 한도를 초과하여 진행되는 경우 — 분석가는 관련 데이터를 ChatGPT에 붙여넣고, 모델은 사전에 업로드된 프롬프트를 따라 고객의 준수 파일에 들어갈 노트를 작성합니다.
이 노트는 단순한 초안 이메일이 아닙니다. 영국 도박위원회(UK Gambling Commission)가 검토할 수 있는 법적 문서입니다. 그런데 시간이 지나면서 ChatGPT는 수치를 환각하고, 핵심 정보를 놓치고, 하우스 스타일을 깨뜨리는 줄표(em dash)를 삽입하며, 오후가 되면 조용히 규칙에서 벗어나기 시작했습니다. 규제 대상 파일에서는 이 각각이 준수 문제입니다.
이들이 던진 질문은 단순했습니다. 언어 모델로부터 규제 업무가 요구하는 일관성을 얻는 것이 애초에 가능한가? 답은 그렇다입니다 — 다만 채팅 창 안에서 프롬프트 문구를 조금씩 손보는 방식으로는 안 됩니다. 아키텍처의 변화와 규율 있는 재작성이 함께 필요합니다. 이 글은 RG 워크플로우를 실제 사례로 삼아 정확한 방법을 단계별로 설명하므로, 동일한 입력이 매번 동일하고 신뢰할 수 있는 출력을 만들어야 하는 어떤 규제 프로세스에도 적용할 수 있습니다.
무언가를 고치기 전에, 먼저 실패 양상을 정확히 짚어보는 것이 도움이 됩니다. RG 워크플로우에서 저희는 심각도가 치명적인 것부터 단순히 성가신 것까지, 다섯 가지 뚜렷한 출력 오류 양상을 재현했습니다.
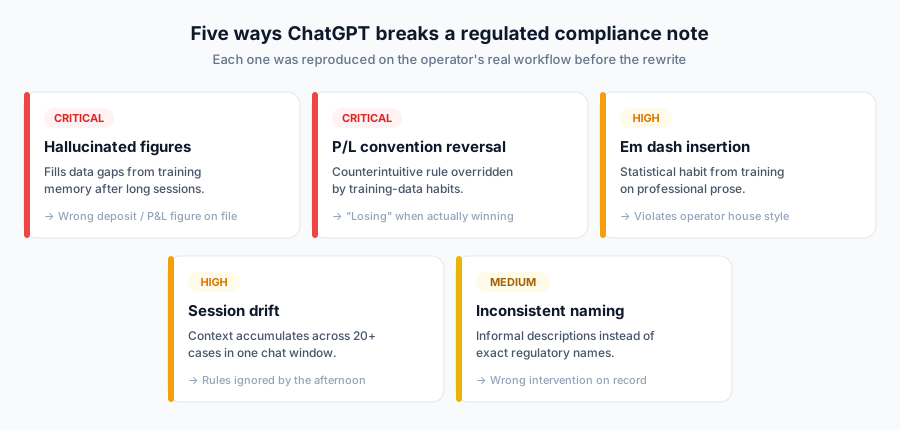
두 가지 치명적 문제가 가장 위험한 조합입니다. 수치 환각은 규제 대상 파일에 잘못된 입금액이나 손익 수치를 기재하게 만듭니다 — 모델이 데이터가 없다고 인정하는 대신 학습 기억에서 공백을 채우는 것입니다. 관례 역전은 더 미묘합니다. 이 운영사는 양수가 고객이 손실을 보고 있음을 의미하는 역전된 손익 관례를 사용합니다. 직관에 반하기 때문에 모델은 학습 과정에서 익힌 표준 관례로 되돌아가 실제로는 이기고 있는 고객을 지고 있다고 서술합니다.
높은 심각도 문제 — 하우스 스타일을 위반하는 줄표, 하루가 지날수록 규칙이 무시되는 세션 드리프트 — 는 파일에 잘못된 수치를 남기지는 않지만, 출력에 대한 신뢰를 갉아먹고 재작업을 유발합니다. 중간 심각도 문제인, 정확한 규제 용어 대신 사용되는 비공식적인 개입 명칭은 준수 기록을 조용히 훼손합니다.
이 다섯 가지 실패 중 네 가지는 하나의 근본 원인을 공유합니다. 하나의 ChatGPT 세션에서는 검토하는 모든 사례가 컨텍스트 윈도우에 추가됩니다. 첫 번째 사례를 검토할 때 모델은 프롬프트와 사례 하나만을 봅니다. 열다섯 번째 사례에 이르면 프롬프트에 더해 이전 열네 번의 교환에서 남은 통계적 잔여물까지 보게 됩니다. 프롬프트의 규칙은 여전히 존재하지만, 점점 쌓이는 컨텍스트와 경쟁하게 되어 그에 대한 주의력이 저하됩니다.
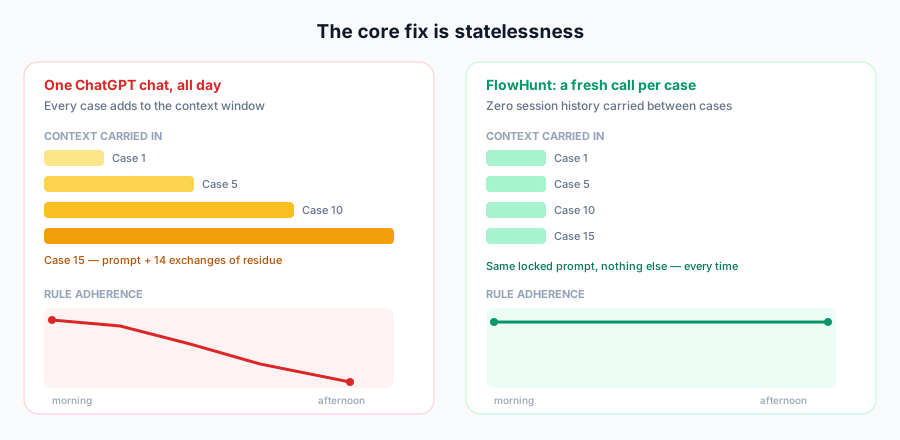
이것이 바로 동일한 프롬프트가 오전 9시에는 완벽한 노트를, 오후 4시에는 결함 있는 노트를 만드는 이유입니다. 아키텍처 차원의 해법은 무상태성입니다. 모든 사례는 잠긴 프롬프트와 현재 사례만을 보는, 완전히 새롭고 독립된 호출이어야 합니다. 아무것도 이어지지 않습니다. 이렇게 구성된 AI 에이전트 는 오십 번째 사례에서도 첫 번째 사례와 동일한 주의를 프롬프트에 기울입니다.
무상태성은 필요조건이지만 충분조건은 아닙니다. 드리프트는 막지만, 매 호출마다 나쁜 프롬프트를 충실히 재현할 뿐입니다. 따라서 프롬프트 자체도 강화해야 합니다.
언어 모델은 프롬프트의 모든 줄에 동일한 가중치를 두지 않습니다. 주의력은 대략 U자 형태를 띠며 — 시작과 끝에서 가장 강하고 중간에서 가장 약합니다. 원래 RG 프롬프트는 이 구조에 역행했습니다. 가장 중요한 규칙인 역전된 손익 관례는 프롬프트 중간에 단 한 번 언급되어 있었습니다. 줄표 금지 규칙은 맨 마지막 줄에 역시 단 한 번 있었습니다.
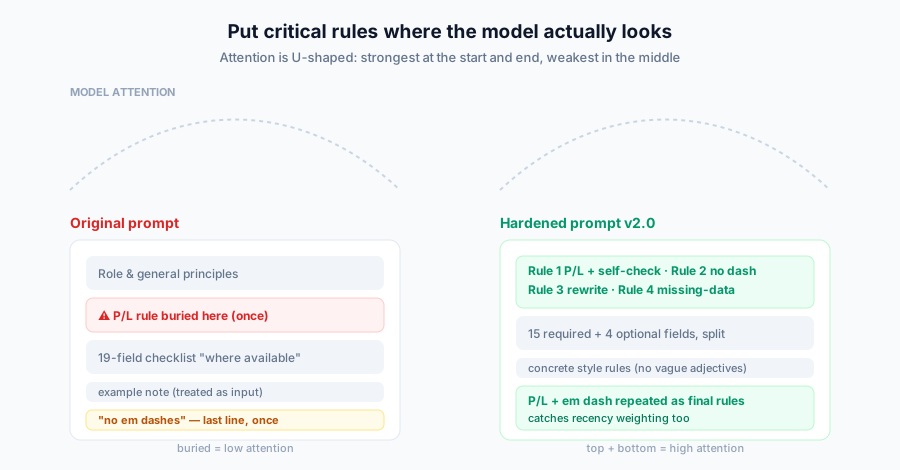
재작성 과정에서는 핵심 규칙을 모델이 실제로 주목하는 위치로 옮기고 시스템 프롬프트 의 취약한 부분을 다시 다듬었습니다. 무엇이 바뀌었고 그 이유는 무엇인지 살펴보겠습니다.
| 원래 프롬프트 | 강화된 v2.0 | 중요한 이유 |
|---|---|---|
| P/L 규칙이 프롬프트 중간에 묻혀 있고 단 한 번 언급됨 | 규칙 1이 맨 위에 자체 점검 단계와 함께 배치되고, 문체 섹션에서 반복됨 | 초두 효과 — 가장 중요한 규칙이 먼저 와야 한다 |
| 줄표 금지 규칙이 맨 끝에 단 한 번 | 규칙 2가 맨 위에 있고, 맨 아래에서 마지막 규칙으로 반복됨 | 초두 효과와 최신 효과를 모두 포착한다 |
| 불완전한 입력에 대한 지시 없음 | 규칙 4 — 정확한 응답 형식을 갖춘 결측 데이터 프로토콜 | 환각을 제거하고 감사 추적을 생성한다 |
| 입력 형식에 대한 지시 없음 | 규칙 3 — 어떤 형식이든 수용하고, 항상 처음부터 다시 작성 | 붙여넣은 노트를 가볍게 재구성하는 것을 방지한다 |
| 필수 필드 19개, 모두 동일한 가중치 | 필수 15개 + 선택 4개로 명확히 구분 | 선택 필드는 조용히 생략되고, 필수 필드는 없으면 생성을 막는다 |
| “전문적으로. 자연스럽게. 로봇 같지 않게.” | 연결어, 다양한 문장 길이, 금지된 구문 등 구체적인 규칙 | 모호한 형용사는 지켜지지 않고, 구체적인 규칙은 지켜진다 |
| 예시 노트 포함 | 예시 완전히 제거 | 모델이 예시를 응답해야 할 입력으로 취급했다 |
여기서 가장 중요한 교훈은 이것입니다. 모호한 형용사는 지시가 아닙니다. 모델에게 “자연스럽게” 쓰라고 지시하는 것은 오히려 하우스 스타일을 깨뜨리는 줄표와 수사적 과장을 부추겼습니다. 이를 구체적이고 검증 가능한 규칙으로 대체한 것이 문체를 일관되게 만든 핵심입니다.
환각은 흔히 모델의 결함으로 여겨집니다. 그러나 구조화된 업무에서 환각은 대개 프롬프트의 결함입니다. 필드가 없을 때 모델이 무엇을 해야 하는지 프롬프트가 알려주지 않았기 때문에, 모델은 통계적으로 가능성이 높은 행동을 하여 그럴듯한 값을 만들어낸 것입니다.
해법은 결측 데이터 프로토콜입니다. 필드를 필수와 선택으로 나눕니다. 선택 필드는 없을 경우 조용히 생략됩니다. 필수 필드는 그 반대입니다. 하나라도 누락되면 모델은 노트를 생성하는 대신 멈추고 정확한 형식으로 해당 데이터를 요청해야 합니다. 이 하나의 규칙이 눈에 보이지 않는 환각을, 눈에 보이고 감사 가능한 추가 데이터 요청으로 바꿉니다. 이는 규제 대상 파일에 잘못된 수치가 남는 것과, 입력이 불완전하여 애초에 노트가 생성되지 않는 것의 차이입니다.

최신 팁, 트렌드 및 특가 정보를 무료로 받아보세요.
강화된 프롬프트를 갖추었다면, 어떤 것도 변동성을 다시 끌어들이지 않도록 에이전트 자체를 잠가야 합니다. 전체 흐름은 의도적으로 최소화되어 세 개의 노드 외에는 아무것도 없습니다.
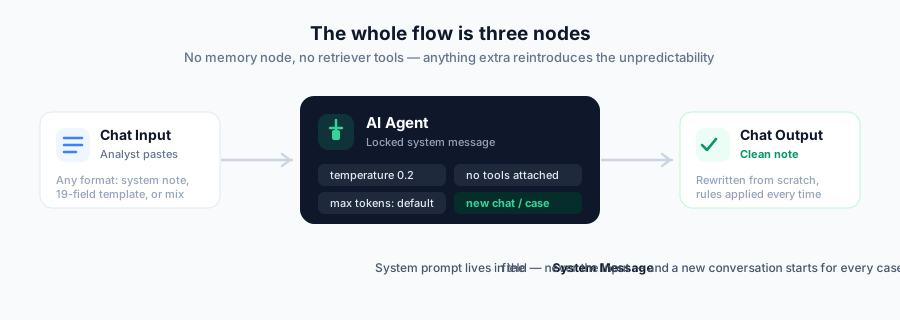
중요했던 구성 선택 사항들은 다음과 같습니다.
위의 모든 수정 사항은 하나의 나쁜 습관으로 무너질 수 있습니다. 바로 같은 채팅을 재사용하는 것입니다. 분석가 팀에게 가장 중요한 운영 규칙은 모든 개별 사례마다 새 대화를 시작하는 것입니다. 같은 창에서 사례 검토를 이어가지 마십시오. 이것이 원래 실패의 근본 원인이었던 세션 드리프트를 없애는 규칙이며, 지키는 데 아무런 비용도 들지 않습니다.
팀이 채팅 창 안에서 드리프트하는 프롬프트와 씨름하고 있다면, 해법은 무상태 에이전트에서 실행되는 강화된 프롬프트입니다. FlowHunt를 사용하면 프롬프트를 잠그고, 모델과 temperature를 고정하며, 사례마다 깨끗한 호출을 실행할 수 있습니다. 그곳에 도달하도록 저희가 도와드리겠습니다.
방법론은 그것을 뒷받침하는 증거만큼만 훌륭합니다. 저희는 강화된 프롬프트에 대해 아홉 개 모델을 테스트했으며, 동일한 실제 사례(이전 세션 지속 시간 이력이 있는 Gambling Intensity 트리거)를 각 모델당 세 번씩 — 총 27회 — 실행하고 16개 준수 기준에 따라 매 실행을 채점했습니다.
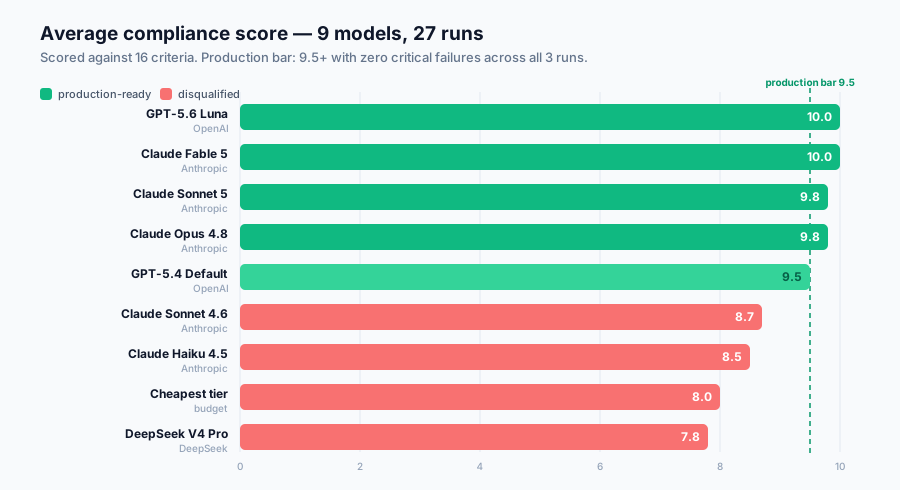
27회 실행 전체에 걸쳐, 프로덕션에 적합한 모델 중 어느 것도 수치를 환각하거나, P/L 관례를 뒤집거나, 줄표를 사용하거나, 출력을 잘라내지 않았습니다. 강화된 프롬프트는 자격을 갖춘 모델들에서 원래의 모든 실패 양상을 제거했습니다. 남은 차이는 정확성이 아니라 분석의 깊이와 일관성에 관한 것이었습니다.
| 모델 | 벤더 | 평균 점수 | 프로덕션 적합 | 비고 |
|---|---|---|---|---|
| GPT-5.6 Luna | OpenAI | 10 / 10 | 예 | 세 번 모두 완벽; 가장 높은 일관성 |
| Claude Fable 5 | Anthropic | 10 / 10 | 예 | 가장 논리적인 결과 문단; 최고의 단일 노트 |
| Claude Sonnet 5 | Anthropic | 9.8 / 10 | 예 | 어떤 실행에서도 환각 없음; 전반적으로 가장 뛰어난 Claude |
| Claude Opus 4.8 | Anthropic | 9.8 / 10 | 예 | 가장 깊이 있는 분석; 프리미엄 비용 |
| GPT-5.4 Default | OpenAI | 9.5 / 10 | 예 | 명칭 실수 한 번; 최고의 예산형 옵션 |
| Claude Sonnet 4.6 | Anthropic | 8.7 / 10 | 아니오 | 3회 중 2회에서 트리거 임계값과 입금 한도를 혼동 |
| Claude Haiku 4.5 | Anthropic | 8.5 / 10 | 아니오 | 일관되지만 결과 근거가 약함 |
| 최저가 등급 | 예산형 | 8.0 / 10 | 아니오 | 정확한 개입 명칭을 3회 중 1회만 사용 |
| DeepSeek V4 Pro | DeepSeek | 7.8 / 10 | 아니오 | 첫 번째 실행에서 출력이 잘림; 일관성 없음 |
부적격 판정은 시사하는 바가 큽니다. Claude Sonnet 4.6은 훌륭한 문장을 만들어냈지만 트리거 임계값과 입금 한도를 혼동했습니다 — 이는 규제 대상 파일에 남는 사실상 잘못된 수치이며, 문장이 아무리 훌륭해도 부적격 사유가 됩니다. DeepSeek의 실행 간 변동폭(6, 8.5, 9)이야말로 진짜 문제입니다. 규제 업무에서 운에 좌우되는 품질은 품질이 아닙니다.
가격을 최적화하고 싶은 유혹이 있지만, 수치는 그것에 반하는 논거를 보여줍니다. 프로덕션에 적합한 모델 중 가장 비싼 Claude Opus 4.8조차 노트 한 건당 비용이 약 6센트에 불과합니다. 하루에 50건을 검토하는 팀이라면 월 90달러 미만입니다. 부정확한 노트 하나로 인한 규제 지적 비용은 목록에 있는 어떤 모델의 연간 비용도 압도할 것입니다. 규제 준수 업무에서는 가장 저렴한 모델이 아니라 가장 신뢰할 수 있는 모델을 선택하십시오.
27회 실행 전체 중 최고의 단일 노트는 Claude Fable 5에서 나왔습니다. 이 노트가 무엇을 하는지 주목하십시오. 올바른 관례로 포지션을 서술하고, 수치를 그대로 인용하며, 정확한 개입 명칭을 사용하고 — 결정적으로 — 단순히 결과를 서술하는 것이 아니라 에스컬레이션이 왜 비례적이지 않은지 그 이유를 설명합니다.
The customer is currently in a winning position of £1,612.50 with an account balance of £8,962.50, which represents an improvement on the winning position of £1,275.00 recorded at the previous review… Session duration was reviewed under Session Duration Level 1 on 19/07 and again on 20/07… Given that those decisions were made within the last few days, insufficient time has elapsed to assess their effectiveness, and repeating or escalating on the same behaviour at this stage would be disproportionate… In this context, No Further Action Required is the proportionate outcome.
이것이 바로 규제 업무가 요구하는 표준입니다. 근거에 기반하고, 비례적이며, 하루의 첫 사례와 쉰 번째 사례에서 품질이 동일한 것.
RG 노트 생성기는 하나의 구체적인 사례이지만, 이 방법론은 언어 모델이 규제 대상 또는 고위험 데이터에서 신뢰할 수 있고 반복 가능한 출력을 만들어야 하는 어떤 프로세스에도 일반화됩니다.
이 다섯 가지를 실천하면, 오후가 되면 환각을 일으키던 모델을 매번 감사 대응 가능한 출력을 생성하는 모델로 전환할 수 있습니다. 규제 업무가 요구하는 일관성은 달성 가능합니다 — 이는 아키텍처와 프롬프트 엔지니어링의 문제이며, 둘 다 해결 가능합니다.
아르시아는 FlowHunt의 AI 워크플로우 엔지니어입니다. 컴퓨터 과학 배경과 AI에 대한 열정을 바탕으로, 그는 AI 도구를 일상 업무에 통합하여 생산성과 창의성을 높이는 효율적인 워크플로우를 설계하는 데 전문성을 가지고 있습니다.

드리프트하는 ChatGPT 프롬프트를, 매번 감사 대응 가능한 노트를 생성하는 잠긴 무상태 에이전트로 전환하세요. 프롬프트를 강화하고 올바른 모델을 선택하는 것을 저희가 도와드립니다.
AI 챗봇이 프롬프트 엔지니어링, 적대적 입력, 맥락 혼란을 통해 어떻게 속일 수 있는지 알아보세요. 2025년 챗봇의 취약점과 한계를 이해합니다....
AI에서의 환각 현상이란 무엇이며, 왜 발생하고, 어떻게 피할 수 있을까요? 실용적이고 인간 중심의 전략으로 AI 챗봇의 답변 정확도를 높이는 방법을 알아보세요....
AI 챗봇 탈옥은 안전 가드레일을 우회하여 모델이 의도된 경계 밖에서 작동하도록 만듭니다. DAN, 역할극, 토큰 조작 등 가장 일반적인 기술과 챗봇을 방어하는 방법을 알아보세요....
쿠키 동의
당사는 귀하의 브라우징 경험을 향상시키고 트래픽을 분석하기 위해 쿠키를 사용합니다. See our privacy policy.