


AIチャットボットにおけるハルシネーションの理解と防止
AIにおけるハルシネーションとは何か、なぜ発生するのか、そしてどのように回避できるのか?実践的かつ人間中心の戦略で、AIチャットボットの回答を正確に保つ方法を学びましょう。...
1 分で読める
Theory
Intermediate
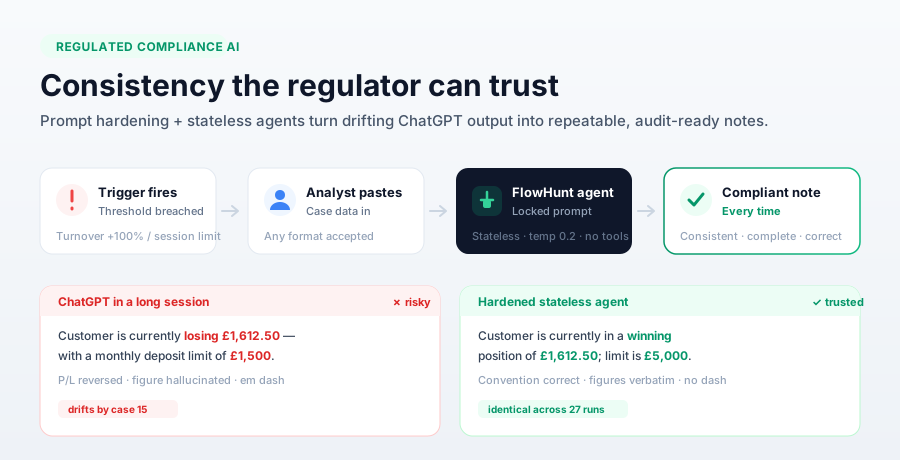
ChatGPTは規制対象のコンプライアンスノートにおいて内容がぶれ、数値を幻覚し、文体規則を崩してしまう。9モデル・27回の実行によるモデル比較テストを経て、英国のResponsible Gamblingワークフローを監査対応可能な状態にした、プロンプト強化とステートレスエージェントの手法を紹介する。
英国のResponsible Gambling(RG、責任あるギャンブル)チームが、自動化された規制対象業務に携わる誰もが心当たりのある問題を持ち込んできた。彼らは自動化されたコンプライアンストリガーを正式なアナリストノートに変換するためにChatGPTを使用している。顧客が閾値を超えたとき——30日間で入金額が100%以上増加した、あるいはセッションが制限時間を超えて続いているなど——アナリストは関連データをChatGPTにコピーし、モデルは事前にアップロードされたプロンプトに従って、その顧客のコンプライアンスファイル用のノートを起草する。
そのノートは単なる下書きメールではない。英国のUK Gambling Commission(英国ギャンブル委員会)が確認しうる法的文書である。そしてしばらくすると、ChatGPTは数値を幻覚し、重要な情報を見落とし、文体規則に反するエムダッシュを挿入し、午後になると静かにルールから逸脱し始めた。規制対象ファイルにおいて、これらのいずれもがコンプライアンス上の問題となる。
彼らが投げかけた問いはシンプルだった。そもそも言語モデルから規制対象業務が求める一貫性を得ることはできるのか? 答えはイエスだ——ただし、チャットウィンドウ内でプロンプトの文言を微調整するだけでは実現しない。アーキテクチャの変更と、規律あるプロンプトの書き直しが必要になる。本記事ではRGワークフローを実例として、同じ入力が毎回同じ信頼できる出力を生むべきあらゆる規制対象プロセスに応用できる、その具体的な手法を解説する。
何かを修正する前に、失敗モードを正確に名付けておくことが役立つ。RGワークフローでは、重大なものからささいなものまで、出力が破綻する5つの明確な形態を再現した。
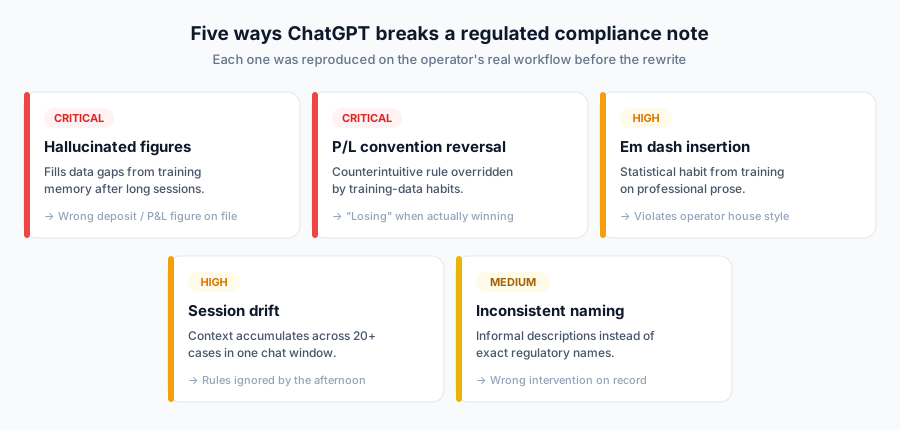
2つの重大な問題が危険な組み合わせだ。数値の幻覚は、誤った入金額や損益の数値を規制対象ファイルに記載してしまう——モデルはデータが存在しないと認める代わりに、学習時の記憶から空白を埋めてしまう。慣例の逆転はより微妙だ。このオペレーターは正の数値が顧客の負けを意味する反転した損益慣例を用いている。これは直感に反するため、モデルは学習時に習得した標準的な慣例に戻ってしまい、実際には勝っている顧客について負けていると記述してしまう。
高リスクの問題——文体規則に反するエムダッシュと、一日の後半でルールが無視されるセッションドリフト——は誤った数値をファイルに記載するわけではないが、出力への信頼を損ない、手戻りを生む。中リスクの問題、すなわち正式な規制用語ではなく略式の介入名を使ってしまう点は、コンプライアンス記録を静かに損なう。
これら5つの失敗のうち4つは1つの根本原因を共有している。単一のChatGPTセッションでは、確認するすべてのケースがコンテキストウィンドウに追加されていく。1件目のケースを確認する際、モデルが目にするのはプロンプトと1件のケースだけだ。15件目に達する頃には、プロンプトに加えて過去14回のやり取りの統計的な残滓を目にすることになる。プロンプトのルールはまだそこにあるが、増え続けるコンテキストの山と競合しており、それらへの注意は減衰していく。
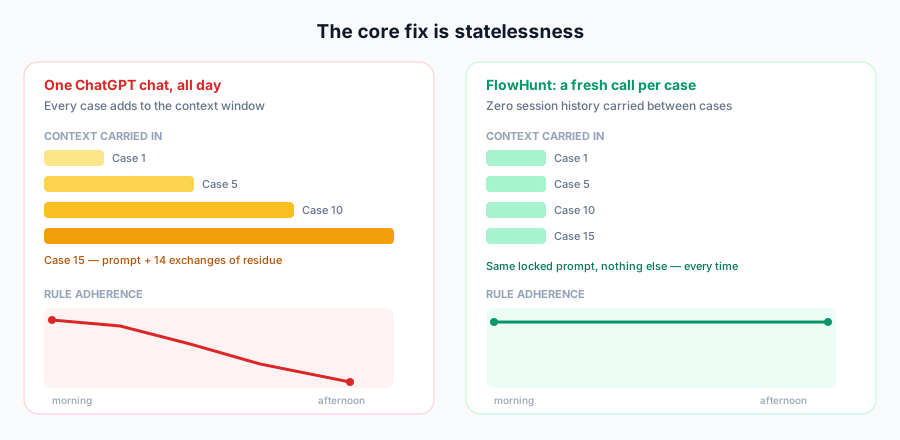
これが、同じプロンプトが午前9時には完璧なノートを生成し、午後4時には不完全なノートを生成する理由だ。アーキテクチャ上の解決策はステートレス性である。すべてのケースは、固定されたプロンプトと現在のケースのみを参照する、完全に新しく独立した呼び出しでなければならない。何も持ち越されない。このように設定されたAIエージェント は、50件目のケースでも1件目と同じ注意をプロンプトに与える。
ステートレス性は必要条件ではあるが十分条件ではない。ドリフトは止まるが、悪いプロンプトであれば毎回忠実にそれを再現してしまう。だからこそプロンプト自体を強化する必要がある。
言語モデルはプロンプトのすべての行を等しく重み付けするわけではない。注意はおおむねU字型を描き、冒頭と末尾で最も強く、中間で最も弱くなる。元のRGプロンプトはこれに逆らっていた。最も重要なルールである損益慣例の反転は、プロンプトの中間に1回だけ記載されていた。エムダッシュの禁止事項は最後の1行に、これも1回だけ記載されていた。
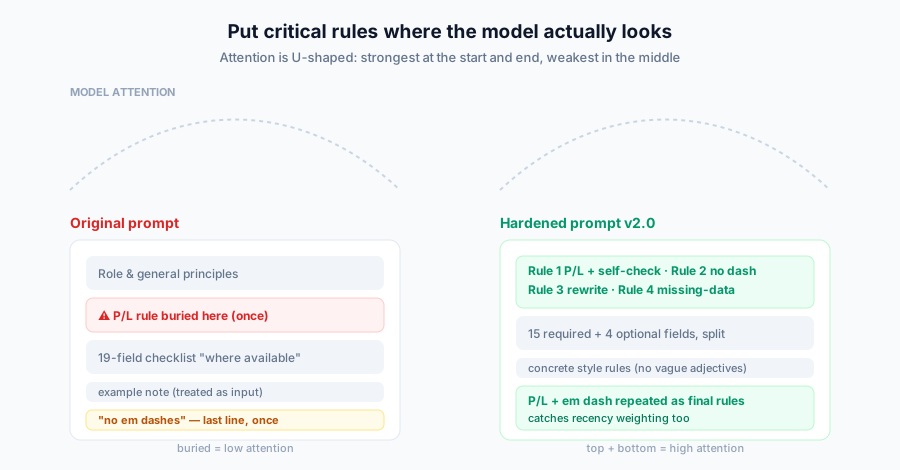
書き直しにあたっては、重要なルールをモデルが実際に目を向ける場所に移動し、システムプロンプト の弱い部分を作り直した。変更内容とその理由は以下の通りだ。
| 元のプロンプト | 強化版 v2.0 | 重要な理由 |
|---|---|---|
| P/Lルールがプロンプト中間に埋もれ、1回のみ記載 | ルール1として冒頭に自己チェックのステップとともに配置し、文体セクションでも繰り返す | 初頭効果の重み付け——最も重要なルールは最初に来なければならない |
| エムダッシュ禁止が末尾に1回のみ | ルール2として冒頭に配置し、末尾でも最終ルールとして繰り返す | 初頭効果と新近効果の両方を捉える |
| 不完全な入力に対する指示なし | ルール4——正確な応答フォーマットを伴う欠落データプロトコル | 幻覚を排除し、監査証跡を作成する |
| 入力フォーマットに関する指示なし | ルール3——あらゆる形式を受け入れ、常にゼロから書き直す | モデルが貼り付けられたノートを軽く整形し直すだけになるのを防ぐ |
| 必須項目19個、すべて同等の重み付け | 必須15個+任意4個、明確に分離 | 任意項目は静かに省略され、必須項目は欠落時に生成をブロックする |
| 「プロフェッショナルに。自然に。機械的にならないように。」 | 具体的なルール:接続表現、多様な文の長さ、禁止される構文 | 曖昧な形容詞は守られないが、具体的なルールは守られる |
| 例文ノートを含めていた | 例文を完全に削除 | モデルが例文を応答すべき入力として扱ってしまっていた |
ここで得られる最大の教訓はこうだ。曖昧な形容詞は指示にならない。 モデルに「自然に」書くよう伝えることは、文体規則を破るエムダッシュや修辞的な誇張表現を実際には助長していた。それを具体的でテスト可能なルールに置き換えたことこそが、文体の一貫性を実現した。
幻覚はしばしばモデルの欠陥として語られる。しかし構造化された業務においては、それは通常プロンプトの欠陥である。プロンプトが項目欠落時にモデルが何をすべきかを一度も指示していないため、モデルは統計的にありそうなことを行い、もっともらしい値を生成してしまう。
解決策は欠落データプロトコルだ。項目を必須と任意に分ける。任意項目は欠落時に静かに省略される。必須項目はその逆で、欠落している場合はノートを生成する代わりに、モデルは停止し、正確なフォーマットでその項目を要求しなければならない。この一つのルールが、見えない幻覚を、目に見える監査可能な追加データの要求へと変える。それは、規制対象ファイルに誤った数値が記載されることと、入力が不完全であったために一度もノートが生成されなかったこととの違いである。

最新のヒント、トレンド、お得な情報を無料で入手。
強化されたプロンプトができたら、何もばらつきを再導入しないよう、エージェント自体もロックダウンする必要がある。フロー全体は意図的に最小限に抑えられており、3つのノード以外は何もない。
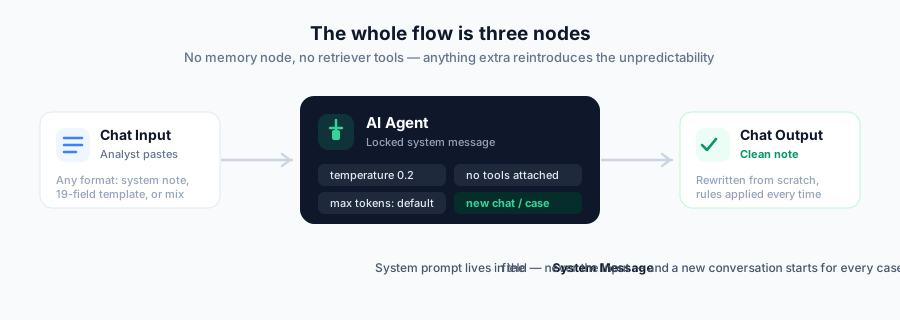
重要だった設定上の選択は以下の通りだ。
上記のすべての修正は、たった一つの悪習によって台無しになりうる。同じチャットを使い回すことだ。アナリストチームにとって最も重要な運用ルールは、すべてのケースごとに新しい会話を開始することである。同じウィンドウで複数のケースを続けて確認しないこと。これがセッションドリフト——元の失敗のほとんどの根本原因——を排除するルールであり、実行するのに何のコストもかからない。
チーム内でチャットウィンドウのプロンプトがぶれることに悩まされているなら、解決策はステートレスエージェント上で動く強化されたプロンプトです。FlowHuntを使えば、プロンプトを固定し、モデルとtemperatureをピン留めし、ケースごとにクリーンな呼び出しを実行できます。ぜひその実現をお手伝いさせてください。
手法はその裏付けとなる証拠があってこそ良いものになる。私たちは9つのモデルを強化済みプロンプトに対してテストした。同一の実際のケース(過去のセッション時間履歴を伴うGambling Intensityトリガー)を各モデルにつき3回ずつ実行——合計27回の実行——し、16のコンプライアンス基準に照らして各実行を採点した。
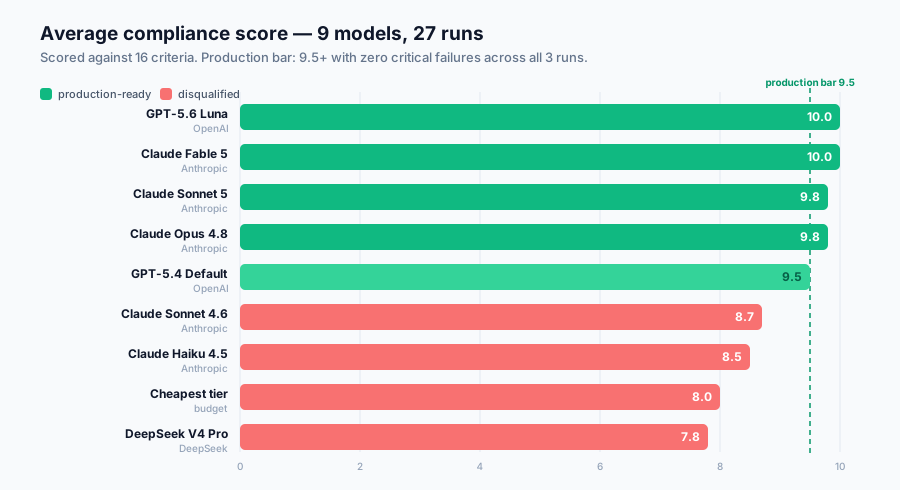
27回の実行すべてにおいて、実運用可能なモデルは数値を幻覚したり、P/L慣例を逆転させたり、エムダッシュを使用したり、出力を打ち切ったりすることはなかった。強化されたプロンプトは、条件を満たしたモデルにおいて元の失敗モードのすべてを排除した。残った違いは正確性ではなく、分析の深さと一貫性に関するものだった。
| モデル | ベンダー | 平均スコア | 実運用可能 | 備考 |
|---|---|---|---|---|
| GPT-5.6 Luna | OpenAI | 10 / 10 | Yes | 3回すべてで完璧、最高の一貫性 |
| Claude Fable 5 | Anthropic | 10 / 10 | Yes | 最も論理立てられた結論段落、最良の単一ノート |
| Claude Sonnet 5 | Anthropic | 9.8 / 10 | Yes | どの実行でも幻覚なし、Claude全体で最もバランスが良い |
| Claude Opus 4.8 | Anthropic | 9.8 / 10 | Yes | 最も深い分析、プレミアムコスト |
| GPT-5.4 Default | OpenAI | 9.5 / 10 | Yes | 名称の言い間違いが1件、最良の予算オプション |
| Claude Sonnet 4.6 | Anthropic | 8.7 / 10 | No | 3回中2回でトリガー閾値と入金限度額を混同 |
| Claude Haiku 4.5 | Anthropic | 8.5 / 10 | No | 一貫性はあるが結論の論拠が弱い |
| 最安価格帯 | Budget | 8.0 / 10 | No | 正確な介入名は3回中1回のみ |
| DeepSeek V4 Pro | DeepSeek | 7.8 / 10 | No | 1回目の実行で出力が打ち切られ、一貫性に欠ける |
失格となったモデルは示唆に富む。Claude Sonnet 4.6は美しい文章を生成したが、トリガー閾値と入金限度額を混同した——規制対象ファイルにおける事実として誤った数値であり、どれほど読みやすい文章であっても失格となる。DeepSeekの実行ごとのばらつき(6、8.5、9)こそが本当の問題だ。規制対象業務において、運次第で決まる品質はそもそも品質とは言えない。
価格を最適化したくなるのは分かるが、数字を見ればその考えに反する結論が出る。最も高価な実運用可能モデルであるClaude Opus 4.8でさえ、1件のノートあたりのコストはおよそ6セントだ。1日に50件のケースを確認するチームにとって、これは月あたり90ドル未満に収まる。誤ったノート1件による規制上の指摘のコストは、リスト上のどのモデルの年間コストをもはるかに上回るだろう。規制対象コンプライアンスにおいては、最も安いモデルではなく、最も信頼できるモデルを選ぶべきだ。
27回の実行の中で最良の単一ノートは、Claude Fable 5によるものだった。その内容に注目してほしい。正しい慣例でポジションを記述し、数値を一字一句正確に引用し、正確な介入名を使用し——そして決定的に——なぜエスカレーションが不相応であるのかを単に結果を述べるだけでなく説明している。
The customer is currently in a winning position of £1,612.50 with an account balance of £8,962.50, which represents an improvement on the winning position of £1,275.00 recorded at the previous review… Session duration was reviewed under Session Duration Level 1 on 19/07 and again on 20/07… Given that those decisions were made within the last few days, insufficient time has elapsed to assess their effectiveness, and repeating or escalating on the same behaviour at this stage would be disproportionate… In this context, No Further Action Required is the proportionate outcome.
これこそが規制対象業務が求める水準である。エビデンスに基づき、均衡が取れており、一日の最初のケースでも50件目のケースでも品質が同一であること。
このRGノート生成の事例は特定のケースだが、その手法は、言語モデルが規制対象またはハイステークスなデータについて信頼でき再現可能な出力を生成しなければならないあらゆるプロセスに一般化できる。
この5つを実行すれば、午後になると幻覚を起こすモデルを、毎回監査対応可能な出力を生成するモデルへと変えることができる。規制対象業務が求める一貫性は達成可能だ——それはアーキテクチャとプロンプトエンジニアリングの問題であり、そのどちらも解決可能である。
アルシアはFlowHuntのAIワークフローエンジニアです。コンピュータサイエンスのバックグラウンドとAIへの情熱を持ち、AIツールを日常業務に統合して効率的なワークフローを作り出し、生産性と創造性を高めることを専門としています。

ぶれるChatGPTプロンプトを、毎回監査対応可能なノートを生成する固定されたステートレスエージェントに変えます。プロンプトの強化と最適なモデル選定をお手伝いします。
AIにおけるハルシネーションとは何か、なぜ発生するのか、そしてどのように回避できるのか?実践的かつ人間中心の戦略で、AIチャットボットの回答を正確に保つ方法を学びましょう。...
AIチャットボットがプロンプトエンジニアリング、敵対的入力、コンテキスト混乱によってどのようにだまされるかを学びます。2025年におけるチャットボットの脆弱性と限界を理解しましょう。...
コンテキストウィンドウ操作とは、大規模言語モデルの有限なコンテキストウィンドウを悪用する攻撃を指し、コンテキストスタッフィング、コンテキストオーバーフロー、戦略的ポイズニングなどを含み、パフォーマンスを低下させたり、悪意のあるペイロードを隠したり、以前の指示を上書きしたりします。...
クッキーの同意
閲覧体験を向上させ、トラフィックを分析するためにクッキーを使用します。 See our privacy policy.