Slik stopper du ChatGPT fra å hallusinere på regulert compliance-arbeid
ChatGPT sporer av, hallusinerer tall og bryter husstil på regulerte compliance-notater. Her er metoden med prompt-herding og en tilstandsløs agent som gjorde en britisk Responsible Gambling-arbeidsflyt revisjonsklar — med modelltesting på tvers av 9 modeller og 27 kjøringer.
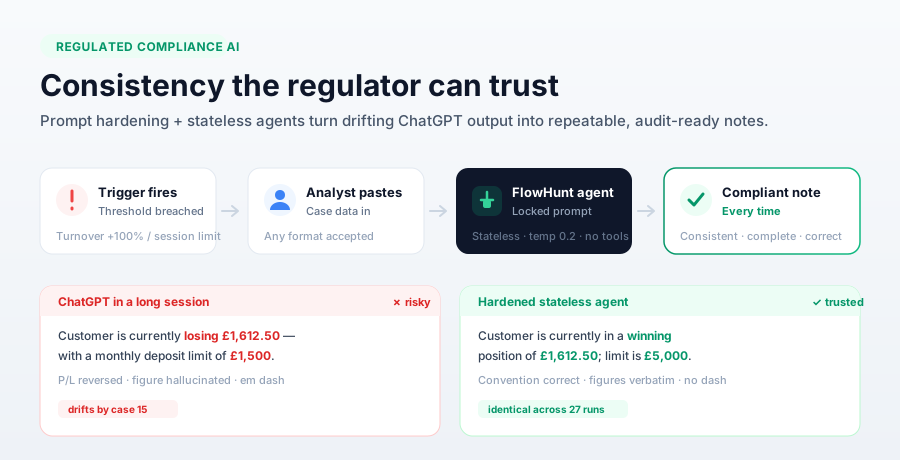
Et britisk Responsible Gambling-team (RG) kom til oss med et problem alle som automatiserer regulert arbeid, vil kjenne igjen. De bruker ChatGPT til å gjøre automatiserte compliance-varsler om til formelle analytikernotater. Når en kunde bryter en terskel — omsetning opp mer enn 100 % på 30 dager, en økt som varer lenger enn grensen — kopierer en analytiker de relevante dataene inn i ChatGPT, og modellen, som følger en forhåndslastet prompt, utformer et notat til kundens compliance-mappe.
Det notatet er ikke et e-postutkast. Det er et juridisk dokument som kan gjennomgås av UK Gambling Commission. Og etter en stund begynte ChatGPT å hallusinere tall, gå glipp av nøkkelinformasjon, sette inn tankestreker som brøt husstilen, og stille og rolig gli bort fra reglene utover ettermiddagen. På en regulert sak er hver eneste av disse et compliance-problem.
Spørsmålet de stilte var enkelt: kan vi i det hele tatt oppnå den konsistensen regulert arbeid krever, fra en språkmodell? Svaret er ja — men ikke ved å finpusse ordlyden i en prompt inne i et chatvindu. Det krever en arkitekturendring pluss en disiplinert omskriving. Denne artikkelen går gjennom den eksakte metoden, med RG-arbeidsflyten som gjennomarbeidet eksempel, slik at du kan bruke den på enhver regulert prosess der samme input må gi samme pålitelige output hver eneste gang.
Hvorfor ChatGPT sporer av på regulert arbeid
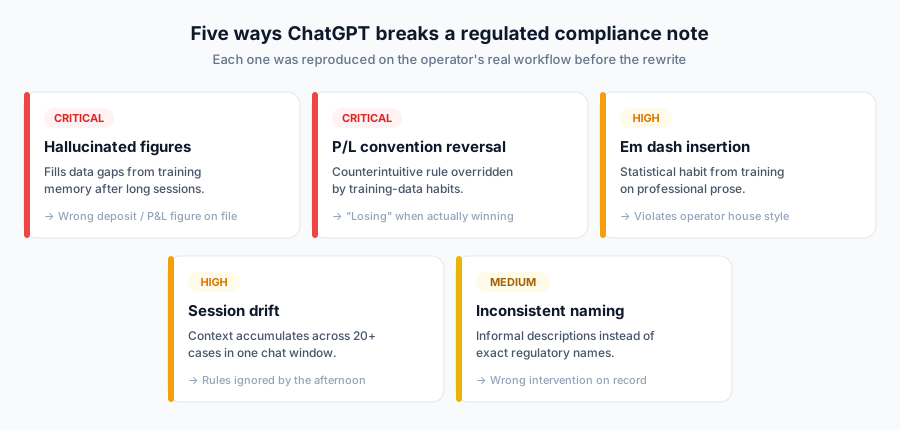
Før vi fikser noe som helst, er det nyttig å presist navngi feilmodusene. På RG-arbeidsflyten gjenskapte vi fem distinkte måter outputen brøt sammen på, fra kritiske til bare irriterende.
De to kritiske er det farlige paret. Hallusinerte tall setter et feil innskudds- eller resultattall på en regulert sak — modellen fyller et datahull fra treningshukommelsen i stedet for å innrømme at dataene mangler. Reversering av konvensjon er mer subtil: denne operatøren bruker en invertert profit-and-loss-konvensjon der et positivt tall betyr at kunden taper. Det er kontraintuitivt, så modellen faller tilbake på standardkonvensjonen den lærte under trening, og skriver at en kunde taper når vedkommende faktisk vinner.
De alvorlige problemene med høy prioritet — tankestreker som bryter husstilen, og session drift der reglene ignoreres senere på dagen — setter ikke et feil tall på saken, men de undergraver tilliten til outputen og skaper ekstraarbeid. Problemet med middels alvorlighetsgrad, uformelle intervensjonsnavn i stedet for de nøyaktige regulatoriske betegnelsene, korrumperer stille og rolig compliance-journalen.
Rotårsaken er statelessness — eller mangelen på det
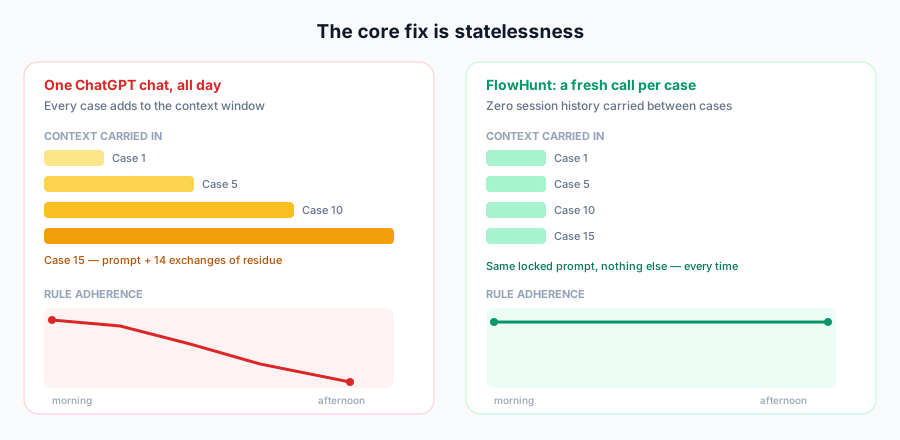
Fire av de fem svikttypene deler én felles rotårsak. I én enkelt ChatGPT-økt blir hver sak du gjennomgår, lagt til kontekstvinduet. Gjennomgå sak én, og modellen ser prompten og én sak. Ved sak femten ser den prompten pluss det statistiske restmaterialet fra fjorten tidligere utvekslinger. Prompten sine regler er fortsatt der, men de konkurrerer med en voksende haug med kontekst, og oppmerksomheten mot dem svekkes.
Dette er grunnen til at samme prompt produserer et perfekt notat klokken 9 og et mangelfullt et klokken 16. Den arkitektoniske løsningen er statelessness (tilstandsløshet): hver sak må være et helt nytt, isolert kall som bare ser den låste prompten og den aktuelle saken. Ingenting føres videre. En AI-agent
konfigurert på denne måten gir prompten samme oppmerksomhet på sak femti som på sak én.
Statelessness er nødvendig, men ikke tilstrekkelig. Det stopper avdriften, men det vil trofast gjenskape en dårlig prompt på hvert eneste kall. Så selve prompten må herdes.
Klar til å vokse bedriften din?
Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
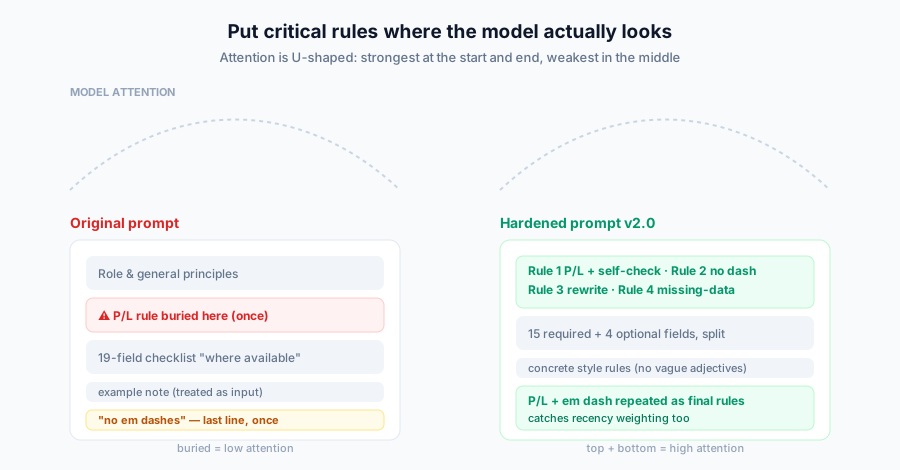
Språkmodeller vekter ikke hver eneste linje i en prompt likt. Oppmerksomheten er omtrent U-formet — sterkest i begynnelsen og på slutten, svakest i midten. Den opprinnelige RG-prompten kjempet mot dette. Den viktigste regelen, den inverterte profit-and-loss-konvensjonen, lå midt i prompten, uttrykt kun én gang. Forbudet mot tankestreker var den aller siste linjen, også uttrykt kun én gang.
Omskrivingen flyttet de kritiske reglene dit modellen faktisk ser, og bearbeidet de svake delene av systemprompten
. Her er hva som ble endret, og hvorfor.
Original
Herdet v2.0
Hvorfor det betyr noe
P/L-regelen gjemt midt i prompten, uttrykt én gang
Regel 1 helt i toppen med et selvsjekk-trinn, gjentatt i skrivestil-seksjonen
Primacy-vekting — den viktigste regelen må komme først
Forbud mot tankestrek helt til slutt, én gang
Regel 2 i toppen, gjentatt som siste regel i bunnen
Fanger opp både primacy- og recency-vekting
Ingen instruksjon for ufullstendig input
Regel 4 — protokoll for manglende data med et eksakt svarformat
Eliminerer hallusinasjon og skaper et revisjonsspor
Ingen instruksjon for inputformat
Regel 3 — aksepter ethvert format, skriv alltid om fra bunnen av
Hindrer modellen i å bare lett omformulere et innlimt notat
Vage adjektiver følges ikke; konkrete regler gjør det
Eksempelnotat inkludert
Eksempel fjernet helt
Modellen behandlet eksemplet som input den skulle svare på
Den enkeltviktigste lærdommen her: vage adjektiver er ikke instruksjoner. Å be en modell om å være «naturlig» oppmuntret aktivt til tankestrekene og de retoriske utsvevelsene som brøt husstilen. Å erstatte det med konkrete, testbare regler er det som gjorde stilen konsistent.
Steg 2: Håndter manglende data i stedet for å finne på dem
Hallusinasjon blir ofte framstilt som en modellfeil. På strukturert arbeid er det som regel en prompt-feil: prompten fortalte aldri modellen hva den skulle gjøre når et felt mangler, så den gjorde det statistisk sannsynlige og produserte en plausibel verdi.
Løsningen er en protokoll for manglende data. Del feltene dine inn i obligatoriske og valgfrie. Valgfrie felt utelates stille når de mangler. Obligatoriske felt gjør det motsatte — hvis ett mangler, må modellen stoppe og etterspørre det i et eksakt format i stedet for å generere et notat. Den ene regelen gjør en usynlig hallusinasjon om til en synlig, reviderbar forespørsel om mer data. Det er forskjellen mellom et feil tall på en regulert sak og et notat som aldri ble produsert fordi inputen var ufullstendig.
Bli med i vårt nyhetsbrev
Få de siste tipsene, trendene og tilbudene gratis.
Steg 3: Lås agentkonfigurasjonen
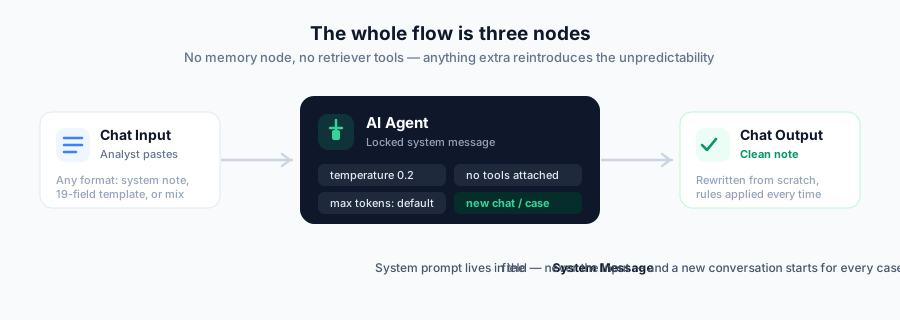
Med en herdet prompt må selve agenten låses ned slik at ingenting gjeninnfører variabilitet. Hele flyten er bevisst minimal — tre noder og ikke noe mer.
Konfigurasjonsvalgene som betydde noe:
Systemprompt i System Message-feltet, aldri i Input-feltet, slik at den leses som instruksjoner og ikke som data.
Temperature 0,2. Lav nok for maksimal konsistens, høy nok til å unngå robotaktig prosa. Null var for rigid; én var for kreativ.
Ingen verktøy tilkoblet. Fil- og URL-hentere introduserer uforutsigbarhet og kan omgå agentens resonnering. For denne oppgaven trenger modellen ikke noe annet enn prompten og den innlimte saken.
Maks tokens på standardverdi. Å begrense tokens førte til at notater ble kuttet av midt i en setning, og et avkuttet notat på en kundesak er i seg selv en regulatorisk risiko.
En instruksjon om stille start øverst i prompten, slik at agenten ikke bekrefter reglene tilbake til analytikeren når flyten først lastes.
Den ene operasjonelle regelen som betyr mest
Alle løsningene ovenfor blir opphevet av én dårlig vane: å gjenbruke samme chat. Den viktigste operasjonelle regelen for analytikerteamet er å starte en ny samtale for hver eneste sak. Fortsett aldri å gjennomgå saker i samme vindu. Dette er regelen som eliminerer session drift — rotårsaken til de fleste av de opprinnelige feilene — og den koster ingenting å følge.
Konsistens er et arkitekturproblem, ikke et ordlydsproblem
Hvis teamet ditt kjemper mot en prompt som sporer av inne i et chatvindu, er løsningen en herdet prompt som kjører på en tilstandsløs agent. FlowHunt lar deg låse prompten, feste modellen og temperature, og kjøre et rent kall per sak. La oss hjelpe deg dit.
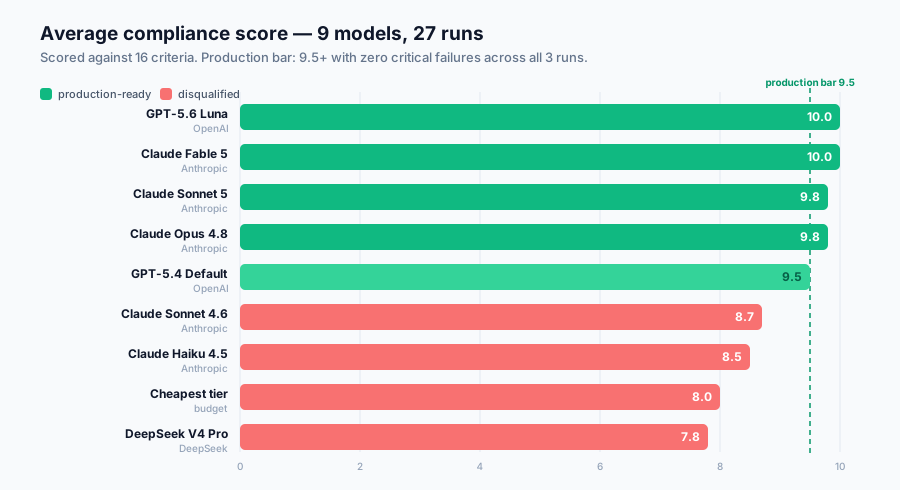
En metode er bare så god som beviset for den. Vi testet ni modeller mot den herdede prompten, med en identisk reell sak (en Gambling Intensity-utløser med tidligere historikk for øktvarighet) på tvers av tre kjøringer hver — 27 kjøringer totalt — og scoret hver kjøring mot 16 compliance-kriterier.
På tvers av alle 27 kjøringer hallusinerte ingen produksjonsklar modell et tall, reverserte P/L-konvensjonen, brukte en tankestrek eller kuttet av output. Den herdede prompten eliminerte hver eneste av de opprinnelige feilmodusene på modellene som kvalifiserte. Forskjellene som gjensto, handlet om analytisk dybde og konsistens, ikke korrekthet.
Modell
Leverandør
Snittscore
Produksjon
Notater
GPT-5.6 Luna
OpenAI
10 / 10
Ja
Perfekt på alle tre kjøringer; høyest konsistens
Claude Fable 5
Anthropic
10 / 10
Ja
Mest gjennomtenkte resultatavsnitt; beste enkeltnotat
Claude Sonnet 5
Anthropic
9,8 / 10
Ja
Ingen hallusinasjon på noen kjøring; beste Claude-modell samlet sett
Claude Opus 4.8
Anthropic
9,8 / 10
Ja
Dypest analyse; premiumkostnad
GPT-5.4 Default
OpenAI
9,5 / 10
Ja
Én navngivningsglipp; beste budsjettalternativ
Claude Sonnet 4.6
Anthropic
8,7 / 10
Nei
Forvekslet utløsergrensen med innskuddsgrensen i 2/3 kjøringer
Claude Haiku 4.5
Anthropic
8,5 / 10
Nei
Konsistent, men svak resultatbegrunnelse
Billigste tier
Budsjett
8,0 / 10
Nei
Eksakt intervensjonsnavn i bare 1/3 kjøringer
DeepSeek V4 Pro
DeepSeek
7,8 / 10
Nei
Avkuttet output på kjøring 1; inkonsekvent
Diskvalifikasjonene er lærerike. Claude Sonnet 4.6 produserte vakker prosa, men forvekslet utløsergrensen med innskuddsgrensen — et faktisk feil tall på en regulert sak, som er diskvalifiserende uansett hvor godt det leses. DeepSeeks svingninger fra kjøring til kjøring (6, 8,5, 9) er det egentlige problemet: i regulert arbeid er kvalitet som avhenger av flaks, ikke kvalitet i det hele tatt.
Kostnad er ikke begrensningen
Det er fristende å optimalisere for pris, men tallene taler mot det. Selv den dyreste produksjonsklare modellen, Claude Opus 4.8, koster rundt seks cent per notat. For et team som gjennomgår 50 saker om dagen, er det under 90 dollar i måneden. Kostnaden ved ett eneste regulatorisk avvik fra et feilaktig notat ville overgå den årlige kostnaden for enhver modell på listen. For regulert compliance-arbeid, velg den mest pålitelige modellen du kan, ikke den billigste.
Slik ser et herdet notat ut
Det beste enkeltnotatet på tvers av alle 27 kjøringer kom fra Claude Fable 5. Legg merke til hva det gjør: det angir posisjonen i riktig konvensjon, siterer tall ordrett, bruker det eksakte intervensjonsnavnet, og — avgjørende — forklarer hvorfor en eskalering ville vært uforholdsmessig, i stedet for bare å slå fast et utfall.
The customer is currently in a winning position of £1,612.50 with an account balance of £8,962.50, which represents an improvement on the winning position of £1,275.00 recorded at the previous review… Session duration was reviewed under Session Duration Level 1 on 19/07 and again on 20/07… Given that those decisions were made within the last few days, insufficient time has elapsed to assess their effectiveness, and repeating or escalating on the same behaviour at this stage would be disproportionate… In this context, No Further Action Required is the proportionate outcome.
Det er standarden regulert arbeid krever: evidensbasert, forholdsmessig, og identisk i kvalitet på dagens første sak som på den femtiende.
Å anvende dette på din egen regulerte arbeidsflyt
RG-notatgeneratoren er et konkret tilfelle, men metoden generaliserer til enhver prosess der en språkmodell må produsere pålitelig, repeterbar output på regulerte eller høyrisiko-data:
Beveg deg bort fra chatvinduet. Kjør hver sak som et tilstandsløst kall slik at kontekst ikke kan akkumuleres og spore av.
Herd prompten for primacy og recency. Sett kritiske regler først og gjenta dem sist. Legg til selvsjekker.
Gi modellen en protokoll for manglende data. Obligatoriske felt blokkerer generering når de mangler; valgfrie felt utelates stille. La den aldri gjette.
Lås konfigurasjonen. Lav, ikke-null temperature, ingen unødvendige verktøy, ubegrenset output, prompt i systemmeldingen.
Test før du stoler på den. Kjør samme sak flere ganger på tvers av kandidatmodeller og scor mot eksplisitte kriterier. Konsistens på tvers av kjøringer er metrikken som betyr noe.
Gjør de fem tingene, og du gjør om en modell som hallusinerer utover ettermiddagen, til én som produserer revisjonsklar output hver eneste gang. Konsistensen regulert arbeid krever, er oppnåelig — det er et arkitektur- og prompt-engineering-problem, og begge deler kan løses.
Vanlige spørsmål
Hovedårsaken er session drift (kontekstglidning). I ett langt chatvindu blir hver sak du gjennomgår lagt til kontekstvinduet. Ved den femtende saken jobber modellen ut fra prompten pluss det statistiske restmaterialet fra fjorten tidligere utvekslinger, og den begynner å fylle datahull fra treningshukommelsen i stedet for saken foran seg. En tilstandsløs agent som starter et helt nytt kall per sak, fjerner dette fullstendig.
Prompt hardening er å skrive om en prompt slik at de viktigste reglene havner der modellen faktisk retter oppmerksomheten — helt i toppen og helt i bunnen — med selvsjekk-trinn og eksplisitt håndtering av manglende eller uventede data. Det erstatter vage stilbeskrivelser med konkrete regler og skiller obligatoriske felt fra valgfrie, slik at modellen utelater fraværende data i stedet for å finne på dem.
Fordi det ikke finnes noen akkumulert kontekst å spore av mot. Hver sak er et isolert kall som bare ser den låste systemprompten og de aktuelle sakdataene. Prompten får samme oppmerksomhet på sak én som på sak femti, så regeloverholdelsen holder seg stabil gjennom hele arbeidsdagen i stedet for å svekkes utover ettermiddagen.
I testing på tvers av 9 modeller og 27 kjøringer mot 16 compliance-kriterier var fem modeller produksjonsklare: GPT-5.6 Luna og Claude Fable 5 scoret perfekte 10/10, Claude Sonnet 5 og Claude Opus 4.8 scoret 9,8, og GPT-5.4 Default scoret 9,5 som budsjettalternativet. Det riktige valget avhenger av volum, sakskompleksitet og kostnadstoleranse snarere enn én enkelt vinner.
En lav, men ikke-null temperature fungerer best. I dette prosjektet ga 0,2 maksimal konsistens uten at output ble robotaktig. En temperature på 0 har en tendens til å bli for rigid, og 1 for kreativ for regulert arbeid der samme input må gi samme notat.
Ja, forutsatt at pipelinen er kontrollert. Notatet forblir et juridisk dokument som kan gjennomgås av tilsynsmyndigheten, så modellen må aldri hallusinere et tall, snu en konvensjon eller kutte av output. En herdet prompt, en tilstandsløs agent, en låst modell og en protokoll for manglende data som stopper i stedet for å gjette, er det som gjør outputen pålitelig nok for en regulert sak.
Arshia er en AI Workflow Engineer hos FlowHunt. Med bakgrunn i informatikk og en lidenskap for kunstig intelligens, spesialiserer han seg på å lage effektive arbeidsflyter som integrerer AI-verktøy i daglige oppgaver, og dermed øker produktivitet og kreativitet.
Arshia Kahani
AI Workflow Engineer
Gi din regulerte arbeidsflyt FlowHunts konsistens
Gjør en ChatGPT-prompt som sporer av, om til en låst, tilstandsløs agent som produserer revisjonsklare notater hver gang. Vi hjelper deg med å herde prompten og velge riktig modell.
De enkleste måtene å koble ChatGPT til dine data (2024-guide)
Oppdag de mest effektive og brukervennlige metodene for å koble ChatGPT til dine egne data, inkludert innebygde koblinger, Custom GPT-er og den sømløse FlowHunt...
AI chatbot-assistent drevet av OpenAI GPT-4o som automatisk søker og utnytter interne bedriftsdokumenter for å svare på brukerens spørsmål. Leverer kontekstsens...
En sanntids chatbot som bruker Google Søk begrenset til ditt eget domene, henter relevant nettinnhold, og utnytter OpenAI LLM for å svare på brukerforespørsler ...
4 min lesing
Informasjonskapselsamtykke Vi bruker informasjonskapsler for å forbedre din surfeopplevelse og analysere vår trafikk. See our privacy policy.