Så stoppar du ChatGPT från att hallucinera i reglerat compliance-arbete
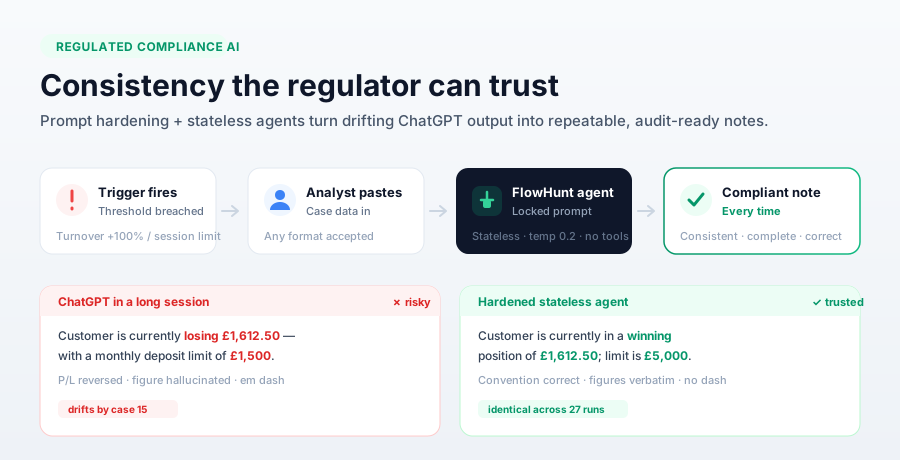
ChatGPT driver iväg, hallucinerar siffror och bryter husstilen i reglerade compliance-anteckningar. Här är metoden med prompt-hardening och en tillståndslös agent som gjorde ett brittiskt Responsible Gambling-flöde granskningsklart — med modelltestning över 9 modeller och 27 körningar.
Ett brittiskt Responsible Gambling-team (RG) kom till oss med ett problem som alla som automatiserar reglerat arbete känner igen. De använder ChatGPT för att omvandla automatiska compliance-triggers till formella analytikeranteckningar. När en kund bryter mot ett tröskelvärde — omsättningen upp mer än 100 % på 30 dagar, en session som pågår längre än gränsen — kopierar en analytiker den relevanta datan till ChatGPT, och modellen, som följer en förladdad prompt, utformar en anteckning för kundens compliance-ärende.
Den anteckningen är inte ett utkast till ett mejl. Det är ett juridiskt dokument som kan granskas av UK Gambling Commission. Och efter ett tag började ChatGPT hallucinera siffror, missa viktig information, infoga tankstreck som bröt mot husstilen, och tyst driva bort från reglerna under eftermiddagen. I ett reglerat ärende är vart och ett av dessa en compliance-fråga.
Frågan de ställde var enkel: kan vi över huvud taget få den konsekvens som reglerat arbete kräver från en språkmodell? Svaret är ja — men inte genom att finjustera formuleringen i en prompt inuti ett chattfönster. Det krävs en förändring i arkitektur plus en disciplinerad omskrivning. Den här artikeln går igenom exakt metoden, med RG-flödet som det praktiska exemplet, så att du kan tillämpa den på vilken reglerad process som helst där samma indata måste ge samma pålitliga resultat varje enda gång.
Varför ChatGPT driver iväg i reglerat arbete
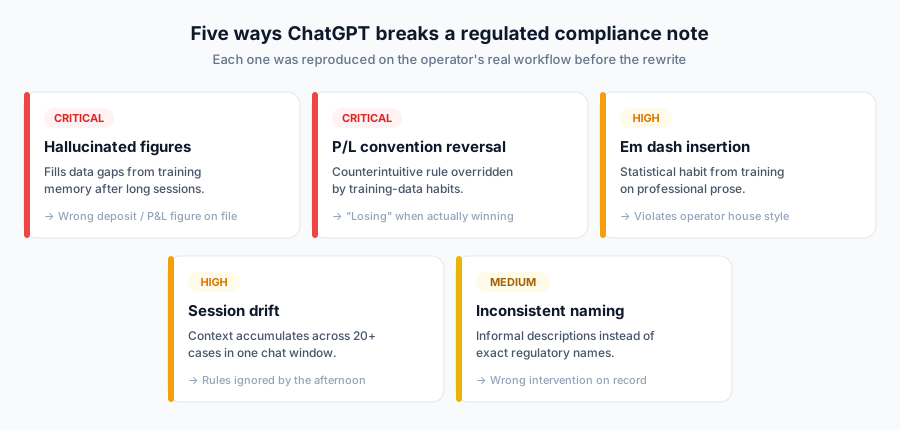
Innan man fixar något är det värdefullt att namnge felmönstren precist. I RG-flödet återskapade vi fem distinkta sätt som resultatet gick fel på, från kritiska till bara irriterande.
De två kritiska är det farliga paret. Hallucinerade siffror sätter en felaktig insättnings- eller vinst/förlust-siffra i ett reglerat ärende — modellen fyller en lucka från träningsminnet istället för att erkänna att datan saknas. Omkastning av konvention är subtilare: den här operatören använder en omvänd vinst/förlust-konvention där ett positivt tal betyder att kunden förlorar. Det är kontraintuitivt, så modellen faller tillbaka på standardkonventionen den lärde sig under träning och skriver att en kund förlorar när denne egentligen vinner.
De allvarliga problemen — tankstreck som bryter mot husstilen, och session drift där reglerna ignoreras senare på dagen — sätter inte en felaktig siffra i ärendet, men de undergräver förtroendet för resultatet och skapar merarbete. Det mellanliggande problemet, informella interventionsnamn istället för de exakta regulatoriska termerna, korrumperar tyst compliance-registret.
Grundorsaken är statslöshet — eller bristen på den
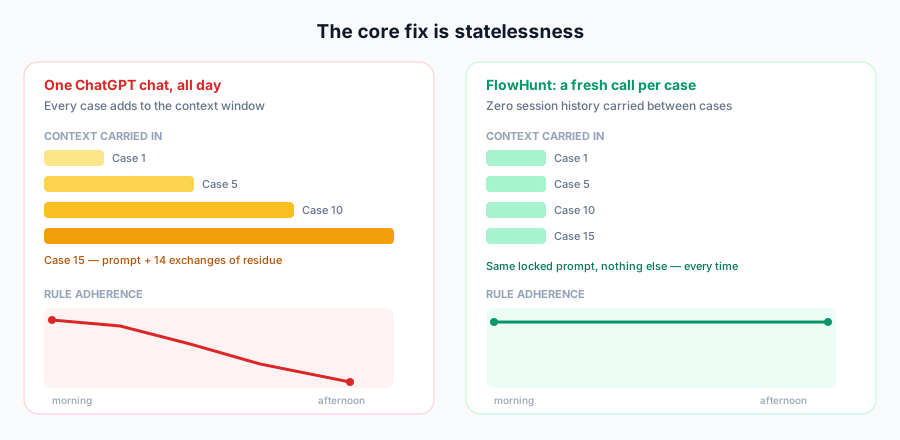
Fyra av dessa fem fel har en gemensam grundorsak. I en enda ChatGPT-session läggs varje ärende du granskar till i kontextfönstret. Granska ärende ett och modellen ser prompten och ett ärende. Vid ärende femton ser den prompten plus den statistiska resten av fjorton tidigare utbyten. Promptens regler finns fortfarande där, men de konkurrerar med en växande hög av kontext, och uppmärksamheten på dem avtar.
Det är därför samma prompt producerar en perfekt anteckning klockan 9 och en bristfällig klockan 16. Den arkitektoniska lösningen är statslöshet: varje ärende måste vara ett helt nytt, isolerat anrop som bara ser den låsta prompten och det aktuella ärendet. Inget förs vidare. En AI-agent
konfigurerad på detta sätt ger prompten samma uppmärksamhet vid ärende femtio som vid ärende ett.
Statslöshet är nödvändigt men inte tillräckligt. Det stoppar kontextdriften, men det kommer troget att återge en dålig prompt vid varje anrop. Så själva prompten måste härdas.
Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
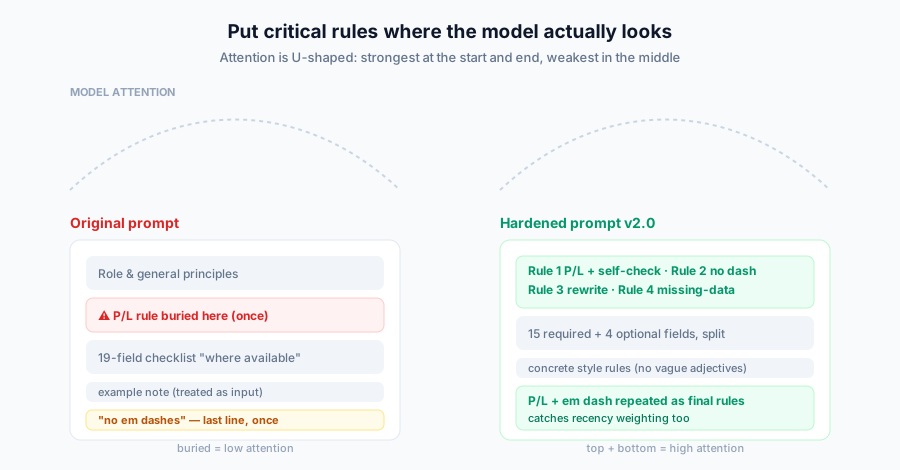
Språkmodeller viktar inte varje rad i en prompt lika. Uppmärksamheten är ungefär U-formad — starkast i början och slutet, svagast i mitten. Den ursprungliga RG-prompten gick emot detta. Dess viktigaste regel, den omvända vinst/förlust-konventionen, låg i mitten av prompten, angiven en enda gång. Förbudet mot tankstreck var den allra sista raden, också angiven en enda gång.
Omskrivningen flyttade de kritiska reglerna dit modellen faktiskt tittar och omarbetade de svaga delarna av systemprompten
. Här är vad som ändrades och varför.
Original
Härdad v2.0
Varför det spelar roll
Vinst/förlust-regeln begravd mitt i prompten, angiven en gång
Regel 1 allra högst upp med ett självkontrollsteg, upprepad i avsnittet om skrivstil
Primacy-viktning — den viktigaste regeln måste komma först
Förbud mot tankstreck allra sist, en gång
Regel 2 högst upp, upprepad som den sista regeln längst ner
Fångar både primacy- och recency-viktning
Ingen instruktion för ofullständig indata
Regel 4 — protokoll för saknad data med ett exakt svarsformat
Eliminerar hallucination och skapar ett granskningsspår
Ingen instruktion för indataformat
Regel 3 — acceptera vilket format som helst, skriv alltid om från grunden
Hindrar modellen från att bara lätt omformulera en inklistrad anteckning
Modellen behandlade exemplet som indata att svara på
Den enskilt viktigaste lärdomen här: vaga adjektiv är inte instruktioner. Att be en modell vara “naturlig” uppmuntrade aktivt de tankstreck och retoriska utsvävningar som bröt mot husstilen. Att ersätta det med konkreta, testbara regler är det som gjorde stilen konsekvent.
Steg 2: Hantera saknad data istället för att hitta på den
Hallucination beskrivs ofta som ett modellfel. I strukturerat arbete är det oftast ett prompt-fel: prompten talade aldrig om för modellen vad den skulle göra när ett fält saknas, så den gjorde det statistiskt sannolika och producerade ett plausibelt värde.
Lösningen är ett protokoll för saknad data. Dela upp fälten i obligatoriska och valfria. Valfria fält utelämnas tyst när de saknas. Obligatoriska fält gör motsatsen — om ett saknas måste modellen stanna och begära det i ett exakt format istället för att generera en anteckning. Den enda regeln omvandlar en tyst hallucination till en synlig, granskningsbar begäran om mer data. Det är skillnaden mellan en felaktig siffra i ett reglerat ärende och en anteckning som aldrig producerades eftersom indatan var ofullständig.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Steg 3: Lås agentkonfigurationen
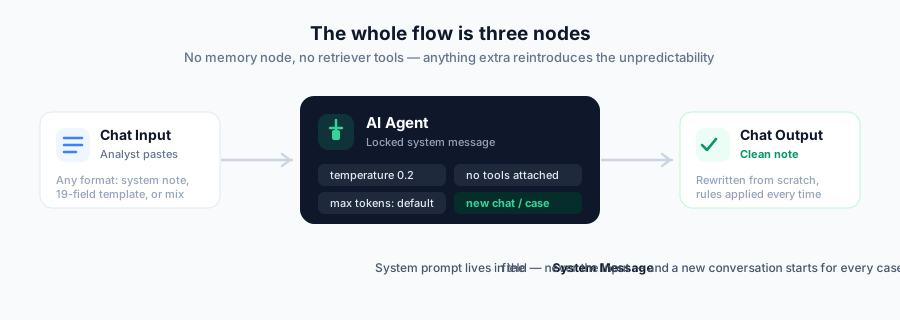
Med en härdad prompt måste själva agenten låsas ner så att inget återinför variabilitet. Hela flödet är medvetet minimalt — tre noder och inget annat.
Konfigurationsvalen som spelade roll:
Systemprompt i fältet System Message, aldrig i inmatningsfältet, så den läses som instruktioner snarare än data.
Temperatur 0,2. Tillräckligt låg för maximal konsekvens, tillräckligt hög för att undvika robotlik prosa. Noll var för rigid; ett var för kreativt.
Inga verktyg kopplade. Fil- och URL-hämtare introducerar oförutsägbarhet och kan kringgå agentens resonemang. För denna uppgift behöver modellen inget annat än prompten och det inklistrade ärendet.
Max tokens kvar på standard. Att begränsa antalet tokens gjorde att anteckningar trunkerades mitt i en mening, och en trunkerad anteckning i ett kundärende är i sig en regulatorisk risk.
En instruktion om tyst start högst upp i prompten, så att agenten inte bekräftar reglerna tillbaka till analytikern när flödet först laddas.
Den operativa regeln som betyder mest
Varje förbättring ovan förstörs av en dålig vana: att återanvända samma chatt. Den viktigaste operativa regeln för analytikerteamet är att starta en ny konversation för varje enskilt ärende. Fortsätt aldrig granska ärenden i samma fönster. Det är regeln som eliminerar session drift — grundorsaken till de flesta av de ursprungliga felen — och den kostar ingenting att följa.
Konsekvens är ett arkitekturproblem, inte ett formuleringsproblem
Om ditt team kämpar med en prompt som driver iväg i ett chattfönster är lösningen en härdad prompt som körs på en tillståndslös agent. Med FlowHunt kan du låsa prompten, fixera modell och temperatur, och köra ett rent anrop per ärende. Låt oss hjälpa dig dit.
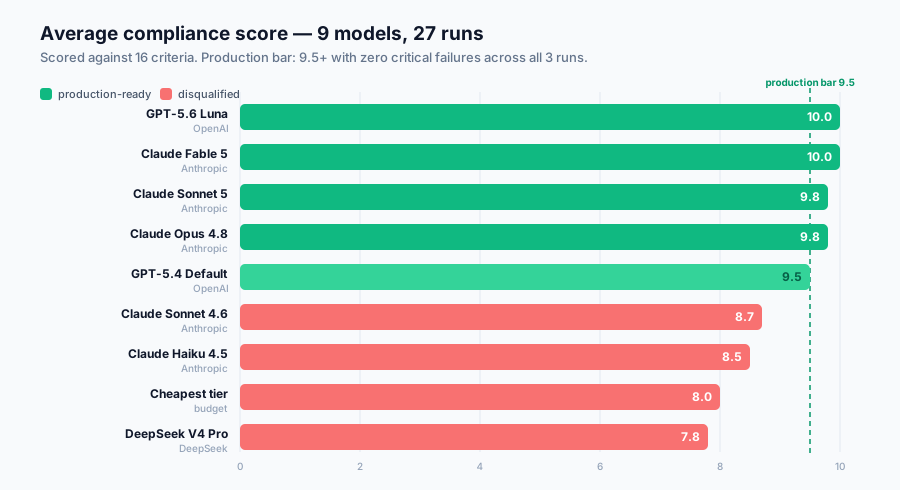
En metod är bara så bra som sina bevis. Vi testade nio modeller mot den härdade prompten, med ett identiskt verkligt ärende (en Gambling Intensity-trigger med tidigare session-duration-historik) över tre körningar vardera — 27 körningar totalt — och bedömde varje körning mot 16 compliance-kriterier.
Över alla 27 körningar hallucinerade ingen produktionsklar modell en siffra, kastade om vinst/förlust-konventionen, använde ett tankstreck eller trunkerade resultatet. Den härdade prompten eliminerade alla de ursprungliga felmönstren hos de modeller som kvalificerade sig. De skillnader som återstod handlade om analytiskt djup och konsekvens, inte korrekthet.
Modell
Leverantör
Snittpoäng
Produktion
Anteckningar
GPT-5.6 Luna
OpenAI
10 / 10
Ja
Perfekt på alla tre körningar; högst konsekvens
Claude Fable 5
Anthropic
10 / 10
Ja
Mest genomtänkta resultatstycken; bästa enskilda anteckning
Claude Sonnet 5
Anthropic
9,8 / 10
Ja
Ingen hallucination på någon körning; bäst allround-Claude
Claude Opus 4.8
Anthropic
9,8 / 10
Ja
Djupast analys; premiumkostnad
GPT-5.4 Default
OpenAI
9,5 / 10
Ja
Ett namngivningsmisstag; bästa budgetalternativet
Claude Sonnet 4.6
Anthropic
8,7 / 10
Nej
Blandade ihop triggertröskeln med insättningsgränsen i 2/3 körningar
Claude Haiku 4.5
Anthropic
8,5 / 10
Nej
Konsekvent men svag motivering av resultatet
Billigaste nivån
Budget
8,0 / 10
Nej
Exakt interventionsnamn i endast 1/3 körningar
DeepSeek V4 Pro
DeepSeek
7,8 / 10
Nej
Trunkerat resultat i körning 1; inkonsekvent
Diskvalificeringarna är lärorika. Claude Sonnet 4.6 producerade vacker prosa men blandade ihop triggertröskeln med insättningsgränsen — en faktiskt felaktig siffra i ett reglerat ärende, vilket diskvalificerar oavsett hur väl det läses. DeepSeeks svängning från körning till körning (6, 8,5, 9) är det verkliga problemet: i reglerat arbete är kvalitet som beror på tur ingen kvalitet alls.
Kostnad är inte begränsningen
Det är frestande att optimera för pris, men siffrorna talar emot det. Även den dyraste produktionsklara modellen, Claude Opus 4.8, kostar ungefär sex cent per anteckning. För ett team som granskar 50 ärenden om dagen är det under 90 dollar i månaden. Kostnaden för en enda regulatorisk anmärkning från en felaktig anteckning skulle med råge överskugga den årliga kostnaden för vilken modell som helst på listan. För reglerad compliance, välj den mest pålitliga modellen du har råd med, inte den billigaste.
Så ser en härdad anteckning ut
Den bästa enskilda anteckningen över alla 27 körningar kom från Claude Fable 5. Lägg märke till vad den gör: den anger positionen enligt korrekt konvention, citerar siffror ordagrant, använder det exakta interventionsnamnet och — avgörande — förklarar varför en eskalering skulle vara oproportionerlig snarare än att bara ange ett resultat.
The customer is currently in a winning position of £1,612.50 with an account balance of £8,962.50, which represents an improvement on the winning position of £1,275.00 recorded at the previous review… Session duration was reviewed under Session Duration Level 1 on 19/07 and again on 20/07… Given that those decisions were made within the last few days, insufficient time has elapsed to assess their effectiveness, and repeating or escalating on the same behaviour at this stage would be disproportionate… In this context, No Further Action Required is the proportionate outcome.
Det är standarden som reglerat arbete kräver: evidensbaserad, proportionerlig, och identisk i kvalitet vid dagens första ärende som vid det femtionde.
Att tillämpa detta på ditt eget reglerade arbetsflöde
RG-anteckningsgeneratorn är ett specifikt fall, men metoden generaliserar till vilken process som helst där en språkmodell måste producera pålitligt, repeterbart resultat på reglerad eller högriskdata:
Flytta bort från chattfönstret. Kör varje ärende som ett tillståndslöst anrop så att kontext inte kan ackumuleras och driva iväg.
Härda prompten för primacy och recency. Sätt kritiska regler först och upprepa dem sist. Lägg till självkontroller.
Ge modellen ett protokoll för saknad data. Obligatoriska fält blockerar generering när de saknas; valfria fält utelämnas tyst. Låt den aldrig gissa.
Lås konfigurationen. Låg, icke-noll temperatur, inga onödiga verktyg, obegränsat resultat, prompt i systemmeddelandet.
Testa innan du litar på det. Kör samma ärende flera gånger över kandidatmodeller och bedöm mot explicita kriterier. Konsekvens över körningar är måttet som räknas.
Gör dessa fem saker och du förvandlar en modell som hallucinerar på eftermiddagen till en som producerar granskningsklart resultat varje gång. Den konsekvens som reglerat arbete kräver är uppnåelig — det är ett arkitektur- och prompt-engineering-problem, och båda går att lösa.
Vanliga frågor
Huvudorsaken är session drift (kontextdrift). I ett långt chattfönster läggs varje ärende du granskar till i kontextfönstret. Vid det femtonde ärendet arbetar modellen utifrån prompten plus den statistiska resten av fjorton tidigare utbyten, och den börjar fylla i dataluckor från träningsminnet istället för från ärendet framför sig. En tillståndslös agent som startar ett nytt anrop per ärende eliminerar detta helt.
Prompt hardening innebär att skriva om en prompt så att dess viktigaste regler hamnar där modellen faktiskt ägnar mest uppmärksamhet — allra först och allra sist — med självkontrollsteg och explicit hantering av saknad eller oväntad indata. Det ersätter vaga stiladjektiv med konkreta regler och separerar obligatoriska fält från valfria, så att modellen utelämnar saknad data istället för att hitta på den.
Eftersom det inte finns någon ackumulerad kontext att driva iväg mot. Varje ärende är ett isolerat anrop som bara ser den låsta systemprompten och det aktuella ärendets data. Prompten får samma uppmärksamhet vid ärende ett som vid ärende femtio, så regelefterlevnaden förblir stabil under hela arbetsdagen istället för att försämras på eftermiddagen.
I tester över 9 modeller och 27 körningar mot 16 compliance-kriterier var fem modeller produktionsklara: GPT-5.6 Luna och Claude Fable 5 fick perfekta 10/10, Claude Sonnet 5 och Claude Opus 4.8 fick 9,8, och GPT-5.4 Default fick 9,5 som budgetalternativ. Rätt val beror på volym, ärendekomplexitet och kostnadstolerans snarare än en enskild vinnare.
En låg men icke-noll temperatur fungerar bäst. I det här projektet gav 0,2 maximal konsekvens utan att resultatet blev robotlikt. En temperatur på 0 tenderar att vara för rigid och 1 för kreativ för reglerat arbete där samma indata måste ge samma anteckning.
Ja, förutsatt att pipelinen är kontrollerad. Anteckningen förblir ett juridiskt dokument som kan granskas av tillsynsmyndigheten, så modellen får aldrig hallucinera en siffra, kasta om en konvention eller trunkera resultatet. En härdad prompt, en tillståndslös agent, en låst modell och ett protokoll för saknad data som stoppar istället för att gissa är det som gör resultatet tillräckligt pålitligt för ett reglerat ärende.
Arshia är en AI-arbetsflödesingenjör på FlowHunt. Med en bakgrund inom datavetenskap och en passion för AI, specialiserar han sig på att skapa effektiva arbetsflöden som integrerar AI-verktyg i vardagliga uppgifter, vilket förbättrar produktivitet och kreativitet.
Arshia Kahani
AI-arbetsflödesingenjör
Ge ditt reglerade arbetsflöde FlowHunts konsekvens
Förvandla en driftande ChatGPT-prompt till en låst, tillståndslös agent som producerar granskningsklara anteckningar varje gång. Vi hjälper dig härda prompten och välja rätt modell.
Förstå och förebygga hallucinationer hos AI-chattbottar
Vad är hallucinationer i AI, varför uppstår de och hur kan du undvika dem? Lär dig hur du håller dina AI-chattbottsvar korrekta med praktiska, människocentrerad...
Jailbreaking av AI-chatbottar: Tekniker, exempel och försvar
Jailbreaking av AI-chatbottar kringgår säkerhetsskydd för att få modellen att bete sig utanför sina avsedda gränser. Lär dig de vanligaste teknikerna — DAN, rol...
AI-chattbotassistent som drivs av OpenAI GPT-4o och automatiskt söker igenom och utnyttjar interna företagsdokument för att besvara användarfrågor. Levererar ko...
3 min läsning
Cookie-samtycke Vi använder cookies för att förbättra din surfupplevelse och analysera vår trafik. See our privacy policy.