


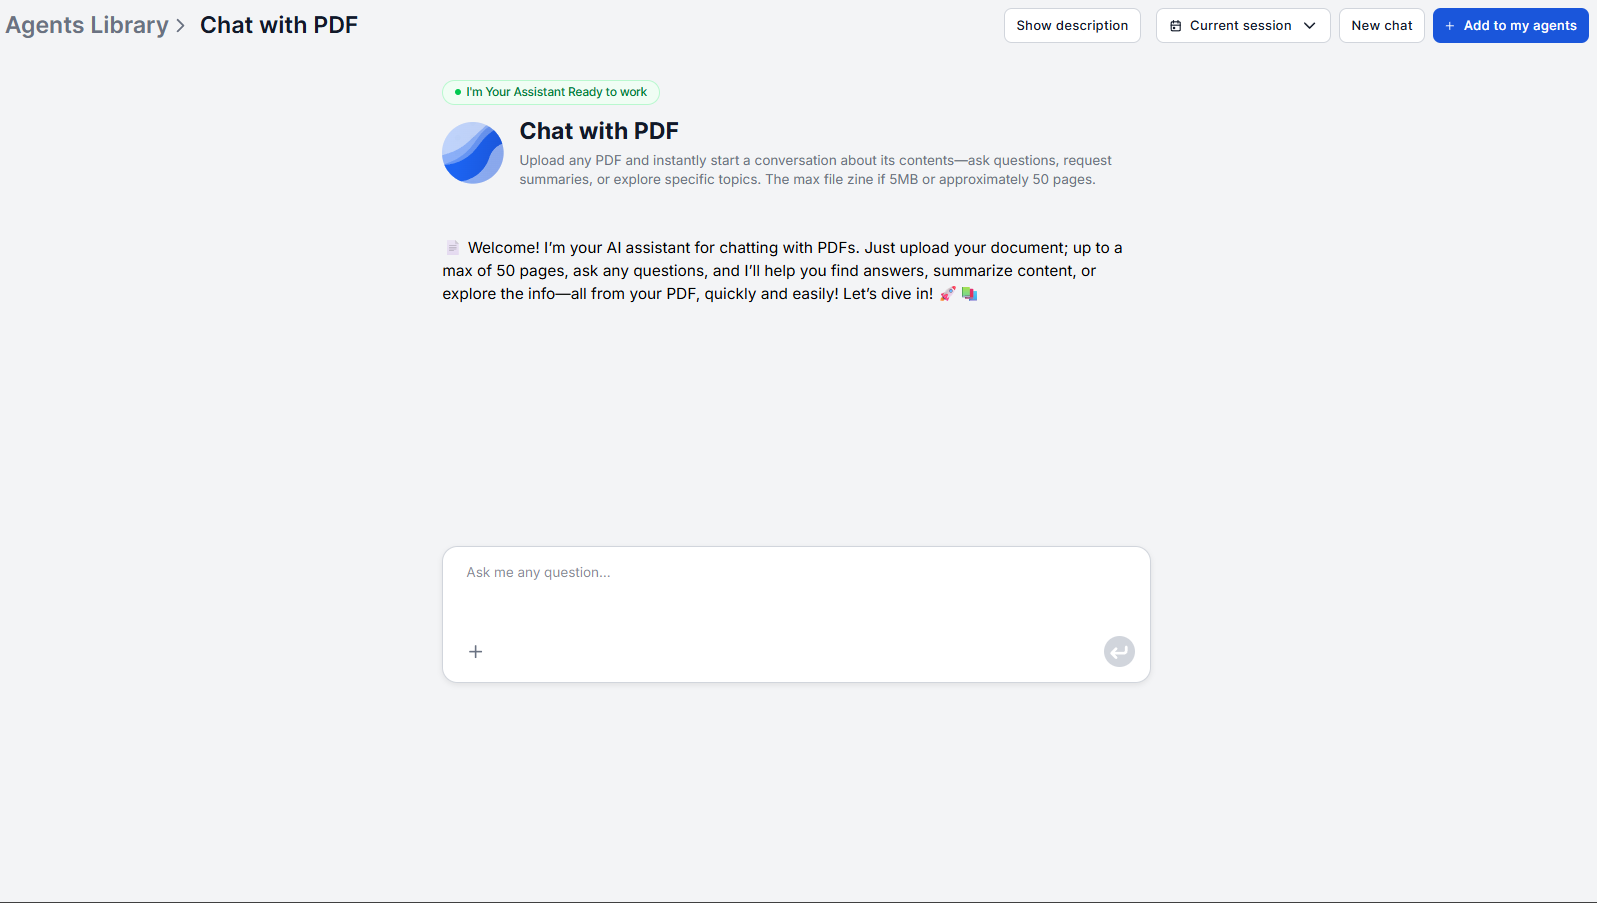
Rechercher manuellement dans un PDF reste gérable pour une note de 10 pages. Au-delà, qu’il s’agisse d’un contrat de 50 pages, d’un rapport trimestriel de résultats ou d’un article de recherche accompagné de 40 pages d’annexes, cela devient un moyen infaillible de perdre tout un après-midi. C’est pourquoi les professionnels de presque tous les domaines à forte intensité de connaissances utilisent désormais l’IA pour discuter avec un PDF et faire remonter immédiatement les sections et les données.
Voici les sept scénarios professionnels où Chat with PDF apporte systématiquement le plus de valeur, et à quoi ressemble chaque flux de travail en pratique.
Cas d’usage 1 : Analyse de contrats juridiques et extraction de clauses
Les documents juridiques sont longs, denses et structurellement non linéaires. Un contrat de service ou un NDA peut définir un terme page 4 et l’appliquer 25 pages plus loin, renvoyer à d’autres sections tout au long du document et contenir des dispositions qui ne deviennent pertinentes que dans des circonstances précises, que vous ne penserez peut-être pas à vérifier avant qu’il ne soit trop tard.
Le chat PDF par IA pour les équipes juridiques signifie qu’il n’est plus nécessaire de lire les documents de bout en bout : il suffit de poser les questions précises qui comptent. Par exemple, vous pouvez vous renseigner sur les conditions de résiliation, sur la définition de ‘confidential information’ retenue par le document, ou sur l’existence de clauses de renouvellement automatique.
L’IA récupère le libellé exact du document plutôt que de le paraphraser, ce qui est essentiel dans un contexte où la formulation détermine le sens. L’historique de la conversation vous permet d’enchaîner les questions (“De quelle section cela provient-il ?” ou “Y a-t-il des exceptions à cette clause ?”) sans réexpliquer votre demande.
Pour un flux de travail complet de révision juridique, étape par étape — y compris la révision d’un NDA en moins de 10 minutes et une checklist pour contrat fournisseur — voir Comment les avocats révisent les contrats 5 fois plus vite avec l’IA .
Cas d’usage 2 : Revue de la littérature académique
Les revues de littérature impliquent de lire de nombreux articles pour n’en extraire qu’une petite quantité d’informations précises. Lire 30 articles de la première à la dernière page pour identifier leur méthodologie, la taille de leur échantillon et leurs principaux résultats est une pratique courante, mais l’essentiel de ce temps de lecture ne produit rien d’exploitable.
L’approche du chat IA avec document change l’équation économique. Vous importez un article, vous demandez ce dont vous avez besoin, et vous passez à la suite. Parmi les requêtes utiles :
- “Quelle était la taille de l’échantillon et la source des données ?”
- “Quelles étaient les principales conclusions ?”
- “Quelles limites les auteurs ont-ils identifiées ?”
- “Cette étude reproduit-elle ou contredit-elle des résultats antérieurs sur ce sujet ?”
- “Quelles recherches futures les auteurs ont-ils recommandées ?”
Le retriever renvoie le passage exact plutôt qu’un résumé généré, ce qui est utile lorsque vous devez vérifier des affirmations ou citer des résultats avec précision sans déformer ce que disait l’article.
Pour une synthèse thématique plus large à partir de plusieurs sources, l’assistant de recherche IA construit des documents de recherche structurés avec des bibliographies annotées.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Cas d’usage 3 : Analyse de rapports financiers
Les publications de résultats, les rapports annuels et les documents réglementaires sont conçus pour être exhaustifs, pas pour être lisibles. Les chiffres clés sont répartis sur plusieurs sections, et les notes de bas de page contiennent souvent les ajustements qui changent la manière d’interpréter les chiffres affichés.
Les outils d’analyse PDF destinés aux professionnels de la finance se concentrent sur :
- L’extraction rapide d’indicateurs précis (“Quelle était la marge opérationnelle au T3 ?”)
- La recherche de ventilations par segment ou par région (“Comment le segment Asie-Pacifique s’est-il comporté ?”)
- La mise en évidence des notes de bas de page et des ajustements comptables (“L’EBITDA est-il ajusté, et qu’est-ce qui est exclu ?”)
- La comparaison des commentaires du management avec les chiffres publiés (“Quelle croissance le management prévoyait-il pour cette période ?”)
L’assistant récupère le texte exact, pas un résumé régénéré, de sorte que les chiffres et le libellé des notes de bas de page ressortent exactement tels qu’ils sont énoncés dans le document, ce qui compte lorsque vous construisez des modèles ou préparez une analyse pour des parties prenantes.
Pour extraire à grande échelle des données financières structurées à partir de factures et de documents financiers, l’extracteur de données de factures gère l’extraction automatisée par OCR sur de gros volumes de factures.
Cas d’usage 4 : Analyse d’appels d’offres et de dossiers de candidature
Les appels d’offres et les dossiers de candidature sont longs par conception : périmètre, exigences, critères d’évaluation, formats de soumission, conditions juridiques et délais s’étalent sur des dizaines de pages. Manquer une exigence obligatoire peut entraîner la disqualification.
L’assistant documentaire IA peut vous aider à qualifier votre candidature avant la soumission :
- “Quelles sont les exigences de soumission obligatoires ?”
- “Quels critères d’évaluation cet appel d’offres précise-t-il, et comment sont-ils pondérés ?”
- “Existe-t-il des clauses de conflit d’intérêts ?”
- “Quel est le montant maximal du contrat ?”
- “Quelle est la date limite de soumission et quel format est accepté ?”
Traiter un appel d’offres de façon conversationnelle est plus rapide et plus fiable qu’une lecture linéaire pour faire remonter les dix exigences enfouies dans un document de 60 pages. Une fois la liste complète des exigences connue, vous pouvez choisir de relire intégralement les sections concernées, mais vous savez déjà si répondre vaut l’investissement.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Cas d’usage 5 : Analyse d’articles de recherche médicale
Les chercheurs cliniques, les pharmaciens et les professionnels de santé doivent régulièrement extraire des résultats précis d’articles dont la méthodologie complète est dense et pas toujours pertinente pour la question immédiate. Lire une étude clinique entière pour trouver le profil des événements indésirables ou les critères d’inclusion est courant, mais inefficace.
Requêtes typiques pour ce cas d’usage :
- “Quel était le critère de jugement principal et comment a-t-il été mesuré ?”
- “Quels événements indésirables ont été rapportés et à quelle fréquence ?”
- “Quels étaient les critères d’inclusion et d’exclusion des participants ?”
- “Quel seuil de signification statistique a été utilisé ?”
- “Comment cette étude se compare-t-elle aux essais précédents cités dans l’introduction ?”
Le retriever renvoie le texte exact de l’article, de sorte que les résultats sont rapportés précisément tels que les auteurs les ont formulés. C’est important lorsque l’exactitude de l’affirmation d’origine compte à des fins cliniques ou réglementaires.
Cas d’usage 6 : Dépannage à partir de manuels techniques
Les manuels techniques, la documentation d’API et les spécifications produit sont des documents de référence. Ils sont rarement lus de façon linéaire et sont conçus pour répondre à des questions précises. Mais “question précise + recherche manuelle” signifie tout de même naviguer dans une table des matières, parcourir des sections et suivre des renvois, ce qui finit par s’accumuler.
Les IA de chat avec document rendent les documents de référence techniques conversationnels :
- “Que signifie le code d’erreur E204 ?”
- “Quelles sont les exigences de configuration de l’interface réseau ?”
- “Quel est le couple de serrage recommandé pour les boulons de fixation ?”
- “Quelle section couvre la procédure de mise à jour du firmware ?”
- “Quelles sont les précautions de sécurité pour les composants haute tension ?”
L’assistant récupère directement le passage pertinent, ce qui supprime la surcharge de navigation. Pour les équipes techniques qui maintiennent des équipements complexes ou intègrent des API, cela transforme le flux de travail : on passe de “trouver la section et la lire” à “demander, obtenir la réponse, agir”.
Cas d’usage 7 : Audit de documents de conformité
Les référentiels de conformité, comme les normes ISO, les lignes directrices réglementaires ou les politiques internes, sont de longs documents où la réponse à “sommes-nous conformes ?” dépend d’abord de la localisation de l’exigence précise, puis de sa comparaison avec la pratique actuelle. La première étape à elle seule peut prendre beaucoup de temps dans une norme dense.
Vous pouvez plutôt demander à un assistant documentaire IA :
- “Que exige cette politique en matière de délais de réponse aux incidents ?”
- “Existe-t-il des exigences spécifiques de conservation des enregistrements dans cette réglementation ?”
- “Quels contrôles d’accès cette norme impose-t-elle ?”
- “Où ce document traite-t-il des exigences relatives aux fournisseurs tiers ?”
- “Quelles sont les obligations d’audit et de reporting au titre de ce référentiel ?”
Parcourir une checklist de conformité de façon conversationnelle est plus rapide que lire chaque section pour localiser la disposition pertinente.
Comment formuler de meilleures requêtes pour des réponses plus précises
Le retriever fonctionne avec ce que vous lui demandez, mais la précision de la requête influence directement la qualité du résultat. Quelques schémas améliorent systématiquement les réponses :
Soyez précis sur ce que vous voulez. “Parlez-moi du contrat” produit une réponse générale. “Quelles sont les dispositions de résiliation à la section 9 ?” donne au retriever une cible précise.
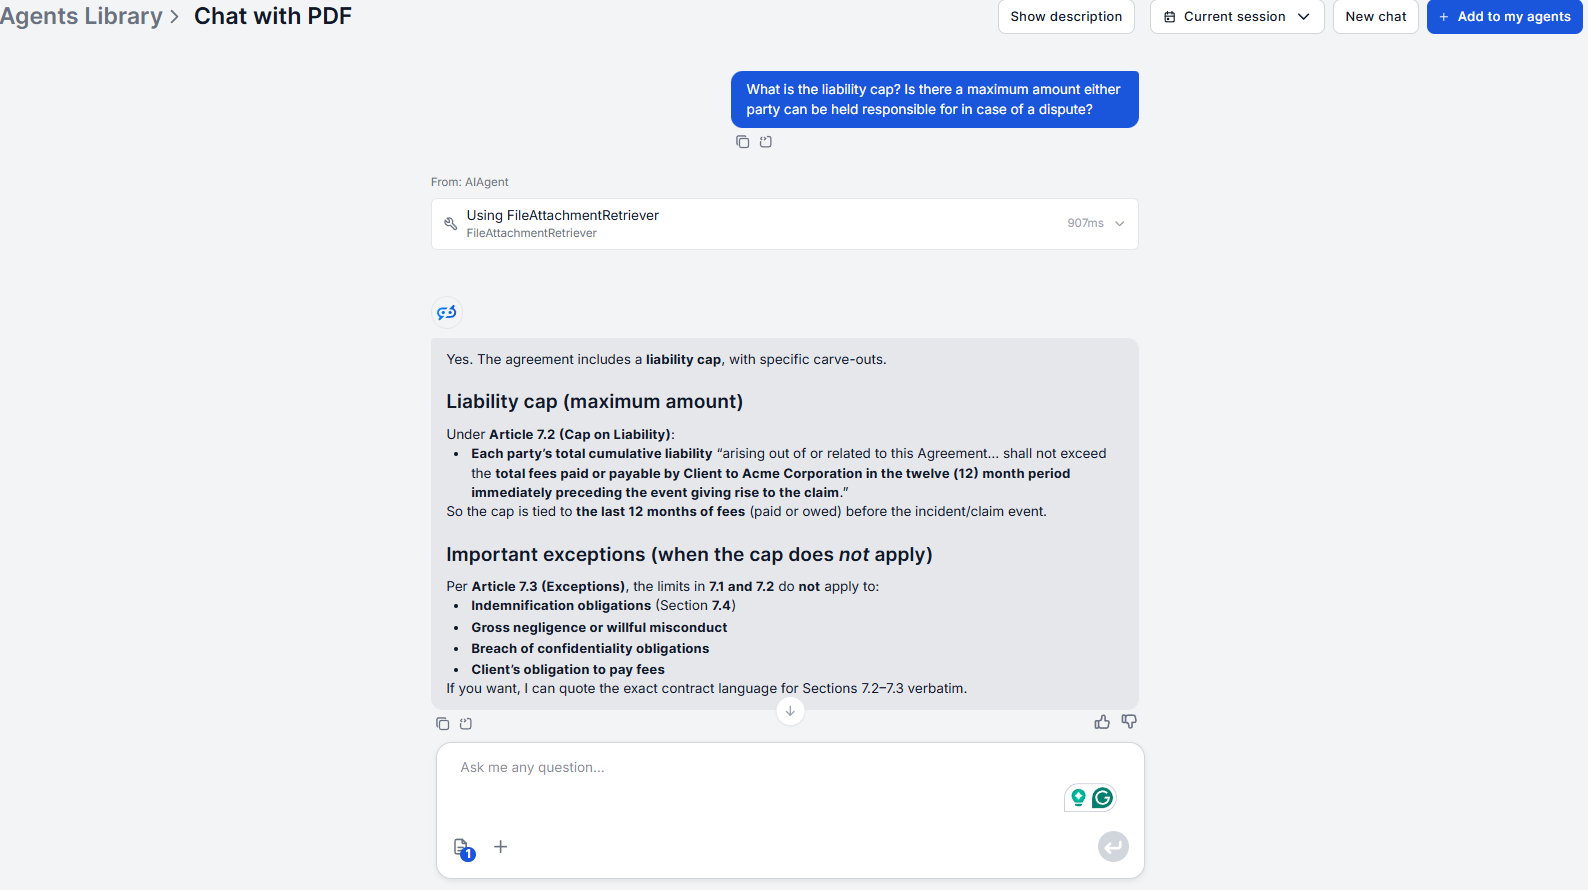
Citez les numéros de section lorsque vous les connaissez. “Que dit la section 4.2 ?” est plus ciblé que “Que dit ce document à propos de la responsabilité ?”
Utilisez des questions de suivi plutôt que de repartir de zéro. L’assistant conserve l’intégralité de l’historique de la conversation pendant la session. “Quelles sont les exceptions à cette clause ?” vaut mieux que réexpliquer tout le contexte dans une nouvelle requête.
Laissez fonctionner la demande de clarification. Si votre question est ambiguë, l’assistant pose une question plutôt que de deviner.
Demandez explicitement des résumés quand vous en avez besoin. “Résume la section 5” ou “Quels sont les points clés de la méthodologie ?” produit des résumés issus du contenu réel, et non générés indépendamment. Les demandes de résumé explicites sont plus fiables que les questions générales du type “vue d’ensemble”.
Dans les sept cas d’usage, le facteur commun est le même : une question ciblée produit une réponse ciblée. Plus la requête est spécifique, moins il y a de bruit de récupération, et plus la réponse est directement utile.
L’outil est également transparent sur ce qu’il ne trouve pas. Si un document ne contient pas ce que vous cherchez, l’assistant le dit plutôt que d’inventer une réponse : c’est ce comportement qui le rend fiable pour un usage professionnel, et pas seulement pratique.
Pour un guide de configuration complet et des schémas de requêtes qui fonctionnent pour tous ces cas d’usage, consultez le tutoriel Chat with PDF .
