


Chat with PDF vous permet de téléverser n’importe quel PDF textuel et de poser des questions à son sujet en langage naturel. Au lieu de le lire de bout en bout, vous obtenez des réponses précises tirées directement du document, avec tout le contexte de la conversation conservé pour que les questions de suivi fonctionnent naturellement.
Ce guide vous accompagne dans la configuration complète, du téléversement à la sortie, y compris les schémas de requêtes qui donnent systématiquement les meilleurs résultats, les erreurs que la plupart des utilisateurs commettent au début, et les ajustements que vous pouvez faire pour tirer le meilleur parti de vos workflows.
Étape 1 : téléversez votre PDF
Ouvrez Chat with PDF et téléversez votre document via l’interface de téléversement de fichiers. L’outil fonctionne avec tout PDF textuel, ainsi qu’avec d’autres formats de texte.
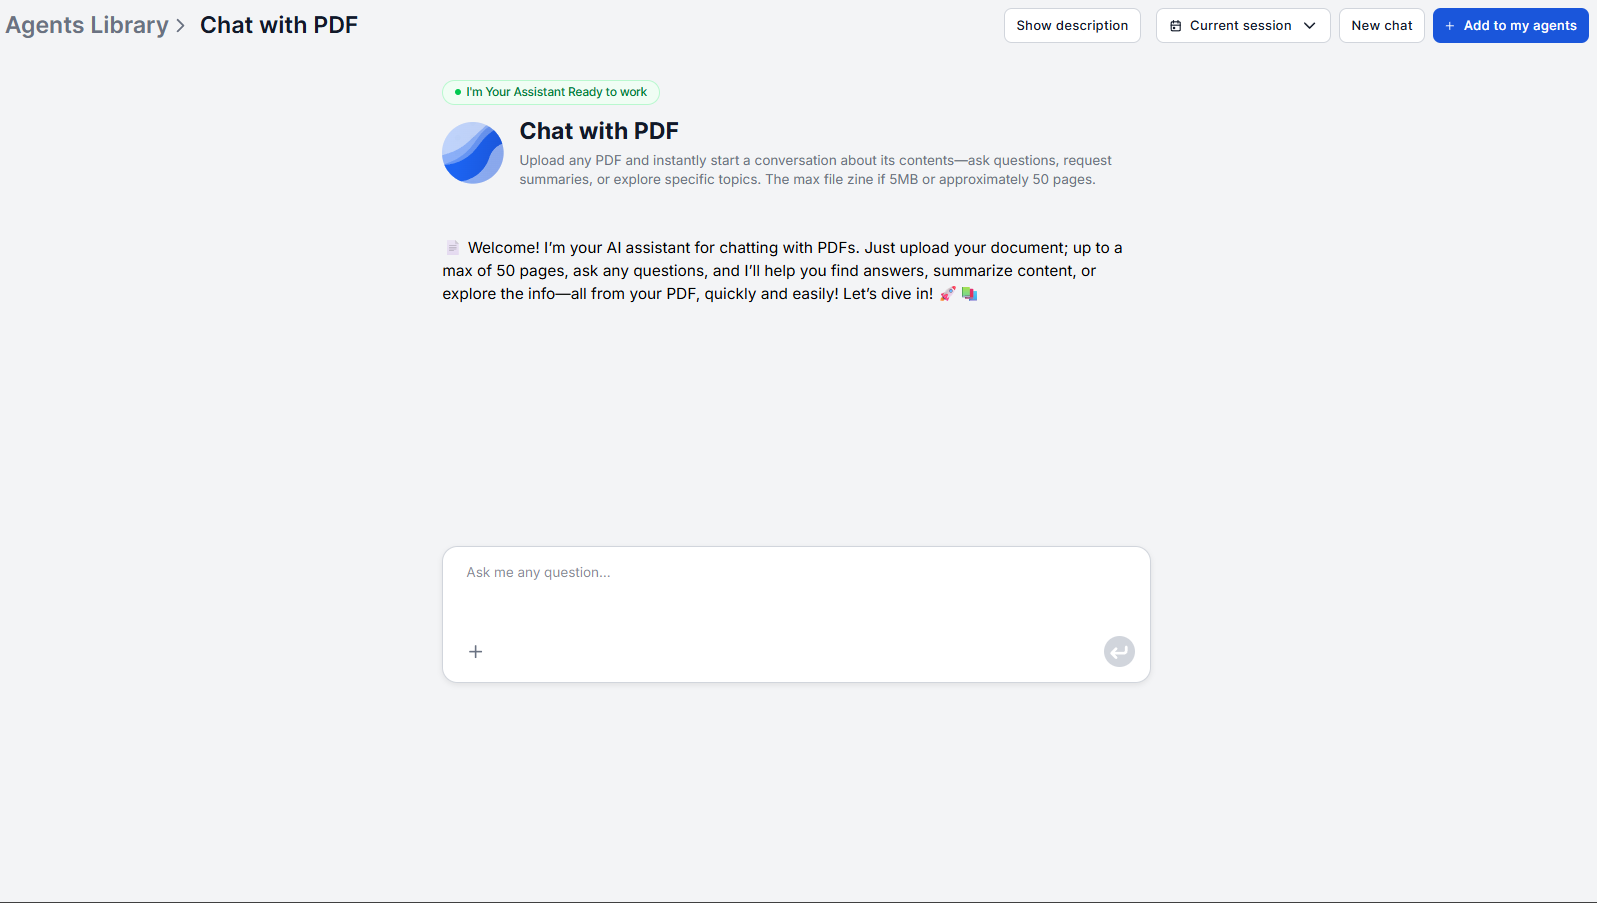
Une contrainte importante : l’outil extrait le texte directement du document, il ne fonctionne donc qu’avec des PDF dont le texte est sélectionnable. Les PDF scannés, qui sont des images de pages plutôt que des documents contenant du texte intégré, ne produiront aucun résultat. Vous pouvez toutefois activer le traitement OCR dans votre flow pour permettre à FlowHunt de les lire également.
Une fois le fichier téléversé, la session est prête. Il n’y a aucune étape de configuration, aucun étiquetage de document, et nul besoin de pré-lire le document avant de poser votre première question.
Étape 2 : comment rédiger des requêtes qui obtiennent des réponses précises
Avant de poser votre première question, il est utile de comprendre ce qui se passe lorsque vous soumettez une requête. L’assistant ne résume pas tout le document pour répondre à partir de ce résumé. Il effectue à la place une passe de récupération dans le fichier, en recherchant les passages les plus pertinents pour votre requête spécifique.
Cela signifie que la précision de votre réponse est directement liée à la précision de votre question. Deux principes en découlent :
Soyez précis, pas général. « Que dit ce contrat à propos des plafonds de responsabilité ? » récupère les sections sur la responsabilité. « Parlez-moi du contrat » demande au moteur de recherche de tout chercher, ce qui produit une réponse générique de haut niveau plutôt que le libellé de la clause dont vous avez besoin.
Référencez par leur nom les éléments que vous recherchez. Les titres de sections, les types de clauses, les termes définis et les mots-clés thématiques donnent tous au moteur de recherche une cible précise. « Quelle est la définition des “informations confidentielles” dans ce document ? » est plus ciblé que « Quelles sont les définitions ? »
Les réponses reposent uniquement sur le contenu du PDF téléversé. L’assistant n’intègre pas d’informations extérieures, ce qui signifie que la réponse reflète exactement ce que dit votre document, et non ce que contient habituellement une version standard de ce document.

Prêt à développer votre entreprise?
Commencez votre essai gratuit aujourd'hui et voyez les résultats en quelques jours.
Étape 3 : posez vos premières questions
Une fois le document téléversé, commencez par des questions qui cartographient la structure du document avant d’entrer dans les détails. Pour la plupart des types de documents, une séquence d’ouverture utile ressemble à ceci :
Pour les contrats : « Quelles sont les principales obligations de chaque partie au titre de cet accord ? » Cela vous donne la carte structurelle avant de poser des questions sur des clauses précises.
Pour les rapports : « Que couvre ce document, et quelles sont ses principales sections ? » Puis : « Quels ont été les principaux constats ou conclusions ? »
Pour les articles de recherche : « Quelle était la question de recherche et la méthodologie ? » Puis : « Quels ont été les principaux résultats ? »
Pour les documents techniques : « Que couvre ce manuel, et à quels systèmes ou composants s’applique-t-il ? »
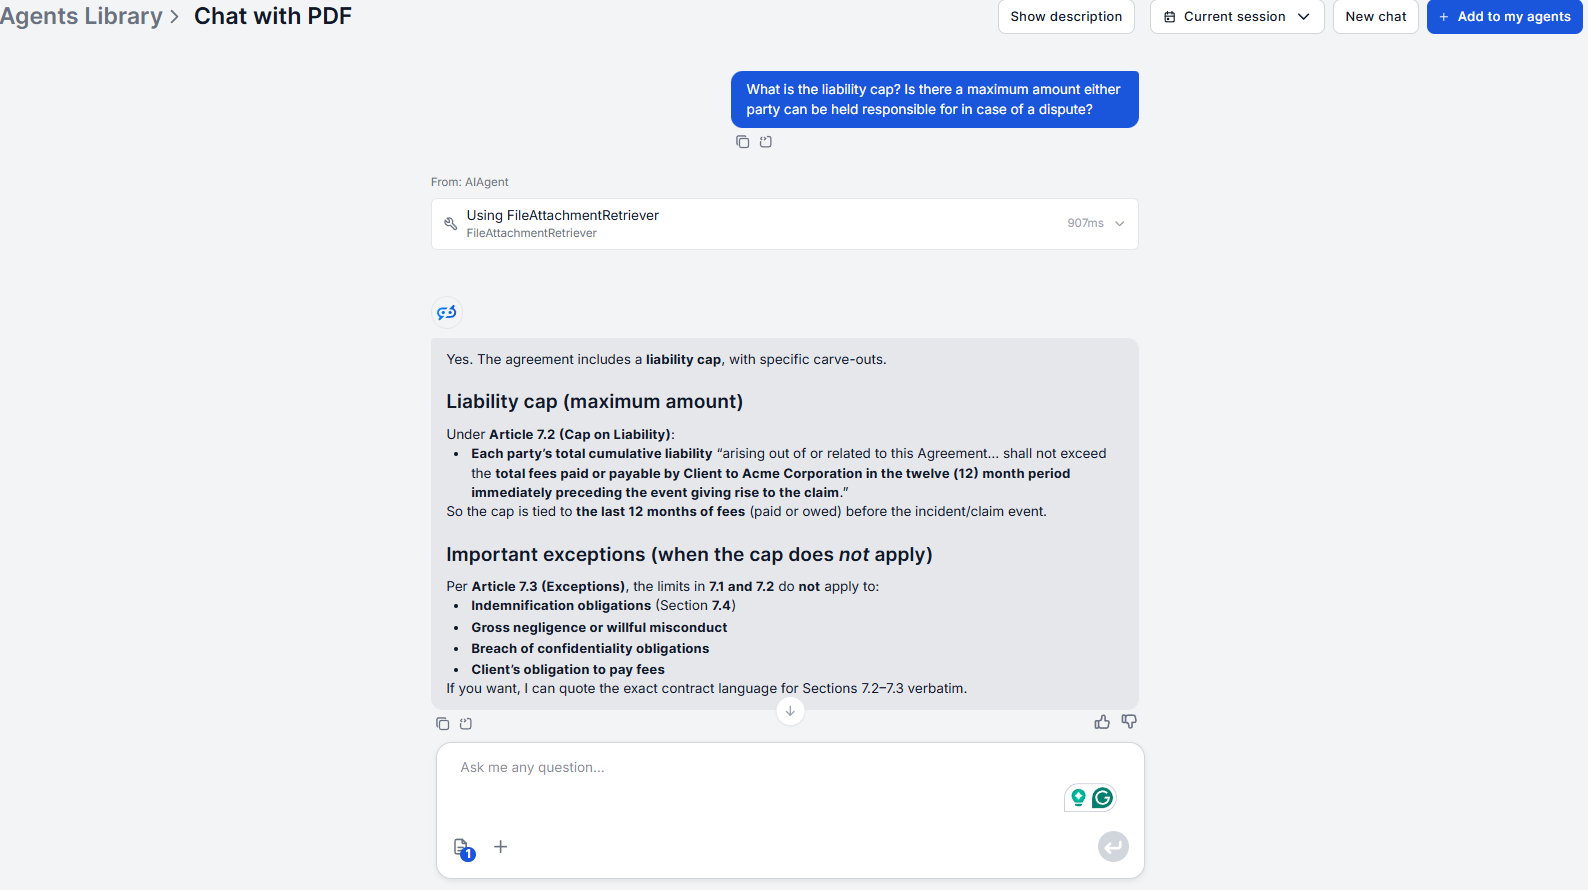
Après les questions d’orientation initiales, passez aux détails. Comme l’assistant conserve tout l’historique de la conversation pendant la session, chaque question de suivi s’appuie sur l’échange précédent. Vous n’avez pas besoin de réexpliquer le contexte. « Quelles sont les exceptions à cette clause ? » fonctionne correctement, car l’assistant sait de quelle clause vous venez de parler.
Si une question est ambiguë — par exemple si vous demandez « la tarification » dans un document qui contient trois sections de tarification distinctes — l’assistant pose une question de clarification plutôt que de deviner. Il suffit de répondre à la demande de clarification.
Étape 4 : vérifiez les réponses par rapport au document
L’assistant fournit des réponses accompagnées des extraits pertinents et du contexte du document lorsque cela aide à la compréhension. Utilisez ces extraits pour vérifier la réponse par rapport au fichier d’origine.
Pour toute réponse qui servira à fonder une décision — une clause de contrat sur laquelle vous vous appuyez, un chiffre que vous incluez dans un rapport, une spécification technique sur laquelle vous agissez —, recoupez directement l’extrait retourné avec la section correspondante du PDF. L’extrait vous indique quelle section vérifier. Le recoupement prend quelques secondes et vous apporte une tranquillité d’esprit totale.
Cette étape est importante, car l’outil est précis pour les PDF bien formatés et clairement rédigés, et fidèle à ce que dit le document. La norme professionnelle consiste à vérifier les affirmations issues de sources primaires avant d’agir sur leur base, quelle que soit la qualité de la récupération.
Rejoignez notre newsletter
Recevez gratuitement les derniers conseils, tendances et offres.
Étape 5 : exportez et utilisez vos résultats
Les réponses apparaissent dans l’interface de chat. Copiez les réponses depuis la conversation pour les coller dans des documents externes, des notes clients, des versions annotées ou des rapports. Si vous avez besoin d’une sortie structurée ou d’un résumé mis en forme, le flow sous-jacent peut être modifié dans FlowHunt pour adapter le format de réponse à votre processus documentaire.
Pour les équipes qui extraient régulièrement le même type d’informations dans de nombreux documents — par exemple une équipe juridique qui applique la même liste de clauses à chaque contrat entrant —, configurer le flow pour renvoyer une sortie structurée plutôt que des réponses conversationnelles réduit considérablement le travail de mise en forme en aval.
Pour les workflows multi-documents, les sources de connaissances vous permettent de téléverser plusieurs documents dans une base de connaissances IA et de les interroger tous dans une seule session.
Les schémas de requêtes les plus efficaces (avec exemples)
D’après le fonctionnement du système de récupération (recherche des passages pertinents avant chaque réponse), ces structures de requêtes donnent systématiquement de meilleurs résultats :
Récupération ciblée de clause : « Que dit la section [numéro ou nom] à propos de [sujet] ? » Exemple : « Que dit la section 12 à propos du droit applicable ? »
Recherche de définition : « Comment ce document définit-il le terme ? » Exemple : « Comment ce document définit-il “manquement substantiel” ? »
Questions de portée : « Quelles sont toutes les conditions dans lesquelles X peut se produire ? » Exemple : « Quelles sont toutes les conditions dans lesquelles l’une ou l’autre partie peut résilier cet accord ? »
Comparaison au sein du document : « Ce document traite-t-il le concept A différemment selon les sections ? » Exemple : « Ce contrat applique-t-il des délais de préavis différents selon les contextes ? »
Résumé d’une section précise : « Résume la section [nom ou numéro] en langage clair. » L’assistant résume à partir du contenu réel de la section plutôt que de générer indépendamment.
Suivi explicite : « Quelles sont les exceptions à ce que vous venez de décrire ? » ou « Le document traite-t-il de ce qui se passe si cette condition n’est pas remplie ? »
Erreurs fréquentes et comment les corriger
Téléverser un PDF scanné sans texte intégré. Le moteur de recherche n’a rien à explorer. Faites d’abord passer le document par notre outil OCR .
Poser d’emblée des questions trop générales. « Dites-moi tout ce qui est important dans ce contrat » demande au moteur de recherche de hiérarchiser sans indication suffisante. Commencez par des questions structurelles, puis allez vers le détail.
Ignorer la demande de clarification. Quand l’assistant demande une clarification, cela signifie que votre question correspondait à plusieurs sections. Répondre à la demande oriente la récupération vers la bonne partie du document.
Considérer une longue réponse comme une couverture complète. L’outil récupère les passages les plus pertinents pour votre requête. Il ne garantit pas avoir trouvé chaque occurrence d’un sujet dans tout le document. Si l’exhaustivité compte, posez la question de suivi : « Y a-t-il d’autres sections de ce document qui traitent de [sujet] ? »
Ouvrir une nouvelle session alors qu’une question de suivi suffirait. Utilisez l’historique de la conversation. Retéléverser le même document et reposer des questions qui s’appuient sur des réponses précédentes gaspille un contexte que la session conserve déjà.
Pour des présentations de cas d’usage professionnels — révision de contrats juridiques, analyse financière, documents d’appels d’offres, et plus encore —, consultez Chat with PDF : 7 cas d’usage professionnels . Si vous évaluez quel outil correspond à votre workflow, la comparaison des outils de chat avec PDF met FlowHunt, ChatPDF, Adobe et Humata face à face.