


Een pdf handmatig doorzoeken is te doen voor een brief van 10 pagina’s. Voor alles wat langer is, zoals een contract van 50 pagina’s, een kwartaalcijferrapport of een onderzoekspaper met 40 pagina’s bijlagen, wordt het een betrouwbare manier om een middag te verliezen. Daarom gebruiken professionals in vrijwel elk kennisintensief vakgebied nu AI om met pdf’s te chatten en komen secties en data direct naar boven.
Hieronder staan de zeven professionele scenario’s waarin Chat with PDF consistent de meeste waarde oplevert, en hoe elke workflow er in de praktijk uitziet.
Use case 1: Juridische contractrevisie en clausule-extractie
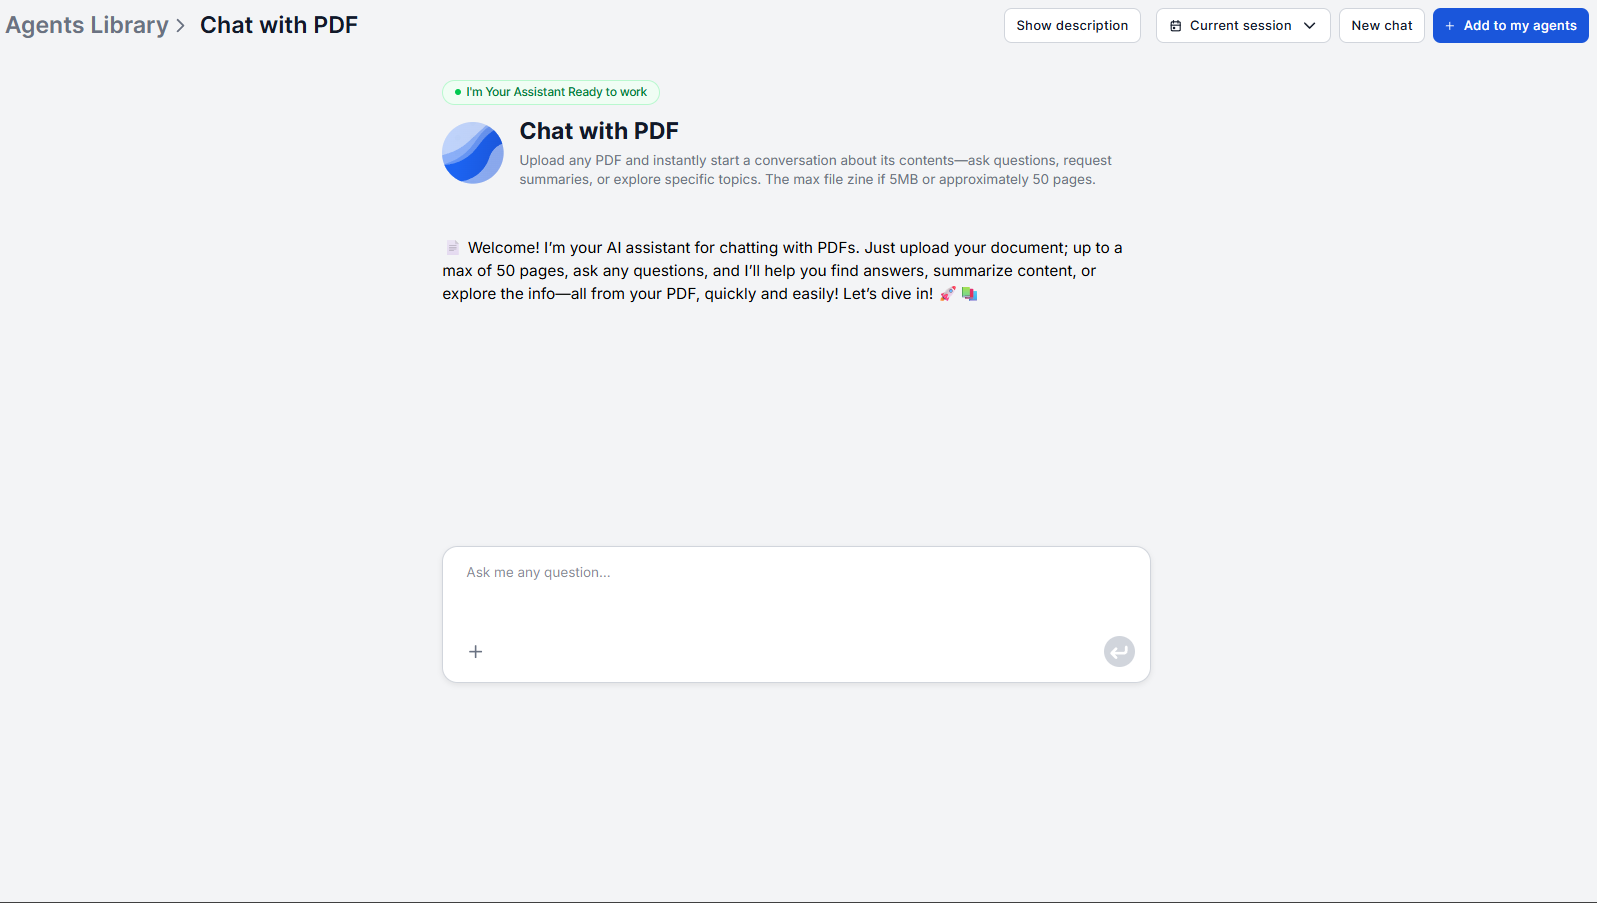
Juridische documenten zijn lang, dicht en structureel niet-lineair. Een dienstverleningsovereenkomst of NDA definieert een term misschien op pagina 4 en past die 25 pagina’s later toe, verwijst door het hele document naar andere secties en bevat bepalingen die alleen onder specifieke omstandigheden relevant worden — waarvan je misschien niet weet dat je erop moet controleren tot het te laat is.
AI-pdfchat voor juridische teams betekent dat je documenten niet van begin tot eind hoeft te lezen; je hoeft alleen de specifieke vragen te stellen die ertoe doen. Je kunt bijvoorbeeld vragen naar de beëindigingsvoorwaarden, de definitie van ‘vertrouwelijke informatie’ in het document, of er clausules voor automatische verlenging zijn.
De AI haalt de exacte bewoording uit het document op in plaats van die te parafraseren, wat cruciaal is in een context waarin de formulering de betekenis bepaalt. De gespreksgeschiedenis betekent dat je kunt doorvragen (“Uit welke sectie komt dat?” of “Zijn er uitzonderingen op die clausule?”) zonder de vraag opnieuw te hoeven uitleggen.
Voor een complete stapsgewijze juridische reviewworkflow — inclusief NDA-beoordeling in minder dan 10 minuten en een checklist voor leveranciersovereenkomsten — zie Hoe advocaten contracten 5x sneller beoordelen met AI .
Use case 2: Academisch literatuuronderzoek
Literatuuronderzoek betekent veel papers lezen om uit elk daarvan een kleine hoeveelheid specifieke informatie te halen. Dertig papers van kaft tot kaft lezen om hun methodologie, steekproefgrootte en belangrijkste bevindingen te vinden is standaardpraktijk, maar het grootste deel van die leestijd levert niets bruikbaars op.
De aanpak van AI-chatten met documenten verandert de rekensom. Je uploadt gewoon een paper, vraagt wat je nodig hebt en gaat verder. Nuttige vragen zijn:
- “Wat was de steekproefgrootte en de databron?”
- “Wat waren de belangrijkste conclusies?”
- “Welke beperkingen noemden de auteurs?”
- “Bevestigde of weersprak deze studie eerdere bevindingen over dit onderwerp?”
- “Welk vervolgonderzoek bevalen de auteurs aan?”
De retriever geeft de exacte passage terug in plaats van een gegenereerde samenvatting, wat helpt wanneer je claims wilt verifiëren of bevindingen nauwkeurig wilt citeren zonder de paper verkeerd weer te geven.
Voor bredere topicsynthese over meerdere bronnen bouwt de AI-onderzoeksassistent gestructureerde onderzoeksdocumenten met geannoteerde bibliografieën.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
Use case 3: Analyse van financiële rapporten
Kwartaalberichten, jaarverslagen en wettelijke deponeringen zijn gemaakt op volledigheid, niet op leesbaarheid. Kerncijfers staan verspreid over meerdere secties, en voetnoten bevatten vaak de aanpassingen die bepalen hoe de kopcijfers moeten worden geïnterpreteerd.
Pdf-analysetools voor professionals in finance richten zich op:
- Snel specifieke cijfers extraheren (“Wat was de operationele marge in Q3?”)
- Segment- of regionale uitsplitsingen vinden (“Hoe presteerde het segment Azië-Pacific?”)
- Voetnoten en boekhoudkundige aanpassingen naar boven halen (“Is de EBITDA aangepast, en wat is uitgesloten?”)
- De toelichting van het management toetsen aan de gerapporteerde cijfers (“Welke groei voorzag het management voor deze periode?”)
De assistent haalt de precieze tekst op, geen opnieuw gegenereerde samenvatting, zodat cijfers en de formulering van voetnoten precies zo naar buiten komen als in het document staan. Dat is belangrijk wanneer je modellen bouwt of analyses voor stakeholders voorbereidt.
Voor het op schaal extraheren van gestructureerde financiële data uit facturen en financiële documenten verwerkt de factuurdata-extractor geautomatiseerde OCR-extractie uit grote hoeveelheden facturen.
Use case 4: Beoordeling van RFP- en aanbestedingsdocumenten
RFP’s en aanbestedingsdocumenten zijn bewust lang: ze behandelen scope, eisen, beoordelingscriteria, indieningsformats, juridische voorwaarden en tijdlijnen over tientallen pagina’s. Een verplichte eis missen kan uitsluiting betekenen.
De AI-documentassistent kan helpen bij de kwalificatie vóór indiening:
- “Wat zijn de verplichte indieningseisen?”
- “Welke beoordelingscriteria specificeert deze RFP, en hoe zwaar wegen ze?”
- “Zijn er bepalingen over belangenverstrengeling?”
- “Wat is de maximale contractwaarde?”
- “Wat is de uiterste indieningsdatum en welk formaat wordt geaccepteerd?”
Een RFP in gespreksvorm doorwerken is sneller en betrouwbaarder dan lineair lezen om de tien eisen te vinden die in een document van 60 pagina’s begraven zitten. Zodra je de volledige eisenlijst kent, kun je ervoor kiezen de relevante secties volledig opnieuw te lezen, maar je hebt dan al bepaald of reageren de investering waard is.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Use case 5: Analyse van medisch onderzoeksmateriaal
Klinisch onderzoekers, apothekers en zorgprofessionals moeten regelmatig specifieke bevindingen uit papers halen waarvan de volledige methodologie dicht en niet altijd relevant voor de directe vraag is. Een hele klinische studie lezen om het bijwerkingenprofiel of de inclusiecriteria te vinden komt veel voor, maar is inefficiënt.
Typische vragen voor deze use case:
- “Wat was het primaire eindpunt en hoe werd het gemeten?”
- “Welke bijwerkingen werden gemeld en met welke frequentie?”
- “Wat waren de inclusie- en exclusiecriteria voor deelnemers?”
- “Welke statistische significantiedrempel werd gebruikt?”
- “Hoe verhoudt deze studie zich tot de eerdere trials die in de inleiding worden aangehaald?”
De retriever geeft de exacte tekst uit de paper terug, zodat bevindingen precies worden weergegeven zoals de auteurs ze formuleerden. Dat is belangrijk wanneer de nauwkeurigheid van de oorspronkelijke claim van belang is voor klinische of regelgevende doeleinden.
Use case 6: Probleemoplossing met technische handleidingen
Technische handleidingen, API-documentatie en productspecificaties zijn naslagwerken. Ze worden zelden lineair gelezen en zijn ontworpen om specifieke vragen te beantwoorden. Maar “specifieke vraag + zoeken in de handleiding” betekent nog steeds navigeren door een inhoudsopgave, secties scannen en kruisverwijzingen volgen, en dat telt op.
AI’s voor chatten met documenten maken van technische naslagwerken een gesprek:
- “Wat betekent foutcode E204?”
- “Wat zijn de configuratie-eisen voor de netwerkinterface?”
- “Wat is het aanbevolen aanhaalmoment voor de bevestigingsbouten?”
- “Welke sectie behandelt de firmware-updateprocedure?”
- “Wat zijn de veiligheidsmaatregelen voor hoogspanningscomponenten?”
De assistent haalt de relevante passage direct op, waardoor de navigatieoverhead verdwijnt. Voor technische teams die complexe apparatuur onderhouden of API’s integreren, verandert dit de workflow van ‘zoek de sectie en lees die’ naar ‘vraag, krijg het antwoord, handel’.
Use case 7: Auditen van compliancedocumenten
Compliancekaders, zoals ISO-normen, regelgevende richtlijnen of interne beleidslijnen, zijn lange documenten waarin het antwoord op “voldoen we?” ervan afhangt dat je eerst de specifieke eis vindt en die vervolgens vergelijkt met de huidige praktijk. Alleen die eerste stap kan in een dichte standaard veel tijd kosten.
In plaats daarvan kun je een AI-documentassistent vragen:
- “Wat vereist dit beleid voor de doorlooptijden van incidentrespons?”
- “Zijn er specifieke bewaartermijnen voor gegevens in deze regelgeving?”
- “Welke toegangscontroles schrijft deze standaard voor?”
- “Waar behandelt dit document de eisen voor externe leveranciers?”
- “Wat zijn de audit- en rapportageverplichtingen onder dit kader?”
Een compliancechecklist in gespreksvorm doorwerken is sneller dan elke sectie lezen om de relevante bepaling te vinden.
Hoe je betere vragen schrijft voor nauwkeurigere antwoorden
De retriever werkt met wat je ook vraagt, maar de precisie van je vraag beïnvloedt direct de kwaliteit van het resultaat. Een paar patronen die de output consistent verbeteren:
Wees specifiek over wat je wilt. “Vertel me over het contract” levert een breed antwoord op. “Wat zijn de beëindigingsbepalingen in sectie 9?” geeft de retriever een precies doelwit.
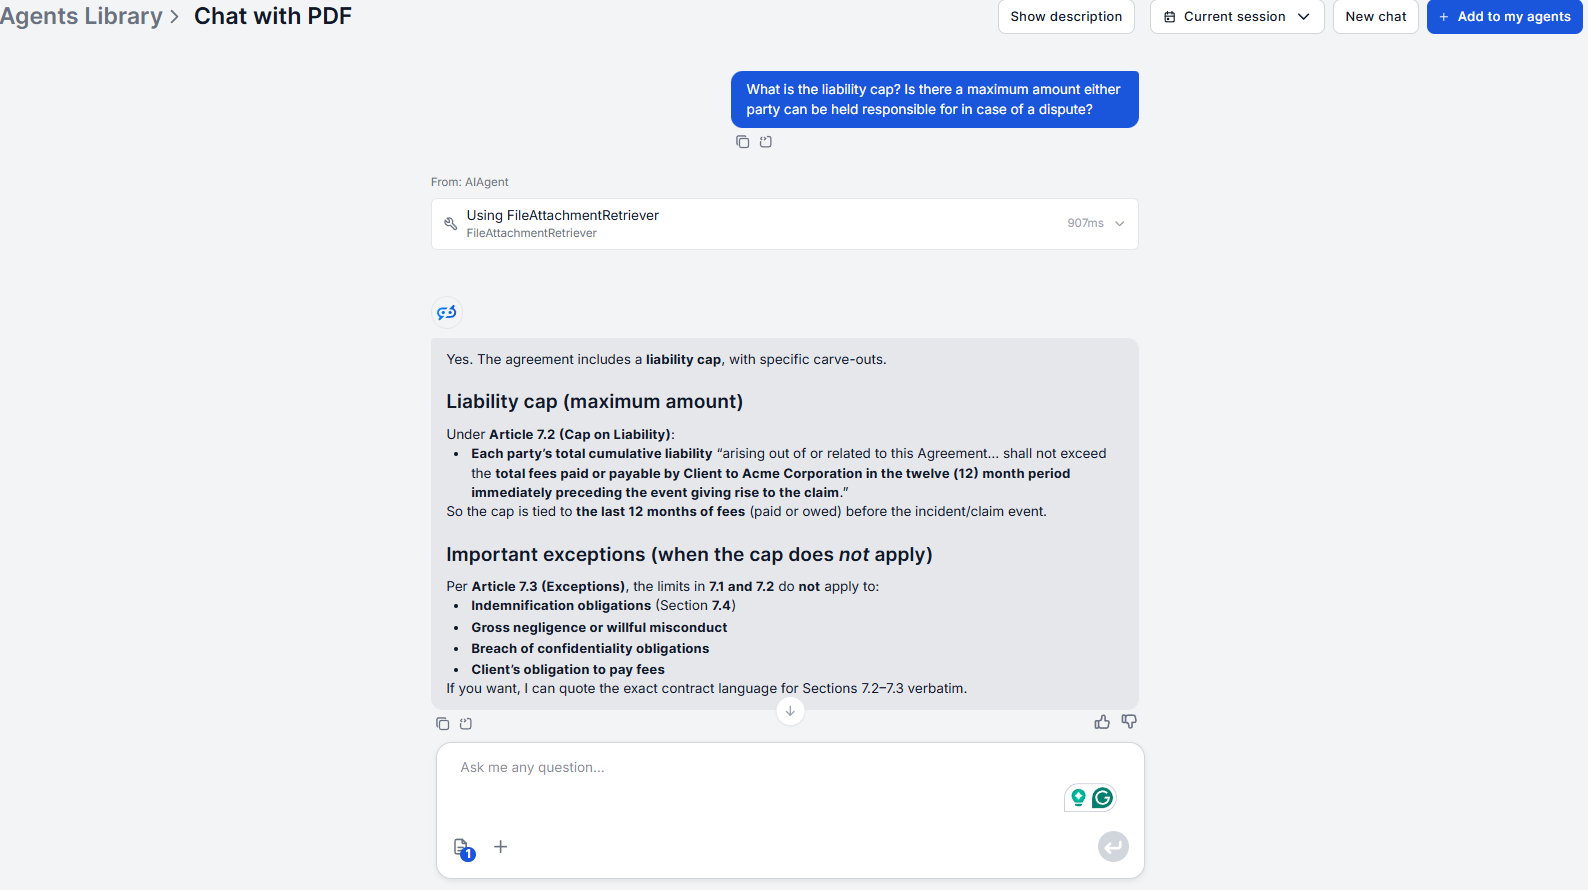
Verwijs naar sectienummers als je ze kent. “Wat staat er in sectie 4.2?” is gerichter dan “Wat zegt dit document over aansprakelijkheid?”
Gebruik vervolgvragen in plaats van opnieuw te beginnen. De assistent houdt de volledige gespreksgeschiedenis gedurende de sessie bij. “Wat zijn de uitzonderingen op die clausule?” is beter dan de volledige context opnieuw uitleggen in een nieuwe vraag.
Laat de verduidelijkingsvraag zijn werk doen. Als je vraag dubbelzinnig is, vraagt de assistent om verduidelijking in plaats van te gokken.
Vraag expliciet om samenvattingen wanneer je die nodig hebt. “Vat sectie 5 samen” of “Wat zijn de belangrijkste conclusies uit de methodologie?” levert samenvattingen op die uit de werkelijke inhoud komen, niet onafhankelijk zijn gegenereerd. Expliciete verzoeken om een samenvatting zijn betrouwbaarder dan brede “overzicht”-vragen.
In alle zeven use cases is de gemeenschappelijke factor dezelfde: een gerichte vraag levert een gericht antwoord op. Hoe specifieker de vraag, hoe minder ruis bij het ophalen en hoe direct bruikbaarder het antwoord.
De tool is ook transparant over wat hij niet kan vinden. Als een document niet bevat waar je naar vraagt, zegt de assistent dat in plaats van een antwoord te verzinnen. Dat gedrag maakt de tool betrouwbaar voor professioneel gebruik in plaats van alleen gemakkelijk.
Voor een complete installatiegids en vraagpatronen die in al deze use cases werken, zie de Chat with PDF-tutorial .
