


Att manuellt söka i en PDF är hanterbart för en promemoria på 10 sidor. För allt längre, till exempel ett 50-sidigt avtal, en kvartalsrapport eller en forskningsartikel med 40 sidor bilagor, blir det ett pålitligt sätt att förlora en eftermiddag. Det är därför yrkesverksamma inom nästan varje kunskapsintensivt område nu använder AI för att chatta med PDF och plockar fram avsnitt och data direkt.
Här är de sju professionella scenarier där Chat with PDF konsekvent ger mest värde, och hur varje arbetsflöde ser ut i praktiken.
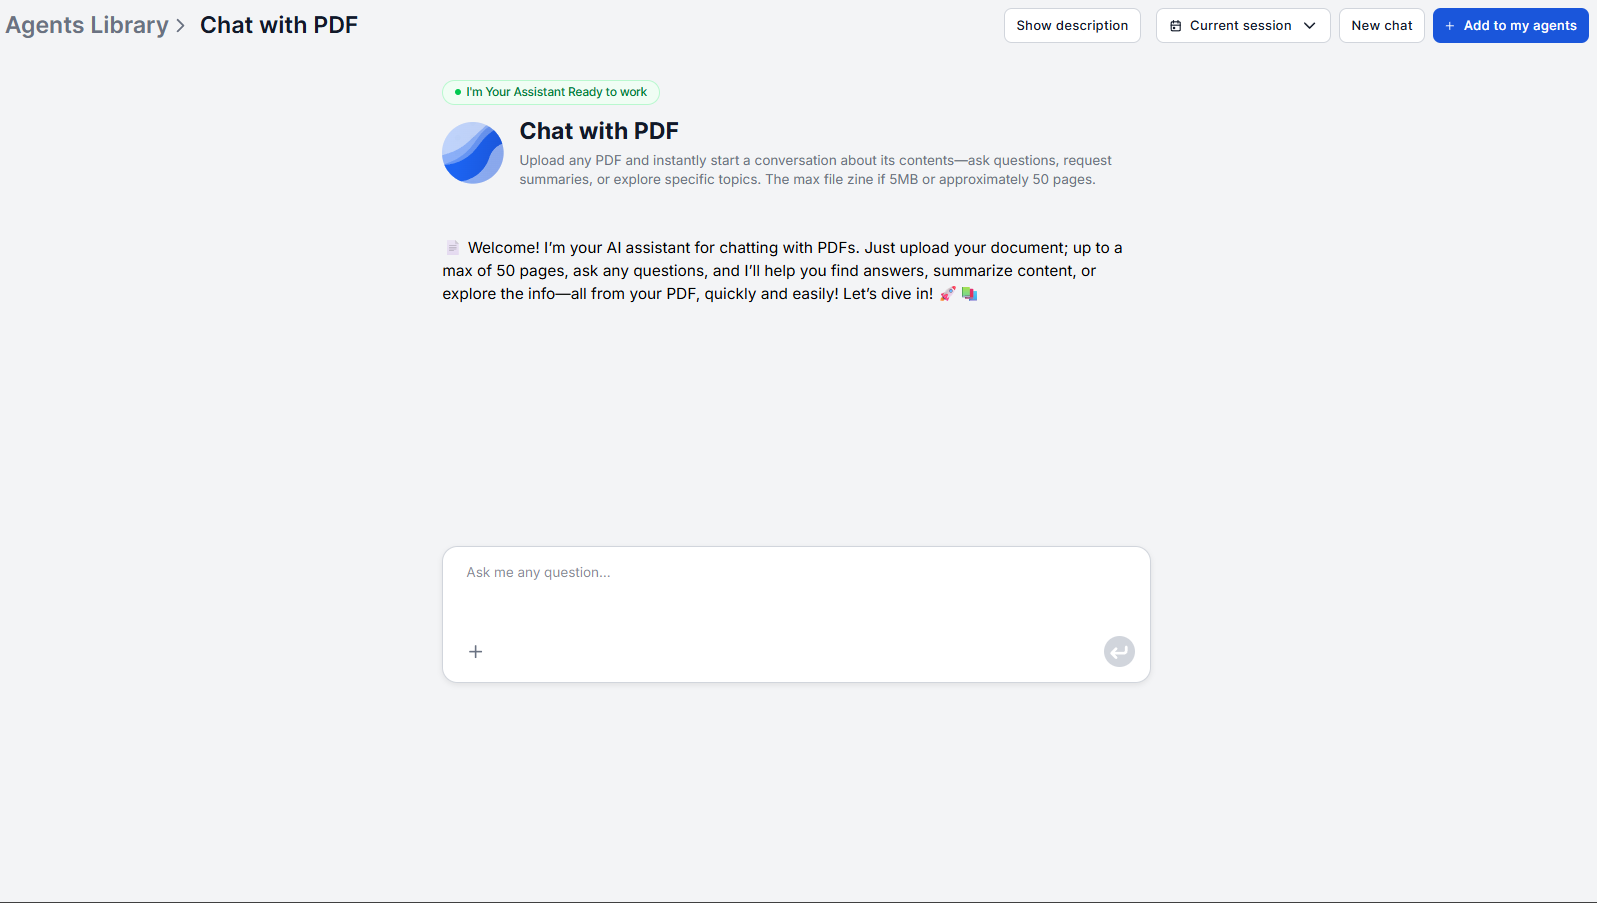
Användningsområde 1: Granskning av juridiska avtal och extrahering av klausuler
Juridiska dokument är långa, täta och strukturellt olinjära. Ett tjänsteavtal eller NDA kan definiera en term på sidan 4 och tillämpa den 25 sidor senare, referera till andra avsnitt genomgående och innehålla bestämmelser som bara blir relevanta under särskilda omständigheter, vilket du kanske inte vet att du bör kontrollera förrän det är för sent.
AI-chatt med PDF för juridiska team innebär att det inte finns något behov av att läsa dokument från pärm till pärm, allt du behöver göra är att ställa de specifika frågor som är viktiga. Du kan till exempel fråga om uppsägningsvillkoren, dokumentets definition av “konfidentiell information”, eller om det finns automatiska förnyelseklausuler.
AI:n hämtar dokumentets exakta formuleringar istället för att parafrasera dem, vilket är avgörande i ett sammanhang där ordval bestämmer betydelsen. Konversationshistoriken gör att du kan följa upp (“Vilket avsnitt kommer det från?” eller “Finns det några undantag från den klausulen?”) utan att förklara frågan igen.
För ett komplett steg-för-steg-arbetsflöde för juridisk granskning – inklusive NDA-granskning på under 10 minuter och en checklista för leverantörsavtal – se Hur jurister granskar avtal 5x snabbare med AI .
Användningsområde 2: Akademisk litteraturgenomgång
Litteraturgenomgångar innebär att läsa många artiklar för att extrahera en liten mängd specifik information från var och en. Att läsa 30 artiklar från pärm till pärm för att hitta deras metodik, urvalsstorlek och huvudresultat är standardförfarande, men större delen av lästiden ger inget användbart.
Metoden att chatta med dokument via AI förändrar kalkylen. Du laddar bara upp en artikel, frågar det du behöver och går vidare. Användbara frågor inkluderar:
- “Vad var urvalsstorleken och datakällan?”
- “Vilka var huvudslutsatserna?”
- “Vilka begränsningar identifierade författarna?”
- “Bekräftade eller motsade denna studie tidigare resultat inom detta ämne?”
- “Vilken framtida forskning rekommenderade författarna?”
Hämtaren returnerar det exakta stycket istället för en genererad sammanfattning, vilket hjälper när du behöver verifiera påståenden eller citera resultat korrekt utan att förvanska vad artikeln sade.
För bredare syntes av ämnen över flera källor bygger AI-forskningsassistenten strukturerade forskningsdokument med annoterade bibliografier.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Användningsområde 3: Analys av finansiella rapporter
Kvartalsrapporter, årsredovisningar och regulatoriska inlämningar är utformade för fullständighet, inte läsbarhet. Nyckeltal är utspridda över flera avsnitt, och fotnoter innehåller ofta de justeringar som förändrar hur rubriksiffrorna bör tolkas.
PDF-analysverktyg för yrkesverksamma inom finans fokuserar på:
- Att snabbt extrahera specifika nyckeltal (“Vad var rörelsemarginalen i Q3?”)
- Att hitta segment- eller regionuppdelningar (“Hur presterade segmentet Asien-Stillahavsregionen?”)
- Att lyfta fram fotnoter och redovisningsjusteringar (“Är EBITDA justerat, och vad exkluderas?”)
- Att kontrollera ledningens kommentarer mot rapporterade siffror (“Vilken tillväxt prognosticerade ledningen för denna period?”)
Assistenten hämtar den exakta texten, inte en återskapad sammanfattning, så siffror och fotnotstexter återges precis som de står i dokumentet, vilket är viktigt när du bygger modeller eller förbereder analys för intressenter.
För att extrahera strukturerad finansiell data från fakturor och finansiella dokument i stor skala hanterar fakturaextraheringsverktyget automatiserad OCR-baserad extrahering från stora fakturavolymer.
Användningsområde 4: Granskning av anbudsförfrågningar och anbudsdokument
Anbudsförfrågningar och anbudsdokument är långa till sin natur och täcker omfattning, krav, utvärderingskriterier, inlämningsformat, juridiska villkor och tidslinjer över dussintals sidor. Att missa ett obligatoriskt krav kan innebära diskvalificering.
AI-dokumentassistenten kan hjälpa till med kvalificering före inlämning:
- “Vilka är de obligatoriska kraven för inlämning?”
- “Vilka utvärderingskriterier anger denna anbudsförfrågan, och hur viktas de?”
- “Finns det bestämmelser om intressekonflikter?”
- “Vad är det högsta kontraktsvärdet?”
- “Vad är sista inlämningsdag och vilket format accepteras?”
Att arbeta sig igenom en anbudsförfrågan i konversationsform är snabbare och mer tillförlitligt än en linjär läsning för att hitta de tio krav som är begravda i ett 60-sidigt dokument. När du väl känner till den fullständiga kravlistan kan du välja att läsa om de relevanta avsnitten i sin helhet, men du har redan avgjort om det är värt investeringen att svara.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Användningsområde 5: Analys av medicinska forskningsartiklar
Kliniska forskare, farmaceuter och vårdpersonal behöver regelbundet extrahera specifika resultat från artiklar vars fullständiga metodik är tät och inte alltid relevant för den aktuella frågan. Att läsa en hel klinisk studie för att hitta biverkningsprofilen eller inklusionskriterierna är vanligt men ineffektivt.
Typiska frågor för detta användningsområde:
- “Vad var det primära effektmåttet och hur mättes det?”
- “Vilka biverkningar rapporterades och med vilken frekvens?”
- “Vilka var inklusions- och exklusionskriterierna för deltagarna?”
- “Vilken tröskel för statistisk signifikans användes?”
- “Hur förhåller sig denna studie till de tidigare studier som citeras i inledningen?”
Hämtaren returnerar den exakta texten från artikeln, så resultat återges precis som författarna formulerade dem. Detta är viktigt när korrektheten i det ursprungliga påståendet har betydelse för kliniska eller regulatoriska ändamål.
Användningsområde 6: Felsökning med tekniska manualer
Tekniska manualer, API-dokumentation och produktspecifikationer är referensdokument. De läses sällan linjärt och är utformade för att besvara specifika frågor. Men “specifik fråga + manuell sökning” innebär fortfarande att navigera i en innehållsförteckning, skanna avsnitt och följa korsreferenser, vilket sammantaget tar tid.
Chatt med dokument-AI gör tekniska referensdokument konversationella:
- “Vad betyder felkoden E204?”
- “Vilka krav finns för konfiguration av nätverksgränssnittet?”
- “Vilket åtdragningsmoment rekommenderas för monteringsbultarna?”
- “Vilket avsnitt beskriver proceduren för firmwareuppdatering?”
- “Vilka säkerhetsåtgärder gäller för högspänningskomponenter?”
Assistenten hämtar det relevanta stycket direkt och tar bort navigationskostnaden. För tekniska team som underhåller komplex utrustning eller integrerar API:er förändrar detta arbetsflödet från “hitta avsnittet och läs det” till “fråga, få svaret, agera”.
Användningsområde 7: Granskning av efterlevnadsdokument
Efterlevnadsramverk, som ISO-standarder, regulatoriska riktlinjer eller interna policyer, är långa dokument där svaret på “efterlever vi?” beror på att först hitta det specifika kravet och sedan jämföra det med nuvarande praxis. Enbart det första steget kan ta betydande tid i en tät standard.
Istället kan du fråga en AI-dokumentassistent:
- “Vad kräver denna policy för tidsramar vid incidenthantering?”
- “Finns det specifika krav på bevarande av register i denna förordning?”
- “Vilka åtkomstkontroller föreskriver denna standard?”
- “Var behandlar detta dokument krav på tredjepartsleverantörer?”
- “Vilka revisions- och rapporteringsskyldigheter gäller enligt detta ramverk?”
Att arbeta sig igenom en efterlevnadschecklista i konversationsform är snabbare än att läsa varje avsnitt för att hitta den relevanta bestämmelsen.
Hur du skriver bättre frågor för mer korrekta svar
Hämtaren arbetar med vad du än frågar om, men frågans precision påverkar resultatkvaliteten direkt. Några mönster som konsekvent förbättrar resultaten:
Var specifik med vad du vill ha. “Berätta om avtalet” ger ett brett svar. “Vilka är uppsägningsbestämmelserna i avsnitt 9?” ger hämtaren ett exakt mål.
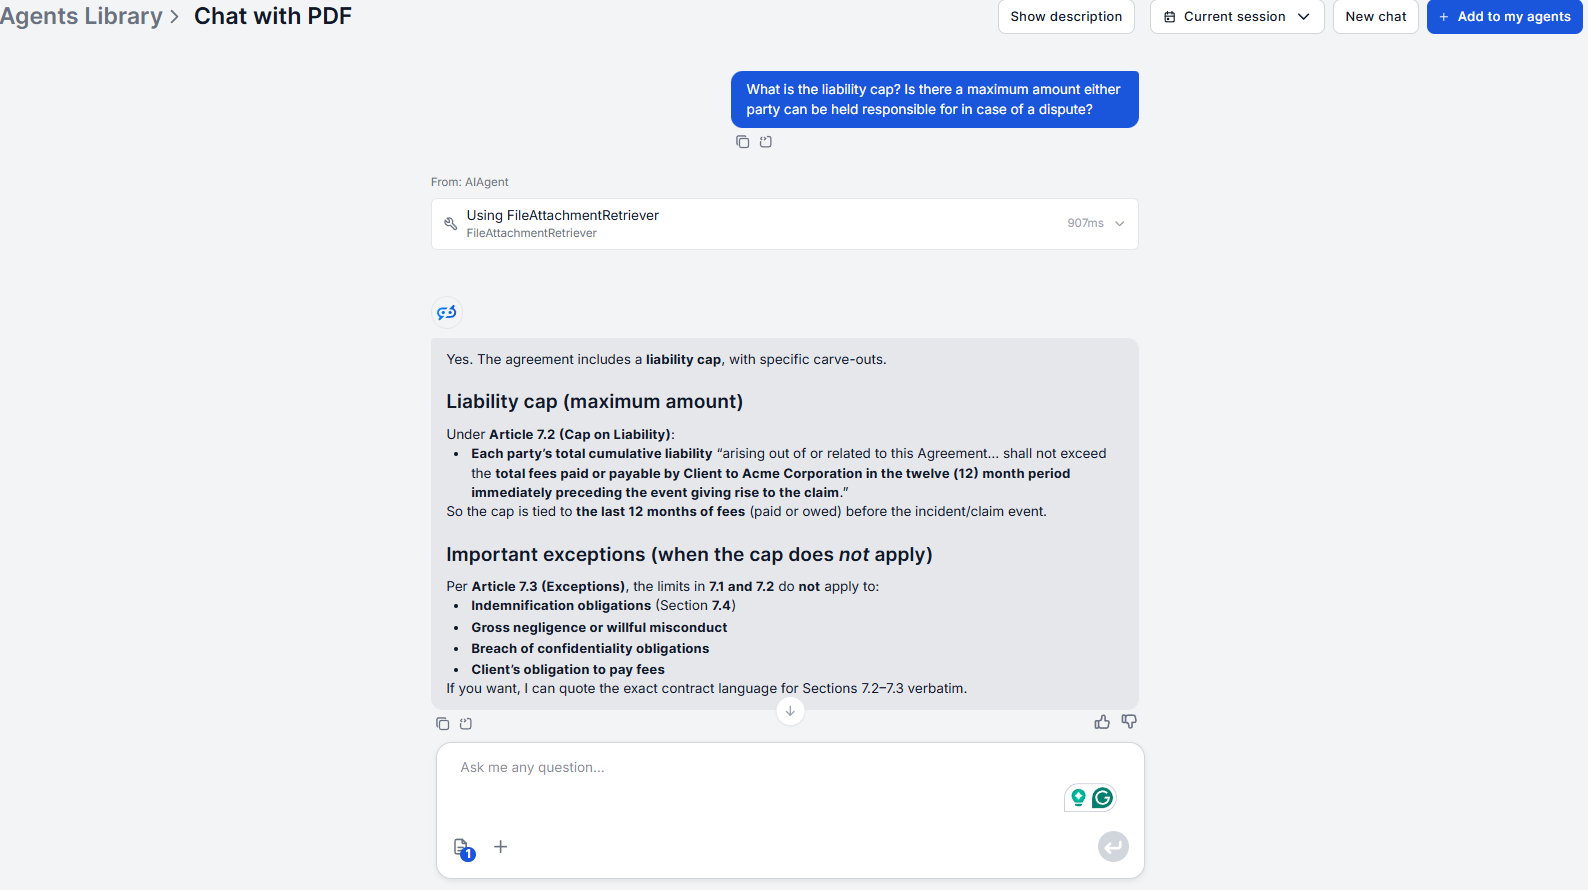
Referera till avsnittsnummer när du känner till dem. “Vad står det i avsnitt 4.2?” är mer riktat än “Vad säger detta dokument om ansvar?”
Använd följdfrågor istället för att börja om. Assistenten behåller hela konversationshistoriken under sessionen. “Vilka är undantagen från den klausulen?” är bättre än att förklara hela sammanhanget på nytt i en ny fråga.
Låt förtydligandeprompten fungera. Om din fråga är tvetydig frågar assistenten istället för att gissa.
Be om sammanfattningar uttryckligen när du behöver dem. “Sammanfatta avsnitt 5” eller “Vilka är de viktigaste slutsatserna från metodiken?” ger sammanfattningar hämtade från det faktiska innehållet, inte genererade oberoende. Uttryckliga sammanfattningsbegäranden är mer tillförlitliga än breda “översikt”-frågor.
I alla sju användningsområden är den gemensamma faktorn densamma: en riktad fråga ger ett riktat svar. Ju mer specifik frågan är, desto mindre brus i hämtningen och desto mer direkt användbart blir svaret.
Verktyget är också transparent med vad det inte kan hitta. Om ett dokument inte innehåller det du frågar om säger assistenten det istället för att hitta på ett svar, vilket är beteendet som gör det tillförlitligt för professionellt bruk och inte bara bekvämt.
För en komplett installationsguide och frågemönster som fungerar i alla dessa användningsområden, se Chat with PDF-handledningen .
