


Chat met PDF laat je elke tekstgebaseerde PDF uploaden en er vragen over stellen in gewone taal. In plaats van het document van begin tot eind te lezen, krijg je nauwkeurige antwoorden die rechtstreeks uit het document komen, waarbij de volledige gesprekscontext behouden blijft zodat vervolgvragen natuurlijk werken.
Deze gids leidt je door de complete installatie van upload tot output, inclusief de querypatronen die consistent de beste resultaten opleveren, de fouten die de meeste gebruikers in het begin maken, en de aanpassingen die je kunt doen om het maximale uit je workflows te halen.
Stap 1: Upload je PDF
Open Chat met PDF en upload je document via de bestandsuploadinterface. De tool werkt met elke tekstgebaseerde PDF, evenals met andere tekstformaten.
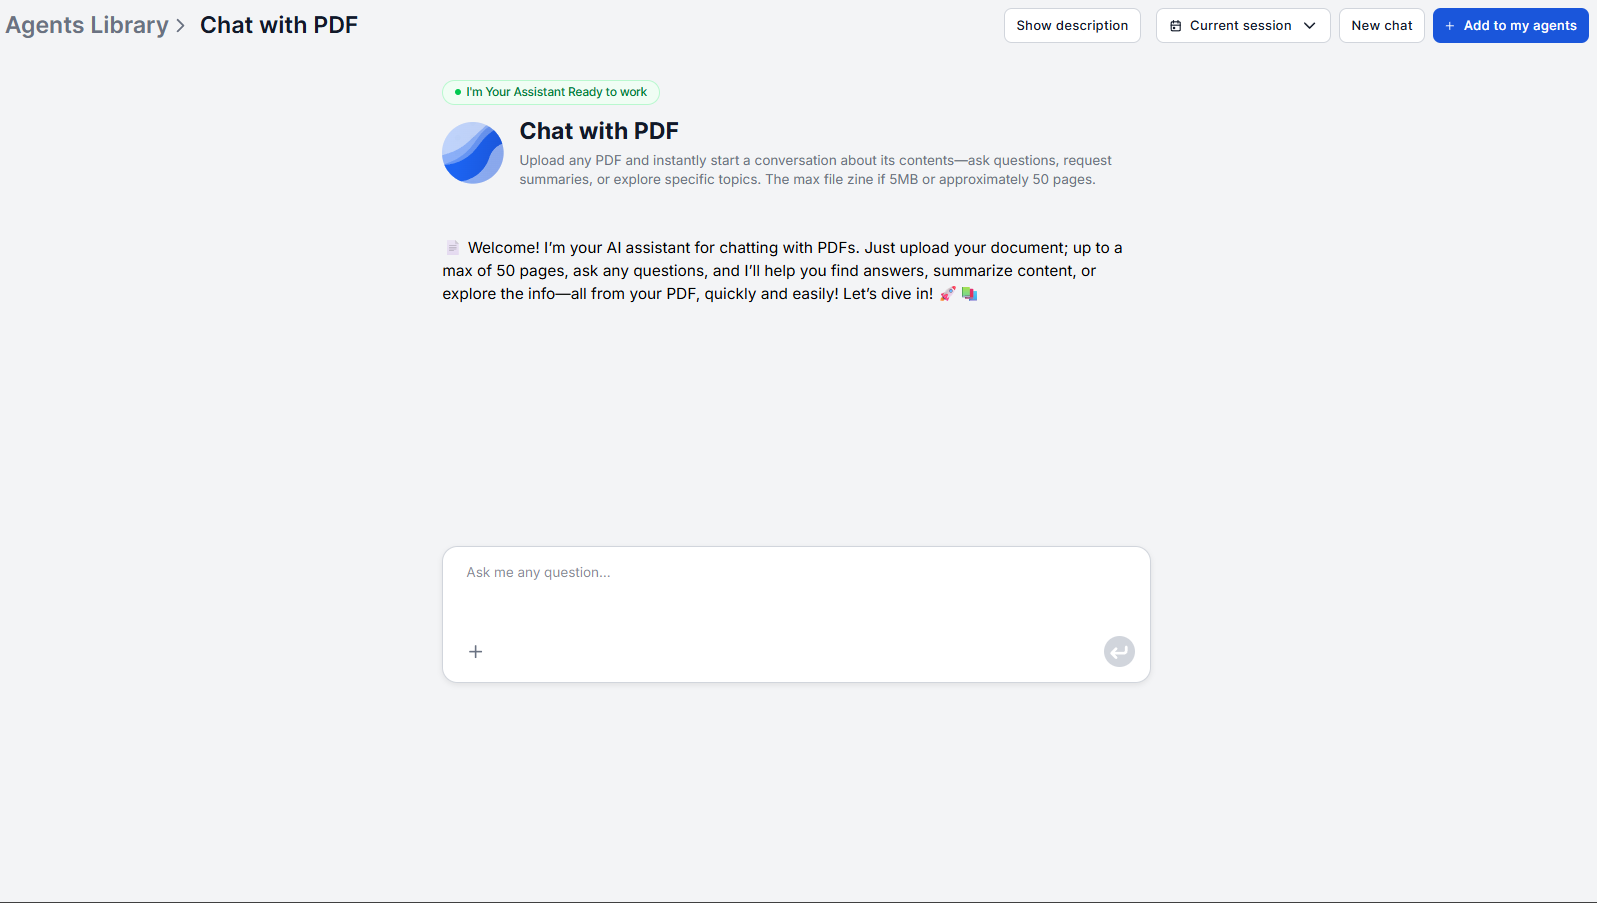
Een belangrijke beperking is dat de tool tekst rechtstreeks uit het document haalt, dus werkt het alleen met PDF’s waarin de tekst selecteerbaar is. Gescande PDF’s die afbeeldingen van pagina’s zijn in plaats van documenten met ingebedde tekst, leveren geen resultaten op. Je kunt echter wel OCR-verwerking inschakelen in je flow zodat FlowHunt deze ook kan lezen.
Zodra het bestand is geüpload, is de sessie klaar. Er is geen configuratiestap, geen documenttagging en het is niet nodig om het document vooraf te lezen voordat je je eerste vraag stelt.
Stap 2: Hoe je queries schrijft die nauwkeurige antwoorden opleveren
Voordat je je eerste vraag stelt, is het de moeite waard om te begrijpen wat er gebeurt wanneer je een query indient. De assistent vat niet het hele document samen en antwoordt niet op basis van die samenvatting. In plaats daarvan voert hij een bestandsretrieval uit, waarbij hij het document doorzoekt op de passages die het meest relevant zijn voor jouw specifieke query.
Dit betekent dat de precisie van je antwoord direct gekoppeld is aan de precisie van je vraag. Hieruit volgen twee richtlijnen:
Wees specifiek, niet breed. “Wat zegt dit contract over aansprakelijkheidslimieten?” haalt de aansprakelijkheidssecties op. “Vertel me over het contract” vraagt de retriever om alles te doorzoeken, wat een generiek antwoord op hoog niveau oplevert in plaats van de clausuletaal die je nodig hebt.
Verwijs naar wat je zoekt bij naam. Sectietitels, clausuletypen, gedefinieerde termen en onderwerpkeywords geven de retriever allemaal een precies doel. “Wat is de definitie van ‘vertrouwelijke informatie’ in dit document?” is gerichter dan “Wat zijn de definities?”
Antwoorden zijn uitsluitend gebaseerd op de inhoud van de geüploade PDF. De assistent haalt geen externe informatie erbij, wat betekent dat het antwoord precies weergeeft wat jouw document zegt in plaats van wat een standaardversie van dat document doorgaans bevat.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
Stap 3: Stel je eerste vragen
Begin na het uploaden met vragen die de structuur van het document in kaart brengen voordat je in details duikt. Voor de meeste documenttypen ziet een nuttige openingsreeks er zo uit:
Voor contracten: “Wat zijn de belangrijkste verplichtingen van elke partij onder deze overeenkomst?” Dit geeft je de structurele kaart voordat je naar specifieke clausules vraagt.
Voor rapporten: “Wat behandelt dit document, en wat zijn de hoofdsecties?” Gevolgd door: “Wat waren de belangrijkste bevindingen of conclusies?”
Voor onderzoekspapers: “Wat was de onderzoeksvraag en methodologie?” Gevolgd door: “Wat waren de belangrijkste resultaten?”
Voor technische documenten: “Wat behandelt deze handleiding, en op welke systemen of componenten is die van toepassing?”
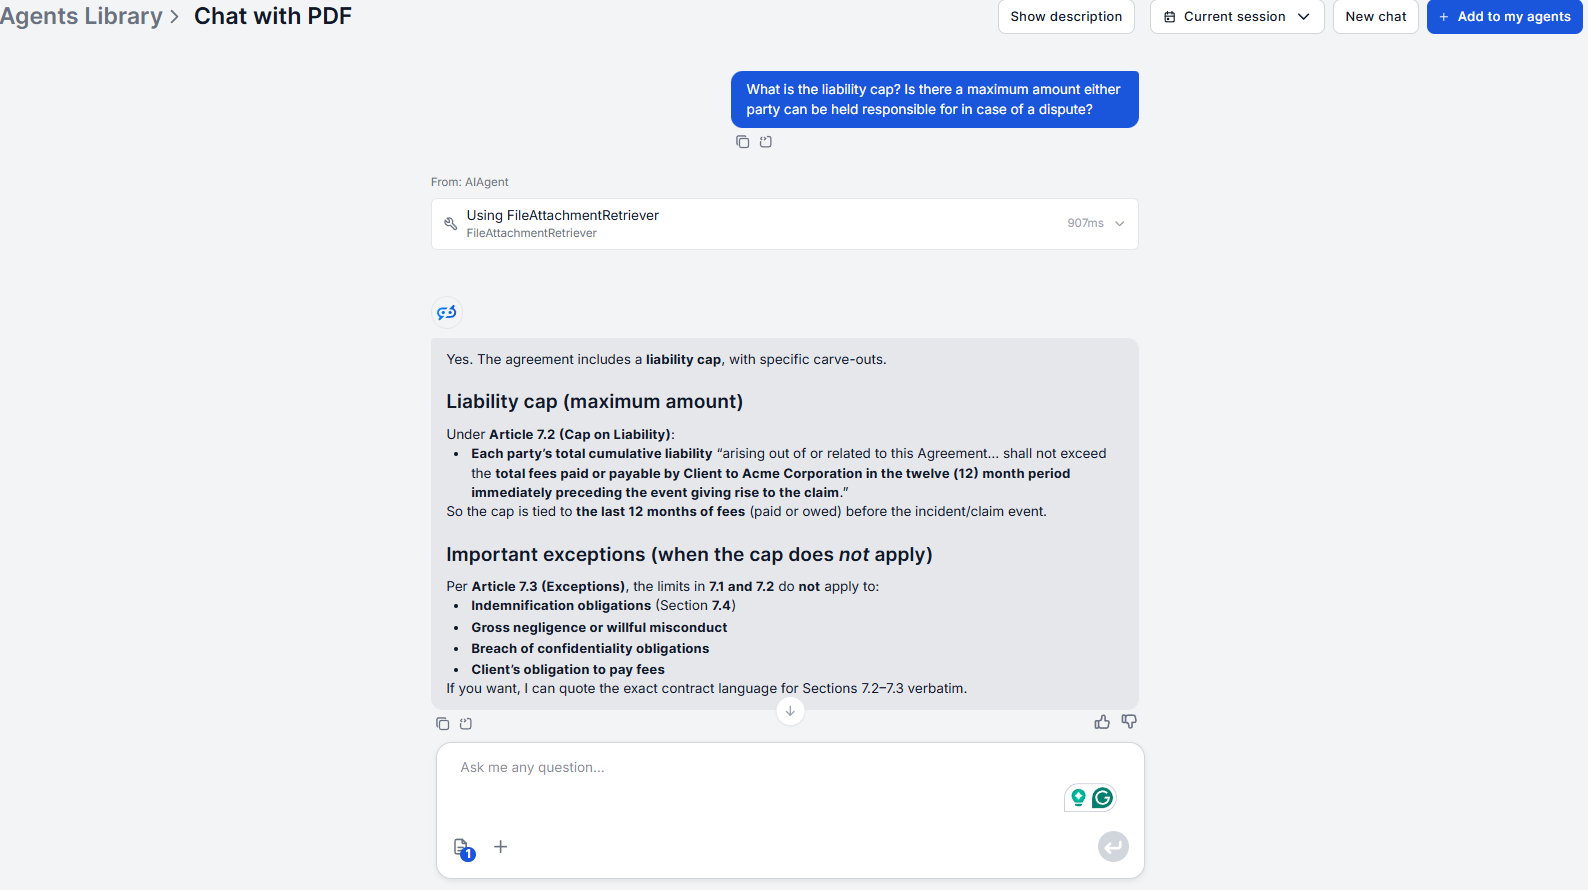
Ga na de eerste oriëntatievragen naar de details. Omdat de assistent tijdens de sessie de volledige gespreksgeschiedenis bijhoudt, bouwt elke vervolgvraag voort op de vorige uitwisseling. Je hoeft de context niet opnieuw uit te leggen. “Wat zijn de uitzonderingen op die clausule?” werkt correct omdat de assistent weet over welke clausule je net sprak.
Als een vraag dubbelzinnig is, bijvoorbeeld vragen naar “de prijsstelling” in een document met drie afzonderlijke prijssecties, stelt de assistent een verduidelijkende vraag in plaats van te gokken. Beantwoord simpelweg de verduidelijkingsvraag.
Stap 4: Verifieer antwoorden aan de hand van het document
De assistent geeft antwoorden met relevante fragmenten en context uit het document waar die het begrip ondersteunen. Gebruik deze fragmenten om het antwoord te verifiëren aan de hand van het originele bestand.
Voor elk antwoord dat de basis vormt voor een beslissing — een contractclausule waarop je vertrouwt, een cijfer dat je in een rapport opneemt, een technische specificatie waarop je handelt — vergelijk je het teruggegeven fragment rechtstreeks met de overeenkomstige sectie in de PDF. Het fragment vertelt je welke sectie je moet controleren. Kruisverwijzing kost seconden en geeft je volledige gemoedsrust.
Deze stap is belangrijk omdat de tool precies is voor goed opgemaakte, duidelijk geschreven PDF’s en nauwkeurig is voor wat het document zegt. De professionele standaard is om claims uit primaire bronnen te verifiëren voordat je erop handelt, ongeacht hoe goed de retrieval is uitgevoerd.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Stap 5: Exporteer en gebruik je bevindingen
Antwoorden verschijnen in de chatinterface. Kopieer reacties uit het gesprek om ze in externe documenten, klantnotities, redlines of rapporten te plakken. Als je een gestructureerde output of een opgemaakte samenvatting nodig hebt, kan de onderliggende flow binnen FlowHunt worden aangepast om het antwoordformaat af te stemmen op je documentworkflow.
Voor teams die regelmatig hetzelfde type informatie uit veel documenten halen, zoals een juridisch team dat dezelfde clausulechecklist op elk binnenkomend contract toepast, vermindert het configureren van de flow om gestructureerde output te retourneren in plaats van conversationele antwoorden het opmaakwerk stroomafwaarts aanzienlijk.
Voor workflows met meerdere documenten kun je met knowledge sources meerdere documenten uploaden naar een AI-kennisbank en ze allemaal in één sessie bevragen.
Querypatronen die het beste werken (met voorbeelden)
Op basis van hoe het retrievalsysteem werkt (het opvragen van relevante passages vóór elk antwoord), leveren deze querystructuren consistent betere resultaten op:
Gerichte clausuleretrieval: “Wat zegt sectie [nummer of naam] over het onderwerp?” Voorbeeld: “Wat zegt sectie 12 over toepasselijk recht?”
Definitieopzoeken: “Hoe definieert dit document de term?” Voorbeeld: “Hoe definieert dit document ‘wezenlijke tekortkoming’?”
Scope-vragen: “Wat zijn alle voorwaarden waaronder X kan gebeuren?” Voorbeeld: “Wat zijn alle voorwaarden waaronder een van beide partijen deze overeenkomst kan beëindigen?”
Vergelijking binnen het document: “Behandelt dit document concept A anders in verschillende secties?” Voorbeeld: “Hanteert dit contract verschillende opzegtermijnen in verschillende contexten?”
Samenvatting van een specifieke sectie: “Vat sectienaam of -nummer samen in gewone taal.” De assistent vat samen op basis van de werkelijke sectie-inhoud in plaats van onafhankelijk te genereren.
Expliciete vervolgvraag: “Wat zijn de uitzonderingen op wat je net beschreef?” of “Behandelt het document wat er gebeurt als aan die voorwaarde niet wordt voldaan?”
Veelgemaakte fouten en hoe je ze oplost
Een gescande PDF zonder ingebedde tekst uploaden. De retriever heeft niets om te doorzoeken. Haal het document eerst door onze OCR-tool .
Eerst te brede vragen stellen. “Vertel me alles wat belangrijk is over dit contract” vraagt de retriever om prioriteiten te stellen zonder voldoende richting. Begin met structurele vragen en ga dan specifiek te werk.
De verduidelijkingsvraag negeren. Wanneer de assistent om verduidelijking vraagt, betekent dit dat je vraag overeenkwam met meerdere secties. Het beantwoorden van de vraag leidt de retrieval naar het juiste deel van het document.
Een lang antwoord behandelen als volledige dekking. De tool haalt de meest relevante passages voor je query op. Het garandeert niet dat elk exemplaar van een onderwerp in het hele document is gevonden. Als volledigheid belangrijk is, stel dan de vervolgvraag: “Zijn er nog andere secties in dit document die [onderwerp] behandelen?”
Een nieuwe sessie starten terwijl een vervolgvraag zou werken. Gebruik de gespreksgeschiedenis. Het opnieuw uploaden van hetzelfde document en het opnieuw stellen van vragen die voortbouwen op eerdere antwoorden verspilt context die de sessie al bijhoudt.
Voor professionele use case-walkthroughs — juridische contractreview, financiële analyse, RFP-documenten en meer — zie Chat met PDF: 7 professionele use cases . Als je afweegt welke tool bij je workflow past, vergelijkt de vergelijking van PDF-chattools FlowHunt, ChatPDF, Adobe en Humata rechtstreeks met elkaar.