


Tekoälyasetus (AI Act)
Tutustu EU:n tekoälyasetukseen – maailman ensimmäiseen kattavaan tekoälysääntelyyn. Opi, miten se luokittelee tekoälyjärjestelmät riskin mukaan, luo hallintorak...
8 min lukuaika
AI Act
EU Regulation
+4
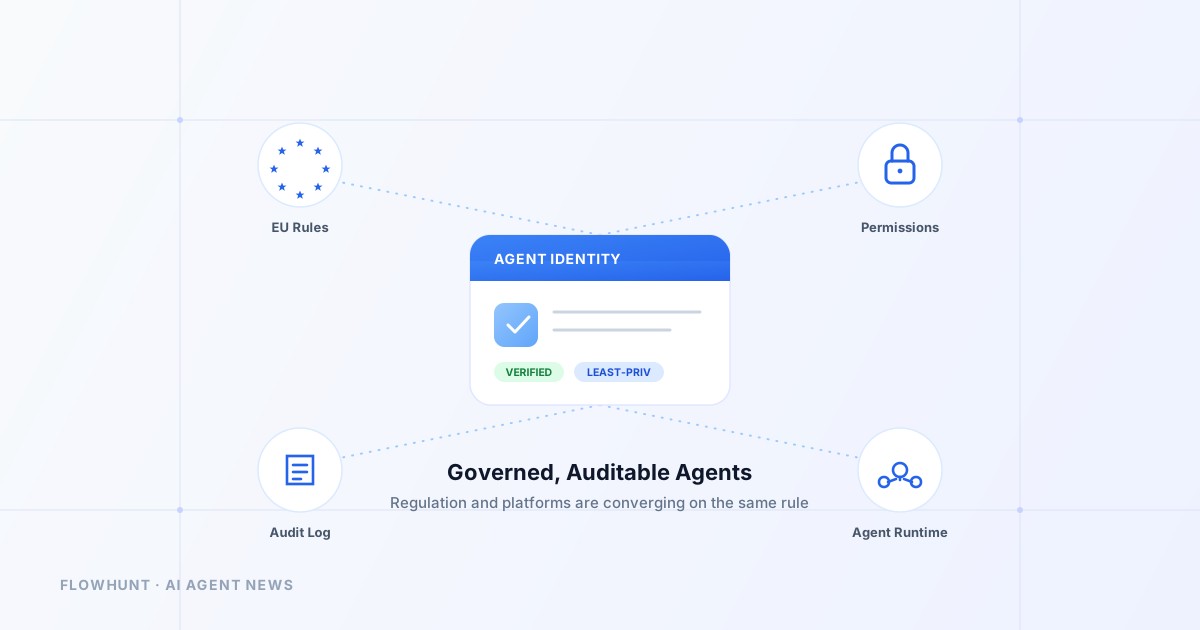
EU:n tekoälysäädöksen läpinäkyvyyssäännöt ovat nyt täytäntöönpanokelpoisia, ja Google Cloud julkaisi natiivin Agent Identity -järjestelmän. Tässä kerrotaan, mikä muuttui tekoälyagentteja rakentaville tiimeille.
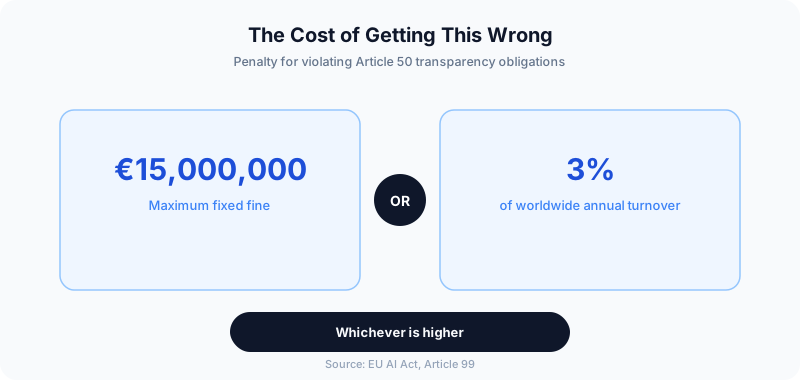
Kaksi elokuun 2026 ensimmäisen viikon ilmoitusta osoittavat samaan muutokseen vastakkaisista suunnista. Elokuun 2. päivänä EU:n tekoälysäädöksen läpinäkyvyyssäännöistä tuli täytäntöönpanokelpoista lakia, mikä edellyttää kaikkia chatbotin, sisällöntuottajan tai tunnetunnistusjärjestelmän käyttäjiä ilmoittamaan siitä selkeästi tai kohtaamaan jopa 15 miljoonan euron sakot. Muutamaa päivää myöhemmin Google Cloud julkaisi Agent Identity -järjestelmänsä yleiseen saatavuuteen — natiivin käyttöoikeuskerroksen, joka seuraa tarkalleen, mihin tekoälyagentti voi päästä käsiksi, ja kirjaa kaiken mitä se tekee. Toinen on sääntelyviranomainen, joka pakottaa läpinäkyvyyteen. Toinen on pilvialusta, joka myy vastuullisuutta ominaisuutena. Molemmat päätyvät samaan johtopäätökseen: tekoälyagentti, jota kukaan ei voi tunnistaa, auditoida tai saattaa vastuuseen, ei ole valmis tuotantoon riippumatta siitä, onko tuomioistuin toista mieltä.
EU:n tekoälysäädöksen artiklan 50 läpinäkyvyysvelvoitteet tulivat yleisesti sovellettaviksi ja kansallisten viranomaisten täytäntöönpanokelpoisiksi koko EU:ssa 2. elokuuta 2026. Käytännössä tämä kattaa neljä asiaa. Palveluntarjoajien on varmistettava, että henkilöt saavat “selkeästi tiedon, että he ovat tekemisissä tekoälyjärjestelmän kanssa, ellei tämä ole asiayhteydestä ilmeistä” — chatbot-ilmoitussääntö. Palveluntarjoajien, jotka tuottavat synteettistä ääntä, kuvaa, videota tai tekstiä, on merkittävä kyseinen tuotos koneellisesti luettavassa ja havaittavassa muodossa. Jokaisen, joka ottaa käyttöön järjestelmän, joka tuottaa todellisia henkilöitä, paikkoja tai tapahtumia esittäviä syväväärennöksiä, on ilmoitettava siitä. Ja tunnetunnistus- tai biometristä luokittelujärjestelmää käyttävien on tiedotettava niille henkilöille, jotka ovat alttiina järjestelmälle, ja pysyttävä EU:n tietosuojalainsäädännön puitteissa.
Mikään tästä ei ole uutta konseptina — tekoälysäädös allekirjoitettiin vuosia aiemmin. Se, mikä muuttui 2. elokuuta, on se, että nämä erityiset velvoitteet lakkasivat olemasta tulevaisuuden päivämäärä vaatimustenmukaisuuden tiekartalla ja muuttuivat joksikin, jota kansalliset sääntelyviranomaiset voivat todella panna täytäntöön tänään.

Aloita ilmainen kokeilujakso tänään ja näe tulokset muutamassa päivässä.
Kaikki säädöksen osat eivät saapuneet aikataulussa. Digital Omnibus on AI -säädöksen kautta, joka allekirjoitettiin 8. heinäkuuta 2026, EU siirsi korkean riskin järjestelmiä koskevia vaatimuksia myöhemmäksi. Liitteen III mukaiset itsenäiset järjestelmät — ajattele työhönottoseulontaa, koulutusta, lainvalvontaa, kriittistä infrastruktuuria — ovat nyt voimassa 2. joulukuuta 2027 asti. Jo säädeltyihin tuotteisiin liitteen I mukaisesti upotetulla tekoälyllä, kuten lääkinnällisillä laitteilla tai hisseillä, on määräaika 2. elokuuta 2028.
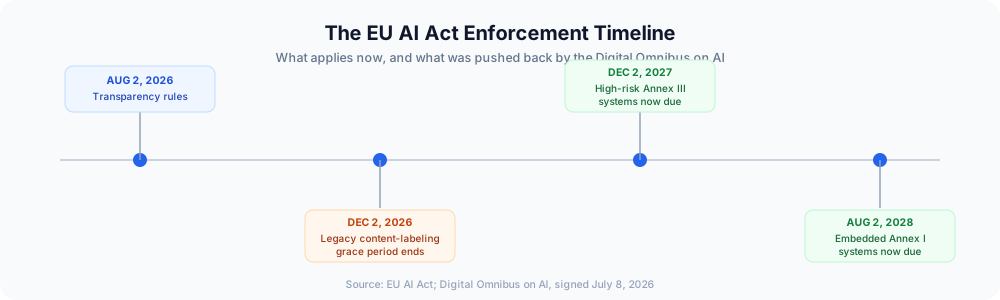
Tämä lykkäys on syytä ymmärtää tarkasti, koska se on helppo tulkita väärin “tekoälysäädös viivästyi” -merkityksessä. Näin ei käynyt. Kiellettyjen käytäntöjen lista ja yleiskäyttöisiä tekoälymalleja koskevat velvoitteet ovat ennallaan. Se mikä siirtyi, on nimenomaan korkean riskin luokitusvaatimukset — painavin vaatimustenmukaisuuden taakka, kapeimmalle järjestelmäjoukolle. Jos agenttisi keskustelee käyttäjien kanssa tai tuottaa sisältöä, olet sen lain osan sisällä, joka on jo voimassa.
Läpinäkyvyysvaatimus kuulostaa vaatimattomalta “korkean riskin järjestelmän” rinnalla, mutta se on se sääntö, johon useimmat tekoälyagenttien rakentajat todella törmäävät ensimmäisenä. Asiakaspalveluagentti, sisällöntuotannon työnkulku, ääniassistentti — kaikki nämä ovat järjestelmiä, jotka puhuvat ihmisille, mikä tarkoittaa, että artikla 50 koskee niitä riippumatta siitä, luokiteltaisiinko ne koskaan korkean riskin järjestelmiksi. Tämän tekeminen oikein ei ole monimutkaista: kerro selkeästi, että käyttäjä puhuu tekoälylle, merkitse tuotettu sisältö ja pidä kirjaa siitä, että teit niin. Sen tekeminen väärin on sitä, kun vaatimustenmukaisuusraportointi lakkaa olemasta paperityötä ja muuttuu juridiseksi riskiksi, johon liittyy todellinen lukema.
Saa uusimmat vinkit, trendit ja tarjoukset ilmaiseksi.
Google Cloudin vastaus samaan taustalla olevaan ongelmaan tuli täysin eri suunnasta: infrastruktuurista, ei laista. Yhtiö toi Gemini Enterprise Agent -alustansa yleiseen saatavuuteen uuden agenttien hallinnan peruskomponenttien klusterin — Agent Memory Bank, Agent Runtime, Agent Gateway, Agent Registry, Agent Evaluation ja ennen kaikkea Agent Identity.
Agent Identity on natiivi IAM-käyttöoikeustyyppi, joka on rakennettu avoimille standardeille ja suunniteltu erityisesti autonomisille järjestelmille eikä mukautettu ihmiskäyttäjätileistä. Se valvoo vähimpien oikeuksien periaatetta sitomalla käyttöoikeudet suoraan agentin suoritusympäristöön, mikä sulkee pois yleisen hyökkäysreitin, jossa varastettu agenttitunnus voitaisiin toistaa muualla. Se tuottaa kiistämättömiä lokeja jokaisesta agentin toimesta. Ja se hallinnoi käyttöoikeuksien elinkaarta automaattisesti, joten käytöstä poistettu agentti ei jätä jälkeensä käyttämättömiä, unohdettuja käyttöoikeuksia odottamaan väärinkäyttöä.
Käytännön vaikutus on, että “mikä agentti teki tämän, ja oliko se sallittua?” muuttuu kysymykseksi, johon on lopullinen vastaus, sen sijaan että se olisi arvaus, joka rekonstruoidaan sovelluslokeista jälkikäteen. Tällä on enemmän merkitystä, kun agentit siirtyvät kysymyksiin vastaamisesta toimien suorittamiseen — varaamiseen, tietojen muokkaamiseen, rahan siirtämiseen, tiedostojen poistamiseen. LLM-turvallisuus-käytäntö, joka huolehtii vain mallin kohdistuvista kehoteinjektioista, jättää huomiotta koko tämän pinnan: agentin todelliset käyttöoikeudet ja sen, mitä se niillä teki.
Tässä kohtaa nämä kaksi ilmoitusta myös liittyvät toisiinsa enemmän kuin ensi silmäyksellä näyttää. Artikla 50 kysyy “ilmoititko, että tämä oli tekoälyä?” Agent Identity vastaa samankaltaiseen mutta erilliseen kysymykseen: “voitko todistaa tarkalleen, mitä tämä tietty agentti teki, millä käyttöoikeuksilla, kenen valtuutuksella?” Järjestelmä, joka pystyy vastaamaan toiseen kysymykseen puhtaasti, löytää ensimmäisen paljon helpommaksi.
On syytä nimetä kaava suoraan, koska se tulee toistumaan. Sääntelyviranomaiset lähestyvät läpinäkyvyyttä ja vastuullisuutta juridisesta riskinäkökulmasta. Pilvialustat lähestyvät identiteettiä ja käyttöoikeuksia turvallisuus- ja luotettavuusnäkökulmasta. Tekoälyagenttikehykset kohtelivat aiemmin identiteettiä jälkikäteisajatuksena — API-avainta ympäristömuuttujassa, jaettuna jokaiselle agentille koko infrastruktuurissa. Tämä malli ei kestä kosketusta sääntelyvalvonnan tai todellisen tietoturvaloukkauksen kanssa, mikä on juuri syy siihen, miksi molemmat suunnat osoittavat nyt samaan korjaukseen: tiedä mikä agentti teki mitä, millä käyttöoikeuksilla, ja pysty näyttämään se.
Tiimit, jotka ovat jo kokeilleet todellisia esimerkkejä tekoälyagenteista — asiakaspalvelubotteja, tutkimusassistentteja, koodausagentteja — tuntevat tämän muutoksen ensimmäisinä, yksinkertaisesti siksi, että heillä on enemmän agentteja tuotannossa, jotka tuottavat enemmän toimia, joista on vastattava. Kyse on samasta kaavasta, jonka näimme kun Claude Cowork ja sen kilpailijat työnsivät agentit yksittäisistä keskusteluista pysyviin, monipäiväisiin tehtäviin: enemmän autonomiaa saapuu aina askeleen edellä työkaluja, joilla sitä hallitaan.
Auditointijälkien lisääminen jälkikäteen agenttijoukkoon, jota ei koskaan suunniteltu tuottamaan niitä, on kurja projekti — jokainen toiminto on rekonstruoitava niistä lokeista, joita sattui olemaan, ja puolessa tapauksista niitä ei ole. Halvempi tie on rakentaa työkaluilla, joissa jokainen agentin askel on näkyvä ja jäljitettävä alusta alkaen, samalla tavalla kuin tietohallinto käsittelee tietojen alkuperää ensiluokkaisena asiana eikä jälkikäteen kiinnitettävänä lisäyksenä tietomurron jälkeen.
Tässä kohtaa myös taustalla olevien mallien kehitysvauhti on merkityksellistä. Viimeaikaiset julkaisut, kuten Microsoftin Orchard-kehys, ja laajempi suuntaus kohti erikoistuneita, auditoitavia agentteja (yhden valtavan yleiskäyttöisen mallin sijaan, joka tekee kaiken) tekevät käytännöllisemmäksi rakentaa agentteja, joiden toiminta-ala — ja siten myös käyttöoikeudet — ovat kapeat ja hyvin määritellyt suunnittelun tasolla. Kapea-alainen agentti on luonnostaan helpompi hallita kuin sellainen, joka voi teoriassa tehdä mitä tahansa.
FlowHuntin lähestymistapa noudattaa samaa logiikkaa: tekoälyagenttialustana jokainen automaatio on näkyvä työnkulku, ei musta laatikko, joten kun vaatimustenmukaisuuskysymys tulee — mitä tämä agentti teki, miksi ja millä valtuutuksella — vastaus on jo työnkulussa, eikä tiimisi tarvitse rekonstruoida sitä aikapaineen alla.
EU:n tekoälysäädöksen läpinäkyvyyssäännöt ja Googlen Agent Identity -järjestelmä eivät koordinoineet keskenään, ja ne ratkaisevat nimellisesti eri ongelmia — toinen on lainsäädännön noudattamista, toinen pilvi-infrastruktuuria. Mutta ne saapuivat samalla viikolla osoittaen samaa taustalla olevaa totuutta: kun tekoälyagentit ottavat hoitaakseen yhä autonomisempia ja merkittävämpiä tehtäviä, “emme oikeastaan tiedä, mitä se teki” lakkaa olemasta hyväksyttävä vastaus, olipa kysyjä sääntelyviranomainen tai oma tietoturvatiimisi. Ne tiimit, jotka käsittelevät identiteettiä, läpinäkyvyyttä ja auditoitavuutta ydintoimintoina nyt — eivät ominaisuuksina, jotka lisätään myöhemmin — ovat niitä, jotka kokevat sekä vaatimustenmukaisuuden että tuotantoon liittyvät tapahtumat huomattavasti vähemmän kivuliaiksi, kun ne ilmaantuvat.
Arshia on AI-työnkulkuinsinööri FlowHuntilla. Tietojenkäsittelytieteen taustalla ja intohimolla tekoälyyn hän erikoistuu luomaan tehokkaita työnkulkuja, jotka integroivat tekoälytyökaluja arjen tehtäviin, parantaen tuottavuutta ja luovuutta.

FlowHunt antaa jokaiselle automaatiolle näkyvän, muokattavan työnkulun — joten kun joku kysyy, mitä agenttisi teki ja miksi, sinulla on vastaus, ei musta laatikko.
Tutustu EU:n tekoälyasetukseen – maailman ensimmäiseen kattavaan tekoälysääntelyyn. Opi, miten se luokittelee tekoälyjärjestelmät riskin mukaan, luo hallintorak...
Tutustu keskeisiin tekoälykäytäntöihin, jotka EU:n tekoälyasetus kieltää, kuten sosiaalisen pisteytyksen, manipuloivan tekoälyn, reaaliaikaisen biometrisen tunn...
Tutustu, miten Euroopan tekoälyasetus vaikuttaa chatbotteihin: riskiluokittelut, vaatimukset, määräajat ja seuraamukset varmistavat eettiset, läpinäkyvät ja tur...
Evästeiden Suostumus
Käytämme evästeitä parantaaksemme selauskokemustasi ja analysoidaksemme liikennettämme. See our privacy policy.