


AI-lagen
Utforska EU:s AI-lag, världens första omfattande AI-reglering. Lär dig hur den klassificerar AI-system efter risk, etablerar styrning och sätter globala standar...
10 min läsning
AI Act
EU Regulation
+4
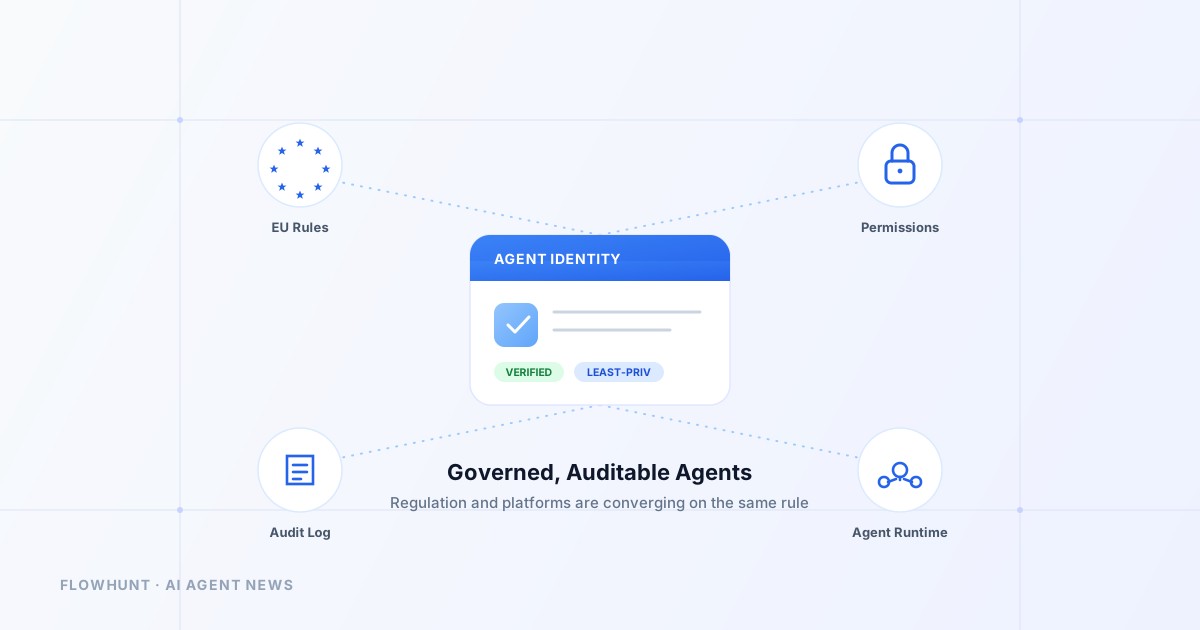
EU:s AI-lags transparensregler är nu verkställbara, och Google Cloud lanserade ett inbyggt Agent Identity-system. Här är vad som förändrades för team som bygger AI-agenter.
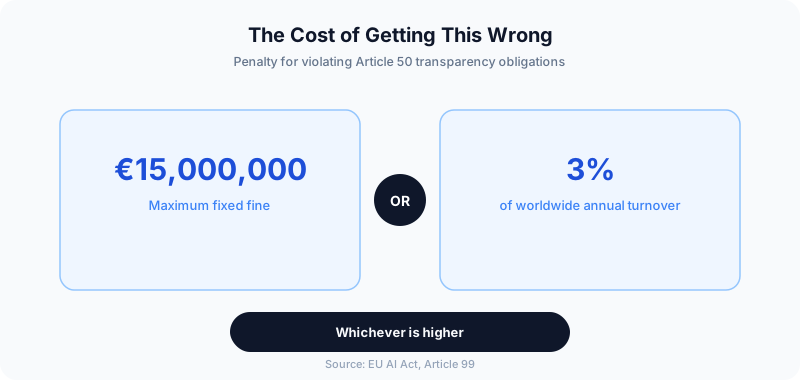
Två tillkännagivanden från första veckan i augusti 2026 pekar på samma förändring, från motsatta håll. Den 2 augusti blev EU:s AI-lags transparensregler verkställbar lag, vilket kräver att alla som distribuerar en chattbot, innehållsgenerator eller känsloavläsande system måste upplysa om detta tydligt eller riskera böter på upp till 15 miljoner euro. Några dagar senare lanserade Google Cloud sitt Agent Identity-system till allmän tillgänglighet – ett inbyggt behörighetsskikt som spårar exakt vad en AI-agent har åtkomst till och loggar allt den gör. Det ena är en regulator som tvingar fram transparens. Det andra är en molnplattform som säljer ansvarsskyldighet som en funktion. Båda konvergerar mot samma slutsats: en AI-agent som ingen kan identifiera, granska eller hålla ansvarig är inte redo för produktion, oavsett om en domstol säger det eller inte.
EU:s AI-lags artikel 50 om transparensskyldigheter blev allmänt tillämplig och verkställbar av nationella myndigheter inom hela EU den 2 augusti 2026. I praktiken omfattar detta fyra saker. Leverantörer måste säkerställa att människor “tydligt informeras om att de har att göra med ett AI-system, om inte detta framgår av sammanhanget” – chattbots-regeln. Leverantörer av system som genererar syntetiskt ljud, bild, video eller text måste märka denna utdata i ett maskinläsbart, detekterbart format. Den som distribuerar ett system som producerar deepfakes av verkliga personer, platser eller händelser måste avslöja detta. Och de som distribuerar system för känsloigenkänning eller biometrisk kategorisering måste informera de personer som exponeras för dem och hålla sig inom EU:s dataskyddslagstiftning.
Inget av detta är nytt i konceptet – AI-lagen undertecknades år tidigare. Vad som förändrades den 2 augusti är att dessa specifika skyldigheter upphörde att vara ett framtida datum på en efterlevnadsplan och blev något som nationella regulatorer faktiskt kan verkställa redan idag.

Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Allt i lagen kom inte i tid. Genom Digital Omnibus on AI, som undertecknades den 8 juli 2026, sköt EU upp sina krav för högrisksystem. Fristående system enligt bilaga III – tänk anställningsscreening, utbildning, brottsbekämpning, kritisk infrastruktur – har nu till den 2 december 2027 på sig. AI inbäddad i redan reglerade produkter enligt bilaga I, som medicintekniska produkter eller hissar, har till den 2 augusti 2028 på sig.
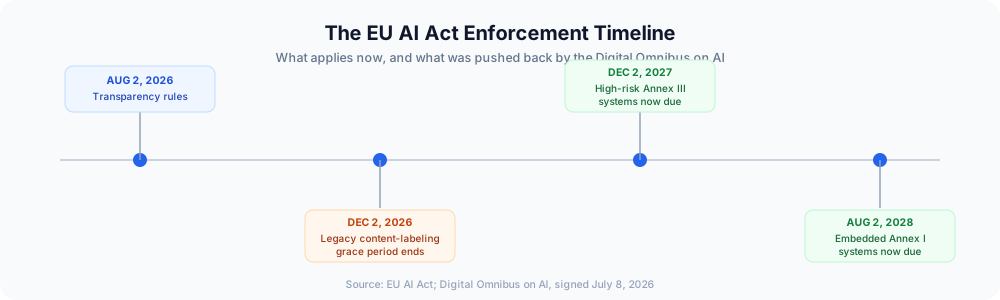
Den förlängningen är värd att vara precis om, eftersom den lätt kan misstolkas som “AI-lagen blev försenad.” Det blev den inte. Listan över förbjudna metoder och skyldigheterna för AI-modeller med allmänt ändamål är opåverkade. Det som flyttades är specifikt klassificeringskraven för hög risk – den tyngsta efterlevnadsbördan, för den smalaste delen av systemen. Om din agent pratar med användare eller genererar innehåll, befinner du dig i den del av lagen som redan är aktiv.
Transparenskravet låter blygsamt i jämförelse med “högrisksystem”, men det är den regel som de flesta AI-agentbyggare faktiskt kommer att stöta på först. En kundvänd supportagent, ett innehållsgenereringsarbetsflöde, en röstassistent – alla dessa är system som pratar med människor, vilket innebär att artikel 50 gäller oavsett om de någonsin skulle klassificeras som högrisk. Att göra rätt är inte komplicerat: säg tydligt att användaren pratar med en AI, märk genererat innehåll och behåll register som visar att du gjort det. Att göra fel är där efterlevnadsrapportering upphör att vara pappersarbete och blir en juridisk exponering med ett reellt belopp kopplat till sig.
Få de senaste tipsen, trenderna och erbjudandena gratis.
Google Cloud’s svar på samma underliggande problem kom från en helt annan riktning: infrastruktur, inte lag. Företaget lanserade sin Gemini Enterprise Agent Platform till allmän tillgänglighet med ett kluster av nya agentstyrningsprimitiver – Agent Memory Bank, Agent Runtime, Agent Gateway, Agent Registry, Agent Evaluation och, mest anmärkningsvärt, Agent Identity.
Agent Identity är en inbyggd IAM-legitimationstyp byggd på öppna standarder, specifikt utformad för autonoma system snarare än anpassad från mänskliga användarkonton. Den tillämpar minsta behörighet genom att binda rättigheter direkt till agentens körningsmiljö, vilket stänger en vanlig attackväg där en stulen agenttoken skulle kunna återanvändas någon annanstans. Den producerar oavvisliga loggar över varje åtgärd en agent vidtar. Och den hanterar behörigheternas livscykel automatiskt, så att en agent som har avvecklats inte lämnar kvar en inaktiv, bortglömd uppsättning rättigheter som väntar på att missbrukas.
Den praktiska effekten är att “vilken agent gjorde detta, och var den tillåten?” blir en fråga med ett definitivt svar istället för en gissning rekonstruerad från applikationsloggar i efterhand. Det spelar större roll när agenter går från att svara på frågor till att vidta åtgärder – boka saker, redigera poster, flytta pengar, ta bort filer. En LLM-säkerhet som bara oroar sig för promptinjektion i själva modellen missar hela denna yta: agentens faktiska behörigheter och vad den gjorde med dem.
Det är också här de två tillkännagivandena hänger ihop mer än de först verkar. Artikel 50 frågar “avslöjade du att detta var AI?” Agent Identity svarar på en relaterad men distinkt fråga: “kan du bevisa exakt vad denna specifika agent gjorde, med vilka behörigheter, på vems auktoritet?” Ett system som kan svara på den andra frågan rent finner den första mycket lättare.
Det är värt att namnge mönstret direkt, eftersom det kommer att fortsätta återkomma. Regulatorer konvergerar mot transparens och ansvarsskyldighet ur en juridisk riskvinkel. Molnplattformar konvergerar mot identitet och behörigheter ur en säkerhets- och tillförlitlighetsvinkel. AI-agentramverk brukade behandla identitet som en eftertanke – en API-nyckel i en miljövariabel, delad över alla agenter i flottan. Den modellen överlever inte kontakt med varken regulatorisk granskning eller en verklig säkerhetsincident, vilket är exakt varför båda riktningarna nu pekar på samma lösning: vet vilken agent som gjorde vad, med vilken åtkomst, och kunna visa det.
Team som redan har experimenterat med verkliga AI-agentexempel – kundsupportrobotar, forskningsassistenter, kodningsagenter – är de som kommer att känna av denna förändring först, helt enkelt för att de har fler agenter i produktion som genererar fler åtgärder att redovisa. Det är samma mönster vi såg när Claude Cowork och dess konkurrenter flyttade agenter från engångschatt till beständiga, flerdagarsuppgifter: mer autonomi kommer alltid ett steg före verktygen för att styra den.
Att eftermontera granskningskedjor på en agentflotta som aldrig designades för att producera dem är ett miserabelt projekt – varje åtgärd måste rekonstrueras från de loggar som råkade finnas, och hälften av gångerna finns de inte. Den billigare vägen är att bygga på verktyg där varje steg en agent tar är synligt och spårbart från början, på samma sätt som datastyrning behandlar dataledning som en förstklassig angelägenhet snarare än något du eftermonterar efter ett intrång.
Det är också här takten på de underliggande modellerna spelar roll. Nya lanseringar som Microsofts Orchard-ramverk och den bredare förskjutningen mot specialiserade, granskningsbara agenter (snarare än en enda enorm generell modell som gör allt) gör det mer praktiskt att bygga agenter vars omfattning – och därmed deras behörigheter – är smala och väldefinierade av design. En snävt avgränsad agent är i sig lättare att styra än en som teoretiskt kan göra vad som helst.
FlowHunt’s tillvägagångssätt följer samma logik: som en AI-agentplattform är varje automation ett synligt flöde, inte en svart låda, så när en efterlevnadsfråga kommer in – vad gjorde denna agent, varför och under vilken auktorisation – finns svaret redan i arbetsflödet, inte något som ditt team måste rekonstruera under deadlinepress.
EU:s AI-lags transparensregler och Googles Agent Identity-system samordnade sig inte med varandra, och de löser nominellt olika problem – det ena är juridisk efterlevnad, det andra är molninfrastruktur. Men de landade samma vecka och pekade på samma underliggande sanning: när AI-agenter tar sig an mer autonomt och konsekvensrikt arbete, upphör “vi vet egentligen inte vad den gjorde” att vara ett acceptabelt svar, oavsett om den som frågar är en regulator eller ditt eget säkerhetsteam. De team som behandlar identitet, transparens och granskningsbarhet som kärnkrav nu – inte funktioner att lägga till senare – är de som kommer att finna både efterlevnad och produktionsincidenter långt mindre smärtsamma när de dyker upp.
Arshia är en AI-arbetsflödesingenjör på FlowHunt. Med en bakgrund inom datavetenskap och en passion för AI, specialiserar han sig på att skapa effektiva arbetsflöden som integrerar AI-verktyg i vardagliga uppgifter, vilket förbättrar produktivitet och kreativitet.

FlowHunt ger varje automation ett synligt, redigerbart flöde – så att när någon frågar vad din agent gjorde och varför, har du ett svar, inte en svart låda.
Utforska EU:s AI-lag, världens första omfattande AI-reglering. Lär dig hur den klassificerar AI-system efter risk, etablerar styrning och sätter globala standar...
Upptäck hur den europeiska AI-förordningen påverkar chatbottar, med riskklassificeringar, krav på efterlevnad, tidsfrister och sanktioner för att säkerställa et...
Utforska de viktigaste AI-metoderna som förbjuds av EU:s AI-förordning, inklusive förbud mot social poängsättning, manipulativ AI, realtids biometrisk identifie...
Cookie-samtycke
Vi använder cookies för att förbättra din surfupplevelse och analysera vår trafik. See our privacy policy.