


AI-loven
Utforsk EUs AI-lov, verdens første omfattende regulering av kunstig intelligens. Lær hvordan den klassifiserer AI-systemer etter risiko, etablerer styringsstruk...
10 min lesing
AI Act
EU Regulation
+4
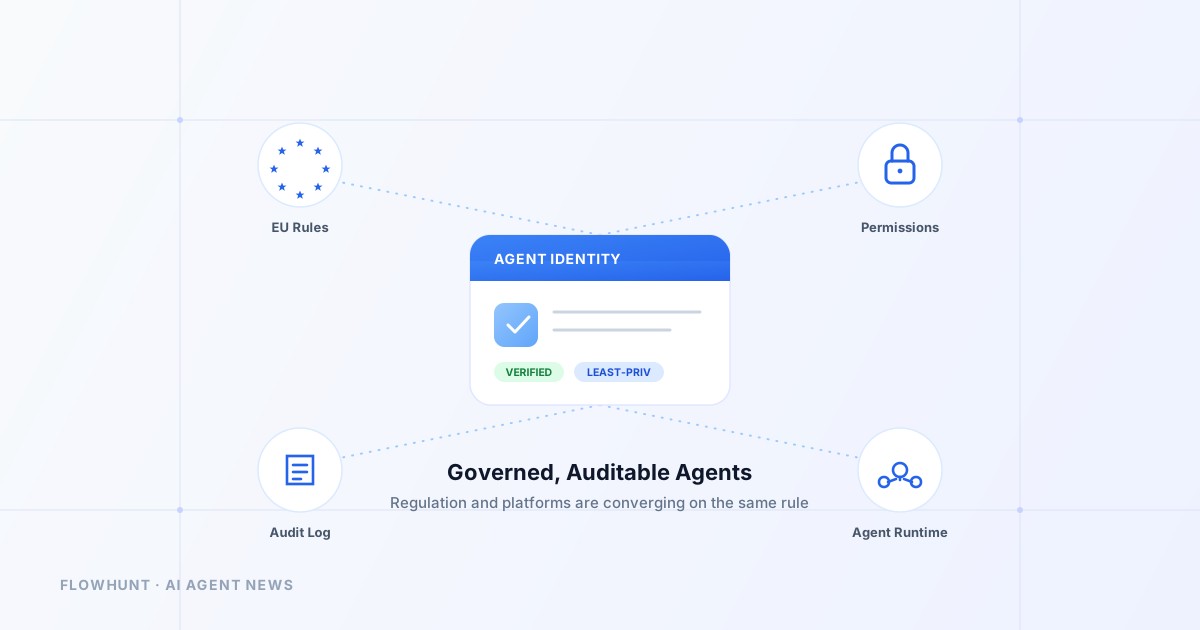
EUs KI-forordnings åpenhetsregler er nå håndhevbare, og Google Cloud har lansert et innebygd Agent Identity-system. Her er hva som endret seg for team som bygger KI-agenter.
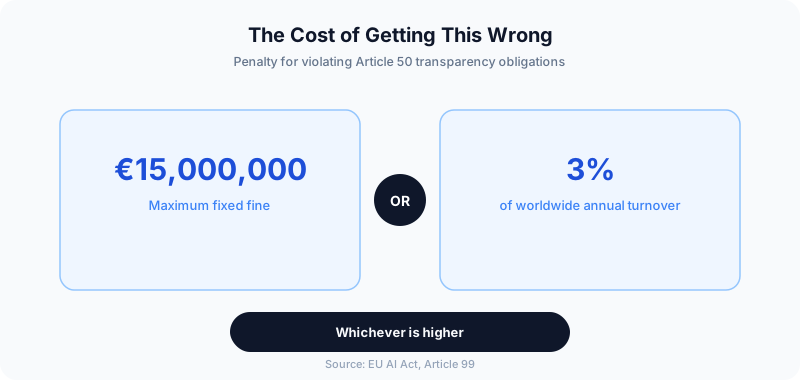
To kunngjøringer fra den første uken i august 2026 peker på det samme skiftet, fra motsatte retninger. 2. august ble EUs KI-forordnings åpenhetsregler håndhevbar lov, som krever at alle som distribuerer en chatbot, innholdsgenerator eller følelsesavlesende system, må opplyse om dette tydelig eller risikere bøter på opptil 15 millioner euro. Dager senere lanserte Google Cloud sitt Agent Identity-system til generell tilgjengelighet – et innebygd tillatelseslag som sporer nøyaktig hva en KI-agent har tilgang til og logger alt den gjør. Den ene er en regulator som tvinger frem åpenhet. Den andre er en skytjeneste som selger ansvarlighet som en funksjon. Begge konvergerer mot samme konklusjon: en KI-agent som ingen kan identifisere, revidere eller holde ansvarlig, er ikke klar for produksjon, uansett om en domstol sier det eller ikke.
EUs KI-forordnings artikkel 50 om åpenhetsforpliktelser ble generelt gjeldende og håndhevbare av nasjonale myndigheter over hele EU 2. august 2026. I praksis dekker dette fire ting. Leverandører må sikre at folk blir «tydelig informert om at de samhandler med et KI-system, med mindre dette er åpenbart ut fra konteksten» – chatbot-opplysningsregelen. Leverandører av systemer som genererer syntetisk lyd, bilde, video eller tekst, må merke dette resultatet i et maskinlesbart, detekterbart format. Den som distribuerer et system som produserer deepfakes av virkelige personer, steder eller hendelser, må opplyse om dette. Og distributører av systemer for følelsesgjenkjenning eller biometrisk kategorisering må informere personene som utsettes for dem, og holde seg innenfor EUs databeskyttelseslovgivning.
Ingenting av dette er nytt i konsept – KI-forordningen ble signert år tidligere. Det som endret seg 2. august, er at disse spesifikke pliktene sluttet å være en fremtidig dato på en etterlevelsesplan og ble noe nasjonale regulatorer faktisk kan håndheve i dag.

Start din gratis prøveperiode i dag og se resultater i løpet av få dager.
Ikke alt i forordningen kom i rute. Gjennom Digital Omnibus on AI, signert 8. juli 2026, utsatte EU kravene til høyrisikosystemer. Frittstående systemer under vedlegg III – tenk ansettelsesscreening, utdanning, rettshåndhevelse, kritisk infrastruktur – har nå frist til 2. desember 2027. KI innebygd i allerede regulerte produkter under vedlegg I, som medisinsk utstyr eller heiser, har frist til 2. august 2028.
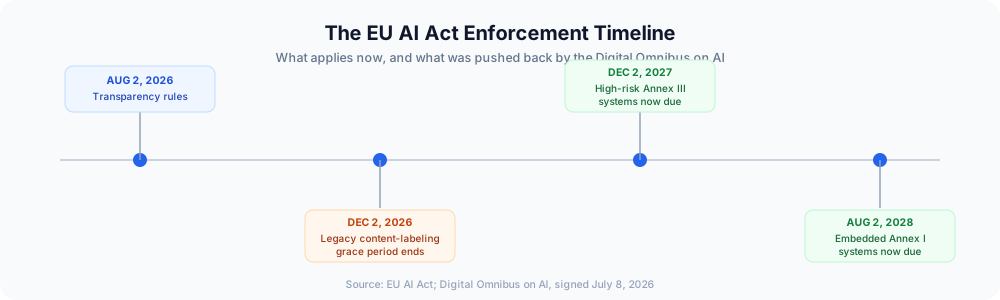
Den utsettelsen er verdt å være presis om, fordi den lett kan misforstås som «KI-forordningen ble utsatt». Det ble den ikke. Listen over forbudt praksis og forpliktelsene for generelle KI-modeller er urørt. Det som ble flyttet, er spesifikt klassifiseringskravene for høyrisikosystemer – den tyngste etterlevelsesbyrden, for den smaleste gruppen av systemer. Hvis agenten din snakker med brukere eller genererer innhold, er du inne i den delen av loven som allerede er aktiv.
Åpenhetskravet høres beskjedent ut sammenlignet med «høyrisikosystem», men det er regelen de fleste KI-agentbyggere faktisk vil møte først. En kundevendt støtteagent, en innholdsgenereringsarbeidsflyt, en talassistent – alle disse er systemer som snakker med mennesker, noe som betyr at artikkel 50 gjelder uavhengig av om de noen gang ville blitt klassifisert som høyrisiko. Å gjøre dette riktig er ikke komplisert: si tydelig at brukeren snakker med en KI, merk generert innhold, og behold journaler som viser at du gjorde det. Å gjøre det galt er der etterlevelsesrapportering slutter å være papirarbeid og begynner å være en juridisk eksponering med et reelt tall vedlagt.
Få de siste tipsene, trendene og tilbudene gratis.
Google Clouds svar på det samme underliggende problemet kom fra en helt annen retning: infrastruktur, ikke lov. Selskapet lanserte sitt Gemini Enterprise Agent Platform til generell tilgjengelighet med en klynge nye agentstyringsprimitiver – Agent Memory Bank, Agent Runtime, Agent Gateway, Agent Registry, Agent Evaluation, og mest bemerkelsesverdig, Agent Identity.
Agent Identity er en innebygd IAM-legitimasjonstype bygget på åpne standarder, designet spesifikt for autonome systemer snarere enn tilpasset fra menneskelige brukerkontoer. Den håndhever minsterettighetsprinsippet ved å binde tillatelser direkte til agentens kjøretid, noe som stenger en vanlig angrepsvei der et stjålet agent-token kunne blitt spilt av et annet sted. Den produserer ubestridelige logger av hver handling en agent utfører. Og den håndterer legitimasjonens livssyklus automatisk, slik at en agent som er pensjonert ikke etterlater seg et sovende, glemt sett med tillatelser som venter på å bli misbrukt.
Den praktiske effekten er at «hvilken agent gjorde dette, og hadde den lov til det?» blir et spørsmål med et definitivt svar i stedet for en gjetning rekonstruert fra applikasjonslogger i etterkant. Det betyr mer ettersom agenter går fra å svare på spørsmål til å utføre handlinger – bestille ting, redigere journaler, flytte penger, slette filer. En LLM-sikkerhet som bare bekymrer seg for prompt-injisering i selve modellen, går glipp av hele denne flaten: agentens faktiske tillatelser og hva den gjorde med dem.
Dette er også der de to kunngjøringene henger sammen mer enn de først ser ut til. Artikkel 50 spør «opplyste du om at dette var KI?» Agent Identity svarer på et beslektet, men distinkt spørsmål: «kan du bevise nøyaktig hva denne spesifikke agenten gjorde, med hvilke tillatelser, og på hvis autoritet?» Et system som kan svare godt på det andre spørsmålet, finner det første mye lettere.
Det er verdt å navngi mønsteret direkte, fordi det kommer til å gjenta seg. Regulatorer konvergerer mot åpenhet og ansvarlighet fra en juridisk risikovinkel. Skytjenester konvergerer mot identitet og tillatelser fra en sikkerhets- og pålitelighetsvinkel. Rammeverk for KI-agenter pleide å behandle identitet som en ettertanke – en API-nøkkel i en miljøvariabel, delt på tvers av alle agenter i flåten. Den modellen overlever ikke kontakt med verken regulatorisk gransking eller en reell sikkerhetshendelse, noe som er nettopp grunnen til at begge retninger nå peker på samme løsning: vet hvilken agent som gjorde hva, med hvilken tilgang, og vær i stand til å vise det.
Team som allerede har eksperimentert med virkelighetseksempler på KI-agenter – kundestøtteboter, forskningsassistenter, kodeagenter – er de som vil merke dette skiftet først, rett og slett fordi de har flere agenter i produksjon som genererer flere handlinger å gjøre rede for. Det er samme mønster vi så da Claude Cowork og konkurrentene presset agenter fra engangschat til vedvarende, flerdagers oppgaver: mer autonomi kommer alltid et steg foran verktøyene for å styre det.
Å ettermontere revisjonsspor på en agentflåte som aldri ble designet for å produsere dem, er et elendig prosjekt – hver handling må rekonstrueres fra de loggene som tilfeldigvis eksisterte, og halvparten av tiden finnes de ikke. Den billigere veien er å bygge på verktøy der hvert steg en agent tar er synlig og sporbart fra starten, på samme måte som datastyring behandler datalinje som en førsteklasses bekymring snarere enn noe du ettermonterer etter et brudd.
Dette er også der tempoet i de underliggende modellene har betydning. Nyere utgivelser som Microsofts Orchard-rammeverk og det bredere skiftet mot spesialiserte, revisjonsbare agenter (i stedet for én enorm generell modell som gjør alt) gjør det mer praktisk å bygge agenter hvis omfang – og dermed tillatelser – er smale og veldefinerte av design. En smalt avgrenset agent er iboende lettere å styre enn en som teoretisk kan gjøre hva som helst.
FlowHunts tilnærming følger samme logikk: som en KI-agentplattform er hver automatisering en synlig flyt, ikke en svart boks, så når et etterlevelsesspørsmål kommer inn – hva gjorde denne agenten, hvorfor, og under hvilken autorisasjon – ligger svaret allerede i arbeidsflyten, ikke noe teamet ditt må rekonstruere under tidspress.
EUs KI-forordnings åpenhetsregler og Googles Agent Identity-system koordinerte ikke med hverandre, og de løser tilsynelatende ulike problemer – det ene er juridisk etterlevelse, det andre er skyinfrastruktur. Men de landet i samme uke og pekte på den samme underliggende sannheten: etter hvert som KI-agenter tar på seg mer autonomt og konsekvensfylt arbeid, slutter «vi vet egentlig ikke hva den gjorde» å være et akseptabelt svar, uansett om personen som spør er en regulator eller ditt eget sikkerhetsteam. Teamene som behandler identitet, åpenhet og revisjonsdyktighet som kjernkrav nå – ikke funksjoner som skal legges til senere – er de som vil finne både etterlevelse og produksjonshendelser langt mindre smertefulle når de dukker opp.
Arshia er en AI Workflow Engineer hos FlowHunt. Med bakgrunn i informatikk og en lidenskap for kunstig intelligens, spesialiserer han seg på å lage effektive arbeidsflyter som integrerer AI-verktøy i daglige oppgaver, og dermed øker produktivitet og kreativitet.

FlowHunt gir hver automatisering en synlig, redigerbar flyt – så når noen spør hva agenten din gjorde og hvorfor, har du et svar, ikke en svart boks.
Utforsk EUs AI-lov, verdens første omfattende regulering av kunstig intelligens. Lær hvordan den klassifiserer AI-systemer etter risiko, etablerer styringsstruk...
Oppdag hvordan den europeiske AI-forordningen påvirker chatboter, med detaljer om risikoklassifiseringer, krav til etterlevelse, tidsfrister og sanksjoner for m...
Utforsk de viktigste AI-praksisene som er forbudt av EUs AI-forordning, inkludert forbud mot sosial poenggiving, manipulerende AI, sanntids biometrisk identifik...
Informasjonskapselsamtykke
Vi bruker informasjonskapsler for å forbedre din surfeopplevelse og analysere vår trafikk. See our privacy policy.