


SEOのためのAIコンテンツ検出は、今のコンテンツマーケティングにおいて最も誤解されているトピックのひとつです。GoogleがあらゆるAI執筆コンテンツを一律にペナルティしていると主張する人も多くいます。しかし、この恐れは実際に起きていることの誤読に基づいています。
GoogleはコンテンツがAIによって生成されたという理由でペナルティを与えるのではありません。低品質であること、トピックとの関連性が低いこと、役に立たないこと、内容が薄いことに対してペナルティを与えるのです。ここでは、証拠が実際に示していること、どのAIパターンがエンゲージメントと品質シグナルを引き起こすのか、そして上位表示されるAI支援コンテンツの作り方を見ていきます。
Googleが2026年のAIコンテンツについて実際に述べていること
Googleの公式ドキュメント には、「Googleのランキングシステムは、私たちがE-E-A-Tと呼ぶ性質——専門性(Expertise)、経験(Experience)、権威性(Authoritativeness)、信頼性(Trustworthiness)——を示す、独自性の高い高品質なコンテンツを評価することを目的としています。私たちのシステムはコンテンツの品質を評価するのであって、コンテンツがAIによって生成されたかどうかを評価するのではありません」と記されています。
AIコンテンツを明確に対象としているポリシーはGoogleのスパムポリシーで、そこでは「検索ランキングを操作することを目的とした自動生成コンテンツ」が扱われています。問題なのは「操作することを目的とした」という部分であり、「AIによって生成された」ではありません。
言い換えれば、ペナルティを受けるのは、クエリに答えたり——まさかとは思いますが——実際に独自の洞察や娯楽的価値を提供したりするのではなく、キーワードを稼ぐことだけに集中した、曖昧で大量生産されたコンテンツです。一方で、あなた自身のデータ、洞察、声を使ったAI生成記事は、あなたのこれまでで最も上位表示される記事に容易になり得ます。
だからこそ、2026年におけるAIライティングのSEOインパクトは、AI生成コンテンツそのものではなく、Googleが昔から重視してきた品質指標で失敗しがちだという点にあります。そして最も重要なのは、その理由が予測可能で修正可能だということです。以下でその方法を説明します。
AIコンテンツ検出ツールの仕組み(とその精度)
他の小さな特性に加えて、AI検出ツールは主に2つの統計的特性に依存しています。1つ目は**パープレキシティ(困惑度)です。これは、それ以前の文脈を踏まえて各語の選択がどれだけ予測可能かを示します。言語モデルは非常に予測可能な系列を生成しますが、人間の書き手はより頻繁に予想外の選択をします。2つ目はバースティネス(バースト性)**で、文と文の間にどれだけ変動があるかを表します。AIの出力は文の長さと構造が均一になりがちで、人間の文章はかなり変化に富みます。また、よくあるAI的なフレーズや文体上の選択、その他の特性もチェックします。
これらの特性は、GPTZeroやTurnitinといった検出ツールが測定する識別可能な統計的指紋を作り出します。未編集の生のAI出力に対しては、これらのツールはかなり信頼できます。しかし、ヒューマナイズ・編集・人間によるレビューを経たコンテンツに対しては、誤検知率がはるかに高くなります。
Googleはランキング判断にこうしたAI検出ツールを使っていないことを覚えておいてください。代わりに、コンテンツの出所に関係なく、独自の品質シグナルを使っています。エンゲージメント指標、E-E-A-T評価、コンテンツの深さ、トピック上の権威性をチェックしているのです。
結論として、あらゆるAI検出ツールを通過したページが品質ペナルティを免れるわけではなく、すべての検出ツールで不合格になったページがその理由だけでペナルティを受けるわけでもありません。
AIコンテンツを凡庸で低品質にするパターン
Googleのシステムが実際に評価しているのは、コンテンツが競合ページよりも検索者の意図をよく満たしているかどうかです。このテストで最も一貫して失敗する具体的なAIライティングのパターンは次のとおりです。
- 一次体験や視点がない。 AIは要約はできても、取材はできません。「多くの専門家はこう考えている」と述べるだけで、具体的な専門知識や数値、引用、一人称の知見を示さないコンテンツは、E-E-A-Tの「経験」要素で失敗します。
- 独自データや独自の洞察がない。 記事のすべての文がWikipediaの要約と既存のブログ記事数本から書けてしまうなら、それは何も付加していません。Googleのシステムは、あるページが新しい何かを提供しているかどうかを識別する能力を高めています。
- 事実誤認とハルシネーション。 AIモデルは、もっともらしく聞こえるが時に誤っている情報を生成します。事実が誤っているのに自信に満ちて流暢な記事は、品質シグナルの失敗であり、読者の信頼の失敗でもあります。
- クエリ意図への浅い対応。 「メタディスクリプションの書き方」についてのAI記事が、文字数制限やクリック率への影響、よくある間違いに触れていなければ、どう書かれたかに関係なく内容が薄いと言えます。
- 定型的な書き出しと凡庸な言い回し。 「今日のデジタル環境では」「〜であることに注意することが重要です」「AIの台頭に伴い…」といったフレーズはAIスロップの代名詞となり、読者(そしてエンゲージメント指標)に対して、そのページは注意深く読む価値がないと即座に示してしまいます。
Googleのランキングは品質シグナルであり、それ自体はAIよりずっと前から存在していたことを忘れないでください。AIは、それらのシグナルで失敗するコンテンツを大規模に作りやすくしただけです。
AI支援ライティングにとって「役立つコンテンツ」とは何か
GoogleのHelpful Content Systemは、コンテンツが「主に検索エンジンのために」ではなく「主に人のために」作られたかどうかを評価します。AI支援コンテンツの場合、その違いは人間のレイヤーが何を付加するかにかかっています。
役立つAI支援コンテンツを凡庸なAI出力と分ける品質の要素は次のとおりです。
- 独自の事例とケーススタディ。 「200人のユーザーでテストしたところ、〜が分かった」は、「多くのユーザーが報告している」にはない重みを持ちます。
- 専門用語の正しい使用。 キーワードの配置ではなく、その主題を本当に理解している人だと示す、正確で的確な言葉づかいです。
- 更新・検証されたデータ。 2026年に2023年の研究を引用することは品質上の警告サインです。競争の激しいトピックでは、それを最新の研究に置き換えることは任意ではありません。
- ニュアンスとトレードオフへの誠実な扱い。 AIは外交的にバランスを取ろうとしがちです。役立つコンテンツは、明確な意見やその理由の説明から逃げません。
AIは構造、リサーチ、初稿の生成に優れています。人間の貢献は、生成できないレイヤーです。それは経験、判断力、独自データ、そして唯一無二の声です。
良いニュースは、FlowHuntにあなたらしく話させる方法を教えられるということです。独自データ、ケーススタディ、ブランドガイドライン、好みの事例をナレッジソース を通して与え、エージェント指示 でエージェントの書き方と振る舞いを設定してください。これにより、AIだけでは欠けていた価値を補い、校正に費やす時間を大幅に削減できます。AIが必要なものにすでにアクセスできるからです。さらに重要なのは、ほとんどの人がこれをやっていないという点です。彼らは何も考えずに適当なスロップを投稿するか、不必要なほどの手作業に頼るかのどちらかです。

ニュースレターに登録
最新のヒント、トレンド、お得な情報を無料で入手。
SEOに特化してAIコンテンツをヒューマナイズする方法
AI Text Humanizer は、読者をページにとどめる執筆品質を向上させます。ページ滞在時間、スクロール深度、再訪問で測定されるそのエンゲージメントが、検索エンジンがコンテンツ品質の間接的なシグナルとして使うものです。
このツールのプロセスは、AIコンテンツのパフォーマンスを損なうパターンに直接対処します。
- トーンと意図の分析 — コンテンツが説明的か、説得的か、指示的かを識別し、その意図に合う自然な言葉づかいで書き直します。意図のミスマッチ(検索者が説明を求めているのに商品の売り込みのように読める記事)は直帰のシグナルです。
- AIパターンの除去 — 「in the realm of」「leverage」「it’s worth noting that」といった使い古されたフレーズは、平易で直接的な言葉に置き換えられます。これらのフレーズはAI生成らしく読めるだけでなく、読者に情報密度の低さを伝えます。
- 自然な言葉への書き直し — 硬い言い回し、均一な文の長さ、機械的な接続表現を、真のエンゲージメントを生む変化に富んだ慣用的な言葉に置き換えます。
- 読者ターゲティング — 語彙と文構造を実際の読者に合わせて調整します。フォーマルすぎたり単純すぎたりする文章は、コンテンツが届く前に読者を失います。
ヒューマナイズの後、編集レイヤーが、権威あるコンテンツとそこそこのコンテンツを分けるE-E-A-Tシグナルを加えます。一次体験、独自データ、ブランド事例をナレッジソース 経由でFlowHuntに与えておけば、AIは今後のすべての実行でそれらを自動的に活用できます。人間に残るのは最終レビューと判断であり、データ入力ではありません。
上位表示するコンテンツのための最適なAI+人間のワークフロー
実際に上位表示されるコンテンツのための理想的なAI支援ワークフローには4つのレイヤーがあります。
リサーチに基づく生成。 モデルがすでに知っていることを引き出すだけのプロンプトではなく、最新の情報源に基づき、実際の検索意図に沿って構成された初稿から始めます。つまり、ライブデータを取得し、実際の検索結果と照合して検証し、クエリが本当に必要としているものを中心にアウトラインを組み立てるということです。
ヒューマナイズ。 AI出力を生成物らしく感じさせる統計的・文体上のパターンを取り除き、本物の声と自然な文の変化のために書き直します。ステップ1で作った構造的な初稿は、そのまま公開できる状態であることはほとんどありません。
コンテキストの強化。 独自データ、ブランド事例、専門分野の判断を持ち込みます。これはE-E-A-Tシグナルを加え、同じトピックで書かれた他の100本の記事からその記事を差別化するレイヤーです。レビュー時に手動で加えることも、事前にAIにあなたのコンテキストを教えて、今後のすべての実行で自動的に参照させることもできます。
SEO検証。 公開前に、初稿をライブ検索データと照合し、古い統計を更新し、見出し構造とメタデータを引き締めます。
FlowHuntには、これらの各レイヤー向けのツールがあり、1つのパイプラインとしてつながるように作られています。それぞれが実際に何をするのかを見ていきましょう。
ステップ1:AI Blog Writer — リサーチに基づく初稿を生成する
AI Blog Writer は3段階のプロセスを踏みます。リサーチ(最新データ、統計、技術的洞察を求めてライブの情報源にクエリする)、分析(集めた情報を主要な切り口とフレームワークに統合する)、実行(クリーンなMarkdownで記事全文を書く)。これにより、構造化されたエビデンスに基づく初稿が生まれます。
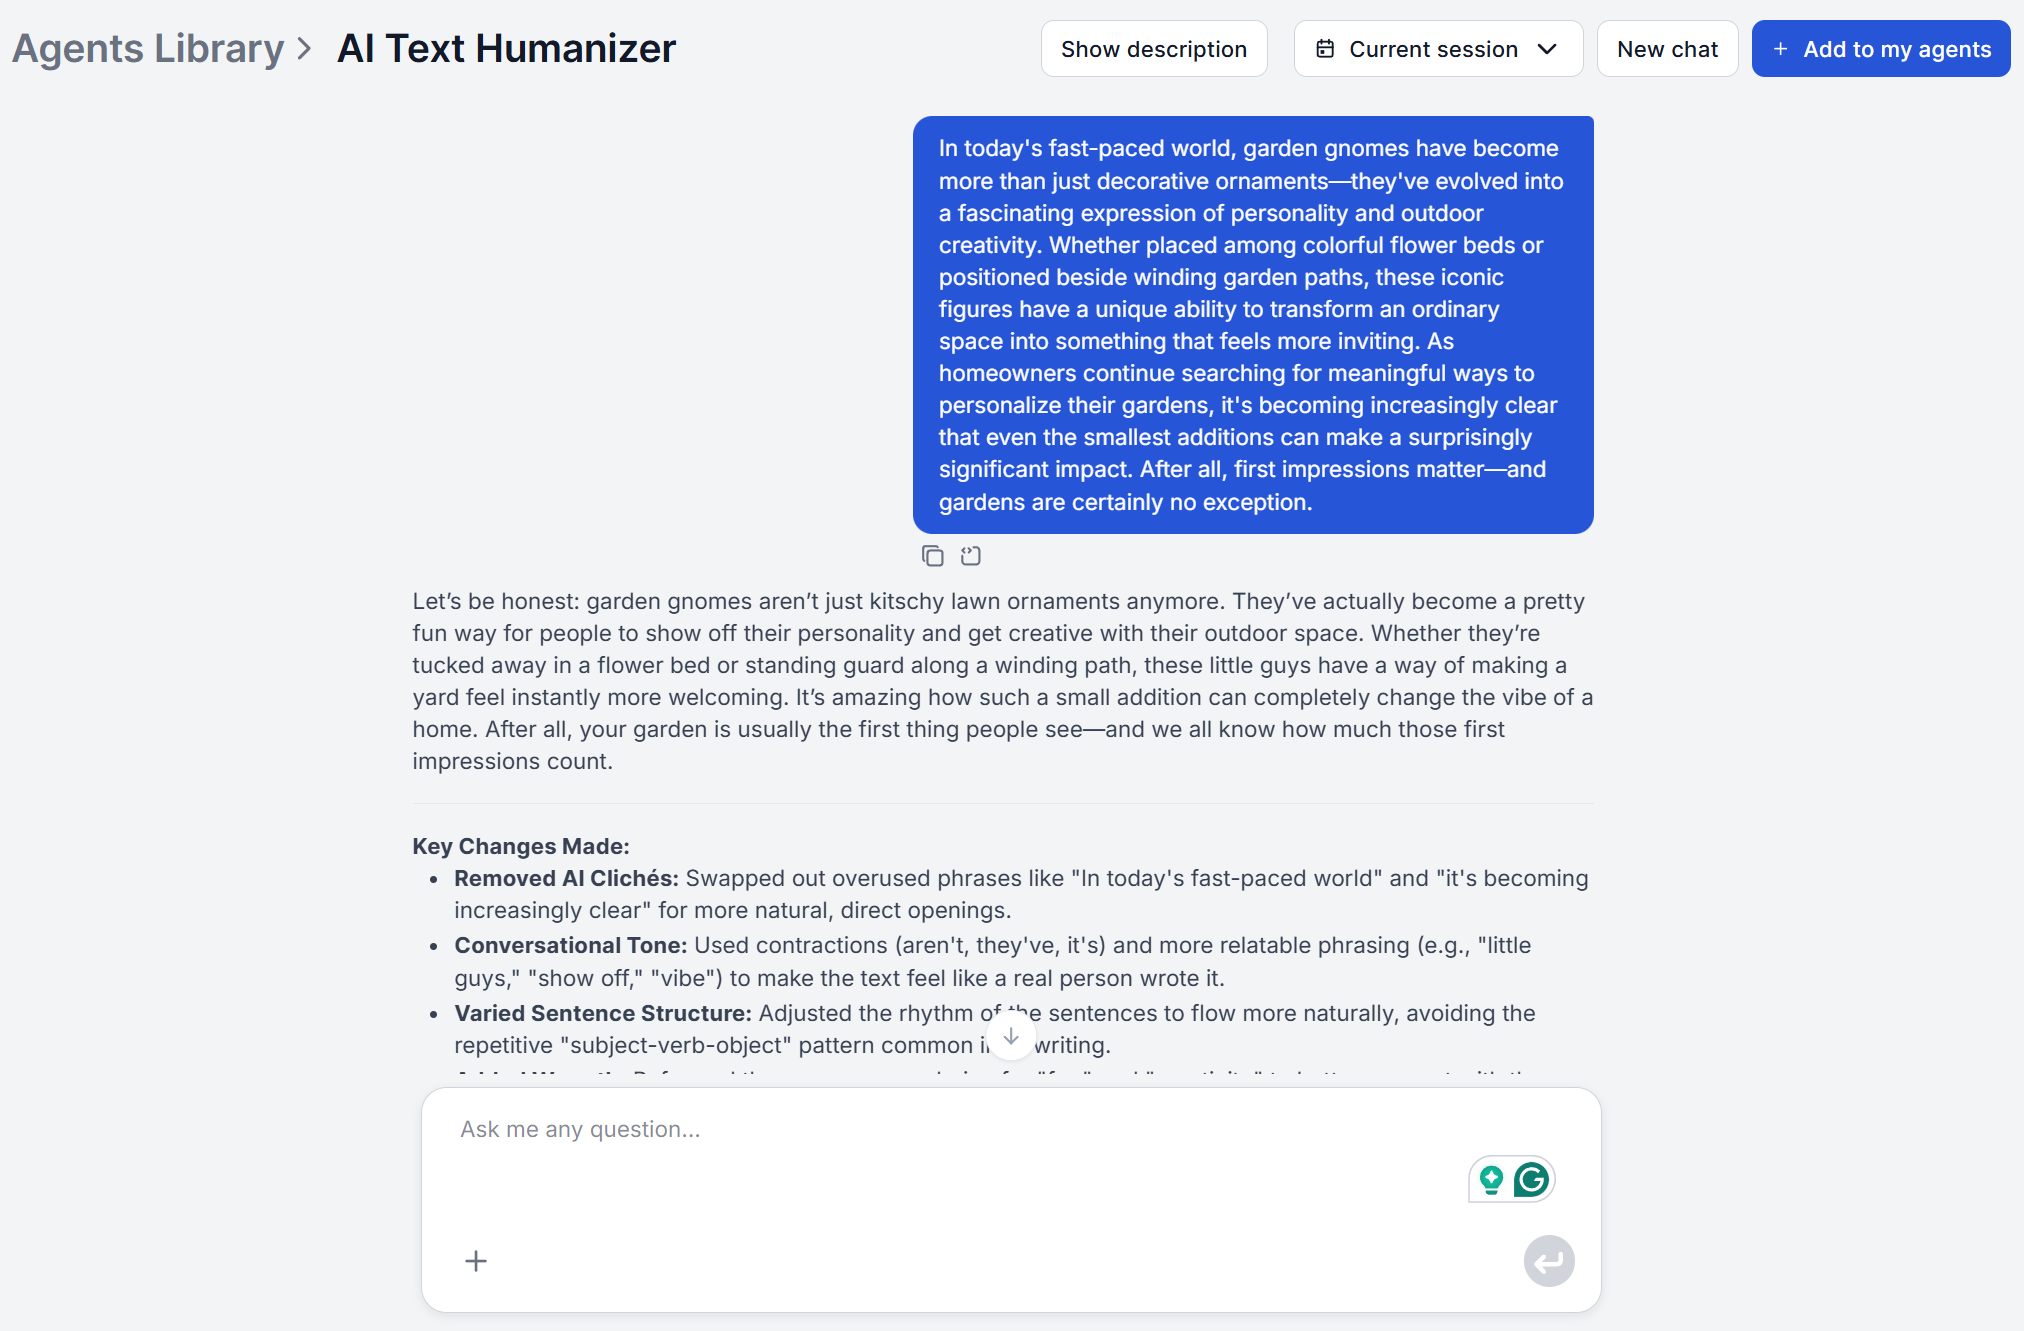
ステップ2:AI Text Humanizer — AIパターンを除去し、声を加える
AI Text Humanizer は、トーンと意図の分析、自然な言葉への書き直し、AIパターンの除去、複雑さの簡素化を1回の処理で行います。出力は、生成物らしく読めなくなった、読みやすく自然な声の初稿です。
ステップ3:FlowHuntを通してあなたの声とデータを加える
一人称の体験、ケーススタディ、ブランドボイス、独自データをナレッジソース とエージェント指示 を通してFlowHuntに与えることで、AIは今後のすべての実行でこれらを自動的に参照できるようになります。すると人間のステップは、主張を検証し、文章が正しく響くかを確認し、専門家にしかできない判断を下すことに変わります。
ステップ4:AI Blog Content Improver — リサーチ強化とSEO
AI Blog Content Improver は4段階の自動改善パスを実行します。取得(URLまたはHTMLで投稿を取得する)、リサーチと検証(ライブのGoogle SearchとArXivの情報源と照合する)、強化(不足を補い、古い統計を更新し、弱いセクションを強化する)、SEOと整形の追加(見出し構造を最適化し、キーワードを自然に組み込み、メタデータを整える)。
実際のAI記事50本のデータ:上位表示したものとしなかったもの
FlowHuntで分析したAI生成記事とAI支援記事を通じて、上位表示するコンテンツとそうでないコンテンツを分けるパターンは一貫しており、予測可能です。
上位表示した記事:
- 一般的な主張ではなく、具体的で検証可能なデータポイントを持っていた。私たちは常にデータと情報源を提供するか、AIにリアルタイムのインターネットリサーチをさせるようにしています。
- 学習データからは生まれ得ない視点や事例を少なくとも1つ含んでいた。たとえば独自のテスト結果、実名のクライアント事例、現在のインプットで実行した特定ツールの比較などです。たとえば私たちは、CEOがLinkedInの投稿で共有した強い意見を中心に据えることで、基本的な生成記事を強化しました。
- 抽象的なトピックではなく、検索者が実際に必要としていたものを中心に構成されていた。関連する生成FAQも完備していた。
- 自然で変化に富んだ文章を使っていた。最も上位表示されたコンテンツは、特に導入部と結論で人間による大幅な介入を経ていました。個人的で意見のある人間らしい言葉づかいが読者をページにとどめ、それがランキングを支えるエンゲージメントシグナルを生みました。ただし、トピックを設定する一般的な説明セクションにはほとんど手を入れていません。AIはそこを単独でとてもうまくこなせます。
- Blog Improver Agentのリサーチと検証パスを経て、公開前に古い統計を捕捉していた。
上位表示しなかった記事:
- 人間の編集レイヤーが最小限かまったくない状態で公開された。洞察を加えていないAI生成の構造と文章。
- 画像、統計、表がまったくないかごくわずかで公開された。
- ハルシネーションや古い統計を含み、信頼を損ない、訂正や直帰を生んだ。
- 検索者が尋ねていないことに答えていた。技術的にはトピックに沿っているが、実際の検索意図とは合っていなかった。
- 均一な文構造と定型的な言い回しで、読者が読み終える前に戻るボタンを押してしまった。
- 不快に長い段落と、多すぎる箇条書きや列挙文があった。
- 広いトピックを扱いながら、深さや数値、具体性がほとんどなかった。
GoogleがAIコンテンツにペナルティを与えるのは、その出所だけが理由ではありません。誰が書いたかに関係なく、コンテンツを読む価値のあるものにする要素が欠けていることこそが問題です。良いコンテンツには、本当の疑問を持つ人にとっての具体性、正確さ、独自の視点、そして真の有用性が常に必要です。
