


AI-contentdetectie voor SEO is op dit moment een van de meest verkeerd begrepen onderwerpen in contentmarketing. Velen beweren dat Google simpelweg alle AI-geschreven content bestraft. Maar die angst berust op een verkeerde lezing van wat er werkelijk gebeurt.
Google bestraft content niet omdat die door AI is gegenereerd. Het bestraft content omdat die van lage kwaliteit is, weinig relevantie voor het onderwerp heeft, niet behulpzaam en oppervlakkig is. Hier is wat het bewijs werkelijk laat zien, welke AI-patronen betrokkenheid en kwaliteitssignalen triggeren, en hoe je AI-ondersteunde content maakt die rankt.
Wat Google in 2026 werkelijk zegt over AI-content
Google’s officiële documentatie stelt dat “de rankingsystemen van Google erop gericht zijn originele, hoogwaardige content te belonen die de kwaliteiten vertoont van wat wij E-E-A-T noemen: expertise, ervaring, autoriteit en betrouwbaarheid. Onze systemen beoordelen de kwaliteit van content, niet of content door AI is gegenereerd.”
Het beleid dat zich specifiek richt op AI-content is het spambeleid van Google, dat ingaat op “automatisch gegenereerde content die bedoeld is om zoekrankings te manipuleren”. De formulering is “bedoeld om te manipuleren”, niet “gegenereerd door AI”.
Met andere woorden: het bestraft vage, in massa geproduceerde content die alleen gericht is op het oogsten van keywords, in plaats van het beantwoorden van zoekopdrachten of — God verhoede — het leveren van echte originele inzichten of entertainmentwaarde. Aan de andere kant kan een AI-gegenereerd artikel dat gebruikmaakt van je eigen data, inzichten en stem gemakkelijk je best rankende stuk ooit worden.
Daarom gaat de SEO-impact van AI-schrijven in 2026 niet over de AI-gegenereerde content zelf, maar over het feit dat die vaak faalt op kwaliteitsmetrics waar Google altijd al om gaf. Maar het belangrijkste: de redenen daarvoor zijn voorspelbaar en oplosbaar. Zo doe je dat.
Hoe AI-contentdetectietools werken (en hoe nauwkeurig ze zijn)
Naast andere kleine eigenschappen leunen AI-detectors vooral op twee grote statistische eigenschappen. De eerste is perplexity. Dit is hoe voorspelbaar elke woordkeuze is gezien wat eraan voorafging. Taalmodellen genereren zeer voorspelbare sequenties, terwijl menselijke schrijvers vaker onverwachte keuzes maken. De tweede is burstiness, oftewel hoeveel variatie er tussen zinnen bestaat. AI-output neigt naar uniforme zinslengte en -structuur; menselijk schrijven varieert aanzienlijk. Er wordt ook gekeken naar veelvoorkomende AI-frases en stilistische keuzes, evenals naar andere eigenschappen.
Deze eigenschappen vormen een herkenbare statistische vingerafdruk die detectietools zoals GPTZero en Turnitin meten. Tegen ruwe, niet-bewerkte AI-output zijn deze tools redelijk betrouwbaar. Tegen gehumaniseerde, bewerkte of door mensen nagekeken content zijn de fout-positieve percentages veel hoger.
Bedenk dat Google deze AI-detectietools niet gebruikt voor rankingbeslissingen. In plaats daarvan gebruikt het zijn eigen kwaliteitssignalen, ongeacht de herkomst van de content. Het kijkt naar betrokkenheidsmetrics, E-E-A-T-evaluatie, contentdiepgang en topical authority.
De kern is: een pagina die elke AI-detector doorstaat, is niet immuun voor een kwaliteitsstraf, en een pagina die elke detector zakt, wordt niet alleen daarom bestraft.

Klaar om uw bedrijf te laten groeien?
Start vandaag uw gratis proefperiode en zie binnen enkele dagen resultaten.
De patronen die AI-content generiek en laagwaardig maken
Wat Google’s systemen werkelijk beoordelen, is of content de intentie van de zoeker beter vervult dan concurrerende pagina’s. De specifieke AI-schrijfpatronen die deze test het vaakst niet doorstaan, zijn:
- Geen ervaring of perspectief uit de eerste hand. AI kan samenvatten, maar kan niet verslag doen. Content die beschrijft wat “veel experts geloven” zonder enige specifieke expertise, cijfers, bronvermeldingen of kennis uit de eerste persoon te tonen, faalt op de Experience-component van E-E-A-T.
- Geen originele data of eigen inzichten. Als elke zin in een artikel geschreven had kunnen zijn op basis van een Wikipedia-samenvatting en een handvol bestaande blogposts, voegt het niets toe. Google’s systemen worden steeds beter in het herkennen wanneer een pagina iets nieuws bijdraagt.
- Feitelijke fouten en hallucinaties. AI-modellen genereren plausibel klinkende informatie die soms onjuist is. Een zelfverzekerd, vloeiend artikel met onjuiste feiten is zowel een falen van het kwaliteitssignaal als een breuk in het vertrouwen van de lezer.
- Oppervlakkige dekking van de zoekintentie. Een AI-artikel over “hoe schrijf je een metabeschrijving” dat geen aandacht besteedt aan tekenlimieten, implicaties voor de click-through rate of veelgemaakte fouten, is oppervlakkig, ongeacht hoe het is geschreven.
- Formulematige openingen en generieke formuleringen. Zinnen als “In het huidige digitale landschap”, “Het is cruciaal om op te merken dat”, “Met de opkomst van AI…” werden synoniem met AI-slop en signaleren onmiddellijk aan lezers (en betrokkenheidsmetrics) dat de pagina het niet waard is om aandachtig te lezen.
Bedenk dat de rankingsignalen van Google van kwaliteit volledig van vóór AI dateren. AI maakt het alleen gemakkelijker om op grote schaal content te produceren die er niet aan voldoet.
Wat ’nuttige content’ betekent voor AI-ondersteund schrijven
Het Helpful Content System van Google beoordeelt of content “primair voor mensen” is gemaakt in plaats van “primair voor zoekmachines”. Voor AI-ondersteunde content komt dat onderscheid neer op wat de menselijke laag bijdraagt.
De kwaliteitsingrediënten die nuttige AI-ondersteunde content onderscheiden van generieke AI-output:
- Originele voorbeelden en casestudy’s. “Toen we dit met 200 gebruikers testten, ontdekten we…” heeft gewicht dat “veel gebruikers melden…” niet heeft.
- Vakkundige terminologie die correct wordt gebruikt. Niet keywordplaatsing, maar het soort accurate, precieze taal dat verraadt dat iemand het onderwerp echt kent.
- Bijgewerkte, geverifieerde data. Een studie uit 2023 citeren in 2026 is een kwaliteitswaarschuwingssignaal. Die vervangen door actueel onderzoek is niet optioneel voor competitieve onderwerpen.
- Eerlijke behandeling van nuance en afwegingen. AI is vaak diplomatiek gebalanceerd. Nuttige content schuwt heldere meningen, redeneringen en uitleg niet.
AI is uitstekend in het genereren van de structuur, het onderzoek en de eerste draft. De menselijke bijdrage is de laag die niet gegenereerd kan worden. Dat is de ervaring, het oordeel, de eigen data en de unieke stem.
Het goede nieuws is dat je FlowHunt absoluut kunt leren klinken als jij. Voed het met je eigen data, casestudy’s, merkrichtlijnen en voorkeursvoorbeelden via kennisbronnen , en configureer hoe je agents schrijven en zich gedragen via agentinstructies . Dit vermindert de tijd die je besteedt aan proeflezen en aan het leveren van de waarde die AI alleen miste, enorm, omdat de AI al toegang heeft tot wat het nodig heeft. En nog belangrijker: de meeste mensen doen dit niet. Ze publiceren achteloos willekeurige slop of grijpen naar onnodig veel handmatig werk.
Schrijf u in voor onze nieuwsbrief
Ontvang gratis de nieuwste tips, trends en aanbiedingen.
Hoe je AI-content specifiek voor SEO humaniseert
De AI Text Humanizer verbetert de schrijfkwaliteit waardoor lezers op de pagina blijven. Die betrokkenheid, gemeten via tijd op de pagina, scrolldiepte en terugkerende bezoeken, is wat zoekmachines gebruiken als indirect signaal van contentkwaliteit.
Het proces van de tool pakt direct de patronen aan die de prestaties van AI-content schaden:
- Toon- en intentieanalyse — de tool stelt vast of de content informatief, overtuigend of instructief is en herschrijft vervolgens zodat die intentie aansluit bij natuurlijke taal. Een verkeerde intentie (een artikel dat leest als een productpitch terwijl de zoeker een uitleg wilde) is een bounce-signaal.
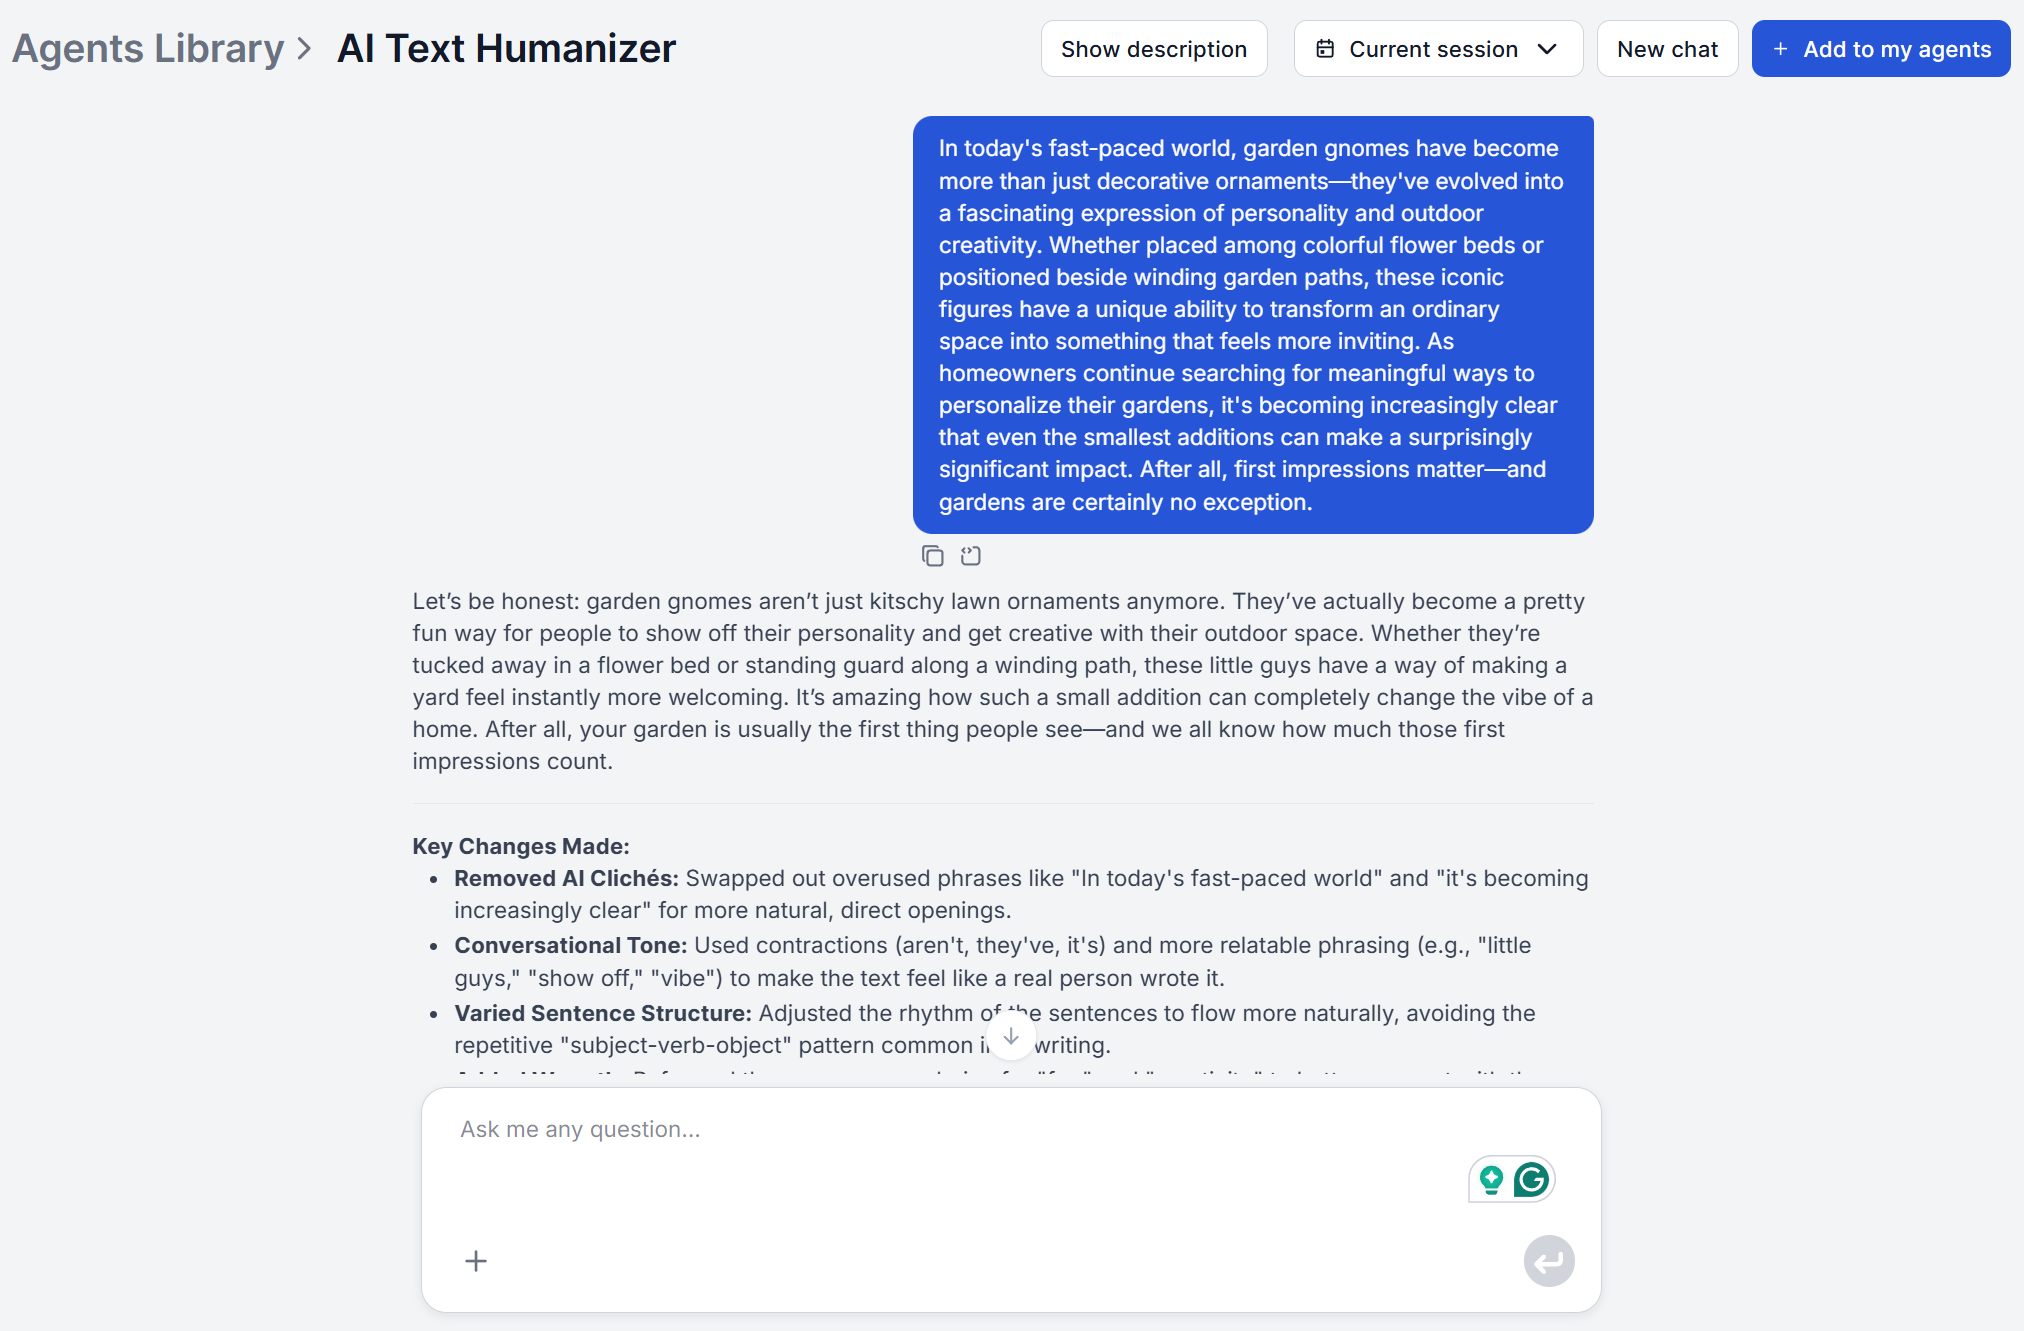
- Verwijderen van AI-patronen — overgebruikte zinnen zoals “op het gebied van”, “benutten” en “het is de moeite waard op te merken dat” worden vervangen door eenvoudige, directe taal. Deze zinnen lezen niet alleen als AI-gegenereerd, ze signaleren ook een lage informatiedichtheid aan lezers.
- Herschrijven in natuurlijke taal — stijve formuleringen, uniforme zinslengte en mechanische overgangen worden vervangen door de gevarieerde, idiomatische taal die echte betrokkenheid creëert.
- Richten op het publiek — woordenschat en zinsstructuur worden aangepast aan je werkelijke lezers. Tekst die te formeel of te simpel is afgestemd, verliest het publiek voordat de content de kans krijgt om aan te komen.
Na het humaniseren voegt de redactionele laag de E-E-A-T-signalen toe die gezaghebbende content onderscheiden van competente content. Als je je ervaring uit de eerste hand, eigen data en merkvoorbeelden via kennisbronnen in FlowHunt invoert, kan de AI daar in elke volgende run automatisch op putten. Wat menselijk blijft, is de eindredactie en de beoordelingsbeslissingen, niet het invoeren van data.
De optimale AI + mens-workflow voor content die rankt
De ideale AI-ondersteunde workflow voor content die daadwerkelijk rankt, heeft vier lagen.
Door onderzoek onderbouwde generatie. Beginnend met een draft die is gebaseerd op actuele bronnen en gestructureerd rond de werkelijke zoekintentie, niet rond een prompt die oplepelt wat het model al weet. Dit betekent live data ophalen, die verifiëren tegen echte zoekresultaten en een outline bouwen rond wat de zoekopdracht werkelijk nodig heeft.
Humanisering. Het verwijderen van de statistische en stilistische patronen die AI-output gegenereerd laten voelen, en herschrijven voor een echte stem en natuurlijke zinsvariatie. De structurele draft uit stap één is zelden klaar om zo te publiceren.
Contextverrijking. Eigen data, merkvoorbeelden en vakkundig oordeel toevoegen. Dit is de laag die E-E-A-T-signalen toevoegt en het stuk onderscheidt van de honderd andere artikelen over hetzelfde onderwerp. Je kunt dit handmatig toevoegen tijdens de review, of de AI je context vooraf aanleren zodat het daar in elke volgende run automatisch op put.
SEO-verificatie. De draft vergelijken met live zoekdata, verouderde statistieken bijwerken en de koppenstructuur en metadata aanscherpen vóór publicatie.
FlowHunt heeft tools voor elk van deze lagen, gebouwd om als één pijplijn te verbinden. Dit doen ze in de praktijk.
Stap 1: AI Blog Writer — Genereer de door onderzoek onderbouwde draft
De AI Blog Writer volgt een proces in drie fasen: onderzoek (live bronnen bevragen voor actuele data, statistieken en technische inzichten), analyse (de verzamelde informatie synthetiseren tot kerninvalshoeken en kaders) en uitvoering (het volledige artikel schrijven in schone Markdown). Dit levert een gestructureerde, op bewijs gebaseerde draft op.
Stap 2: AI Text Humanizer — Verwijder AI-patronen, voeg stem toe
De AI Text Humanizer dekt toon- en intentieanalyse, herschrijven in natuurlijke taal, verwijderen van AI-patronen en vereenvoudiging van complexiteit in één pass. De output is een leesbare draft met een natuurlijke stem die niet langer als gegenereerd leest.
Stap 3: Voeg je stem en data toe via FlowHunt
Door je ervaring uit de eerste persoon, casestudy’s, merkstem en eigen data via kennisbronnen en agentinstructies in FlowHunt te voeren, leer je de AI om daar in elke volgende run automatisch op te putten. De menselijke stap wordt dan het verifiëren van beweringen, controleren of het stuk goed klinkt en het nemen van de beoordelingsbeslissingen die alleen een vakinhoudelijk expert kan nemen.
Stap 4: AI Blog Content Improver — Onderzoeksverrijking en SEO
De AI Blog Content Improver voert een geautomatiseerde verbeteringsronde in vier stappen uit. Ophalen (de post ophalen via URL of HTML), onderzoeken en verifiëren (kruisverwijzingen tegen live Google Search- en ArXiv-bronnen), verbeteren (hiaten opvullen, verouderde statistieken bijwerken, zwakke secties versterken), SEO en opmaak toevoegen (koppenstructuur optimaliseren, keywords natuurlijk verwerken, metadata verfijnen).
Data uit 50 echte AI-artikelen: wat rankte en wat niet
Over de AI-gegenereerde en AI-ondersteunde artikelen die we bij FlowHunt hebben geanalyseerd, zijn de patronen die rankende content scheiden van niet-rankende content consistent en voorspelbaar.
Artikelen die rankten:
- Hadden specifieke, verifieerbare datapunten in plaats van generieke beweringen. We zorgen er altijd voor dat we ofwel data en bronnen aanleveren, ofwel de AI realtime internetonderzoek laten doen.
- Bevatten minstens één perspectief of voorbeeld dat niet uit trainingsdata kon komen, zoals een eigen testresultaat, een met naam genoemd klantgeval of een specifieke toolvergelijking op basis van actuele inputs. We hebben bijvoorbeeld een eenvoudig gegenereerd artikel verrijkt door het te centreren rond de sterke meningen die onze CEO deelde in een LinkedIn-post.
- Waren gestructureerd rond wat de zoeker werkelijk nodig had, niet rond het onderwerp in abstracto. Compleet met relevante gegenereerde FAQ’s.
- Gebruikten natuurlijk, gevarieerd proza. Onze best rankende content onderging zware menselijke interventie, vooral in intro’s en conclusies. Persoonlijke en uitgesproken menselijke taal hield lezers op de pagina, wat de betrokkenheidssignalen creëerde die ranking ondersteunen. Maar de algemene uitleggende secties die het onderwerp opzetten, raken we zelden aan. Dat kan AI prima zelf.
- Waren door de onderzoeks- en verificatieronde van de Blog Improver Agent gegaan, waardoor verouderde statistieken vóór publicatie werden opgemerkt.
Artikelen die niet rankten:
- Werden gepubliceerd met een minimale of geen menselijke redactionele laag. AI-gegenereerde structuur en proza zonder toegevoegd inzicht.
- Werden gepubliceerd met geen of heel weinig afbeeldingen, statistieken of tabellen.
- Bevatten gehallucineerde of verouderde statistieken die vertrouwen ondermijnden en correcties/bounces veroorzaakten.
- Beantwoordden vragen die de zoeker niet stelde. Ze waren technisch gezien on-topic, maar niet afgestemd op de werkelijke zoekintentie.
- Hadden een uniforme zinsstructuur en formulematige formuleringen waardoor lezers terugklikten voordat ze klaar waren.
- Hadden onaangenaam lange alinea’s en te veel lijsten of opsommende zinnen.
- Behandelden brede onderwerpen met heel weinig diepgang, cijfers of specifieke details.
Bedenk dat Google AI-content niet alleen bestraft vanwege de herkomst. Het is de afwezigheid van de dingen die content het lezen waard maken, ongeacht wie het heeft geschreven. Goede content heeft altijd specificiteit, nauwkeurigheid, een origineel perspectief en echte bruikbaarheid voor iemand met een echte vraag nodig.
