


AI-indholdsdetektion for SEO er lige nu et af de mest misforståede emner i content marketing. Mange hævder, at Google ganske enkelt straffer alt AI-skrevet indhold. Men denne frygt bygger på en fejllæsning af, hvad der faktisk foregår.
Google straffer ikke indhold for at være AI-genereret. Det straffer indhold for at være af lav kvalitet, have lav emnerelevans, være uhjælpsomt og tyndt. Her er, hvad evidensen faktisk viser, hvilke AI-mønstre der udløser engagement- og kvalitetssignaler, og hvordan du producerer AI-assisteret indhold, der ranker.
Hvad Google faktisk siger om AI-indhold i 2026
Googles officielle dokumentation fastslår, at “Googles rankingsystemer sigter mod at belønne originalt indhold af høj kvalitet, der udviser kvaliteter af det, vi kalder E-E-A-T: ekspertise, erfaring, autoritet og troværdighed. Vores systemer vurderer kvaliteten af indholdet, ikke om indholdet er AI-genereret.”
De politikker, der specifikt retter sig mod AI-indhold, er Googles spam-politikker, som omhandler “auto-genereret indhold beregnet til at manipulere søgeresultater”. Det afgørende er “beregnet til at manipulere”, ikke “genereret af AI”.
Med andre ord straffer det vagt masseproduceret indhold, der kun fokuserer på at hamstre søgeord i stedet for at besvare forespørgsler eller, gud forbyde det, levere faktisk originale indsigter eller underholdningsværdi. På den anden side kan en AI-genereret artikel, der bruger dine egne data, indsigter og din egen stemme, nemt blive dit bedst rankende stykke indhold til dato.
Derfor handler AI-skrivningens SEO-effekt i 2026 ikke om det AI-genererede indhold i sig selv, men om det faktum, at det har en tendens til at fejle på de kvalitetsmålinger, som Google altid har været optaget af. Men allervigtigst: at årsagerne til dette er forudsigelige og kan udbedres. Her er hvordan.
Sådan fungerer værktøjer til AI-indholdsdetektion (og deres nøjagtighed)
Ud over andre mindre egenskaber hviler AI-detektorer mest på to store statistiske egenskaber. Den første er perpleksitet. Det er, hvor forudsigeligt hvert ordvalg er givet det, der kom før. Sprogmodeller genererer yderst forudsigelige sekvenser, mens menneskelige skribenter oftere træffer uventede valg. Den anden er burstiness (variationsrigdom), eller hvor stor variation der er mellem sætninger. AI-output har tendens til ensartet sætningslængde og -struktur; menneskelig skrivning varierer betydeligt. Den tjekker også for de almindelige AI-fraser og stilistiske valg samt andre egenskaber.
Disse egenskaber skaber et genkendeligt statistisk fingeraftryk, som detektionsværktøjer som GPTZero og Turnitin måler. Mod rå, uredigeret AI-output er disse værktøjer rimeligt pålidelige. Mod humaniseret, redigeret eller menneskeligt gennemgået indhold er falsk-positive raten meget højere.
Husk, at Google ikke bruger disse AI-detektionsværktøjer til at træffe rangordningsbeslutninger. I stedet bruger det sine egne kvalitetssignaler, uanset indholdets oprindelse. Det tjekker engagement-målinger, E-E-A-T-vurdering, indholdsdybde og emnemæssig autoritet.
Konklusionen er, at en side, der består enhver AI-detektor, ikke er immun over for en kvalitetsstraf, og en side, der fejler hos enhver detektor, bliver ikke straffet alene af den grund.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Mønstrene, der gør AI-indhold generisk og af lav kvalitet
Det, Googles systemer faktisk vurderer, er, hvorvidt indholdet opfylder søgerens intention bedre end konkurrerende sider. De specifikke AI-skrivemønstre, der mest konsekvent fejler denne test, er:
- Ingen førstehåndserfaring eller perspektiv. AI kan opsummere, men det kan ikke rapportere. Indhold, der beskriver, hvad “mange eksperter mener”, uden at demonstrere nogen specifik ekspertise, tal, citater eller jeg-viden, fejler Experience-komponenten i E-E-A-T.
- Ingen originale data eller proprietær indsigt. Hvis hver sætning i en artikel kunne være skrevet ud fra et Wikipedia-resumé og en håndfuld eksisterende blogindlæg, tilføjer den intet. Googles systemer er i stigende grad gode til at identificere, hvornår en side bidrager med noget nyt.
- Faktuelle fejl og hallucinationer. AI-modeller genererer plausibelt klingende information, som nogle gange er forkert. En selvsikker, flydende artikel med forkerte fakta er både et svigt i kvalitetssignalerne og et svigt i læserens tillid.
- Tynd dækning af søgeintentionen. En AI-artikel om “hvordan man skriver en meta-beskrivelse”, der ikke behandler tegngrænser, konsekvenser for klikrate eller almindelige fejl, er tynd, uanset hvordan den blev skrevet.
- Formelagtige åbninger og generiske formuleringer. Fraser som “I dagens digitale landskab”, “Det er afgørende at bemærke, at”, “Med AI’ens fremvækst…” er blevet synonyme med AI-slop og signalerer straks til læserne (og engagement-målingerne), at siden ikke er værd at læse grundigt.
Husk, at Googles rangordnings- og kvalitetssignaler er langt ældre end AI. AI gør det blot lettere at producere indhold i stor skala, som fejler dem.
Hvad ‘hjælpsomt indhold’ betyder for AI-assisteret skrivning
Googles Helpful Content System vurderer, om indholdet blev “skabt primært for mennesker” snarere end “primært for søgemaskiner”. For AI-assisteret indhold kommer denne forskel an på, hvad det menneskelige lag bidrager med.
De kvalitetsingredienser, der adskiller hjælpsomt AI-assisteret indhold fra generisk AI-output:
- Originale eksempler og casestudier. “Da vi testede dette med 200 brugere, fandt vi…” har en vægt, som “mange brugere rapporterer…” ikke har.
- Ekspertterminologi brugt korrekt. Ikke placering af søgeord, men den slags præcise og korrekte sprog, der signalerer, at nogen faktisk kender emnet.
- Opdaterede, verificerede data. At citere et studie fra 2023 i 2026 er et kvalitetsflag. At erstatte det med aktuel forskning er ikke valgfrit for konkurrenceprægede emner.
- Ærlig håndtering af nuancer og afvejninger. AI har tendens til at være diplomatisk afbalanceret. Hjælpsomt indhold viger ikke tilbage fra klar mening, ræsonnement og forklaring.
AI er god til at generere strukturen, research og første udkast. Det menneskelige bidrag er det lag, der ikke kan genereres. Det er erfaringen, dømmekraften, de proprietære data og den unikke stemme.
Den gode nyhed er, at du absolut kan lære FlowHunt at lyde som dig. Giv den dine proprietære data, casestudier, brandretningslinjer og foretrukne eksempler gennem videnskilder , og konfigurer, hvordan dine agenter skriver og opfører sig, gennem agentinstruktioner . Det reducerer i høj grad den tid, der bruges på korrekturlæsning og på at tilføre den værdi, som AI alene manglede, fordi AI’en allerede har adgang til det, den har brug for. Og endnu vigtigere: de fleste gør ikke dette. De poster enten tilfældigt slop uden at tænke nærmere over det eller tyer til unødvendige mængder af manuelt arbejde.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
Sådan humaniserer du AI-indhold specifikt til SEO
AI Text Humanizer forbedrer den skrivekvalitet, der holder læserne på siden. Det engagement, målt gennem tid på siden, scrolldybde og genbesøg, er det, søgemaskiner bruger som et indirekte signal om indholdskvalitet.
Værktøjets proces adresserer direkte de mønstre, der skader AI-indholdets ydeevne:
- Tone- og intentionanalyse — den identificerer, om indholdet er informativt, overbevisende eller instruerende, og omskriver derefter for at matche denne intention med naturligt sprog. Manglende overensstemmelse mellem intention og indhold (en artikel, der læses som et produktsalg, når søgeren ønskede en forklaring) er et bounce-signal.
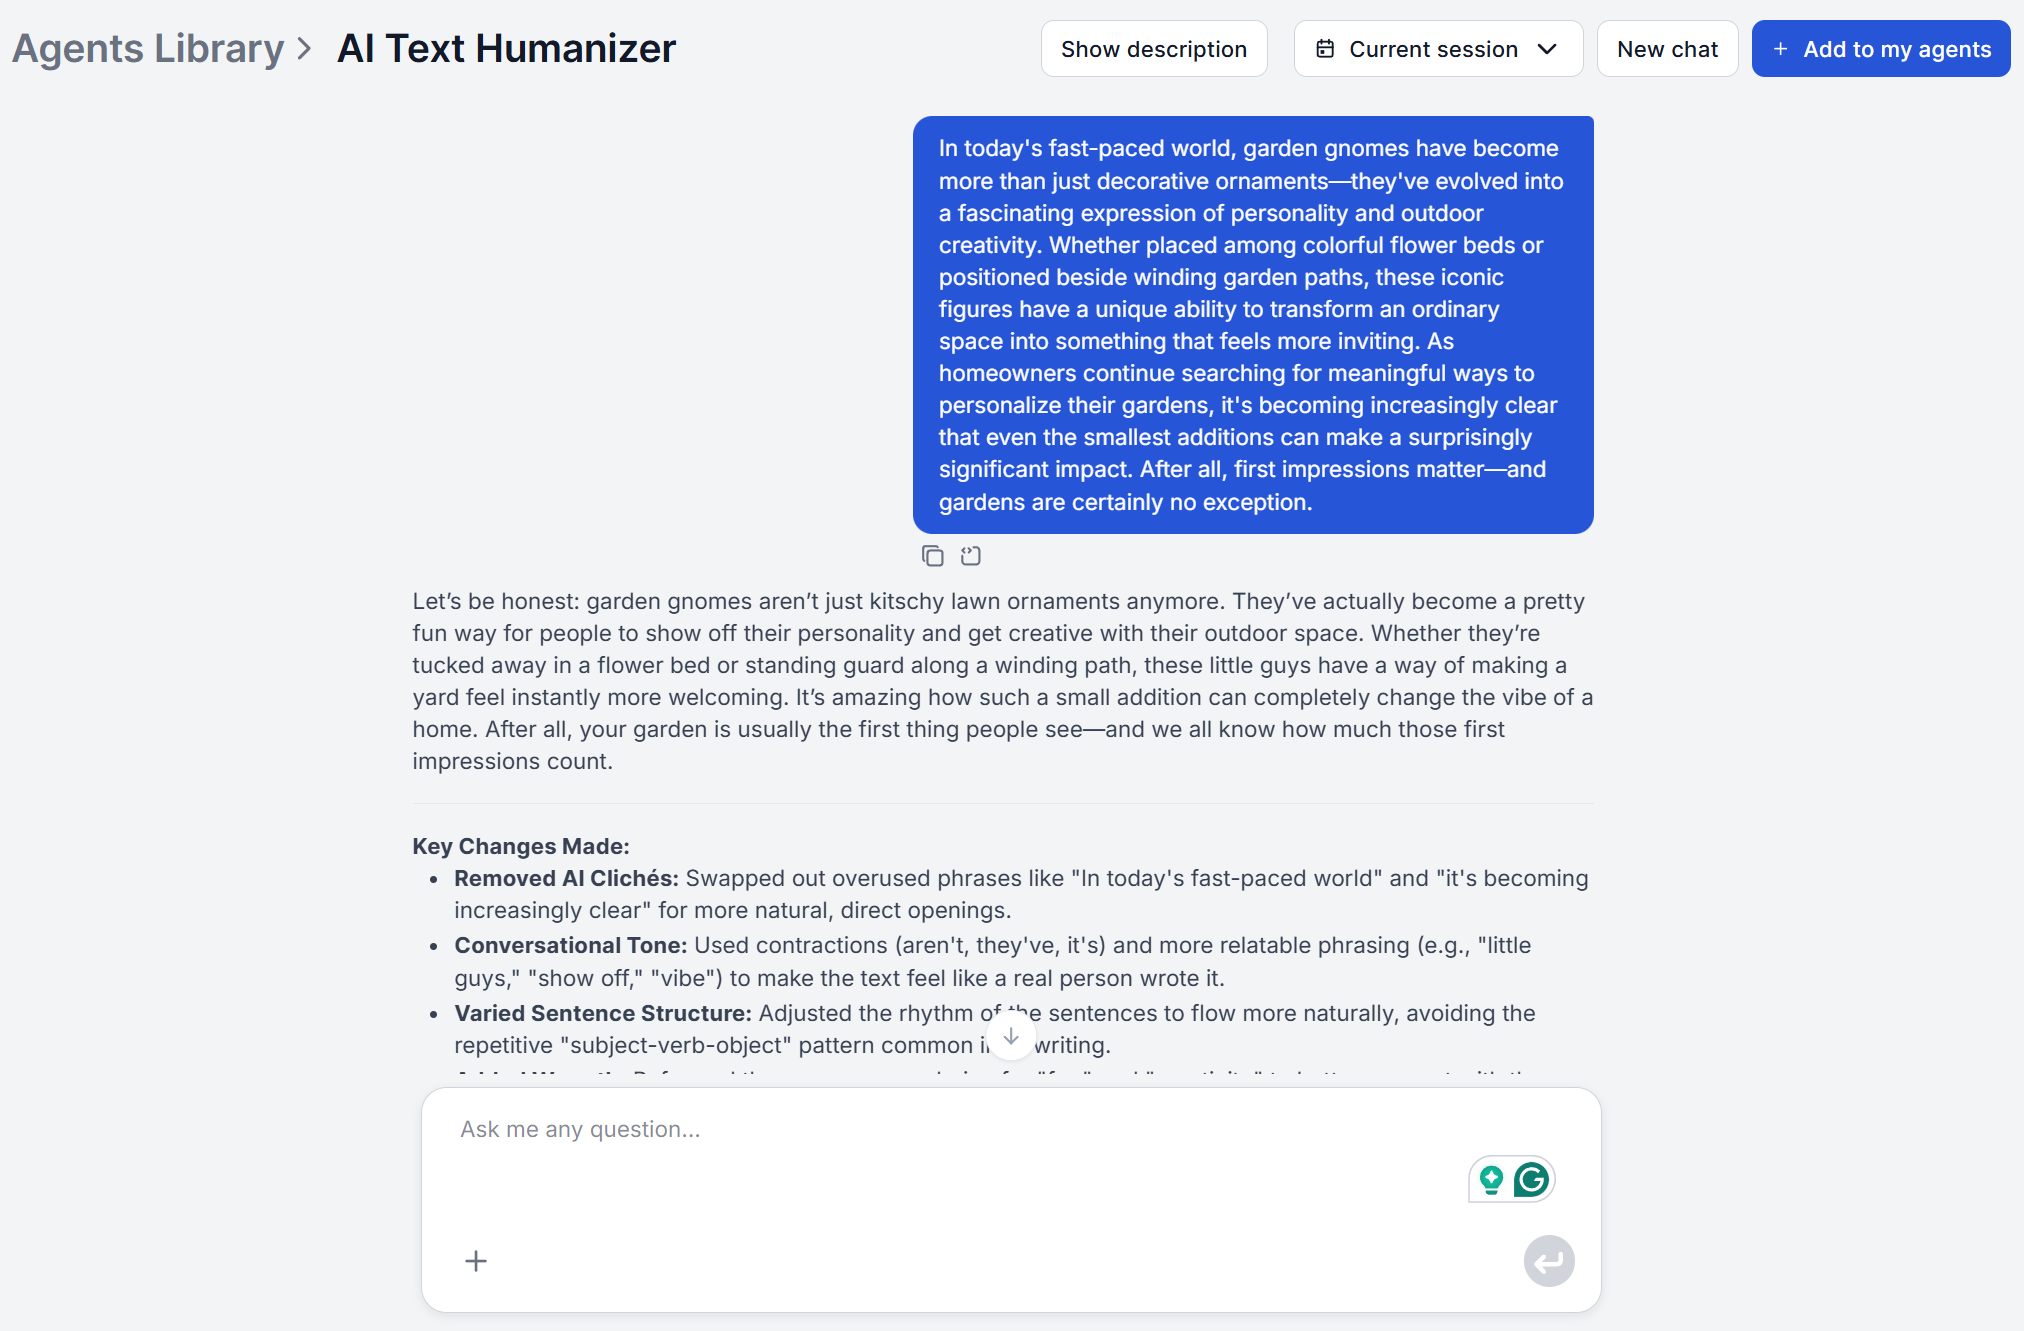
- Fjernelse af AI-mønstre — overbrugte fraser som “i sfæren af”, “udnytte” og “det er værd at bemærke, at” erstattes med enkelt, direkte sprog. Disse fraser læses ikke bare som AI-genererede, de signalerer lav informationstæthed til læserne.
- Omskrivning til naturligt sprog — stive formuleringer, ensartet sætningslængde og mekaniske overgange erstattes med det varierede, idiomatiske sprog, der skaber ægte engagement.
- Målretning mod målgruppen — ordforråd og sætningsstruktur tilpasses dine faktiske læsere. Tekst, der er vinklet for formelt eller for simpelt, mister publikum, før indholdet har en chance for at lande.
Efter humaniseringen tilføjer det redaktionelle lag de E-E-A-T-signaler, der adskiller autoritativt indhold fra kompetent indhold. Hvis du giver din førstehåndserfaring, proprietære data og brandeksempler ind i FlowHunt via videnskilder , kan AI’en automatisk trække på dem i hver fremtidig kørsel. Det, der forbliver menneskeligt, er den endelige gennemgang og vurderingerne, ikke indtastningen af data.
Den optimale AI + menneske-arbejdsgang for indhold, der ranker
Den ideelle AI-assisterede arbejdsgang for indhold, der faktisk ranker, har fire lag.
Researchbaseret generering. At starte med et udkast forankret i aktuelle kilder og struktureret omkring den faktiske søgeintention, ikke en prompt, der blot frembringer, hvad modellen allerede ved. Det betyder at hente live-data, verificere dem mod rigtige søgeresultater og bygge en disposition op omkring, hvad forespørgslen faktisk har brug for.
Humanisering. At fjerne de statistiske og stilistiske mønstre, der får AI-output til at føles genereret, og omskrive for ægte stemme og naturlig sætningsvariation. Det strukturelle udkast fra trin et er sjældent klar til at blive publiceret som det er.
Kontekstberigelse. At inddrage proprietære data, brandeksempler og faglig dømmekraft. Det er det lag, der tilføjer E-E-A-T-signaler og adskiller stykket fra de hundrede andre artikler skrevet om samme emne. Du kan tilføje dette manuelt på gennemgangstidspunktet, eller lære AI’en din kontekst på forhånd, så den automatisk trækker på den i hver fremtidig kørsel.
SEO-verificering. At tjekke udkastet mod live-søgedata, opdatere eventuelle forældede statistikker og stramme overskriftstruktur og metadata op før publicering.
FlowHunt har værktøjer til hvert af disse lag, bygget til at forbinde som én samlet pipeline. Her er, hvad hver af dem gør i praksis.
Trin 1: AI Blog Writer — generér det researchbaserede udkast
AI Blog Writer følger en trefaset proces: research (forespørger live-kilder om aktuelle data, statistikker og tekniske indsigter), analyse (syntetiserer indsamlet information til centrale vinkler og rammer) og eksekvering (skriver hele artiklen i ren Markdown). Det producerer et struktureret, evidensbaseret udkast.
Trin 2: AI Text Humanizer — fjern AI-mønstre, tilføj stemme
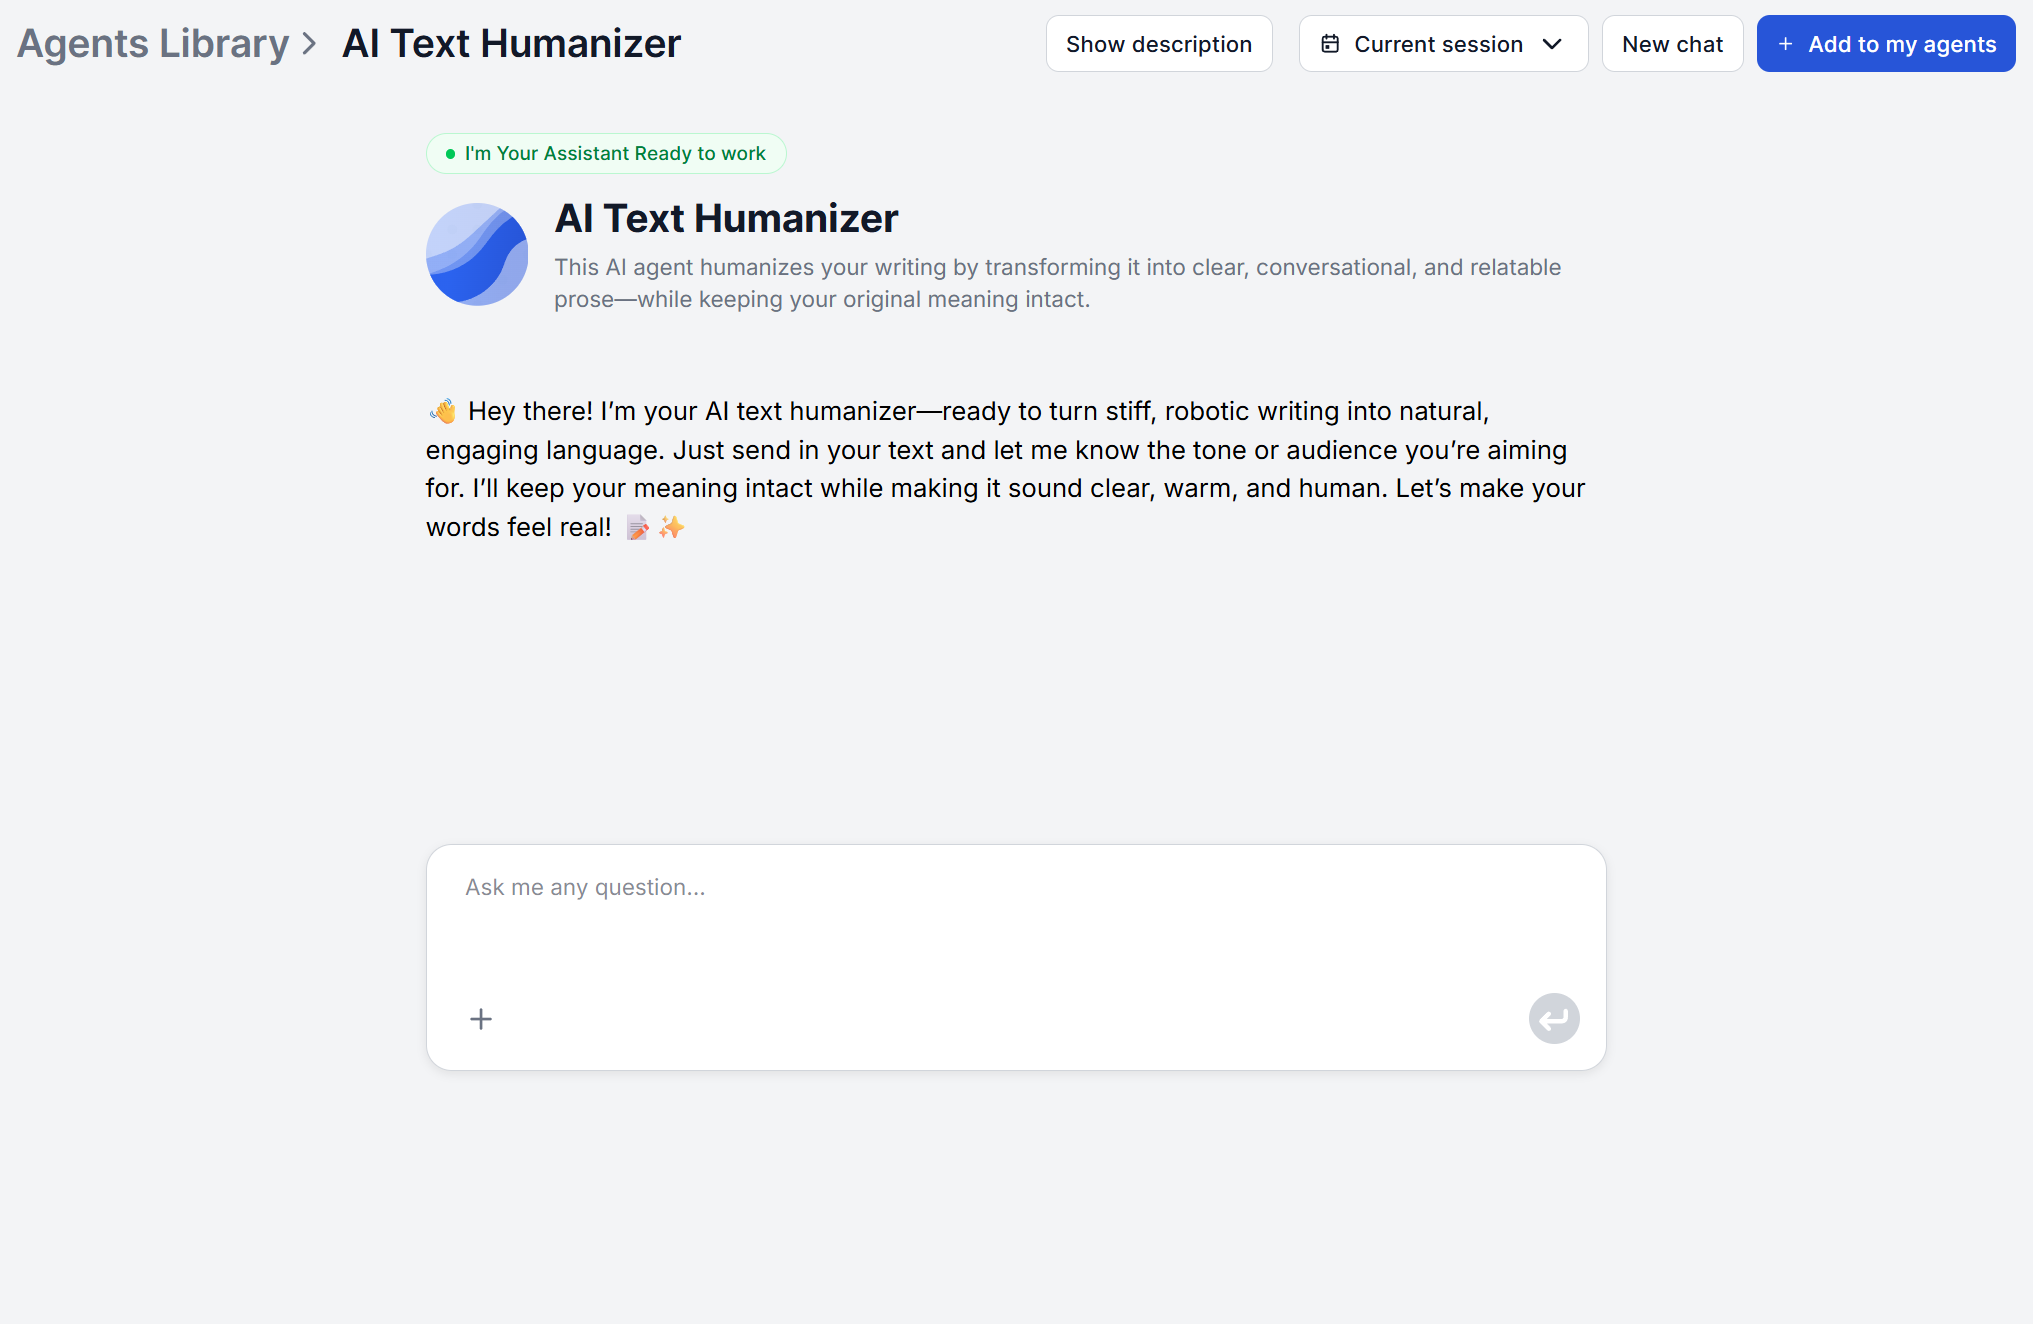
AI Text Humanizer dækker tone- og intentionanalyse, omskrivning til naturligt sprog, fjernelse af AI-mønstre og forenkling af kompleksitet i én gennemkørsel. Resultatet er et læsbart udkast med naturlig stemme, der ikke længere læses som genereret.
Trin 3: Tilføj din stemme og dine data gennem FlowHunt
Ved at give din jeg-erfaring, casestudier, brandstemme og proprietære data ind i FlowHunt via videnskilder og agentinstruktioner lærer du AI’en automatisk at trække på disse i hver fremtidig kørsel. Det menneskelige trin bliver derefter at verificere påstande, tjekke at stykket lyder rigtigt og træffe de vurderinger, som kun en fagperson kan træffe.
Trin 4: AI Blog Content Improver — researchberigelse og SEO
AI Blog Content Improver kører en automatiseret forbedringsproces i fire trin. Den henter (fetcher indlægget via URL eller HTML), researcher og verificerer (krydstjekker mod live Google Search- og ArXiv-kilder), forbedrer (udfylder huller, opdaterer forældede statistikker, styrker svage afsnit) og tilføjer SEO og formatering (optimerer overskriftstruktur, integrerer søgeord naturligt, forfiner metadata).
Data fra 50 rigtige AI-artikler: Hvad ranked, og hvad gjorde ikke
På tværs af de AI-genererede og AI-assisterede artikler, vi har analyseret hos FlowHunt, er mønstrene, der adskiller rankende indhold fra ikke-rankende indhold, konsistente og forudsigelige.
Artikler, der ranked:
- Havde specifikke, verificerbare datapunkter frem for generiske påstande. Vi sørger altid for enten at levere data og kilder eller lade AI’en lave research i realtid på internettet.
- Inkluderede mindst ét perspektiv eller eksempel, der ikke kunne komme fra træningsdata, såsom et proprietært testresultat, en navngivet kundecase eller en specifik værktøjssammenligning kørt på aktuelle input. For eksempel har vi beriget en grundlæggende genereret artikel ved at centrere den om de stærke holdninger, vores CEO delte i et LinkedIn-opslag.
- Var struktureret omkring, hvad søgeren faktisk havde brug for, ikke omkring emnet i abstrakt form. Komplet med relevante genererede FAQ’er.
- Brugte naturlig, varieret prosa. Vores bedst rankende indhold gik gennem kraftig menneskelig indgriben, især i introer og konklusioner. Personligt og meningsfuldt menneskeligt sprog fik læserne til at blive på siden, hvilket skabte de engagement-signaler, der understøtter rangordning. Men vi rører sjældent de generelle forklarende afsnit, der sætter emnet op. Det kan AI’en håndtere meget godt selv.
- Havde været gennem Blog Improver Agentens research- og verifikationsproces, som fanger forældede statistikker før publicering.
Artikler, der ikke ranked:
- Blev publiceret med minimalt eller intet menneskeligt redaktionelt lag. AI-genereret struktur og prosa uden tilføjet indsigt.
- Blev publiceret uden eller med meget få billeder, statistikker eller tabeller.
- Indeholdt hallucinerede eller forældede statistikker, der nedbrød tilliden og gav rettelser/bounce.
- Besvarede spørgsmål, som søgeren ikke stillede. De var teknisk set on-topic, men ikke i tråd med den faktiske søgeintention.
- Havde ensartet sætningsstruktur og formelagtige formuleringer, der fik læserne til at trykke tilbage, før de var færdige.
- Havde ubehageligt lange afsnit og for mange lister eller opremsende sætninger.
- Dækkede brede emner med meget lidt dybde, tal eller specifikke detaljer.
Husk, at Google ikke straffer AI-indhold alene på grund af dets oprindelse. Det er fraværet af de ting, der gør indhold værd at læse, uanset hvem der skrev det. Godt indhold har altid brug for specificitet, nøjagtighed, et originalt perspektiv og ægte nytteværdi for nogen med et reelt spørgsmål.
