


AI-innehållsdetektering för SEO är ett av de mest missförstådda ämnena inom innehållsmarknadsföring just nu. Många hävdar att Google helt enkelt bestraffar allt AI-skrivet innehåll. Men denna rädsla bygger på en felaktig tolkning av vad som faktiskt händer.
Google bestraffar inte innehåll för att det är AI-genererat. Det bestraffar innehåll som är lågkvalitativt, har låg ämnesrelevans, är oanvändbart och tunt. Här är vad bevisen faktiskt visar, vilka AI-mönster som utlöser engagemangs- och kvalitetssignaler, och hur du kan producera AI-assisterat innehåll som rankar.
Vad Google faktiskt säger om AI-innehåll 2026
Googles officiella dokumentation säger att “Googles rankningssystem syftar till att belöna originellt innehåll av hög kvalitet som uppvisar egenskaper av det vi kallar E-E-A-T: expertis, erfarenhet, auktoritet och trovärdighet. Våra system utvärderar innehållets kvalitet, inte huruvida innehållet är AI-genererat.”
De riktlinjer som specifikt riktar sig mot AI-innehåll är Googles spamriktlinjer, som handlar om “automatiskt genererat innehåll avsett att manipulera sökrankningar”. Formuleringen är “avsett att manipulera”, inte “genererat av AI”.
Med andra ord bestraffar det vagt massproducerat innehåll som enbart fokuserar på att samla nyckelord i stället för att svara på frågor eller, hemska tanke, erbjuda faktiska originella insikter eller underhållningsvärde. Å andra sidan kan en AI-genererad artikel som använder dina egna data, insikter och din röst lätt bli din bäst rankade text hittills.
Det är därför AI-skrivandets SEO-påverkan 2026 inte handlar om det AI-genererade innehållet i sig, utan om att det tenderar att misslyckas med de kvalitetsmått som Google alltid har brytt sig om. Men ännu viktigare: att orsakerna till det är förutsägbara och går att åtgärda. Så här.
Hur verktyg för AI-innehållsdetektering fungerar (och deras träffsäkerhet)
Förutom andra mindre egenskaper förlitar sig AI-detektorer mestadels på två stora statistiska egenskaper. Den första är perplexitet. Det är hur förutsägbart varje ordval är med tanke på vad som kom före det. Språkmodeller genererar mycket förutsägbara sekvenser medan mänskliga skribenter oftare gör oväntade val. Den andra är burstiness, eller hur stor variationen är mellan meningar. AI-output tenderar mot enhetlig meningslängd och struktur; mänskligt skrivande varierar betydligt. Den kontrollerar också vanliga AI-fraser och stilistiska val, samt andra egenskaper.
Dessa egenskaper skapar ett igenkännbart statistiskt fingeravtryck som detekteringsverktyg som GPTZero och Turnitin mäter. Mot rå, oredigerad AI-output är dessa verktyg ganska tillförlitliga. Mot humaniserat, redigerat eller mänskligt granskat innehåll är andelen falska positiva mycket högre.
Kom ihåg att Google inte använder dessa AI-detekteringsverktyg för rankningsbeslut. I stället använder det sina egna kvalitetssignaler, oavsett innehållets ursprung. Det kontrollerar engagemangsmått, E-E-A-T-bedömning, innehållets djup och ämnesauktoritet.
Summan av kardemumman är att en sida som klarar alla AI-detektorer inte är immun mot en kvalitetsbestraffning, och en sida som misslyckas i alla detektorer inte bestraffas enbart av den anledningen.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Mönstren som gör AI-innehåll generiskt och lågkvalitativt
Vad Googles system faktiskt utvärderar är huruvida innehållet tillfredsställer sökarens avsikt bättre än konkurrerande sidor. De specifika AI-skrivmönster som mest konsekvent misslyckas i detta test är:
- Ingen förstahandserfarenhet eller perspektiv. AI kan sammanfatta, men det kan inte rapportera. Innehåll som beskriver vad “många experter anser” utan att visa någon specifik expertis, siffror, citat eller förstahandskunskap misslyckas med erfarenhetskomponenten i E-E-A-T.
- Inga originella data eller proprietära insikter. Om varje mening i en artikel kunde ha skrivits utifrån en Wikipedia-sammanfattning och en handfull befintliga blogginlägg tillför den ingenting. Googles system blir allt bättre på att identifiera när en sida bidrar med något nytt.
- Faktafel och hallucinationer. AI-modeller genererar information som låter trolig men ibland är felaktig. En självsäker, välformulerad artikel med felaktiga fakta är både ett misslyckande med kvalitetssignalen och ett svek mot läsarnas förtroende.
- Tunt innehåll i förhållande till sökavsikten. En AI-artikel om “hur man skriver en metabeskrivning” som inte tar upp teckengränser, konsekvenser för klickfrekvens eller vanliga misstag är tunn, oavsett hur den skrevs.
- Formelartade inledningar och generiska formuleringar. Fraser som “I dagens digitala landskap”, “Det är avgörande att notera att”, “Med AI:s framväxt…” har blivit synonyma med AI-skräp och signalerar omedelbart till läsarna (och engagemangsmåtten) att sidan inte är värd att läsa noggrant.
Kom ihåg att Googles ranknings- och kvalitetssignaler är äldre än AI. AI gör det bara enklare att producera innehåll som misslyckas med dem i stor skala.
Vad “hjälpsamt innehåll” betyder för AI-assisterat skrivande
Googles Helpful Content System utvärderar huruvida innehållet “skapades i första hand för människor” snarare än “i första hand för sökmotorer”. För AI-assisterat innehåll handlar den skillnaden om vad det mänskliga lagret bidrar med.
Kvalitetsingredienserna som skiljer hjälpsamt AI-assisterat innehåll från generisk AI-output:
- Originella exempel och fallstudier. “När vi testade detta med 200 användare upptäckte vi…” väger tyngre än “många användare rapporterar…”.
- Expertterminologi som används korrekt. Inte nyckelordsplacering, utan den typ av korrekt, precis språk som signalerar någon som faktiskt kan ämnet.
- Uppdaterade, verifierade data. Att citera en studie från 2023 år 2026 är en kvalitetsflagga. Att ersätta den med aktuell forskning är inte valfritt för konkurrensutsatta ämnen.
- Ärlig hantering av nyanser och avvägningar. AI tenderar att vara diplomatiskt balanserad. Hjälpsamt innehåll backar inte för tydliga åsikter, resonemang och förklaringar.
AI är utmärkt för att generera struktur, research och ett första utkast. Det mänskliga bidraget är lagret som inte kan genereras. Det är erfarenheten, omdömet, de proprietära data och den unika rösten.
Den goda nyheten är att du absolut kan lära FlowHunt att låta som du. Mata in dina proprietära data, fallstudier, varumärkesriktlinjer och föredragna exempel via kunskapskällor och konfigurera hur dina agenter skriver och beter sig via agentinstruktioner . Det minskar kraftigt tiden som läggs på korrekturläsning och på att tillföra det värde som AI ensam saknade, eftersom AI:n redan har tillgång till det den behöver. Och ännu viktigare: de flesta gör inte detta. De publicerar antingen slumpmässigt skräp utan en andra tanke eller tar till onödigt mycket manuellt arbete.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Hur du humaniserar AI-innehåll specifikt för SEO
AI Text Humanizer förbättrar den skriftliga kvaliteten som håller läsarna kvar på sidan. Det engagemanget, mätt genom tid på sidan, scrollningsdjup och återkommande besök, är vad sökmotorer använder som en indirekt signal om innehållets kvalitet.
Verktygets process tar direkt itu med de mönster som skadar AI-innehållets prestanda:
- Analys av ton och avsikt — den identifierar huruvida innehållet är informativt, övertygande eller instruerande och skriver sedan om för att matcha den avsikten med naturligt språk. Felmatchad avsikt (en artikel som läses som en produktsäljande text när sökaren ville ha en förklaring) är en signal om att besökaren lämnar sidan.
- Borttagning av AI-mönster — överanvända fraser som “inom ramen för”, “utnyttja” och “det är värt att notera att” ersätts med enkelt, direkt språk. Dessa fraser läses inte bara som AI-genererade, de signalerar låg informationsdensitet till läsarna.
- Omskrivning till naturligt språk — stelbenta formuleringar, enhetlig meningslängd och mekaniska övergångar ersätts med det varierade, idiomatiska språk som skapar genuint engagemang.
- Målgruppsanpassning — ordförråd och meningsstruktur justeras för att matcha dina faktiska läsare. Text som är alltför formell eller alltför enkel tappar publiken innan innehållet har en chans att landa.
Efter humaniseringen tillför det redaktionella lagret de E-E-A-T-signaler som skiljer auktoritativt innehåll från kompetent innehåll. Om du matar in din förstahandserfarenhet, dina proprietära data och varumärkesexempel i FlowHunt via kunskapskällor kan AI:n automatiskt använda dem i varje framtida körning. Det som förblir mänskligt är den slutliga granskningen och bedömningarna, inte datainmatningen.
Det optimala AI + människa-arbetsflödet för innehåll som rankar
Det ideala AI-assisterade arbetsflödet för innehåll som faktiskt rankar har fyra lager.
Researchbaserad generering. Att börja med ett utkast grundat i aktuella källor och strukturerat kring den faktiska sökavsikten, inte en prompt som lyfter fram vad modellen redan vet. Det innebär att hämta livedata, verifiera dem mot verkliga sökresultat och bygga en disposition kring vad frågan faktiskt behöver.
Humanisering. Att ta bort de statistiska och stilistiska mönster som får AI-output att kännas genererad och skriva om för genuin röst och naturlig meningsvariation. Det strukturella utkastet från steg ett är sällan redo att publiceras som det är.
Kontextberikning. Att föra in proprietära data, varumärkesexempel och ämneskunnande. Detta är lagret som tillför E-E-A-T-signaler och skiljer texten från de hundra andra artiklarna som skrivits om samma ämne. Du kan lägga till detta manuellt vid granskningen, eller lära AI:n din kontext i förväg så att den automatiskt använder dessa i varje framtida körning.
SEO-verifiering. Att kontrollera utkastet mot livedata från sökningar, uppdatera eventuell inaktuell statistik och skärpa rubrikstruktur och metadata före publicering.
FlowHunt har verktyg för vart och ett av dessa lager, byggda för att kopplas samman till en enda pipeline. Så här fungerar var och en i praktiken.
Steg 1: AI Blog Writer — generera det researchbaserade utkastet
AI Blog Writer följer en process i tre faser: research (frågar livekällor efter aktuella data, statistik och tekniska insikter), analys (syntetiserar den insamlade informationen till centrala infallsvinklar och ramverk) och utförande (skriver hela artikeln i ren Markdown). Detta producerar ett strukturerat, evidensbaserat utkast.
Steg 2: AI Text Humanizer — ta bort AI-mönster, lägg till röst
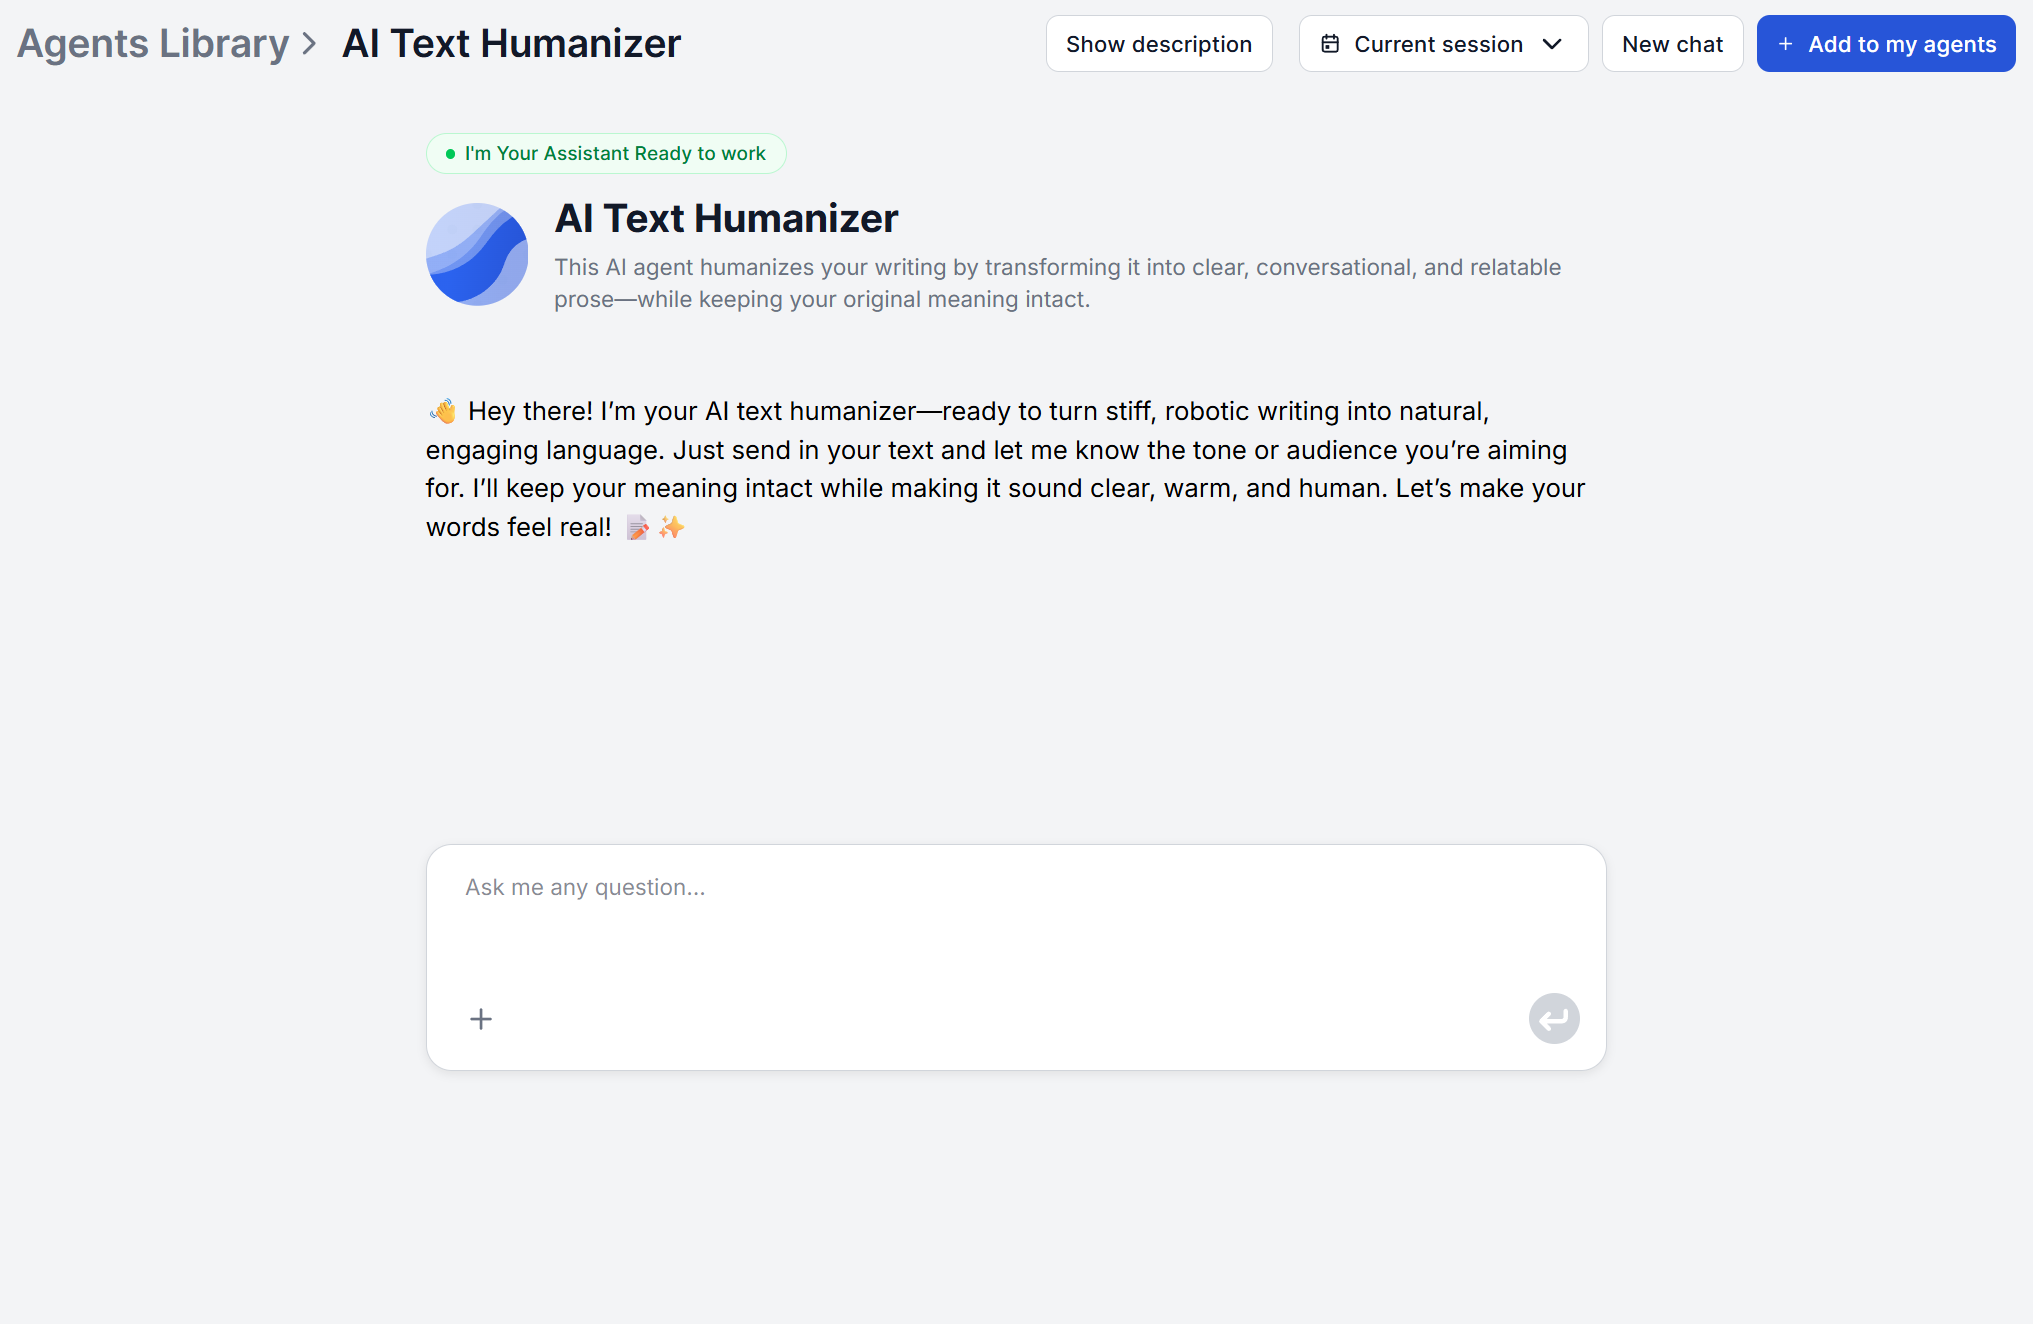
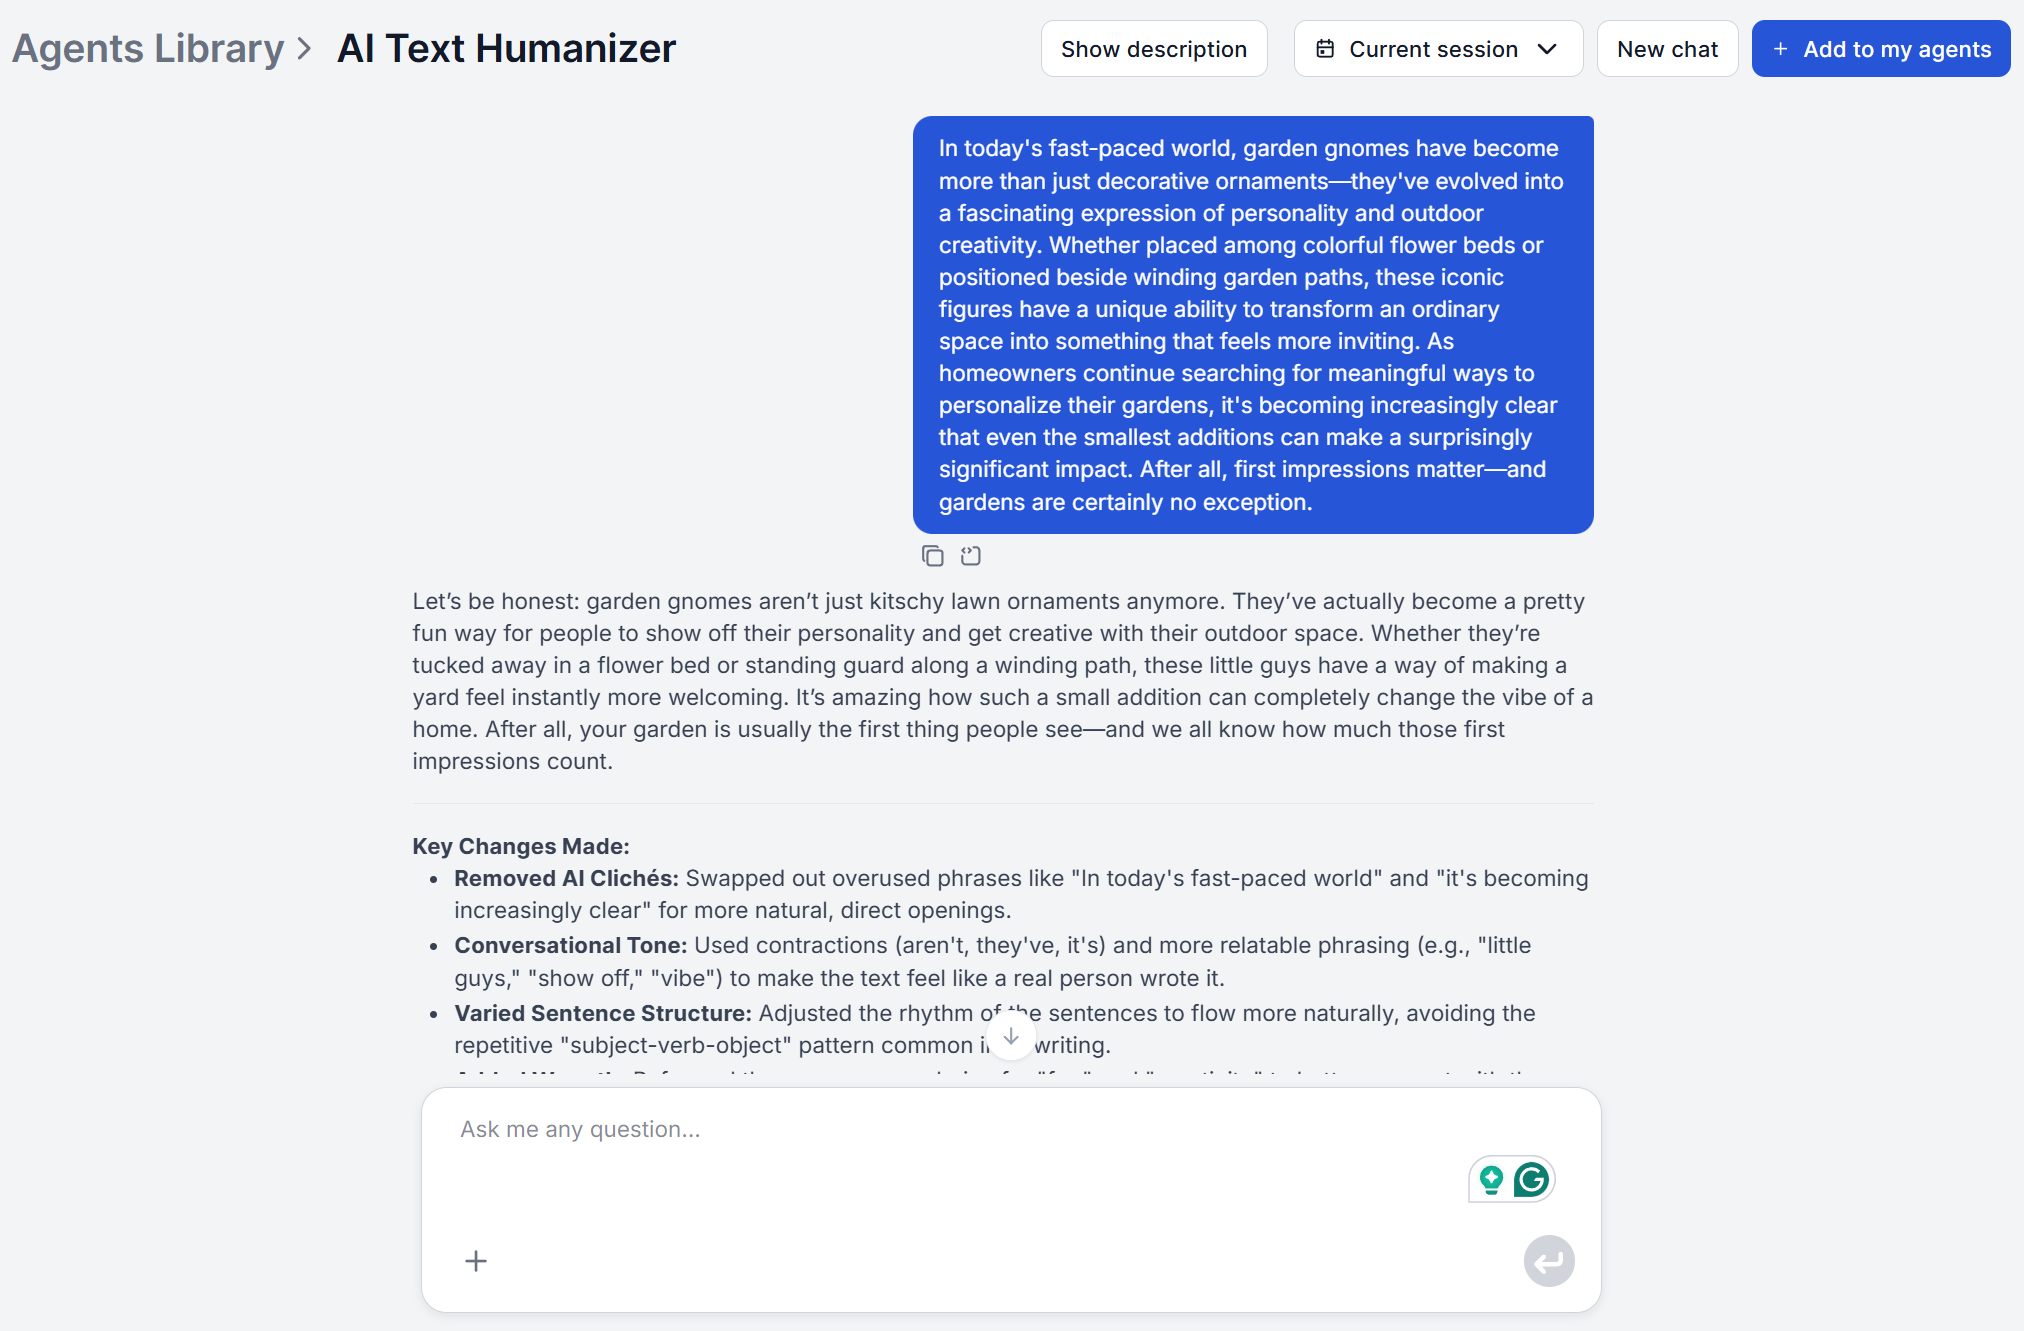
AI Text Humanizer täcker analys av ton och avsikt, omskrivning till naturligt språk, borttagning av AI-mönster och förenkling av komplexitet i en enda körning. Resultatet är ett läsbart utkast med naturlig röst som inte längre läses som genererat.
Steg 3: Lägg till din röst och dina data via FlowHunt
Genom att mata in din förstahandserfarenhet, dina fallstudier, din varumärkesröst och dina proprietära data i FlowHunt via kunskapskällor och agentinstruktioner lär du AI:n att automatiskt använda dessa i varje framtida körning. Det mänskliga steget blir då att verifiera påståenden, kontrollera att texten låter rätt och fatta de bedömningar som bara en ämnesexpert kan fatta.
Steg 4: AI Blog Content Improver — researchberikning och SEO
AI Blog Content Improver kör en automatiserad förbättringsprocess i fyra steg. Den hämtar (hämtar inlägget via URL eller HTML), researchar och verifierar (korskontrollerar mot livekällor i Google Search och ArXiv), förbättrar (fyller luckor, uppdaterar inaktuell statistik, stärker svaga avsnitt), lägger till SEO och formatering (optimerar rubrikstruktur, infogar nyckelord naturligt, förfinar metadata).
Data från 50 riktiga AI-artiklar: vad rankade och vad gjorde det inte
Bland de AI-genererade och AI-assisterade artiklar vi har analyserat på FlowHunt är mönstren som skiljer rankande innehåll från icke-rankande innehåll konsekventa och förutsägbara.
Artiklar som rankade:
- Hade specifika, verifierbara datapunkter i stället för generiska påståenden. Vi ser alltid till att antingen tillhandahålla data och källor, eller låta AI göra realtidsresearch på internet.
- Innehöll minst ett perspektiv eller exempel som inte kunde ha kommit från träningsdata, till exempel ett proprietärt testresultat, ett namngivet kundcase eller en specifik verktygsjämförelse gjord på aktuella indata. Vi har till exempel berikat en grundläggande genererad artikel genom att centrera den kring de starka åsikter vår VD delade i ett LinkedIn-inlägg.
- Var strukturerade kring vad sökaren faktiskt behövde, inte kring ämnet i abstrakt form. Komplett med relevanta genererade vanliga frågor.
- Använde naturlig, varierad prosa. Vårt bäst rankade innehåll gick igenom omfattande mänsklig bearbetning, särskilt i inledningar och avslutningar. Personligt och åsiktsdrivet mänskligt språk fick läsarna att stanna på sidan, vilket skapade de engagemangssignaler som stöder rankning. Men vi rör sällan de allmänna förklarande avsnitten som sätter ämnet. AI hanterar det mycket bra på egen hand.
- Hade gått igenom Blog Improver Agentens research- och verifieringssteg, vilket fångade inaktuell statistik före publicering.
Artiklar som inte rankade:
- Publicerades med minimalt eller inget mänskligt redaktionellt lager. AI-genererad struktur och prosa utan tillförd insikt.
- Publicerades med inga eller väldigt få bilder, statistik eller tabeller.
- Innehöll hallucinerad eller inaktuell statistik som urholkade förtroendet och genererade rättelser/avhopp.
- Svarade på frågor som sökaren inte ställde. De var tekniskt sett relevanta för ämnet, men inte i linje med den faktiska sökavsikten.
- Hade enhetlig meningsstruktur och formelartade formuleringar som drev läsarna att gå tillbaka innan de läst klart.
- Hade obehagligt långa stycken och för många listor eller uppräknande meningar.
- Täckte breda ämnen med väldigt lite djup, siffror eller konkreta detaljer.
Kom ihåg att Google inte kommer att bestraffa AI-innehåll enbart för dess ursprung. Det är frånvaron av det som gör innehåll värt att läsa, oavsett vem som skrev det. Bra innehåll behöver alltid specificitet, noggrannhet, ett originellt perspektiv och genuin användbarhet för någon med en verklig fråga.
