


Detekce AI obsahu pro SEO je momentálně jedno z nejvíce nepochopených témat v obsahovém marketingu. Mnozí tvrdí, že Google prostě penalizuje veškerý obsah napsaný AI. Tento strach však vychází z nesprávného výkladu toho, co se ve skutečnosti děje.
Google nepenalizuje obsah za to, že byl vygenerován AI. Penalizuje obsah za to, že je nekvalitní, má nízkou relevanci k tématu, je neužitečný a plytký. Tady je, co ve skutečnosti ukazují důkazy, které vzorce AI spouštějí signály angažovanosti a kvality a jak vytvářet obsah s asistencí AI, který se umisťuje.
Co Google o AI obsahu v roce 2026 skutečně říká
Oficiální dokumentace Googlu uvádí, že „rankingové systémy Googlu mají za cíl odměňovat originální, vysoce kvalitní obsah, který vykazuje vlastnosti toho, co nazýváme E-E-A-T: odbornost, zkušenost, autoritativnost a důvěryhodnost. Naše systémy hodnotí kvalitu obsahu, ne to, zda byl obsah vygenerován AI."
Zásady, které se specificky zaměřují na AI obsah, jsou Google Spam Policies, které řeší „automaticky generovaný obsah určený k manipulaci s výsledky vyhledávání". Klíčová je fráze „určený k manipulaci", nikoli „vygenerovaný AI".
Jinými slovy, penalizuje vágní masově produkovaný obsah zaměřený jen na těžení klíčových slov místo odpovídání na dotazy nebo — nedej bože — poskytování skutečných originálních poznatků či zábavní hodnoty. Na druhou stranu se článek vygenerovaný AI, který využívá vaše vlastní data, poznatky a váš hlas, může snadno stát vaším nejlépe umístěným textem.
Proto dopad AI psaní na SEO v roce 2026 nespočívá v samotném AI-generovaném obsahu, ale v tom, že obvykle selhává v metrikách kvality, na kterých Googlu vždy záleželo. A co je nejdůležitější — důvody tohoto selhání jsou předvídatelné a opravitelné. Tady je návod.
Jak fungují nástroje pro detekci AI obsahu (a jak jsou přesné)
Kromě dalších drobných vlastností se AI detektory spoléhají hlavně na dvě hlavní statistické vlastnosti. První je perplexita. Ta udává, jak předvídatelná je volba každého slova vzhledem k tomu, co mu předcházelo. Jazykové modely generují vysoce předvídatelné sekvence, zatímco lidští autoři častěji volí nečekané možnosti. Druhou je burstiness (nepravidelnost), tedy jak velká variace existuje mezi větami. Výstup AI směřuje k jednotné délce a struktuře vět; lidské psaní se výrazně liší. Nástroje také kontrolují běžné AI fráze a stylistické volby i další vlastnosti.
Tyto vlastnosti vytvářejí rozpoznatelný statistický otisk, který měří nástroje jako GPTZero a Turnitin. Ve srovnání s neupraveným výstupem AI jsou tyto nástroje poměrně spolehlivé. U humanizovaného, editovaného nebo lidsky revidovaného obsahu jsou míry falešně pozitivních výsledků mnohem vyšší.
Pamatujte, že Google tyto nástroje pro detekci AI nepoužívá pro rozhodování o umístění. Místo toho používá vlastní signály kvality bez ohledu na původ obsahu. Sleduje metriky angažovanosti, hodnocení E-E-A-T, hloubku obsahu a tematickou autoritu.
Základní pointa je, že stránka, která projde všemi AI detektory, není imunní vůči penalizaci za kvalitu, a stránka, která neprojde žádným detektorem, není penalizována jen z tohoto důvodu.

Připraveni rozšířit své podnikání?
Začněte svou bezplatnou zkušební verzi ještě dnes a viďte výsledky během několika dní.
Vzorce, které dělají AI obsah generickým a nekvalitním
Co systémy Googlu skutečně hodnotí, je to, zda obsah naplňuje záměr hledajícího lépe než konkurenční stránky. Konkrétní vzorce psaní AI, které v tomto testu nejčastěji selhávají, jsou:
- Žádná zkušenost nebo pohled z první ruky. AI umí shrnout, ale neumí reportovat. Obsah, který popisuje, čemu „věří mnoho odborníků", aniž by prokázal jakoukoli konkrétní odbornost, čísla, citace nebo znalost z první ruky, selhává ve složce Experience (zkušenost) v rámci E-E-A-T.
- Žádná původní data ani vlastní vhled. Pokud by každou větu v článku šlo napsat ze shrnutí na Wikipedii a několika existujících blogových příspěvků, nic nepřináší. Systémy Googlu jsou stále lepší v rozpoznávání toho, kdy stránka přispívá něčím novým.
- Faktické chyby a halucinace. AI modely generují informace, které znějí věrohodně, ale někdy jsou nesprávné. Sebevědomý, plynulý článek s nesprávnými fakty je selháním signálu kvality i selháním důvěry čtenáře.
- Plytké pokrytí záměru dotazu. AI článek o „tom, jak napsat meta popis", který se nezabývá limity znaků, dopadem na míru prokliku nebo běžnými chybami, je plytký bez ohledu na to, jak byl napsán.
- Formulkovité úvody a generické fráze. Fráze jako „V dnešní digitální krajině", „Je důležité poznamenat, že", „S nástupem AI…" se staly synonymem pro AI brak a čtenářům (i metrikám angažovanosti) okamžitě signalizují, že stránka nestojí za pozorné čtení.
Pamatujte, že signály kvality pro umístění ve vyhledávači Googlu existovaly dávno před AI. AI jen usnadňuje produkovat obsah, který v nich selhává, a to ve velkém měřítku.
Co znamená „užitečný obsah" pro psaní s asistencí AI
Systém Helpful Content Googlu hodnotí, zda byl obsah „vytvořen primárně pro lidi", a ne „primárně pro vyhledávače". U obsahu s asistencí AI se tento rozdíl odvíjí od toho, čím přispívá lidská vrstva.
Kvalitativní ingredience, které odlišují užitečný obsah s asistencí AI od generického výstupu AI:
- Původní příklady a případové studie. „Když jsme to testovali s 200 uživateli, zjistili jsme…" má váhu, kterou „mnoho uživatelů uvádí…" nemá.
- Odborná terminologie používaná správně. Nejde o umísťování klíčových slov, ale o přesný a precizní jazyk, který prozrazuje někoho, kdo tématu skutečně rozumí.
- Aktualizovaná a ověřená data. Citovat v roce 2026 studii z roku 2023 je varovný signál kvality. Nahradit ji aktuálním výzkumem není u konkurenčních témat volitelné.
- Poctivé zacházení s nuancemi a kompromisy. AI má tendenci být diplomaticky vyvážená. Užitečný obsah se nevyhýbá jasnému názoru, zdůvodnění a vysvětlení.
AI je skvělá na generování struktury, rešerše a prvního draftu. Lidský přínos je vrstva, kterou nelze vygenerovat. Je to zkušenost, úsudek, vlastní data a jedinečný hlas.
Dobrá zpráva je, že FlowHunt rozhodně můžete naučit mluvit vaším stylem. Předejte mu svá vlastní data, případové studie, brand guidelines a oblíbené příklady prostřednictvím znalostních zdrojů a nakonfigurujte, jak vaši agenti píší a chovají se, pomocí instrukcí pro agenty . To výrazně zkracuje čas strávený korekturami a doplňováním hodnoty, která samotné AI chyběla, protože AI už má přístup k tomu, co potřebuje. A co je ještě důležitější — většina lidí to nedělá. Buď bez rozmýšlení publikují náhodný brak, nebo se uchylují ke zbytečnému množství ruční práce.
Přihlaste se k odběru newsletteru
Získejte nejnovější tipy, trendy a nabídky zdarma.
Jak humanizovat AI obsah konkrétně pro SEO
Nástroj AI Text Humanizer zlepšuje kvalitu psaní, která udrží čtenáře na stránce. Právě tuto angažovanost, měřenou časem na stránce, hloubkou scrollování a opakovanými návštěvami, používají vyhledávače jako nepřímý signál kvality obsahu.
Proces tohoto nástroje přímo řeší vzorce, které škodí výkonu AI obsahu:
- Analýza tónu a záměru — určí, zda je obsah informativní, přesvědčovací nebo instruktážní, a pak jej přepíše tak, aby tomuto záměru odpovídal přirozeným jazykem. Nesoulad záměru (článek, který zní jako produktová prezentace, když hledající chtěl vysvětlení) je signálem pro okamžité opuštění stránky.
- Odstranění vzorců AI — nadužívané fráze jako „v oblasti", „využít" nebo „stojí za zmínku, že" jsou nahrazeny prostým, přímým jazykem. Tyto fráze nejen působí jako generované AI, ale čtenářům signalizují nízkou informační hustotu.
- Přepis do přirozeného jazyka — strnulé formulace, jednotná délka vět a mechanické přechody jsou nahrazeny rozmanitým, idiomatickým jazykem, který vytváří skutečnou angažovanost.
- Cílení na publikum — slovní zásoba a struktura vět se přizpůsobují vašim skutečným čtenářům. Text napsaný příliš formálně nebo příliš jednoduše ztratí publikum dřív, než obsah stihne zabrat.
Po humanizaci přidává redakční vrstva signály E-E-A-T, které odlišují autoritativní obsah od kompetentního obsahu. Pokud do FlowHuntu vložíte své zkušenosti z první ruky, vlastní data a příklady z vaší značky prostřednictvím znalostních zdrojů , AI z nich může automaticky čerpat při každém dalším běhu. Lidské zůstává finální revize a úsudky, ne zadávání dat.
Optimální pracovní postup AI + člověk pro obsah, který se umisťuje
Ideální pracovní postup s asistencí AI pro obsah, který se skutečně umisťuje, má čtyři vrstvy.
Generování podložené rešerší. Začíná draftem postaveným na aktuálních zdrojích a strukturovaným podle skutečného záměru vyhledávání, ne podle promptu, který vytáhne, co model už zná. To znamená získávat živá data, ověřovat je proti skutečným výsledkům vyhledávání a stavět osnovu kolem toho, co dotaz skutečně potřebuje.
Humanizace. Odstranění statistických a stylistických vzorců, kvůli kterým výstup AI působí generovaně, a přepsání pro skutečný hlas a přirozenou variaci vět. Strukturální draft z prvního kroku je málokdy připraven k přímému publikování.
Obohacení kontextu. Přinesení vlastních dat, příkladů značky a odborného úsudku. To je vrstva, která přidává signály E-E-A-T a odlišuje text od stovky dalších článků napsaných na stejné téma. Můžete ji přidat ručně při revizi, nebo naučit AI váš kontext předem, aby z něj automaticky čerpala při každém dalším běhu.
SEO ověření. Kontrola draftu proti živým datům vyhledávání, aktualizace zastaralých statistik a zpřesnění struktury nadpisů a metadat před publikací.
FlowHunt má nástroje pro každou z těchto vrstev, navržené tak, aby se propojily do jedné pipeline. Tady je, co každý z nich dělá v praxi.
Krok 1: AI Blog Writer — vygenerujte draft podložený rešerší
Nástroj AI Blog Writer postupuje ve třech fázích: rešerše (dotazování živých zdrojů na aktuální data, statistiky a technické poznatky), analýza (syntéza získaných informací do klíčových úhlů a rámců) a exekuce (napsání celého článku v čistém Markdownu). Výsledkem je strukturovaný draft podložený důkazy.
Krok 2: AI Text Humanizer — odstraňte vzorce AI a přidejte hlas
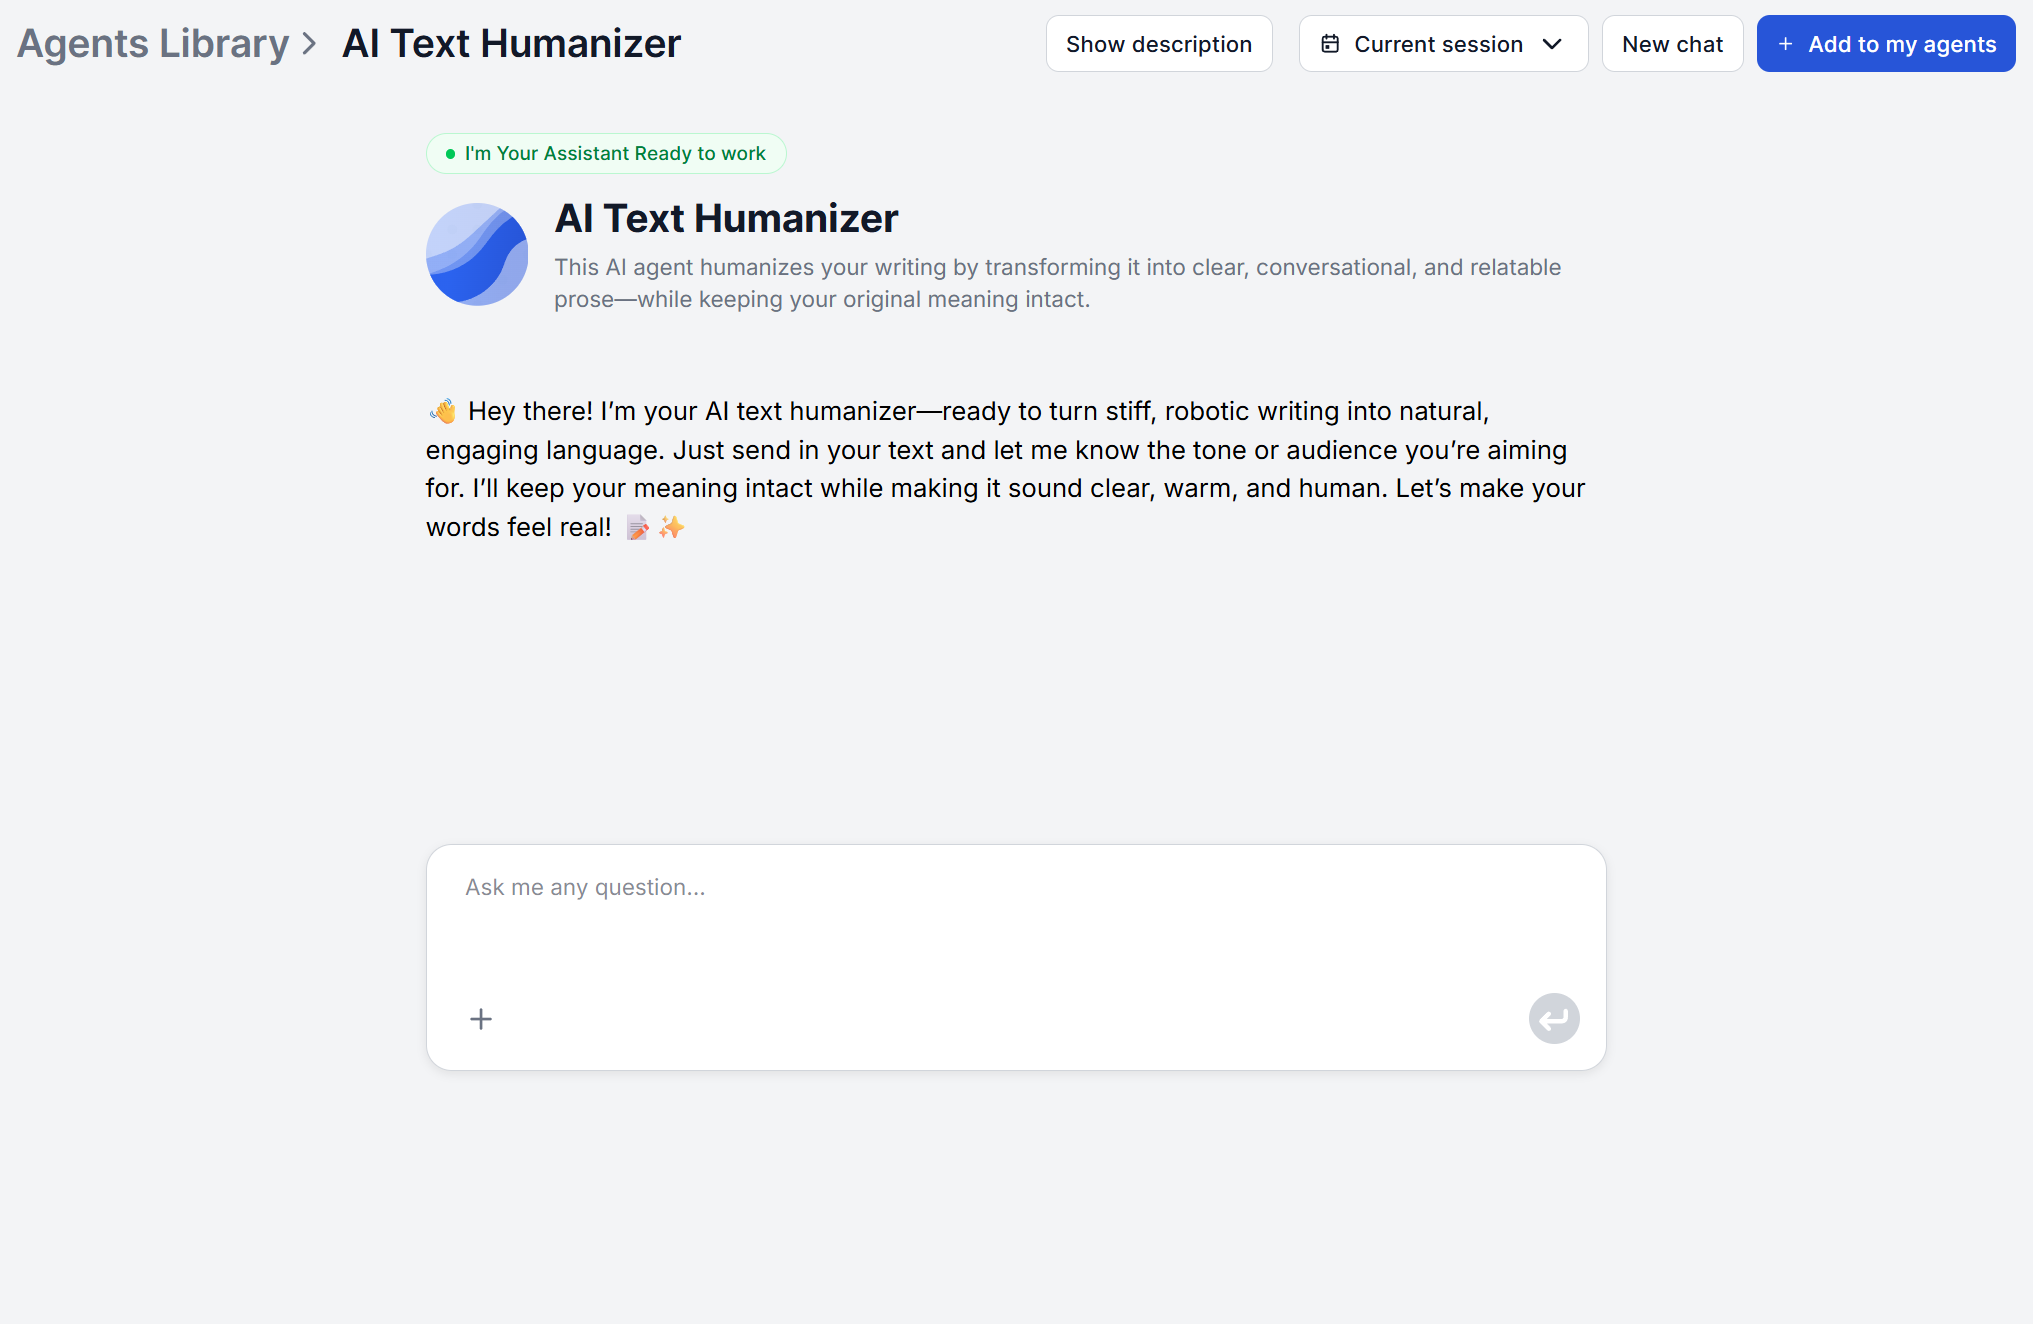
Nástroj AI Text Humanizer zvládne analýzu tónu a záměru, přepis do přirozeného jazyka, odstranění vzorců AI a zjednodušení složitosti v jednom kroku. Výstupem je čitelný draft s přirozeným hlasem, který už nepůsobí generovaně.
Krok 3: Přidejte svůj hlas a data přes FlowHunt
Tím, že do FlowHuntu vložíte své zkušenosti z první ruky, případové studie, hlas značky a vlastní data prostřednictvím znalostních zdrojů a instrukcí pro agenty , naučíte AI čerpat z nich automaticky při každém dalším běhu. Lidským krokem se pak stává ověřování tvrzení, kontrola, že text zní správně, a rozhodnutí, která může učinit jen odborník na danou oblast.
Krok 4: AI Blog Content Improver — obohacení rešerší a SEO
Nástroj AI Blog Content Improver provádí automatizované vylepšení ve čtyřech krocích. Načte (získá příspěvek přes URL nebo HTML), provede rešerši a ověření (křížově porovná s živými zdroji Google Search a ArXiv), vylepší (doplní mezery, aktualizuje zastaralé statistiky, posílí slabé sekce), přidá SEO a formátování (optimalizuje strukturu nadpisů, přirozeně zapracuje klíčová slova, zpřesní metadata).
Data z 50 skutečných AI článků: co se umístilo a co ne
Napříč články generovanými AI a s asistencí AI, které jsme ve FlowHuntu analyzovali, jsou vzorce odlišující obsah, který se umisťuje, od toho, který ne, konzistentní a předvídatelné.
Články, které se umístily:
- Měly konkrétní, ověřitelné datové body místo obecných tvrzení. Vždy se snažíme buď dodat data a zdroje, nebo nechat AI provést rešerši na internetu v reálném čase.
- Obsahovaly alespoň jeden pohled nebo příklad, který nemohl pocházet z trénovacích dat — například výsledek vlastního testu, případovou studii s uvedeným klientem nebo srovnání konkrétních nástrojů provedené na aktuálních vstupech. Například jsme obohatili základní vygenerovaný článek tím, že jsme ho postavili kolem silných názorů, které náš CEO sdílel v příspěvku na LinkedIn.
- Byly strukturovány kolem toho, co hledající skutečně potřeboval, ne kolem tématu v abstraktní rovině. Včetně relevantních generovaných FAQ.
- Používaly přirozený, rozmanitý jazyk. Náš nejlépe umístěný obsah prošel výraznými lidskými zásahy, zejména v úvodech a závěrech. Osobní a názorový lidský jazyk udržel čtenáře na stránce, což vytvořilo signály angažovanosti podporující umístění. Obecných vysvětlujících sekcí, které téma uvádějí, se ale dotýkáme jen zřídka. AI to sama zvládne velmi dobře.
- Prošly rešerší a ověřením agenta Blog Improver, který zachytí zastaralé statistiky před publikací.
Články, které se neumístily:
- Byly publikovány s minimální nebo žádnou lidskou redakční vrstvou. Struktura a text generované AI bez přidaného vhledu.
- Byly publikovány bez obrázků, statistik nebo tabulek, případně s velmi malým množstvím.
- Obsahovaly halucinované nebo zastaralé statistiky, které narušily důvěru a vedly k opravám a okamžitému opuštění stránky.
- Odpovídaly na otázky, které hledající nepokládal. Byly technicky k tématu, ale ne v souladu se skutečným záměrem vyhledávání.
- Měly jednotnou strukturu vět a formulkovité fráze, které čtenáře vedly k tomu, aby stiskli zpět, ještě než dočetli.
- Měly nepříjemně dlouhé odstavce a příliš mnoho seznamů nebo vyjmenovávacích vět.
- Pokrývaly široká témata s velmi malou hloubkou, čísly nebo konkrétnostmi.
Pamatujte, že Google nebude penalizovat AI obsah jen kvůli jeho původu. Jde o absenci věcí, které dělají obsah hodným přečtení, bez ohledu na to, kdo ho napsal. Dobrý obsah vždy potřebuje konkrétnost, přesnost, originální pohled a skutečnou užitečnost pro někoho s reálnou otázkou.
