


Att skriva dokumentation manuellt innebär att själv läsa koden eller processen, avgöra vad som är viktigt och sedan skriva ner det på den lediga tid som blir över efter leverans.
AI för tekniskt skrivande som användningsfall tar bort mellansteget. I stället för att beskriva vad ett system gör utifrån minnet pekar du AI:n mot själva källkoden, och den genererar förklaringen direkt från logiken. Allt som återstår för dig är att kontrollera att allt stämmer.
Men inte alla typer av dokumentation tjänar lika mycket på det. Vissa är nästan ren kod-till-förklaring, där AI har en tydlig snabbfördel. Andra behöver mer mänsklig inramning runt den AI-genererade kärnan. Här är fem specifika typer av dokumentation där FlowHunts AI-dokumentationsskrivare konsekvent överträffar manuellt skrivande.
För en genomgång av själva processen, se hur du automatiskt skriver teknisk dokumentation med AI .
För varför problemet finns över huvud taget, se varför utvecklardokumentation alltid är ofullständig .
Användningsfall 1: API-referensdokumentation
API-referenser är det närmaste man kommer ett bästa-fall för en AI-generator för API-dokumentation, eftersom sanningskällan (endpoint-hanterarna, SDK-metoderna, formerna för förfrågan och svar) redan finns i koden. Det finns inget att intervjua en utvecklare om som inte redan står i funktionssignaturerna.
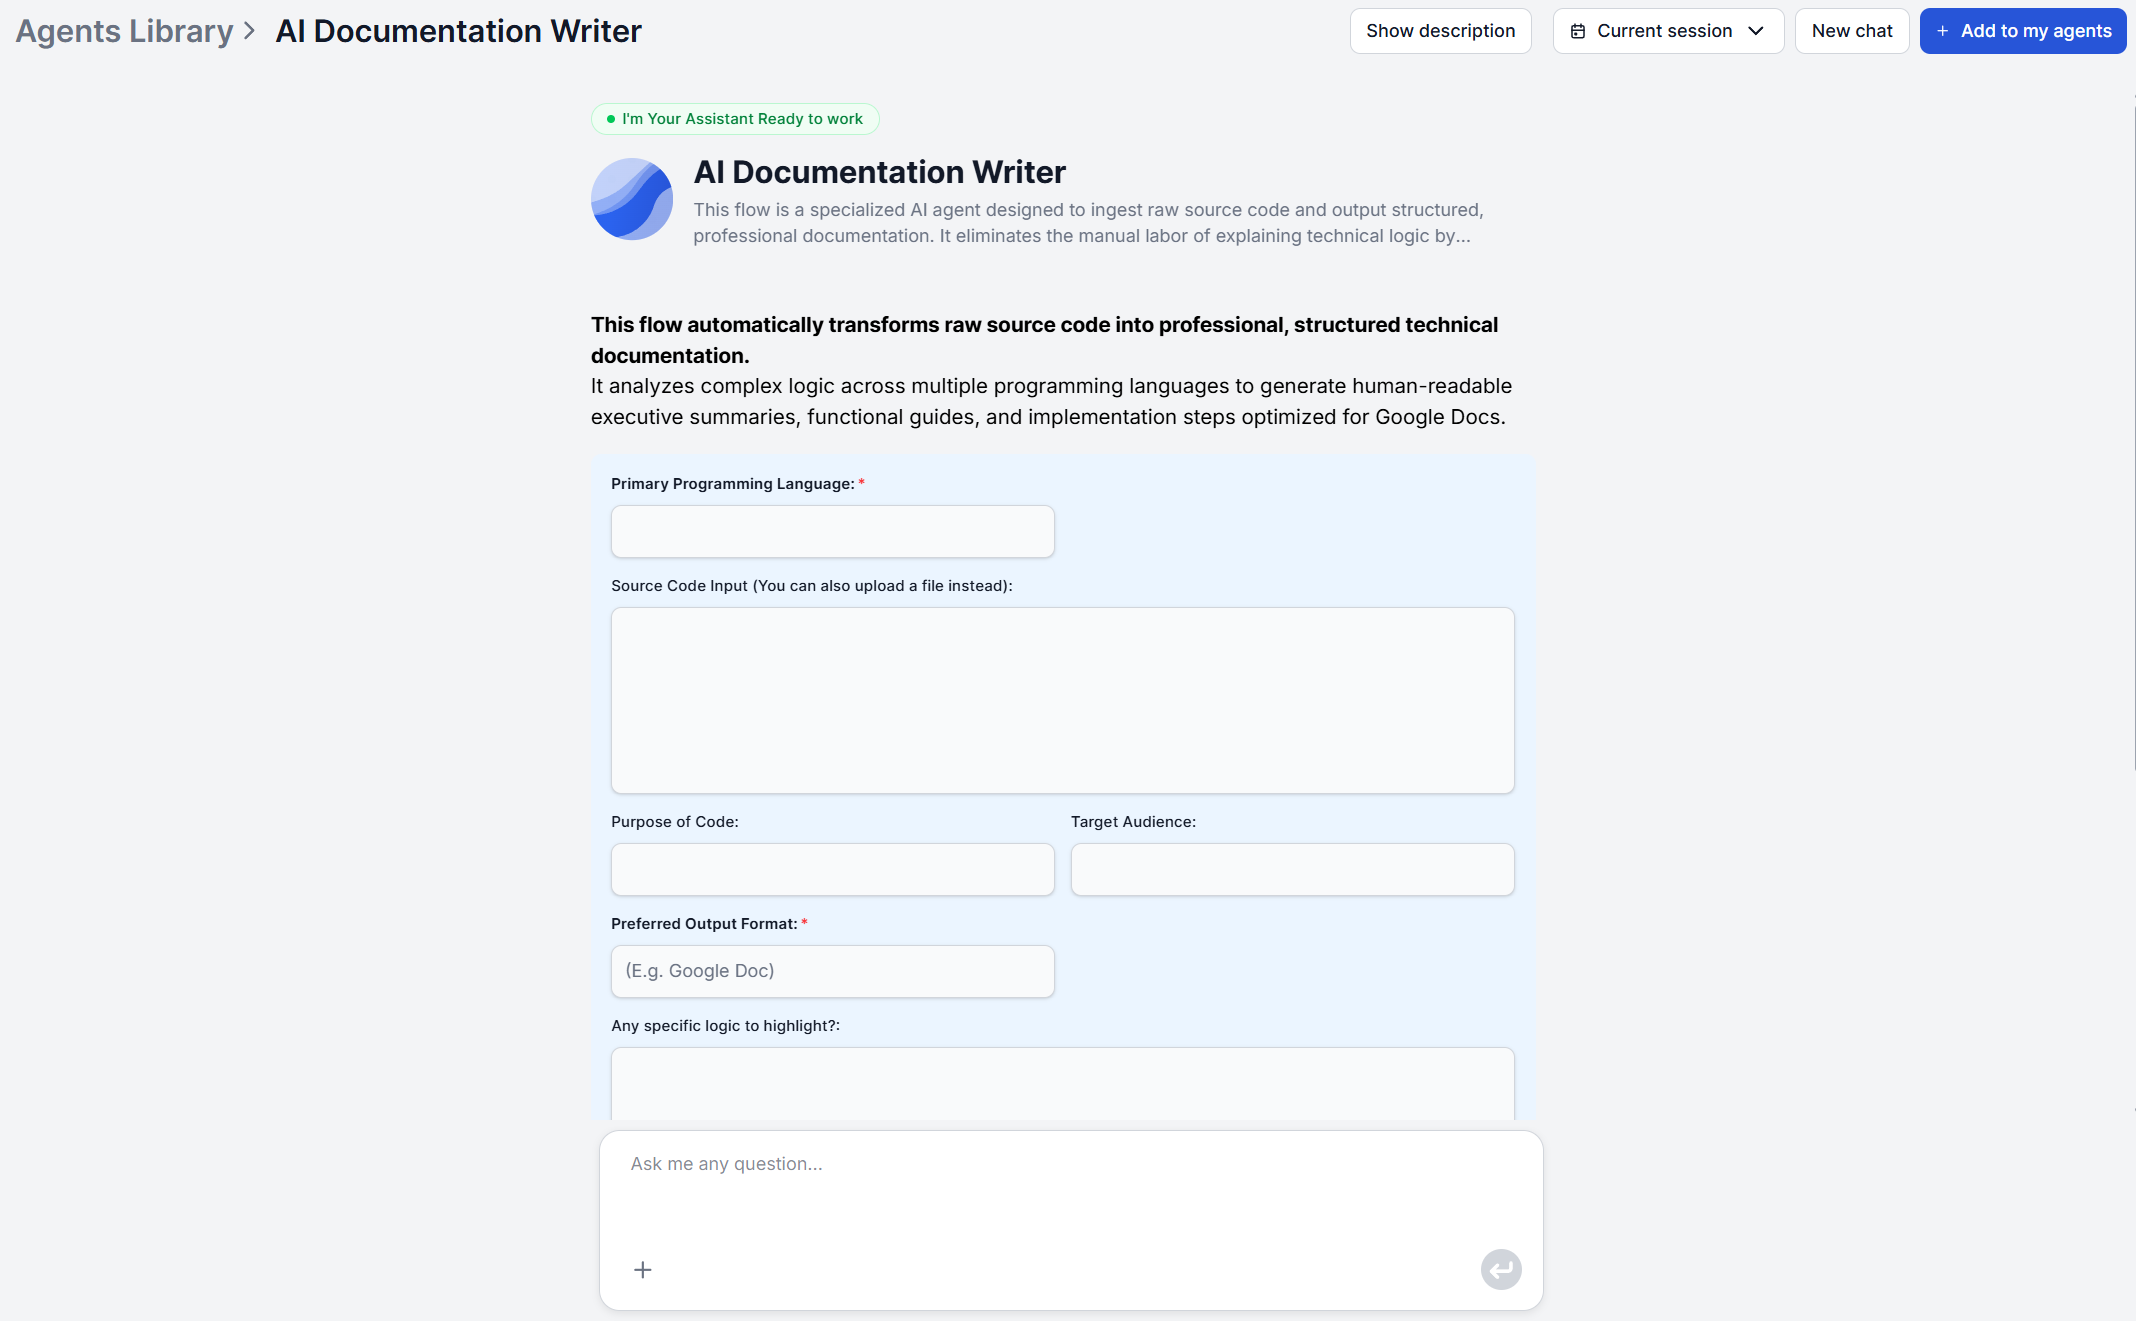
Peka AI-dokumentationsskrivaren mot din API-kod eller klistra bara in den i chatten, ställ in målgruppen på “utvecklare” eller “API-konsumenter” och använd inmatningen “specifik logik att lyfta fram” för att flagga allt som är lätt att missa och som bör granskas ordentligt. Avsnittet med nyckelfunktioner och komponenter i resultatet blir en fungerande referens, och avsnittet om teknisk arkitektur täcker hur delarna hänger ihop.
Snabbfördelen förstärks över tid. API-ytor förändras vid nästan varje release, en parameter läggs till, en endpoint fasas ut, och manuell dokumentation tenderar att hamna på efterkälken just vid dessa små, frekventa ändringar.
Att skriva en referens för tjugo endpoints för hand är en flerdagarsuppgift även för en utvecklare som känner kodbasen väl. Att generera om från aktuell kod tar bara några minuter, oavsett hur många gånger API:et har ändrats sedan förra versionen, och oavsett om det handlar om tjugo eller tvåhundra endpoints.
Användningsfall 2: Produktens release-anteckningar
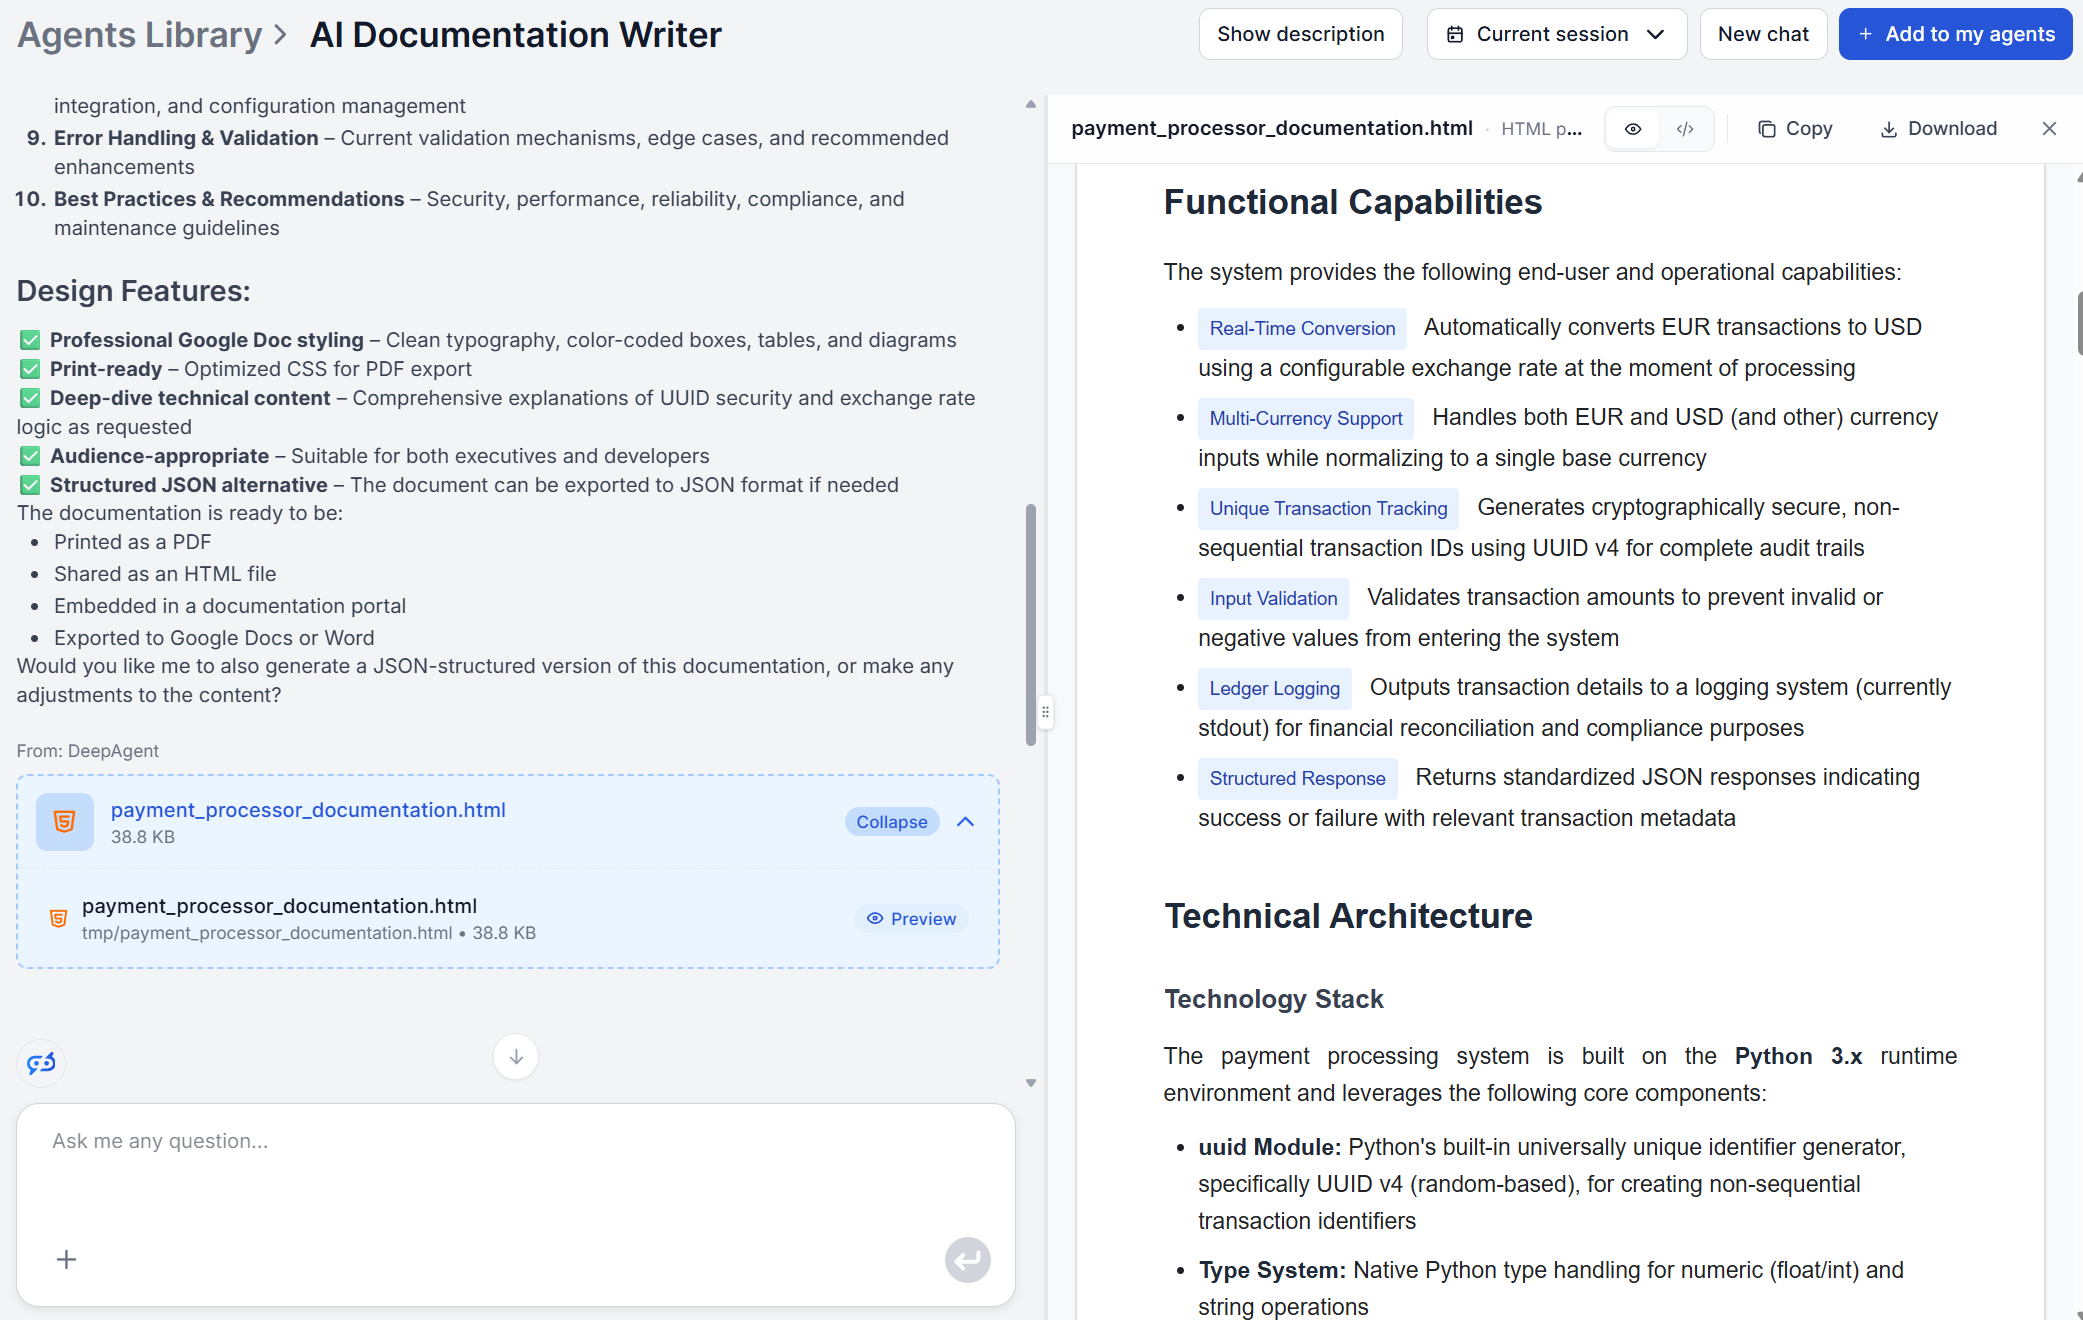
Release-anteckningar måste svara på vad som ändrats och varför det spelar roll. Det motsvarar nära två avsnitt som dokumentationsskrivaren redan producerar, nämligen sammanfattningen och listan över funktionella förmågor.
Ställ in syftet på “release-anteckningar för denna uppdatering”, målgruppen på “kunder” eller “slutanvändare” och mata in koden för den specifika funktionen eller korrigeringen. Steget för klarspråksöversättning gör arbetet med att förvandla en diff till en beskrivning som en icke-teknisk kund faktiskt kan förstå, utan att en skribent behöver intervjua ingenjören som byggde den.
Det är ändå värt en lätt redigeringsomgång efteråt. Release-anteckningar behöver vanligtvis en enhetlig röst och en specifik ordning (brytande ändringar först, sedan nya funktioner, sedan korrigeringar), och även om AI-resultatet ger dig korrekt råmaterial för varje punkt är det ett bedömningsbeslut för en människa att ordna och prioritera dem för en kundvänd changelog.

Redo att växa ditt företag?
Starta din kostnadsfria provperiod idag och se resultat inom några dagar.
Användningsfall 3: Användarhandledningar för onboarding
AI för produktdokumentation gör nytta med onboardingguider som egentligen bara är beskrivningar av verkliga konfigurationssteg, tillgängliga kommandon eller installationskrav som redan finns i koden. Ett CLI-verktyg, ett SDK eller en intern applikation är alla bra kandidater.
Kör samma källkod genom dokumentationsskrivaren, men ställ in målgruppen på “nya användare” eller “icke-tekniska intressenter”. Steget för logiköversättning byter ut utvecklartermer mot klarspråk med naturligt flöde, och avsnittet om implementering och användningsinstruktioner blir själva onboardingstegen, som täcker installation, konfiguration och första användning.
Avvägningen att känna till i förväg är att detta angreppssätt dokumenterar vad produkten gör och hur den konfigureras, inte varför en funktion finns ur ett produktmarknadsföringsperspektiv. För onboardinginnehåll som är mer berättande än instruerande bör du behandla AI-resultatet som den korrekta tekniska ryggraden och lägga till inramning runt det, i stället för att förvänta dig en färdig välkomstsekvens i linje med varumärket.
Detta spelar störst roll för utvecklarverktyg, där en ny användares första timme vanligtvis går åt till installation, autentisering och att köra ett första lyckat kommando. Att generera det avsnittet direkt från den faktiska installationskoden, i stället för från en utvecklares minne av hur installationen ska fungera, fångar upp de små inkonsekvenser (en flagga som bytt namn, ett konfigurationsalternativ som flyttats) som gör att onboardingguider tyst blir felaktiga inom några releaser.
Användningsfall 4: Interna SOP- och processdokument
Automatisering av intern dokumentation spelar störst roll här, eftersom intern processdokumentation förfaller snabbast. Den finns vanligtvis som institutionellt minne. En senior ingenjör som förklarar ett distributionsskript eller en onboardingautomatisering högt, utan att någon skriver ner det innan personen byter team eller lämnar företaget.
Om den förklaringen skedde i ett inspelat möte, kör den genom AI-generatorn för mötesrapporter först för att fånga kontexten som strukturerat protokoll innan den går förlorad. Mata sedan in själva skriptet tillsammans med automatiseringskoden i dokumentationsskrivaren, med målgruppen inställd på nya ingenjörer, för att producera det referensdokument som överlever att personen slutar.
Denna kombination löser två olika problem samtidigt. Mötesrapporten fångar den informella kontexten och resonemanget som inte finns i koden (varför processen fungerar så här), medan dokumentationsskrivaren fångar den korrekta tekniska detaljen om vad koden faktiskt gör.
Tillsammans producerar dessa två agenter den typ av onboardingreferens som en nyanställd faktiskt kan följa utan att dra in en senior ingenjör i ännu ett möte för att förklara samma skript en andra gång.
Gå med i vårt nyhetsbrev
Få de senaste tipsen, trenderna och erbjudandena gratis.
Användningsfall 5: Kunskapsbasartiklar
Kundvända kunskapsbasartiklar behöver en korrekt förklaring av hur en funktion faktiskt beter sig, och en formulering som matchar hur kunderna redan pratar om problemet. Dokumentationsskrivaren hanterar den första delen direkt: mata in koden bakom funktionen, ställ in målgruppen på “kunder” eller “supportteam”, och avsnitten om funktionella förmågor och användningsinstruktioner blir artikelns ryggrad.
Den sista punkten är den del som lättast hoppas över, och den avgör om artikeln faktiskt är användbar. En KB-artikel läses av någon mitt i ett problem, inte av någon som researchar, och dokumentationsskrivarens resultat med sex avsnitt är byggt för fullständighet, inte för korthet. Att klistra in allt i en supportartikel begraver den enda mening en frustrerad kund behöver under en arkitekturförklaring som ingen bad om.
Innan publicering: börja med ett svar på en eller två meningar, behåll avsnitten om funktionella förmågor och användningsinstruktioner, och stryk teknisk arkitektur samt nyckelfunktioner och komponenter om inte ditt supportteam verkligen behöver implementeringsdetaljer.
Hur du underhåller ett levande dokumentationssystem med AI
I alla fem användningsfall förändras aldrig den underliggande processen. Kodanalys, logiköversättning och dokumentstrukturering. Det som förändras är bara målgruppen, syftet och den specifika logik du anger för varje körning. Det är värt att hantera medvetet i stället för att uppfinna inmatningen på nytt varje gång.
Det lönar sig att hålla en kort, sparad inmatningsmall per dokumentationstyp: en för API-referenser (målgrupp: utvecklare), en för release-anteckningar (målgrupp: kunder), en för onboardingguider (målgrupp: nya användare), en för interna SOP:er (målgrupp: nyanställda) och en för kunskapsbasartiklar (målgrupp: supportteam). Att återanvända samma formulering varje gång håller tonen enhetlig över dussintals genererade dokument, även om var och en produceras oberoende av de andra.
För team som driver mer än en produkt: dela upp varje produkt i sin egen FlowHunt-arbetsyta, koppla ihop de relevanta verktygen och bygg en kunskapsbas som är avgränsad specifikt till den produkten. Att hålla varje produkts kontext separat ger mer fokuserat resultat vid varje körning och undviker att en produkts terminologi eller konventioner läcker in i en annans dokumentation. Och eftersom regenerering är snabb kan du knyta den till en faktisk utlösare, en release, en mergad pull request som rör en dokumenterad modul, i stället för en schemalagd dokumentationssprint som konkurrerar med allt annat på färdplanen och oftast förlorar.
Testa AI-dokumentationsskrivaren med 7 dagars kostnadsfri provperiod (5 krediter ingår) innan du binder dig till en betald plan, och se vilket av dessa fem användningsfall som sparar mest tid för ditt team först.
