


Einleitung
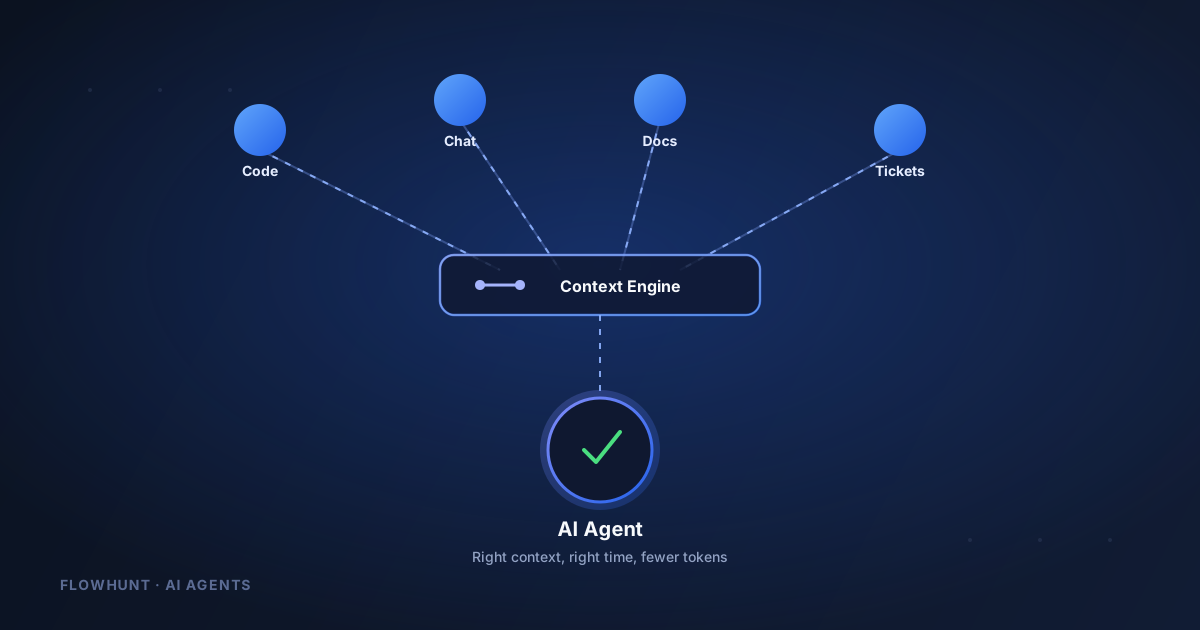
Die Effizienz von KI-Agenten hängt entscheidend von einem grundlegenden Faktor ab: Zugriff auf die richtigen Informationen zur richtigen Zeit zu haben. Während Organisationen immer ausgefeiltere KI-Agenten intern einsetzen, hat sich ein klares Muster gezeigt – wenn Agenten ordentlich kuratierten und indexierten Kontext erhalten, verbessert sich ihre Genauigkeit drastisch, während ihr Token-Verbrauch deutlich sinkt. Diese Verschiebung bedeutet einen grundlegenden Wandel darin, wie wir über KI-Agenten-Architektur denken. Statt Agenten rohen, ungefilterten Zugriff auf alle verfügbaren Daten zu geben, konzentrieren sich moderne Ansätze darauf, intelligente Context Engines zu bauen, die als Gehirn der KI-Systeme fungieren. In diesem Artikel untersuchen wir, wie man eine Context Engine baut und implementiert, warum sie für Ihre Organisation wichtig ist und wie sie Betriebskosten senken und gleichzeitig die Leistung von Agenten verbessern kann.
Was ist eine Context Engine?
Eine Context Engine ist im Kern ein hochentwickeltes System, das kontextuelle Informationen für KI-Agenten auf möglichst effiziente Weise zusammenführt, indexiert und bereitstellt. Statt Agenten zu zwingen, ganze Repositories, Dokumentationen oder Datenspeicher manuell zu durchsuchen, fungiert eine Context Engine als intelligenter Vermittler, der versteht, welchen Kontext ein Agent braucht, und ihn genau dann liefert, wenn er benötigt wird.
Das Kernprinzip hinter einer Context Engine ist Optimierung. Traditionelle KI-Agenten-Architekturen leiden häufig unter dem, was man „Kontext-Aufblähung“ nennen könnte – Agenten erhalten zu viele Informationen, was zu längeren Verarbeitungszeiten, höherem Token-Verbrauch und manchmal sogar zu geringerer Genauigkeit aufgrund von Rauschen im Kontextfenster führt. Eine Context Engine löst dies, indem sie intelligente Filter- und Indexierungsmechanismen implementiert, die sicherstellen, dass Agenten nur die relevantesten Daten für ihre spezifische Aufgabe erhalten.

Bereit, Ihr Geschäft zu erweitern?
Starten Sie heute Ihre kostenlose Testversion und sehen Sie innerhalb weniger Tage Ergebnisse.
Warum Kontextmanagement für die Leistung von KI-Agenten wichtig ist
In der sich schnell entwickelnden Landschaft der KI-gestützten Entwicklung ist die Fähigkeit, Kontext effizient zu verwalten, zu einem Wettbewerbsvorteil geworden. Während Organisationen ihren Einsatz von KI-Agenten für Code-Review, Fehlerbehebung, Dokumentationserstellung und andere komplexe Aufgaben skalieren, werden die Kostenauswirkungen ineffizienten Kontextmanagements immer bedeutender.
Betrachten Sie die praktischen Implikationen:
- Token-Effizienz: Jedes von einem KI-Modell verbrauchte Token stellt direkte Kosten dar. Unnötiger Kontext erhöht den Token-Verbrauch exponentiell, was zu höheren Betriebskosten und langsameren Antwortzeiten führt.
- Genauigkeitsverbesserung: Wenn Agenten Zugriff auf genau den richtigen Kontext ohne Rauschen oder irrelevante Informationen haben, verbessert sich ihre Entscheidungsfindung. Sie können sich darauf konzentrieren, das eigentliche Problem zu lösen, statt überflüssige Daten zu durchforsten.
- Skalierbarkeit: Mit steigender Anzahl von Agenten und zunehmender Komplexität der Aufgaben wird manuelles Kontextmanagement unmöglich. Eine automatisierte Context Engine ermöglicht es Organisationen, ihre KI-Abläufe zu skalieren, ohne dass die Kosten proportional steigen.
- Echtzeit-Reaktionsfähigkeit: Eine gut gestaltete Context Engine kann Agenten frische, aktuelle Informationen liefern und so sicherstellen, dass sie stets mit aktuellen Daten statt mit veralteten Momentaufnahmen arbeiten.
Wie FlowHunt Prinzipien der Context Engine integriert
FlowHunt erkennt, dass moderne KI-Workflows intelligentes Kontextmanagement in ihrem Kern erfordern. Als KI-Agenten-Plattform besteht die Aufgabe darin, sicherzustellen, dass Ihre intelligenten Agenten stets mit dem richtigen Ausschnitt Ihrer Daten arbeiten – nicht mit dem gesamten Datenlager. Die Plattform integriert die Prinzipien der Context Engine in ihr Automatisierungs-Framework und ermöglicht es Nutzern, KI-gestützte Workflows zu bauen, die auch bei Skalierung effizient bleiben. Durch die Integration mehrerer Datenquellen und die Implementierung intelligenter Indexierung stellt FlowHunt sicher, dass Ihre KI-Agenten – ob sie Inhalte generieren, Code prüfen oder Daten analysieren – stets Zugriff auf den relevantesten Kontext haben, ohne den Overhead der Verarbeitung irrelevanter Informationen.
Abonnieren Sie unseren Newsletter
Erhalten Sie die neuesten Tipps, Trends und Angebote kostenlos.
Eine effektive Context Engine bauen: Architektur und Komponenten
Eine produktionsreife Context Engine erfordert sorgfältige architektonische Planung. Das System muss mehrere Datenquellen gleichzeitig verarbeiten, Informationen effizient indexieren und diesen Kontext verschiedenen KI-Agenten über ein standardisiertes Protokoll bereitstellen.
| Komponente | Zweck | Integrationspunkte |
|---|---|---|
| Datenaggregationsschicht | Sammelt Ereignisse und Daten aus mehreren Quellen | GitHub, Slack, Discord, Stripe, Websites |
| Indexierungs-Engine | Organisiert und optimiert Daten für schnellen Abruf | Volltextsuche, semantische Indexierung, Metadaten-Tagging |
| Query-Schnittstelle | Bietet standardisierten Zugriff für KI-Agenten | MCP-Server (Model Context Protocol) |
| Cache-Schicht | Reduziert Latenz bei häufig abgerufenem Kontext | In-Memory-Caching mit TTL-Richtlinien |
| Integrations-Framework | Ermöglicht die Anbindung neuer Datenquellen | Webhook-Empfänger, API-Konnektoren, Event-Listener |
Die effektivsten Context Engines verfolgen einen hybriden Ansatz und kombinieren mehrere Retrieval-Strategien. Statt sich allein auf eine Methode zu verlassen, nutzen sie intelligentes Routing, um zu bestimmen, ob der Kontext aus der indexierten Engine, dem direkten Dateizugriff oder aus Dokumentationsabfragen stammen sollte – abhängig von der konkreten Anfrage und den Anforderungen des Agenten. In der Praxis wird diese Query-Schnittstelle üblicherweise als MCP-Server bereitgestellt, sodass jeder kompatible Agent sich damit verbinden kann, wie er sich mit jedem anderen Tool verbinden würde.
Die FlowHunt Context Engine: praktische Umsetzung
FlowHunt hat eine Open-Source-Context-Engine entwickelt, die speziell für KI-Agenten-Workflows konzipiert ist. Diese Context Engine ist über harx.dev zugänglich und zeigt, wie Kontextmanagement in Produktionsumgebungen praktisch umgesetzt werden kann. Das System baut auf dem Model Context Protocol (MCP) auf, einer standardisierten Schnittstelle, die es mehreren KI-Agenten ermöglicht, die Context Engine abzufragen – unabhängig von ihrer zugrunde liegenden Architektur.
Die Implementierung umfasst mehrere zentrale Funktionen:
- Multi-Quellen-Integration: Die Context Engine aggregiert Daten aus GitHub-Repositories, Slack-Kanälen, Discord-Servern, Stripe-Abrechnungsinformationen, YouTube-Inhalten, Websites und Ticketsystemen. Diese umfassende Integration bedeutet, dass Agenten Zugriff auf Organisationswissen aus jedem kritischen System haben.
- Intelligentes Dateisystemmanagement: Die Engine organisiert indexierte Daten automatisch in logische Entitäten – Bug-Reports, Feature-Anfragen, Nutzerrechnungen, Kundeninformationen –, sodass Agenten leicht navigieren und spezifische Informationen abrufen können.
- Echtzeit-Updates: Sobald neue Ereignisse in verbundenen Plattformen auftreten, verarbeitet und indexiert die Context Engine sie automatisch, damit Agenten stets mit aktuellen Informationen arbeiten.
- Kostenbewusstes Design: Das gesamte System ist auf Token-Effizienz ausgelegt und nutzt ausgefeilte Algorithmen, um zu bestimmen, welcher Kontext für eine gegebene Anfrage wirklich notwendig ist.
Wirkung messen: Ergebnisse aus der Praxis bei Code-Review-Aufgaben
Die theoretischen Vorteile einer Context Engine sind überzeugend, doch die Validierung in der Praxis ist unerlässlich. FlowHunt führte eine umfassende Bewertung seiner Context Engine anhand echter Code-Review-Aufgaben durch, die vom internen Coding-Agenten ausgeführt wurden. Die Ergebnisse liefern konkrete Belege für die Wirksamkeit des Ansatzes.
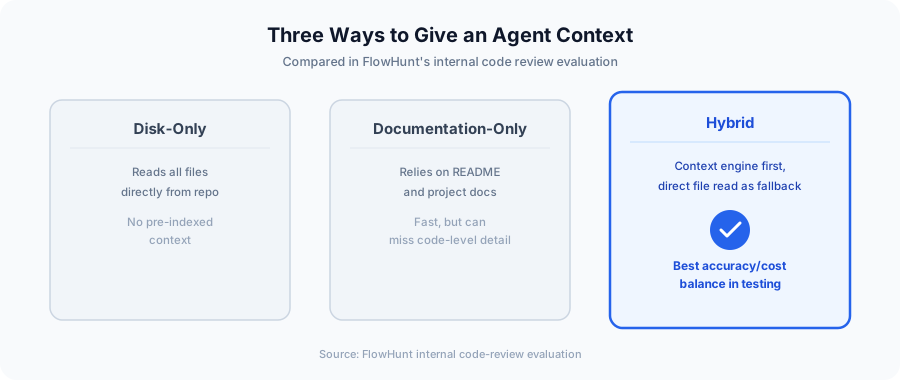
Die Bewertung verglich drei unterschiedliche Ansätze, dem Code-Review-Agenten Kontext bereitzustellen:
- Reiner Disk-Ansatz: Der Agent liest alle relevanten Dateien direkt aus dem Repository, ohne vorkonfigurierten Kontext.
- Reiner Dokumentations-Ansatz: Der Agent stützt sich ausschließlich auf Projektdokumentation und README-Dateien.
- Hybrider Ansatz: Der Agent nutzt die Context Engine für indexierten Kontext und behält gleichzeitig die Möglichkeit, Dateien bei Bedarf direkt aus dem Repository zu lesen.
Die Ergebnisse waren beeindruckend. Der hybride Ansatz, der die Context Engine mit selektivem Dateizugriff kombiniert, erzielte die beste Balance aus Genauigkeit und Kosteneffizienz. Konkret reduzierte diese Methode den Token-Verbrauch um 23 % im Vergleich zu traditionellen Ansätzen, während die Genauigkeitswerte erhalten oder verbessert wurden. Das bedeutet eine erhebliche Kostensenkung für Organisationen, die mehrere Agenten kontinuierlich betreiben.
Die Daten zeigen, dass der effizienteste Weg nach vorn nicht darin besteht, zwischen Context Engines und traditionellem Dateizugriff zu wählen – sondern beide Ansätze intelligent zu kombinieren. Die Context Engine dient als primäre Quelle für häufig benötigte Informationen, während der direkte Dateizugriff einen Fallback für Sonderfälle oder spezialisierte Anfragen bietet.
Context Engines über verschiedene KI-Plattformen hinweg implementieren
Einer der stärksten Aspekte einer gut gestalteten Context Engine ist ihre Plattformunabhängigkeit. Statt für jeden KI-Agententyp separate Kontextsysteme zu bauen, kann eine einheitliche Context Engine mehrere Agenten-Frameworks gleichzeitig bedienen.
Die FlowHunt Context Engine demonstriert dieses Prinzip, indem sie die Integration mit folgenden Systemen unterstützt:
- Harx (FlowHunts interner Coding-Agent)
- Claude Code (Anthropics Coding-Assistent)
- Codeex (spezialisierter Code-Ausführungsagent)
- Pi.dev (Python-fokussierter Entwicklungsagent)
- Harness (Deployment- und Testplattform)
Dieser Multi-Plattform-Ansatz bietet erhebliche Vorteile. Organisationen können ihre Kontextinfrastruktur standardisieren und dennoch flexibel unterschiedliche Agenten-Implementierungen für unterschiedliche Aufgaben wählen. Die Context Engine wird zum zuverlässigen Rückgrat, das sicherstellt, dass alle Agenten – unabhängig von ihrer spezifischen Architektur – Zugriff auf konsistenten, hochwertigen Kontext haben.
Die Ökonomie der Token-Optimierung
Die finanziellen Auswirkungen der Implementierung einer Context Engine zu verstehen, ist entscheidend für Entscheidungen. Der Token-Verbrauch schlägt bei der Nutzung kommerzieller KI-Modelle direkt auf die Betriebskosten durch. Eine Reduktion des Token-Verbrauchs um 23 % bedeutet eine substanzielle Kosteneinsparung, insbesondere für Organisationen, die Agenten kontinuierlich betreiben.
Betrachten Sie ein Szenario: Eine Organisation betreibt Code-Review-Agenten für 100 Pull Requests pro Tag, wobei jede Prüfung durchschnittlich 10.000 Token verbraucht. Eine Reduktion um 23 % durch die Implementierung einer Context Engine würde täglich etwa 230.000 Token einsparen. Über einen Monat sind das fast 7 Millionen Token – was Tausenden von Dollar an reduzierten API-Kosten entspricht. Bei größeren Organisationen skalieren diese Einsparungen proportional.
Über die direkte Kostensenkung hinaus ermöglicht Token-Optimierung schnellere Antwortzeiten der Agenten. Kleinere Kontextfenster bedeuten schnellere Verarbeitung, sodass Agenten Aufgaben zügiger erledigen und Entwicklern schneller Feedback geben können. So entsteht ein Multiplikatoreffekt, bei dem Kosteneinsparungen mit gestiegener Produktivität zusammenwirken.
Best Practices für den Einsatz von Context Engines
Eine erfolgreiche Implementierung einer Context Engine erfordert sorgfältige Planung und Umsetzung. Aus Einsätzen in der Praxis haben sich mehrere Best Practices herauskristallisiert:
Beginnen Sie mit Ihren wertvollsten Anwendungsfällen: Versuchen Sie nicht, alle Organisationsdaten sofort zu indexieren, sondern starten Sie mit den spezifischen Aufgaben, bei denen der Token-Verbrauch am höchsten ist und Kontext-Effizienz am wichtigsten ist. Code-Review, Dokumentationserstellung und Bug-Triage sind hervorragende Ausgangspunkte.
Integrieren Sie Quellen schrittweise: Versuchen Sie nicht, alle Datenquellen gleichzeitig anzubinden. Bauen Sie Integrationen inkrementell auf und validieren Sie, dass jede neue Quelle die Agentenleistung tatsächlich verbessert, bevor Sie die nächste hinzufügen.
Überwachen und messen Sie kontinuierlich: Etablieren Sie Baseline-Metriken, bevor Sie Ihre Context Engine implementieren, und verfolgen Sie Änderungen sorgfältig. Token-Verbrauch, Genauigkeitsraten, Antwortzeiten und Kostenmetriken sollten durchgängig überwacht werden.
Nutzen Sie hybride Ansätze: Die Daten deuten stark darauf hin, dass reine Context-Engine-Ansätze nicht optimal sind. Kombinieren Sie stattdessen indexierten Kontext mit der Möglichkeit, direkt auf Quelldateien zuzugreifen, damit Agenten für jede Anfrage die effizienteste Retrieval-Methode wählen können.
Planen Sie Skalierung ein: Entwerfen Sie Ihre Context Engine mit Wachstum im Blick. Wenn Sie mehr Agenten und mehr Datenquellen hinzufügen, muss das System weiterhin effizient arbeiten, ohne an Leistung zu verlieren.
Die Zukunft der KI-Agenten-Architektur
Die Entstehung von Context Engines als kritische Komponente der KI-Agenten-Architektur zeigt die Reifung des Feldes. Frühe KI-Agenten-Implementierungen behandelten Kontext als Nebensache – Agenten erhielten die verfügbaren Daten und versuchten, damit so gut wie möglich zu arbeiten. Moderne Ansätze erkennen an, dass Kontextmanagement fundamental für die Leistung von Agenten ist.
Mit Blick nach vorn werden Context Engines wahrscheinlich zunehmend ausgefeilter. Machine-Learning-Modelle, die vorhersagen, welcher Kontext für bestimmte Aufgabentypen am relevantesten ist, könnten den Token-Verbrauch weiter optimieren. Die Integration spezialisierterer Datenquellen und domänenspezifischer Wissensbasen wird Agenten befähigen, in spezialisierten Domänen effektiver zu arbeiten. Echtzeit-Lernsysteme könnten Strategien zur Kontextbereitstellung auf Basis von Leistungsfeedback der Agenten anpassen.
Das Prinzip, das all diesen Entwicklungen zugrunde liegt, bleibt konstant: Die leistungsfähigsten KI-Agenten sind nicht die mit den größten Modellen oder der meisten Rechenleistung, sondern die mit Zugriff auf genau den richtigen Kontext zur richtigen Zeit.
Fazit
Eine effektive Context Engine für KI-Agenten zu bauen, ist für Organisationen, die KI-gesteuerte Automatisierung ernst nehmen, nicht länger optional. Die Belege sind eindeutig – eine gut implementierte Context Engine senkt den Token-Verbrauch um 23 % und verbessert gleichzeitig die Genauigkeit, was sich direkt in niedrigeren Kosten und besserer Agentenleistung niederschlägt. Die Technologie ist ausgereift genug für den Produktionseinsatz, mit verfügbaren Open-Source-Implementierungen und nachgewiesenen Ergebnissen aus realen Anwendungsfällen.
Der Weg nach vorn besteht darin, Context Engines als Kernkomponente Ihrer KI-Infrastruktur zu implementieren, beginnend mit wertvollen Anwendungsfällen und schrittweise erweitert. Durch die Kombination von indexiertem Kontext mit selektivem direktem Zugriff können Organisationen optimale Effizienz erreichen. Organisationen, die Context Engines früh übernehmen, werden durch niedrigere Betriebskosten, schnellere Antwortzeiten der Agenten und höhere Genauigkeit bei KI-gesteuerten Aufgaben erhebliche Wettbewerbsvorteile erlangen.
Beschleunigen Sie Ihren Workflow mit FlowHunt
Erleben Sie, wie FlowHunt Ihre KI-Content- und SEO-Workflows automatisiert – von Recherche und Content-Erstellung bis hin zu Publishing und Analytics – alles an einem Ort.
